Les chapitres précédents ont utilisé le maximum de vraisemblance pour justifier nos fonctions de perte: le chapitre 1 a introduit le principe, le chapitre 2 l’a appliqué à la régression (donnant les moindres carrés), et le chapitre 3 à la classification (donnant l’entropie croisée). Ce chapitre va plus loin en présentant le cadre bayésien complet, qui offre une perspective plus riche sur l’apprentissage.
Source
import numpy as np
import matplotlib.pyplot as plt

# Configuration pour des figures haute résolution
%config InlineBackend.figure_format = 'retina'
Le cadre probabiliste
Le maximum de vraisemblance, introduit au chapitre 1, nous a donné un principe pour choisir les paramètres: maximiser la probabilité des données observées. Mais l’EMV n’est qu’un point de départ. Comment intégrer des connaissances préalables? Comment quantifier notre incertitude sur les paramètres?
Le cadre bayésien offre des réponses à ces questions en traitant les paramètres eux-mêmes comme des variables aléatoires. Cette section présente d’abord le cadre général de l’inférence bayésienne, puis montre comment le maximum a posteriori (MAP) relie l’approche bayésienne à la régularisation.
Le cadre bayésien
La statistique bayésienne propose un cadre général pour l’estimation de paramètres. Au lieu d’estimer un point unique, elle caractérise notre incertitude sur les paramètres par une distribution de probabilité.
Le théorème de Bayes nous dit comment mettre à jour nos croyances sur les paramètres après avoir observé des données :
Au numérateur, est la distribution a priori: notre croyance sur avant d’observer les données. Le terme est la vraisemblance: la probabilité des données pour un choix de paramètres donné. Au dénominateur, est la vraisemblance marginale, qui normalise l’ensemble pour obtenir une vraie distribution. Le résultat, , est la distribution a posteriori: notre croyance sur après avoir vu les données.
L’a priori encode notre connaissance préalable. Pour une pièce de monnaie, nous pourrions croire que est probablement proche de 0,5. L’a posteriori combine cette croyance avec l’évidence des données.
Prédiction bayésienne et distribution prédictive a posteriori
En pratique, nous ne connaissons pas . Nous avons un modèle paramétrique et une distribution a posteriori sur les paramètres. L’approche bayésienne complète consiste à moyenner les prédictions sur tous les paramètres possibles, pondérés par leur probabilité a posteriori:
Cette distribution prédictive a posteriori intègre l’incertitude sur les paramètres. Elle ne s’engage pas sur une valeur unique de , mais considère toutes les valeurs plausibles.
Le problème: cette intégrale est rarement calculable analytiquement. Elle nécessite d’intégrer sur un espace de paramètres de grande dimension, ce qui est coûteux ou impossible en pratique. C’est pourquoi nous recourons souvent à des estimateurs ponctuels: plutôt que d’intégrer sur tous les , nous en choisissons un seul, comme l’EMV ou le MAP.
Utilité du modèle probabiliste
Si nous finissons souvent par utiliser un estimateur ponctuel, pourquoi adopter le cadre probabiliste?
D’abord, il justifie nos choix de fonctions de perte. La perte quadratique découle de l’hypothèse de bruit gaussien; la perte logarithmique vient du principe de maximum de vraisemblance. Sans le cadre probabiliste, ces choix sembleraient arbitraires.
Ensuite, il permet de quantifier l’incertitude. Au-delà de la prédiction ponctuelle , nous pouvons donner un intervalle de prédiction. Sous un modèle gaussien, a environ 95% de chances de tomber dans .
Le cadre probabiliste offre aussi des outils pour comparer des modèles. La vraisemblance marginale permet de comparer des modèles de complexités différentes, pénalisant automatiquement les modèles trop complexes.
Enfin, quand les ressources le permettent, nous pouvons aller au-delà des estimateurs ponctuels et approximer la distribution prédictive complète par des méthodes de Monte Carlo ou l’inférence variationnelle.
Maximum de vraisemblance: rappel et approfondissement
Le chapitre 1 a introduit le principe du maximum de vraisemblance: choisir les paramètres qui maximisent la probabilité des données observées sous l’hypothèse i.i.d. Le chapitre 2 a montré que ce principe, appliqué à un modèle gaussien, donne les moindres carrés. Le chapitre 3 a montré qu’appliqué à un modèle de Bernoulli, il donne l’entropie croisée.
Cette section approfondit ces idées en explorant des extensions importantes: la régression hétéroscédastique et le lien avec la minimisation du risque empirique.
L’EMV comme minimisation du risque empirique
La log-vraisemblance négative (LVN) prend la forme:
Remarquez la structure: c’est une somme sur les exemples d’une quantité qui dépend de chaque observation. Cette quantité joue le rôle d’une fonction de perte. Le maximum de vraisemblance est donc un cas particulier de la minimisation du risque empirique, où la perte est définie par le modèle probabiliste lui-même.
Régression homoscédastique et hétéroscédastique
Le chapitre 2 a montré que sous le modèle avec , minimiser la LVN revient à minimiser la somme des erreurs quadratiques. La perte quadratique découle donc de l’hypothèse gaussienne.
Dans ce modèle, la variance est constante pour toutes les entrées . C’est ce qu’on appelle la régression homoscédastique (du grec homos, même, et skedasis, dispersion). C’est l’hypothèse standard en régression linéaire.
En pratique, l’incertitude peut varier selon l’entrée. Par exemple, les mesures à haute vitesse peuvent être plus bruitées que celles à basse vitesse. La régression hétéroscédastique modélise cette variation en faisant dépendre la variance de :
où prédit la moyenne et prédit l’écart-type. Ce modèle est plus flexible mais requiert d’apprendre des paramètres supplémentaires.
Source
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.animation import FuncAnimation
from scipy.stats import norm
from IPython.display import HTML

# Générer des données synthétiques
np.random.seed(42)
N = 100
x_data = np.random.uniform(0.5, 9.5, N)
f_mu = lambda x: 0.5 * x + 1

# Homoscédastique: variance constante
sigma_homo = 0.7
y_homo = f_mu(x_data) + np.random.normal(0, sigma_homo, N)

# Hétéroscédastique: variance croissante
f_sigma = lambda x: 0.3 + 0.12 * x
y_hetero = f_mu(x_data) + np.random.normal(0, f_sigma(x_data))

# Configuration de la figure
fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))
x_line = np.linspace(0, 10, 100)
y_pdf_range = np.linspace(-3, 9, 200)
scale = 2.5  # échelle pour afficher les PDFs

def init():
    for ax in axes:
        ax.clear()
    return []

def animate(frame):
    x_current = 0.5 + frame * 9 / 59  # balayer de 0.5 à 9.5

    for idx, (ax, y_data, title, color, get_sigma) in enumerate([
        (axes[0], y_homo, 'Régression homoscédastique', 'steelblue', lambda x: sigma_homo),
        (axes[1], y_hetero, 'Régression hétéroscédastique', 'coral', f_sigma)
    ]):
        ax.clear()

        # Données et ligne de régression
        ax.scatter(x_data, y_data, alpha=0.4, s=20, c='gray', zorder=1)
        ax.plot(x_line, f_mu(x_line), 'k-', linewidth=2, zorder=2)

        # Gaussienne à la position actuelle
        mu = f_mu(x_current)
        sigma = get_sigma(x_current)
        pdf = norm.pdf(y_pdf_range, mu, sigma)

        # Afficher la gaussienne "horizontalement"
        ax.fill_betweenx(y_pdf_range, x_current, x_current + scale * pdf,
                         alpha=0.5, color=color, zorder=3)
        ax.plot(x_current + scale * pdf, y_pdf_range, color=color, linewidth=2, zorder=4)

        # Ligne verticale indiquant la position
        ax.axvline(x_current, color=color, linestyle='--', alpha=0.5, linewidth=1)

        # Point sur la courbe de régression
        ax.scatter([x_current], [mu], color='black', s=50, zorder=5)

        # Bande ±2σ
        ax.fill_between([x_current - 0.1, x_current + 0.1],
                        [mu - 2*sigma, mu - 2*sigma],
                        [mu + 2*sigma, mu + 2*sigma],
                        alpha=0.2, color=color, zorder=0)

        ax.set_xlim(-0.5, 12)
        ax.set_ylim(-2, 8)
        ax.set_xlabel(r'$x$', fontsize=11)
        ax.set_ylabel(r'$y$', fontsize=11)
        sigma_label = r'$\sigma^2$ constant' if idx == 0 else r'$\sigma^2(x)$ variable'
        ax.set_title(f'{title}\n{sigma_label}', fontsize=11)

    fig.tight_layout()
    return []

anim = FuncAnimation(fig, animate, init_func=init, frames=60, interval=80, blit=True)
anim.save('_static/regression_scedasticity.gif', writer='pillow', fps=12, dpi=100)
plt.close()

# Afficher le GIF
from IPython.display import Image
Image(filename='_static/regression_scedasticity.gif')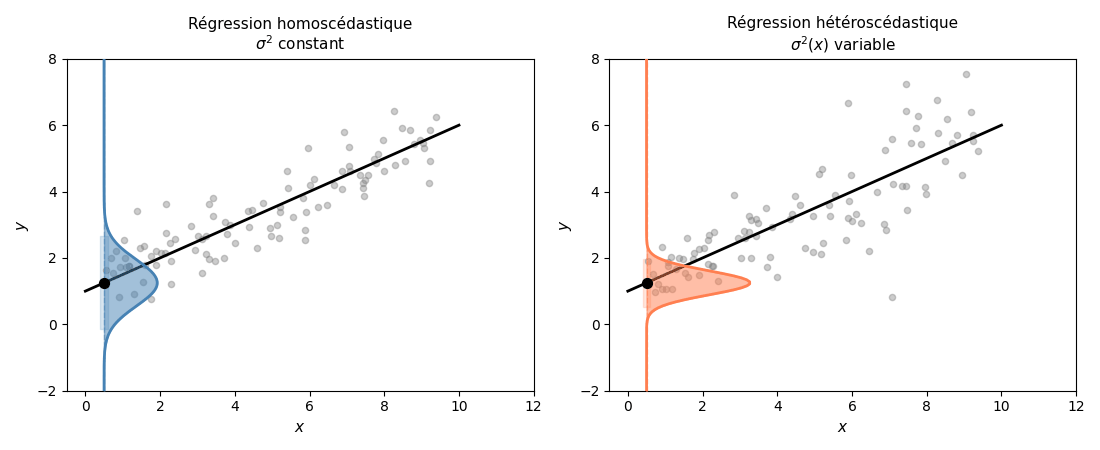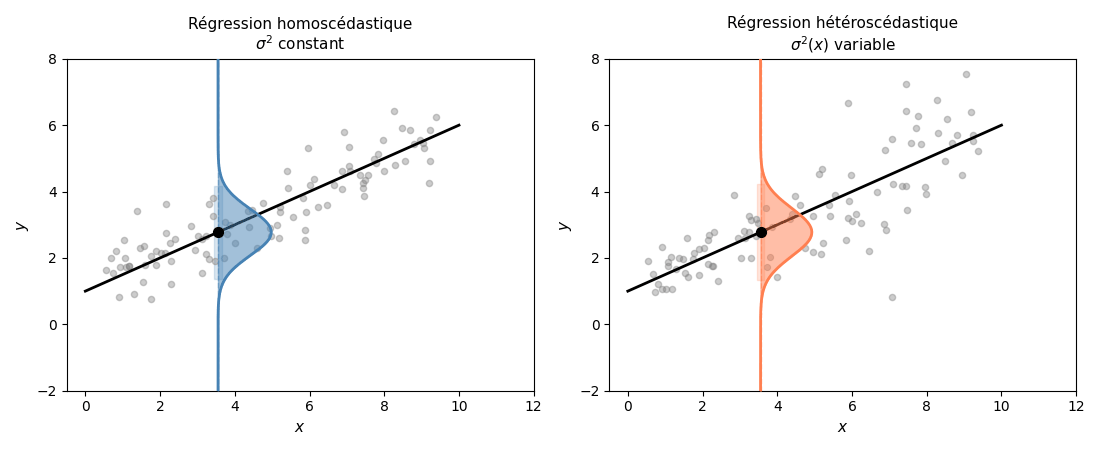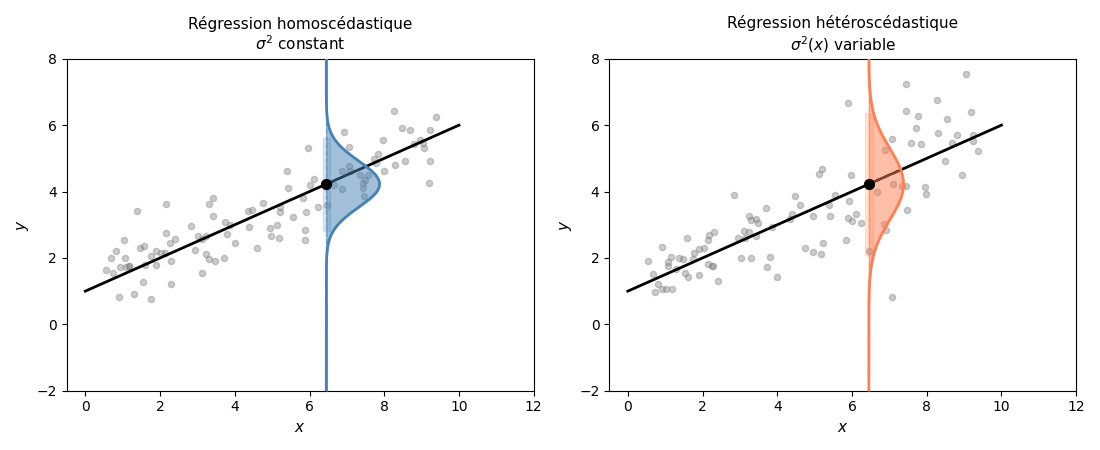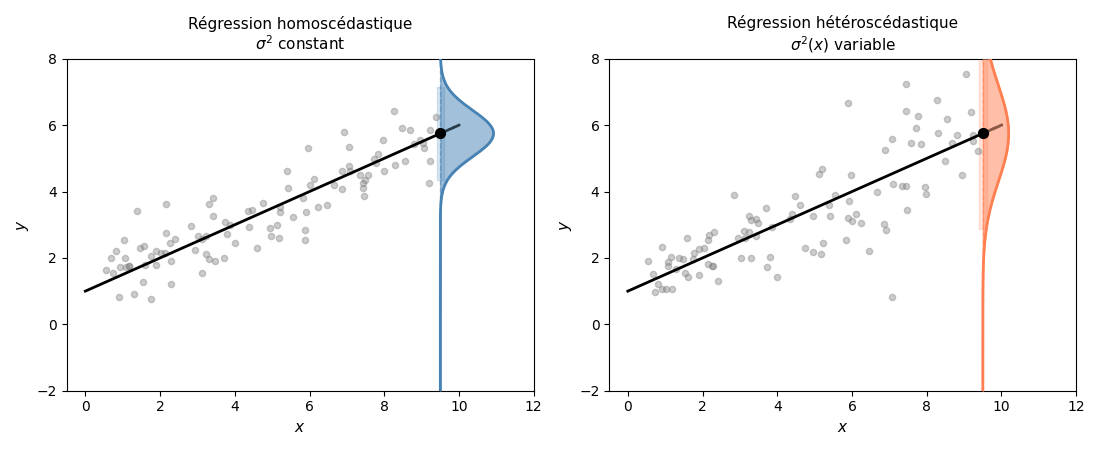
L’animation illustre la différence fondamentale entre les deux modèles. À chaque position , la distribution conditionnelle est une gaussienne (la «cloche» colorée) centrée sur la courbe de régression . Dans le cas homoscédastique (gauche), la cloche garde la même largeur partout. Dans le cas hétéroscédastique (droite), la largeur varie avec . Ici, l’incertitude augmente vers la droite, ce qui se traduit par une dispersion plus grande des points.
Classification binaire
La perte 0-1 pour la classification est discontinue, ce qui empêche l’utilisation de méthodes de gradient. La fonction sigmoïde contourne ce problème: c’est une approximation lisse de la fonction échelon (step function). Elle transforme n’importe quel score réel en une valeur dans l’intervalle , que nous pouvons interpréter comme une probabilité.
Source
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.animation import FuncAnimation

# Create figure
fig, ax = plt.subplots(figsize=(8, 5))

# Define x range
z = np.linspace(-4, 4, 200)

# Step function (Heaviside)
step = (z >= 0).astype(float)

# Sigmoid function with temperature parameter
def sigmoid(z, alpha=1):
    return 1 / (1 + np.exp(-alpha * z))

# Initialize plot
line_step, = ax.plot(z, step, 'k--', linewidth=2, label='Fonction échelon', alpha=0.7)
line_sigmoid, = ax.plot([], [], 'b-', linewidth=2, label='Sigmoïde $\\sigma(\\alpha z)$')
ax.axhline(0.5, color='gray', linestyle=':', alpha=0.5, linewidth=1)
ax.axvline(0, color='gray', linestyle=':', alpha=0.5, linewidth=1)
ax.set_xlim(-4, 4)
ax.set_ylim(-0.1, 1.1)
ax.set_xlabel('$z$')
ax.set_ylabel('$\\sigma(\\alpha z)$')
ax.set_title('Approximation de la fonction échelon par la sigmoïde')
ax.legend(loc='best')
ax.grid(True, alpha=0.3)

# Animation function
def animate(frame):
    # Alpha increases from 0.5 to 10
    alpha = 0.5 + (frame / 100) * 9.5
    y = sigmoid(z, alpha)
    line_sigmoid.set_data(z, y)
    ax.set_title(f'Approximation de la fonction échelon par la sigmoïde ($\\alpha = {alpha:.2f}$)')
    return line_sigmoid,

# Create animation
anim = FuncAnimation(fig, animate, frames=100, interval=50, blit=True, repeat=True)
anim.save('_static/sigmoid_approximation.gif', writer='pillow', fps=20, dpi=100)
plt.close()

# Afficher le GIF
from IPython.display import Image
Image(filename='_static/sigmoid_approximation.gif')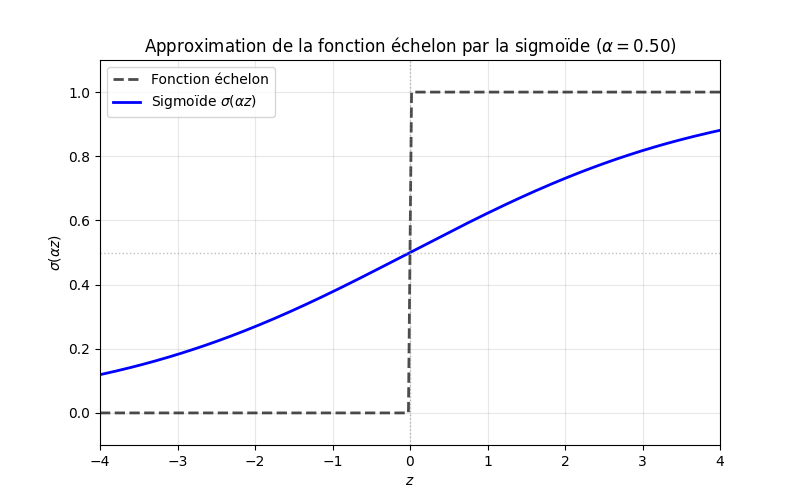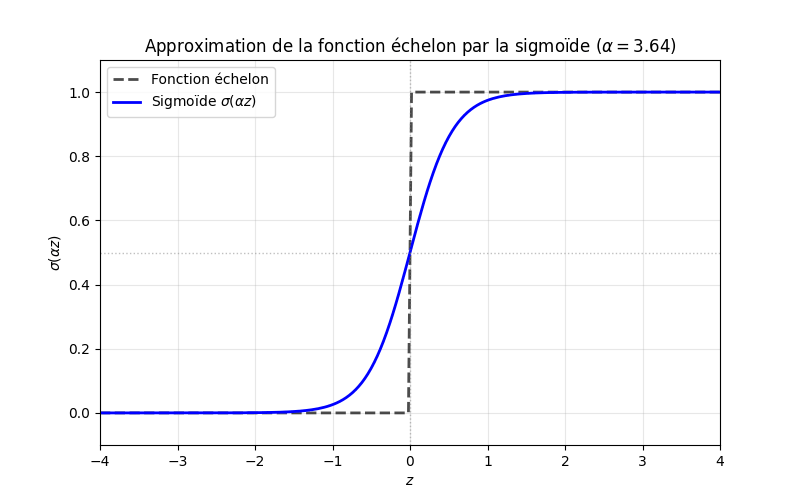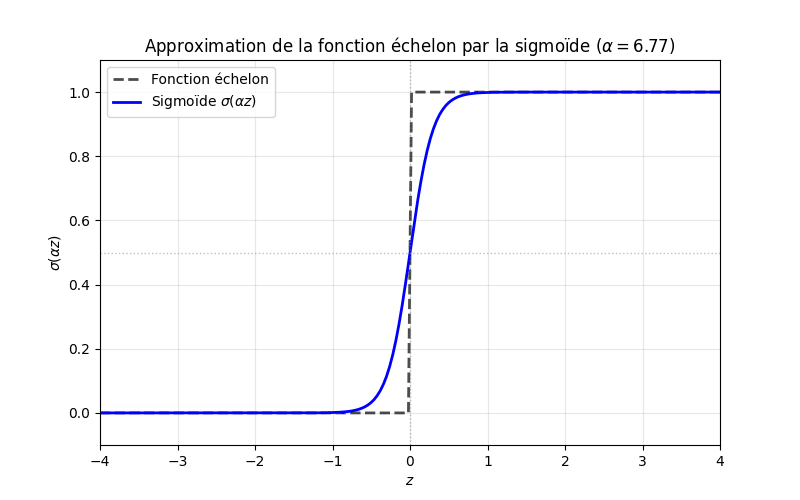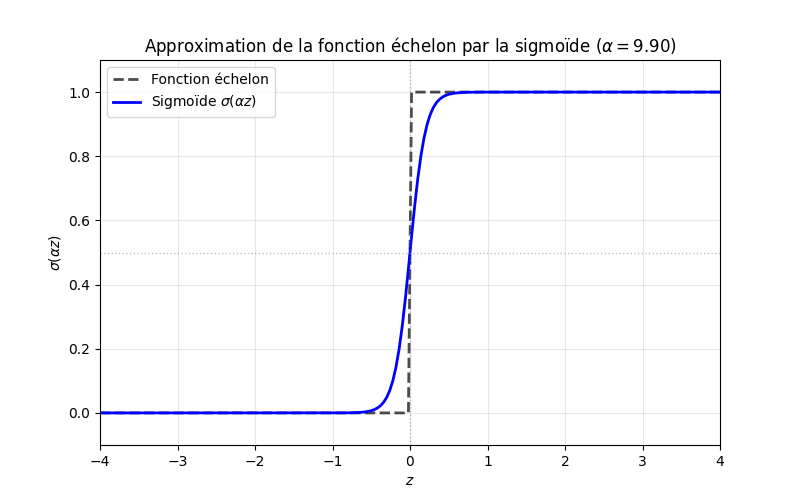
L’animation montre comment la sigmoïde se rapproche de la fonction échelon lorsque le paramètre augmente. Pour , la sigmoïde est douce; pour grand, elle devient presque aussi abrupte que la fonction échelon, tout en restant différentiable.
Cette interprétation probabiliste n’est pas qu’une astuce numérique. Elle correspond exactement à modéliser par une distribution de Bernoulli dont le paramètre dépend de l’entrée.
Pour la classification binaire avec , nous modélisons la probabilité de la classe positive par:
où est la fonction sigmoïde et est le logit (ou log-odds), le score brut du modèle avant transformation. Le logit est le logarithme du rapport des probabilités: . La distribution conditionnelle suit une loi de Bernoulli:
La log-vraisemblance négative est:
Cette quantité est l’entropie croisée binaire. Elle correspond à la perte logistique, à une reparamétrisation près.
Classification multiclasse
Pour la classification avec classes (), nous généralisons le modèle binaire en utilisant la distribution catégorielle (ou multinomiale). Au lieu de modéliser une seule probabilité , nous modélisons un vecteur de probabilités où et .
Pour transformer les scores bruts du modèle en probabilités, nous utilisons la fonction softmax:
où est le score pour la classe . La fonction softmax généralise la sigmoïde au cas multiclasse: elle transforme scores réels en un vecteur de probabilités qui somme à 1.
La distribution conditionnelle suit une loi catégorielle:
où vaut 1 si et 0 sinon. En utilisant l’encodage one-hot , cette expression devient:
La log-vraisemblance négative est:
où . Cette quantité est l’entropie croisée multiclasse. Elle généralise l’entropie croisée binaire au cas où il y a plus de deux classes.
Pour la classification binaire avec , le softmax se réduit à la sigmoïde. En effet, si nous définissons , alors:
Le modèle binaire et le modèle multiclasse partagent donc la même structure probabiliste, avec la distribution catégorielle comme généralisation naturelle de la distribution de Bernoulli.
Stabilité numérique du softmax
La définition mathématique du softmax est élégante, mais son calcul direct peut poser problème. L’exponentielle croît très rapidement: , , dépasse la capacité des nombres en virgule flottante. Quand un logit est grand, le calcul provoque un débordement (overflow) et retourne l’infini.
Une astuce simple résout ce problème: soustraire le maximum des logits avant de calculer l’exponentielle.
où . Cette transformation est mathématiquement équivalente à la définition originale: le facteur apparaît au numérateur et au dénominateur et s’annule. Mais numériquement, elle garantit que le plus grand exposant vaut zéro, évitant tout débordement.
Maximum a posteriori
Plutôt que de travailler avec la distribution a posteriori complète (ce qui peut être coûteux), nous pouvons chercher son mode: la valeur des paramètres la plus probable a posteriori. C’est l’estimateur du maximum a posteriori (MAP):
Le dénominateur ne dépend pas de et peut être ignoré pour l’optimisation. En passant au logarithme:
Cette expression révèle une structure familière. Développons la log-vraisemblance et posons :
Comparons avec le risque empirique régularisé introduit au chapitre 2:
La structure est identique: une somme de pertes sur les exemples, plus un terme de régularisation. La différence est l’absence du facteur devant la somme dans l’objectif MAP. Cette différence n’affecte pas le minimiseur (multiplier par une constante positive ne change pas l’argmin), mais elle a une conséquence importante: le poids relatif de l’a priori par rapport aux données diminue quand augmente. Avec plus de données, l’a priori a moins d’influence, ce qui est le comportement souhaité.
La régularisation correspond donc à l’ajout d’un a priori sur les paramètres. Le terme joue le rôle du régulariseur .
Le maximum de vraisemblance comme cas particulier
Que se passe-t-il si nous n’avons aucune préférence a priori sur les paramètres? Cela correspond à un a priori uniforme (ou constant): .
Dans ce cas, est une constante qui n’affecte pas l’optimisation, et le MAP se réduit à l’EMV:
L’EMV est donc un cas particulier du MAP: celui où nous supposons implicitement que toutes les valeurs de paramètres sont également plausibles avant d’observer les données. Cette perspective unifie les deux approches dans un même cadre.
Limites de l’a priori uniforme
L’a priori uniforme (et donc l’EMV) peut être problématique quand les données sont peu nombreuses. Illustrons ceci avec un exemple concret.
Cette estimation de 100% est peu plausible pour une vraie pièce. Le problème est que l’EMV (avec son a priori uniforme implicite) n’a aucun mécanisme pour modérer les estimations extrêmes quand les données sont peu nombreuses. Un a priori informatif peut atténuer ce problème.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# MLE vs MAP for Bernoulli with few observations
fig, axes = plt.subplots(1, 3, figsize=(12, 4))

# Different sample sizes
samples_list = [
    [1, 1, 1],           # 3 heads
    [1, 1, 1, 0],        # 3 heads, 1 tail
    [1, 1, 1, 0, 0, 1, 1, 0, 1, 1]  # 7 heads, 3 tails
]

theta_grid = np.linspace(0.001, 0.999, 200)

for ax, samples in zip(axes, samples_list):
    n1 = sum(samples)  # heads
    n0 = len(samples) - n1  # tails

    # MLE
    theta_mle = n1 / (n0 + n1)

    # Likelihood (unnormalized)
    likelihood = theta_grid**n1 * (1 - theta_grid)**n0
    likelihood = likelihood / likelihood.max()

    ax.plot(theta_grid, likelihood, 'b-', linewidth=2, label='Vraisemblance')
    ax.axvline(theta_mle, color='b', linestyle='--', alpha=0.7,
               label=f'EMV: {theta_mle:.2f}')
    ax.axvline(0.5, color='gray', linestyle=':', alpha=0.5, label=r'$\theta = 0.5$')

    ax.set_xlabel(r'$\theta$')
    ax.set_ylabel('Vraisemblance (normalisée)')
    ax.set_title(f'{n1} faces, {n0} piles (N={len(samples)})')
    ax.legend(fontsize=8)
    ax.set_xlim(0, 1)

plt.tight_layout()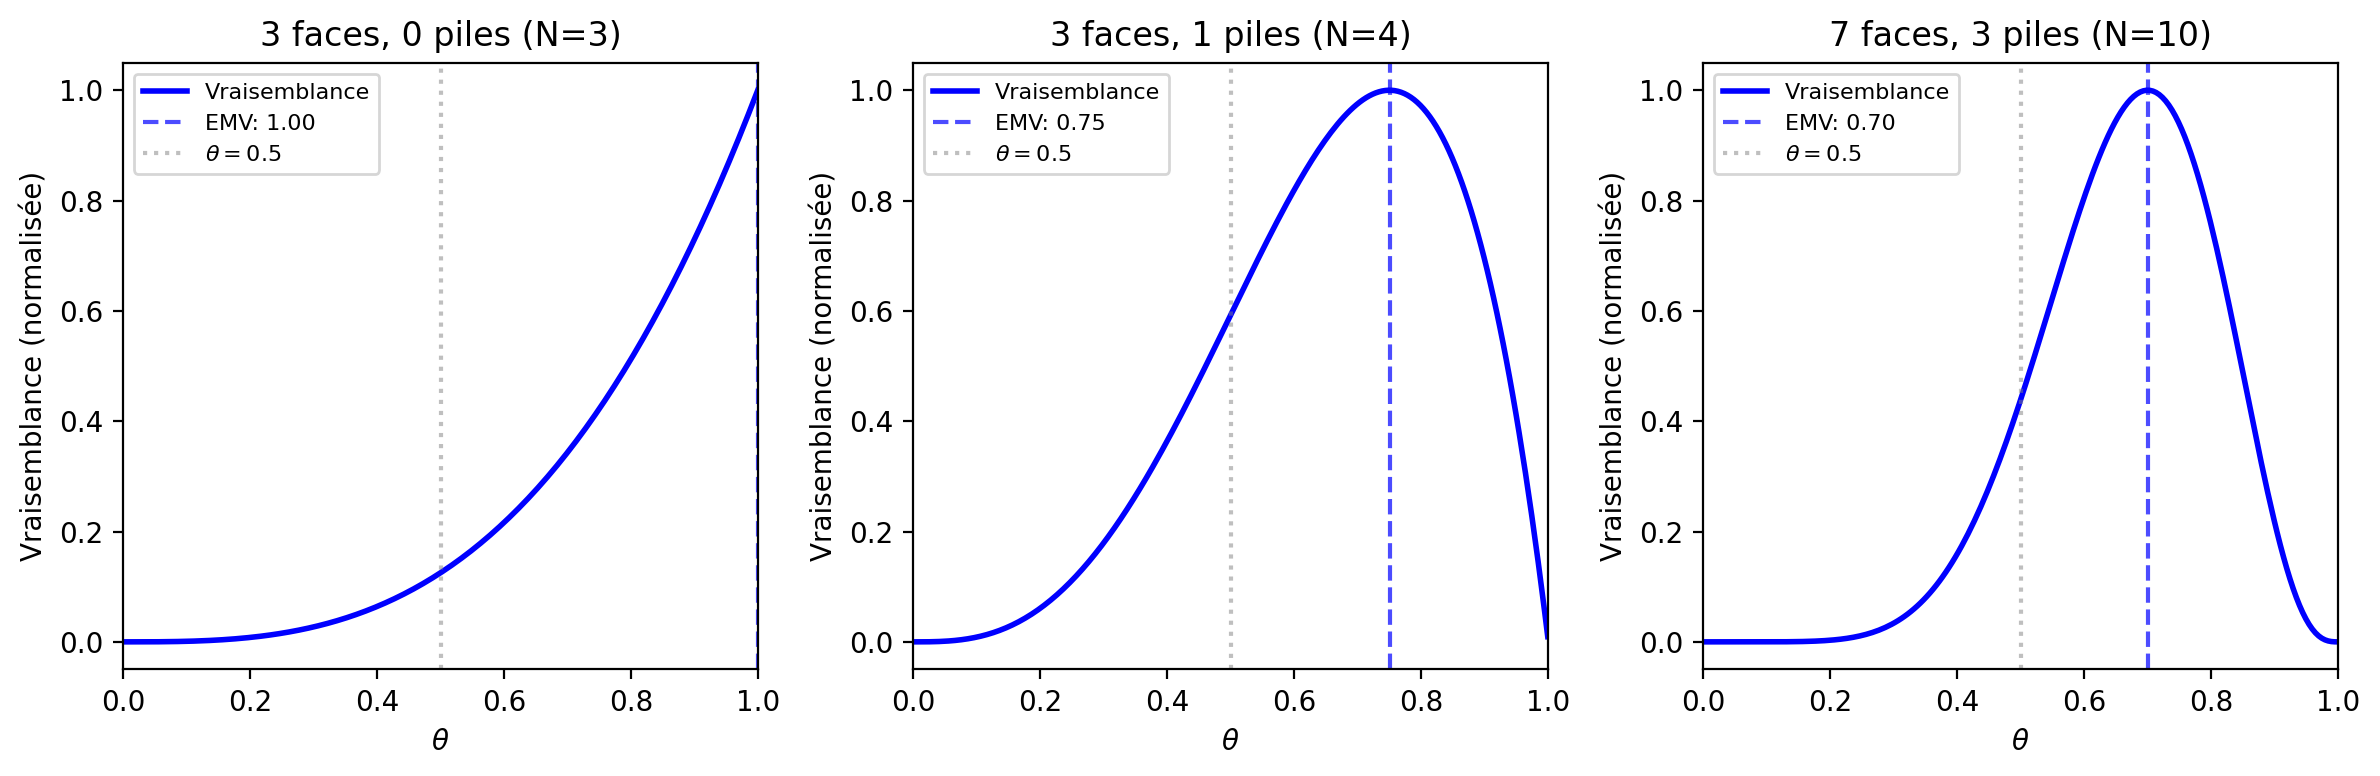
La figure montre la vraisemblance pour différents échantillons. Avec seulement 3 observations (toutes faces), la vraisemblance est maximale à . En augmentant la taille de l’échantillon, l’estimation devient plus raisonnable. Voyons comment un a priori non uniforme peut aider.
Exemple: lissage de Laplace
Revenons à notre exemple de la pièce de monnaie. Utilisons un a priori Beta sur :
Les paramètres et contrôlent la forme de l’a priori. Pour , l’a priori favorise des valeurs de proches de 0,5.
Le logarithme de l’a posteriori (vraisemblance plus a priori) est:
En dérivant et en résolvant, l’estimateur MAP est:
Avec et nos 3 observations de faces:
Cette estimation est plus raisonnable que l’EMV . L’a priori «tire» l’estimation vers des valeurs moins extrêmes.
Le choix correspond au lissage de Laplace (ou add-one smoothing): c’est comme si nous avions observé une face et une pile supplémentaires avant de commencer. Cette technique est particulièrement utile quand certains événements n’ont jamais été observés dans les données.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

theta_grid = np.linspace(0.001, 0.999, 200)

# Left: Prior, likelihood, posterior
ax = axes[0]
n1, n0 = 3, 0  # 3 heads, 0 tails
a, b = 2, 2    # Beta prior parameters

# Prior
prior = stats.beta.pdf(theta_grid, a, b)
prior = prior / prior.max()

# Likelihood
likelihood = theta_grid**n1 * (1 - theta_grid)**n0
likelihood = likelihood / likelihood.max()

# Posterior (Beta(a + n1, b + n0))
posterior = stats.beta.pdf(theta_grid, a + n1, b + n0)
posterior = posterior / posterior.max()

ax.plot(theta_grid, prior, 'g-', linewidth=2, label='A priori Beta(2,2)')
ax.plot(theta_grid, likelihood, 'b--', linewidth=2, label='Vraisemblance')
ax.plot(theta_grid, posterior, 'r-', linewidth=2, label='A posteriori')

theta_mle = n1 / (n1 + n0)
theta_map = (n1 + a - 1) / (n1 + n0 + a + b - 2)
ax.axvline(theta_mle, color='b', linestyle=':', alpha=0.7, label=f'EMV: {theta_mle:.2f}')
ax.axvline(theta_map, color='r', linestyle=':', alpha=0.7, label=f'MAP: {theta_map:.2f}')

ax.set_xlabel(r'$\theta$')
ax.set_ylabel('Densité (normalisée)')
ax.set_title('3 faces, 0 pile')
ax.legend(fontsize=8)
ax.set_xlim(0, 1)

# Right: Effect of different priors
ax = axes[1]
priors = [(1, 1, 'Uniforme'), (2, 2, 'Beta(2,2)'), (5, 5, 'Beta(5,5)')]

for a, b, label in priors:
    theta_map = (n1 + a - 1) / (n1 + n0 + a + b - 2)
    posterior = stats.beta.pdf(theta_grid, a + n1, b + n0)
    posterior = posterior / posterior.max()
    ax.plot(theta_grid, posterior, linewidth=2, label=f'{label}: MAP={theta_map:.2f}')

ax.axvline(1.0, color='gray', linestyle='--', alpha=0.5, label='EMV: 1.00')
ax.set_xlabel(r'$\theta$')
ax.set_ylabel('A posteriori (normalisé)')
ax.set_title('Effet de différents a priori')
ax.legend(fontsize=8)
ax.set_xlim(0, 1)

plt.tight_layout()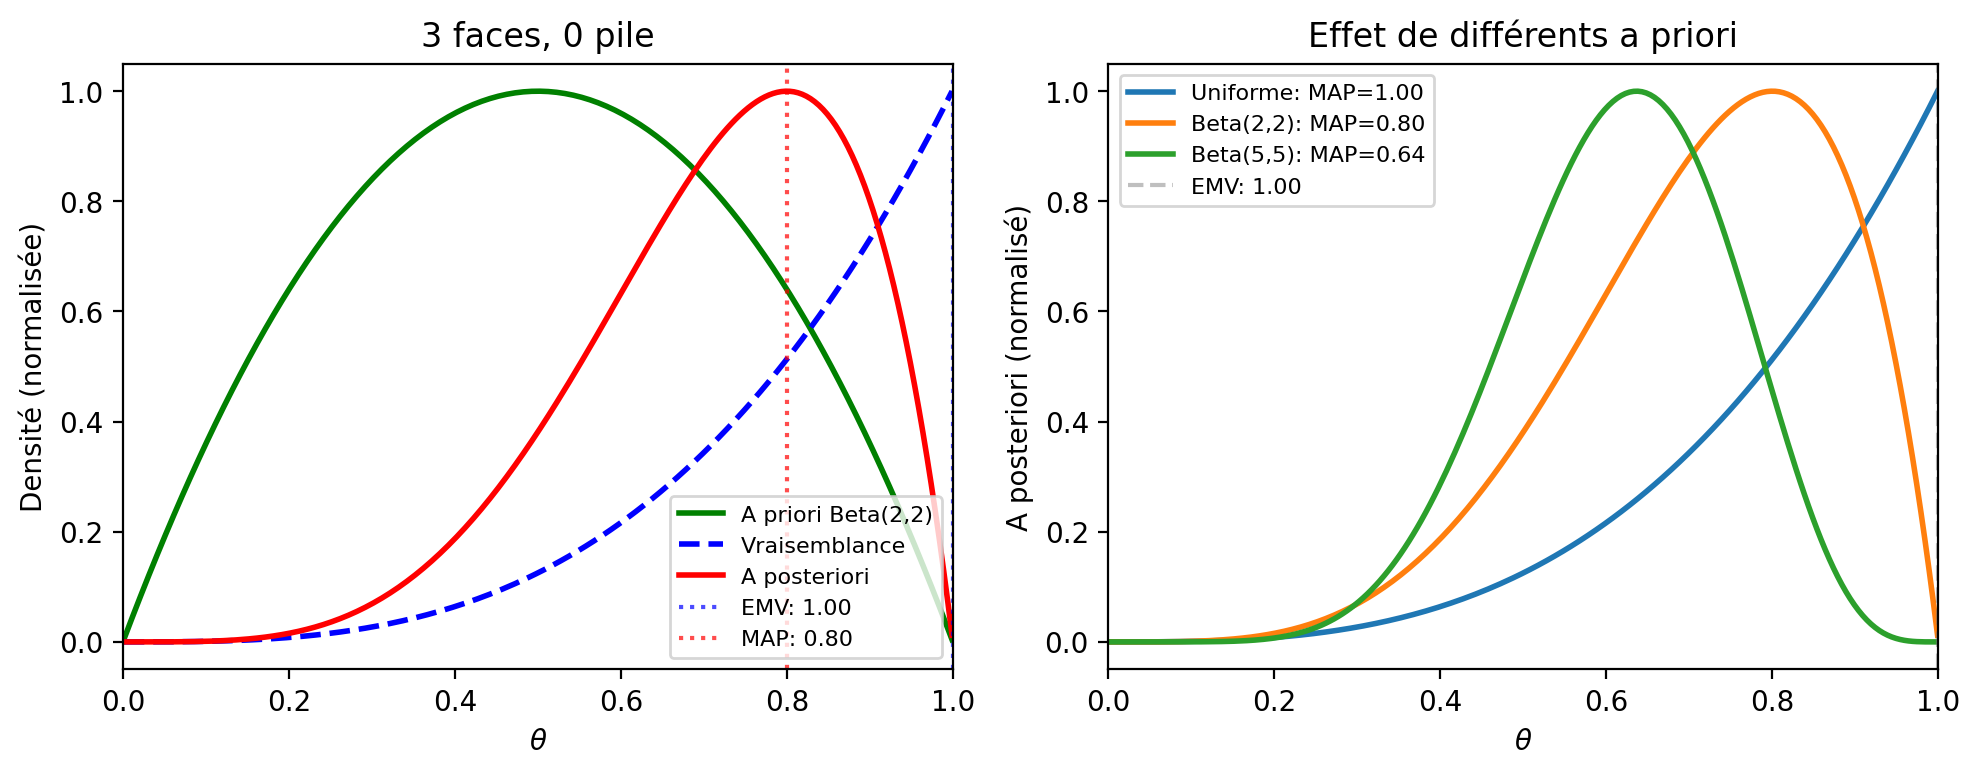
La figure de gauche montre comment l’a posteriori combine l’a priori et la vraisemblance. L’a priori Beta(2,2) «tire» l’estimation vers 0,5, résultant en un MAP de 0,8 au lieu de l’EMV de 1,0. La figure de droite montre l’effet de différents a priori: plus l’a priori est fort (variance faible), plus l’estimation est proche de 0,5.
Régression ridge = MAP avec a priori gaussien
Appliquons maintenant ce cadre bayésien à la régression linéaire. Si nous plaçons un a priori gaussien isotrope sur les paramètres:
cet a priori exprime la croyance que les paramètres sont probablement proches de zéro, avec une incertitude contrôlée par .
Le logarithme négatif de cet a priori est:
L’estimateur MAP devient:
C’est exactement Ridge, avec . Cette correspondance donne une interprétation de l’hyperparamètre. Une grande valeur de (petite variance ) traduit une forte croyance que les paramètres sont proches de zéro. Une petite valeur de (grande variance ) correspond à un a priori peu informatif: on fait confiance aux données.
L’a priori gaussien sur les paramètres est parfois appelé dégradation des poids (weight decay) dans le contexte des réseaux de neurones, car il «tire» les paramètres vers zéro pendant l’entraînement.
Une troisième perspective: la théorie de l’information
La théorie de l’information offre un autre regard sur l’apprentissage. Elle permet de voir le maximum de vraisemblance comme la recherche d’une distribution «proche» des données, au sens d’une mesure de distance entre distributions.
Entropie et incertitude
Commençons par un exemple concret. Considérons une pièce de monnaie équilibrée: chaque lancer donne face ou pile avec probabilité 1/2. Avant le lancer, nous sommes dans l’incertitude totale—nous ne pouvons pas prédire le résultat. Comparons avec une pièce truquée qui donne face 99% du temps: notre incertitude est bien moindre, car nous pouvons prédire «face» avec confiance.
L’entropie quantifie cette incertitude. Pour une distribution discrète sur des résultats , elle est définie par:
où nous utilisons la convention .
Pourquoi le logarithme? Pourquoi les bits?
Le choix du logarithme n’est pas arbitraire. Imaginons que nous voulions deviner un résultat en posant des questions binaires (oui/non). Pour une pièce équilibrée, une seule question suffit: «Est-ce face?». Pour un dé à 6 faces, il faut en moyenne questions. L’entropie mesure exactement ce nombre minimal de questions binaires nécessaires en moyenne.
La base du logarithme détermine l’unité de mesure:
| Base | Unité | Usage |
|---|---|---|
| bits | Théorie de l’information, compression | |
| nats | Apprentissage automatique, optimisation | |
| hartleys | Historique, télécommunications |
En apprentissage automatique, nous utilisons souvent le logarithme naturel () car il simplifie les calculs de gradient. La conversion est simple: . L’interprétation reste la même—seule l’échelle change.
Calculons l’entropie de notre pièce équilibrée. Avec :
Pour la pièce truquée avec et :
L’entropie de la pièce truquée est bien plus faible: nous avons moins d’incertitude sur le résultat.
Source
import numpy as np
import matplotlib.pyplot as plt

def entropy(p):
    """Calcule l'entropie en bits d'une distribution discrète."""
    p = np.array(p)
    p = p[p > 0]  # ignorer les probabilités nulles
    return -np.sum(p * np.log2(p))

# Quatre distributions sur 4 résultats possibles
distributions = [
    ([0.25, 0.25, 0.25, 0.25], 'Uniforme'),
    ([0.7, 0.1, 0.1, 0.1], 'Modérément concentrée'),
    ([0.97, 0.01, 0.01, 0.01], 'Très concentrée'),
    ([1.0, 0.0, 0.0, 0.0], 'Déterministe'),
]

fig, axes = plt.subplots(1, 4, figsize=(12, 3))
x = np.arange(4)
labels = ['A', 'B', 'C', 'D']

for ax, (probs, title) in zip(axes, distributions):
    H = entropy(probs)
    bars = ax.bar(x, probs, color='steelblue', edgecolor='black', alpha=0.7)
    ax.set_xticks(x)
    ax.set_xticklabels(labels)
    ax.set_ylim(0, 1.1)
    ax.set_xlabel('Résultat')
    ax.set_ylabel('Probabilité')
    ax.set_title(f'{title}\n$\\mathbb{{H}} = {H:.2f}$ bits')

plt.tight_layout()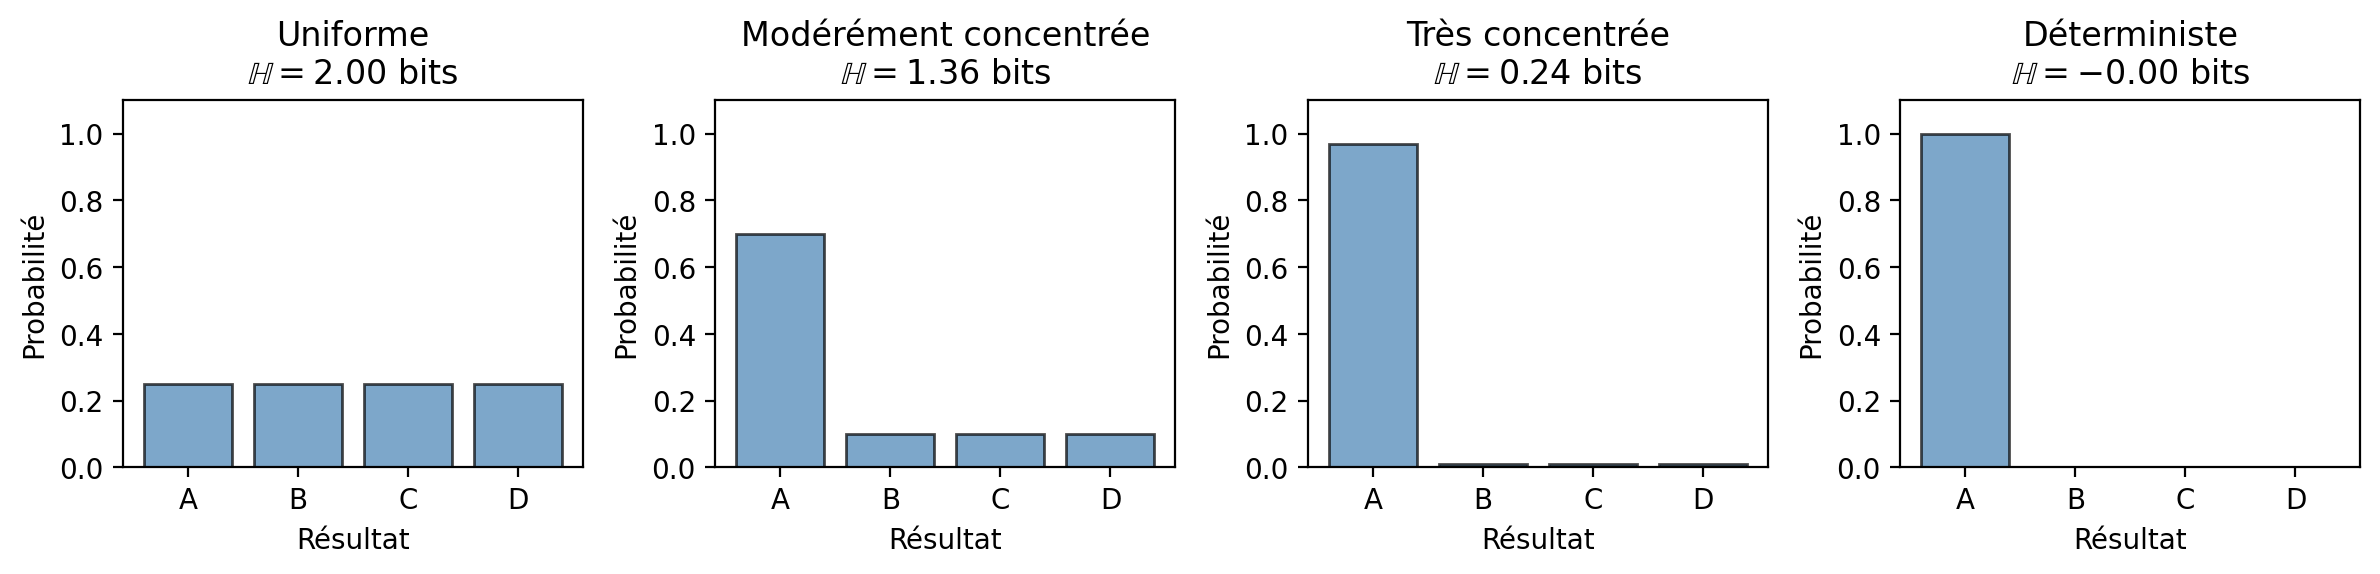
La figure montre quatre distributions sur les mêmes quatre résultats possibles. À gauche, la distribution uniforme maximise l’entropie: chaque résultat est également probable, donc l’incertitude est maximale. À droite, la distribution déterministe concentre toute la masse sur un seul résultat: l’entropie est nulle car il n’y a aucune incertitude.
Pour une distribution continue, l’entropie différentielle est définie de manière analogue par . Une gaussienne a une entropie , qui croît avec la variance: plus la distribution est étalée, plus l’incertitude est grande.
Mesurer la différence entre distributions
L’entropie mesure l’incertitude d’une distribution. Mais en apprentissage, nous avons souvent deux distributions: la «vraie» distribution des données, et notre modèle qui tente de l’approximer. Comment mesurer à quel point diffère de ?
Imaginons que nous voulions prédire la météo à Montréal. La vraie distribution pourrait être: soleil 40%, nuageux 35%, pluie 20%, neige 5%. Si notre modèle prédit: soleil 60%, nuageux 20%, pluie 15%, neige 5%, nous avons un décalage. Nous surestimons le soleil et sous-estimons les nuages. Mais comment quantifier ce décalage?
La divergence de Kullback-Leibler (ou divergence KL) répond à cette question:
On peut l’interpréter ainsi: si les données suivent , mais que nous utilisons pour faire des prédictions, la divergence KL mesure l’inefficacité de ce choix. Plus diffère de , plus la divergence KL est grande.
Trois propriétés sont à retenir:
toujours (c’est l’inégalité de Gibbs)
si et seulement si
La divergence KL n’est pas symétrique: en général
Cette asymétrie est importante. Intuitivement, mesure la surprise de quelqu’un qui croit en mais observe des données de . Ce n’est pas la même chose que la surprise de quelqu’un qui croit en mais observe des données de .
Source
import numpy as np
import matplotlib.pyplot as plt

def kl_divergence(p, q):
    """Calcule la divergence KL de p vers q (en bits)."""
    p, q = np.array(p), np.array(q)
    # Éviter log(0) en ne considérant que les p[i] > 0
    mask = p > 0
    return np.sum(p[mask] * np.log2(p[mask] / q[mask]))

# Deux distributions sur 4 résultats
p = np.array([0.4, 0.35, 0.2, 0.05])  # vraie distribution (météo)
q = np.array([0.6, 0.2, 0.15, 0.05])  # modèle (surestime le soleil)

kl_pq = kl_divergence(p, q)
kl_qp = kl_divergence(q, p)

fig, axes = plt.subplots(1, 3, figsize=(12, 3.5))
x = np.arange(4)
labels = ['Soleil', 'Nuageux', 'Pluie', 'Neige']
width = 0.35

# Gauche: les deux distributions
ax = axes[0]
ax.bar(x - width/2, p, width, label='Vraie distribution $p$', color='steelblue', alpha=0.8)
ax.bar(x + width/2, q, width, label='Modèle $q$', color='coral', alpha=0.8)
ax.set_xticks(x)
ax.set_xticklabels(labels, rotation=15)
ax.set_ylabel('Probabilité')
ax.set_title('Comparaison de $p$ et $q$')
ax.legend(fontsize=9)
ax.set_ylim(0, 0.7)

# Centre: contribution de chaque terme à KL(p||q)
ax = axes[1]
contributions = p * np.log2(p / q)
colors = ['green' if c >= 0 else 'red' for c in contributions]
ax.bar(x, contributions, color=colors, alpha=0.7, edgecolor='black')
ax.axhline(0, color='black', linewidth=0.5)
ax.set_xticks(x)
ax.set_xticklabels(labels, rotation=15)
ax.set_ylabel('Contribution (bits)')
ax.set_title(f'$D_{{\\mathrm{{KL}}}}(p \\| q) = {kl_pq:.3f}$ bits')

# Droite: asymétrie
ax = axes[2]
bars = ax.bar(['$D_{\\mathrm{KL}}(p \\| q)$', '$D_{\\mathrm{KL}}(q \\| p)$'],
              [kl_pq, kl_qp], color=['steelblue', 'coral'], alpha=0.7, edgecolor='black')
ax.set_ylabel('Divergence KL (bits)')
ax.set_title('Asymétrie de la divergence KL')
for bar, val in zip(bars, [kl_pq, kl_qp]):
    ax.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.005,
            f'{val:.3f}', ha='center', va='bottom', fontsize=10)

plt.tight_layout()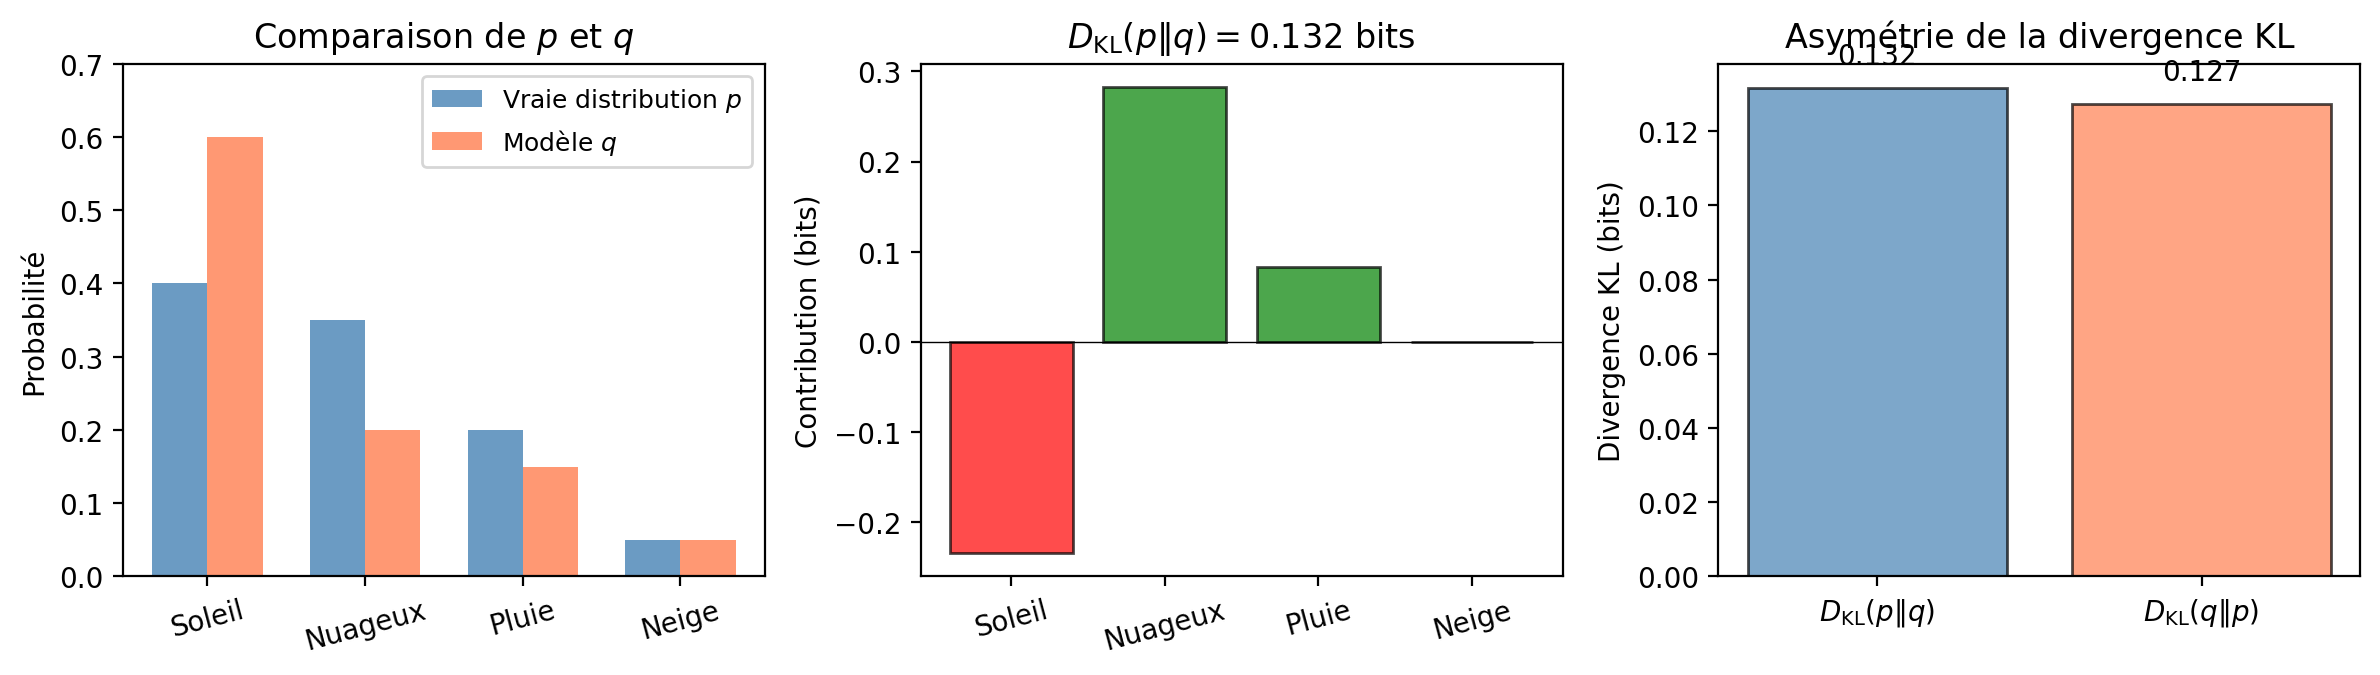
La figure illustre la divergence KL entre deux distributions météo. Le panneau de gauche montre les deux distributions: la vraie et notre modèle . Le panneau central décompose par résultat: les barres positives indiquent où (le modèle sous-estime), les barres négatives où (le modèle surestime). Le panneau de droite montre l’asymétrie: .
Entropie croisée
La divergence KL se décompose naturellement en deux termes. Définissons d’abord l’entropie croisée entre et :
L’entropie croisée mesure la surprise moyenne quand on utilise pour prédire des événements qui suivent . Si , on retrouve l’entropie ordinaire . Sinon, l’entropie croisée est plus grande que l’entropie: utiliser le «mauvais» modèle augmente la surprise moyenne.
La relation avec la divergence KL est:
Cette décomposition a une interprétation importante. L’entropie est irréductible: c’est l’incertitude intrinsèque des données. La divergence KL est réductible: en améliorant notre modèle pour qu’il se rapproche de , nous pouvons la réduire à zéro. L’entropie croisée est leur somme.
Source
import numpy as np
import matplotlib.pyplot as plt

def entropy(p):
    p = np.array(p)
    p = p[p > 0]
    return -np.sum(p * np.log2(p))

def cross_entropy(p, q):
    p, q = np.array(p), np.array(q)
    mask = p > 0
    return -np.sum(p[mask] * np.log2(q[mask]))

def kl_divergence(p, q):
    return cross_entropy(p, q) - entropy(p)

# Même distributions que précédemment
p = np.array([0.4, 0.35, 0.2, 0.05])
q = np.array([0.6, 0.2, 0.15, 0.05])

H_p = entropy(p)
H_ce = cross_entropy(p, q)
KL = kl_divergence(p, q)

fig, ax = plt.subplots(figsize=(8, 4))

# Barres empilées montrant la décomposition
bar_width = 0.5
ax.bar([0], [H_p], bar_width, label=f'$\\mathbb{{H}}(p) = {H_p:.3f}$ (irréductible)',
       color='steelblue', alpha=0.8)
ax.bar([0], [KL], bar_width, bottom=[H_p],
       label=f'$D_{{\\mathrm{{KL}}}}(p \\| q) = {KL:.3f}$ (réductible)',
       color='coral', alpha=0.8)

# Ligne montrant l'entropie croisée totale
ax.hlines(H_ce, -0.4, 0.4, colors='black', linestyles='--', linewidth=2)
ax.text(0.5, H_ce, f'$\\mathbb{{H}}_{{\\mathrm{{ce}}}}(p, q) = {H_ce:.3f}$',
        va='center', fontsize=11)

ax.set_xlim(-1, 2)
ax.set_ylim(0, 2.5)
ax.set_xticks([])
ax.set_ylabel('Bits')
ax.set_title('Décomposition de l\'entropie croisée')
ax.legend(loc='upper right', fontsize=10)

plt.tight_layout()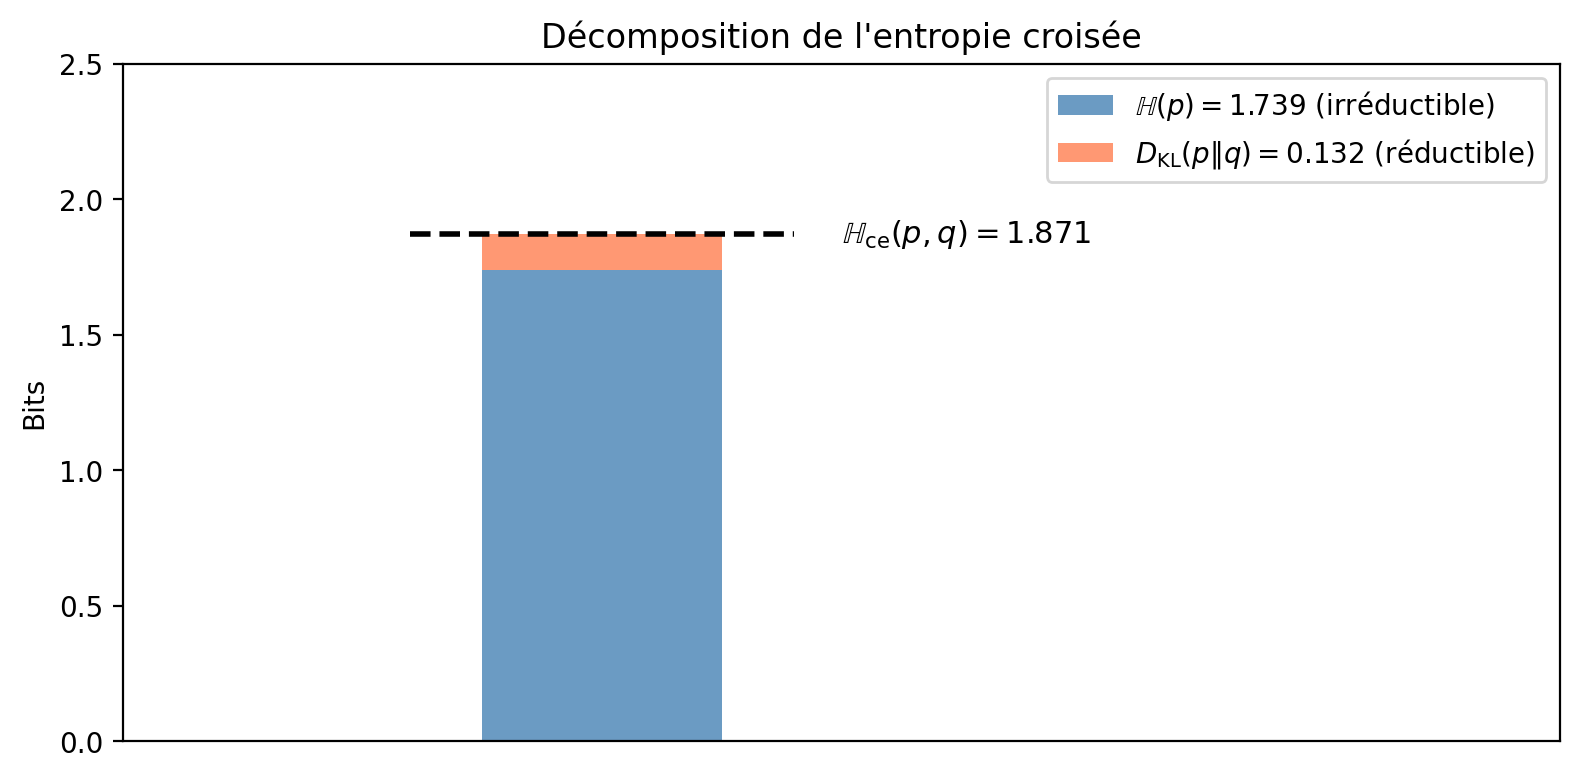
La figure montre la décomposition de l’entropie croisée. La partie bleue (entropie ) est incompressible: c’est l’incertitude des données elles-mêmes. La partie orange (divergence KL) représente le «gaspillage» dû à l’utilisation d’un modèle imparfait. En apprentissage, nous ne pouvons pas réduire , mais nous pouvons minimiser la divergence KL en trouvant un meilleur modèle.
La distribution empirique
Avant de relier ces concepts au maximum de vraisemblance, nous devons définir un objet central: la distribution empirique. C’est simplement la distribution construite à partir des données observées.
Prenons un exemple concret. Supposons que nous lancions un dé (possiblement truqué) six fois et obtenions les résultats: 3, 1, 3, 5, 3, 2. La distribution empirique compte la fréquence de chaque résultat:
| Résultat | Occurrences | Fréquence |
|---|---|---|
| 1 | 1 | 1/6 |
| 2 | 1 | 1/6 |
| 3 | 3 | 3/6 = 0,5 |
| 4 | 0 | 0 |
| 5 | 1 | 1/6 |
| 6 | 0 | 0 |
Cette distribution empirique est notre meilleure estimation de la vraie distribution à partir de ces 6 observations. Bien sûr, avec si peu de données, elle est bruitée: le résultat 4 a une fréquence nulle, mais ce n’est probablement pas parce que le dé ne peut jamais donner 4.
Formellement, la distribution empirique place une masse sur chaque observation:
où est la fonction de Dirac. Pour une variable discrète, cela revient simplement à compter les fréquences: .
Source
import numpy as np
import matplotlib.pyplot as plt

# Vraie distribution (dé légèrement truqué, favorise le 3)
p_true = np.array([0.15, 0.15, 0.25, 0.15, 0.15, 0.15])

np.random.seed(42)

fig, axes = plt.subplots(1, 3, figsize=(12, 3.5))
sample_sizes = [20, 100, 1000]
x = np.arange(1, 7)

for ax, N in zip(axes, sample_sizes):
    # Générer N échantillons de la vraie distribution
    samples = np.random.choice(np.arange(1, 7), size=N, p=p_true)

    # Distribution empirique
    counts = np.bincount(samples, minlength=7)[1:]  # ignorer l'index 0
    p_empirical = counts / N

    # Tracer
    width = 0.35
    ax.bar(x - width/2, p_true, width, label='Vraie distribution $p$',
           color='steelblue', alpha=0.8)
    ax.bar(x + width/2, p_empirical, width, label='Distribution empirique $\\hat{p}$',
           color='coral', alpha=0.8)

    # Calculer la divergence KL (avec lissage pour éviter log(0))
    p_smooth = np.clip(p_empirical, 1e-10, 1)
    kl = np.sum(p_true * np.log2(p_true / p_smooth))

    ax.set_xticks(x)
    ax.set_xlabel('Face du dé')
    ax.set_ylabel('Probabilité')
    ax.set_title(f'$N = {N}$ observations\n$D_{{\\mathrm{{KL}}}}(p \\| \\hat{{p}}) \\approx {kl:.3f}$ bits')
    ax.set_ylim(0, 0.35)
    ax.legend(fontsize=8, loc='upper right')

plt.tight_layout()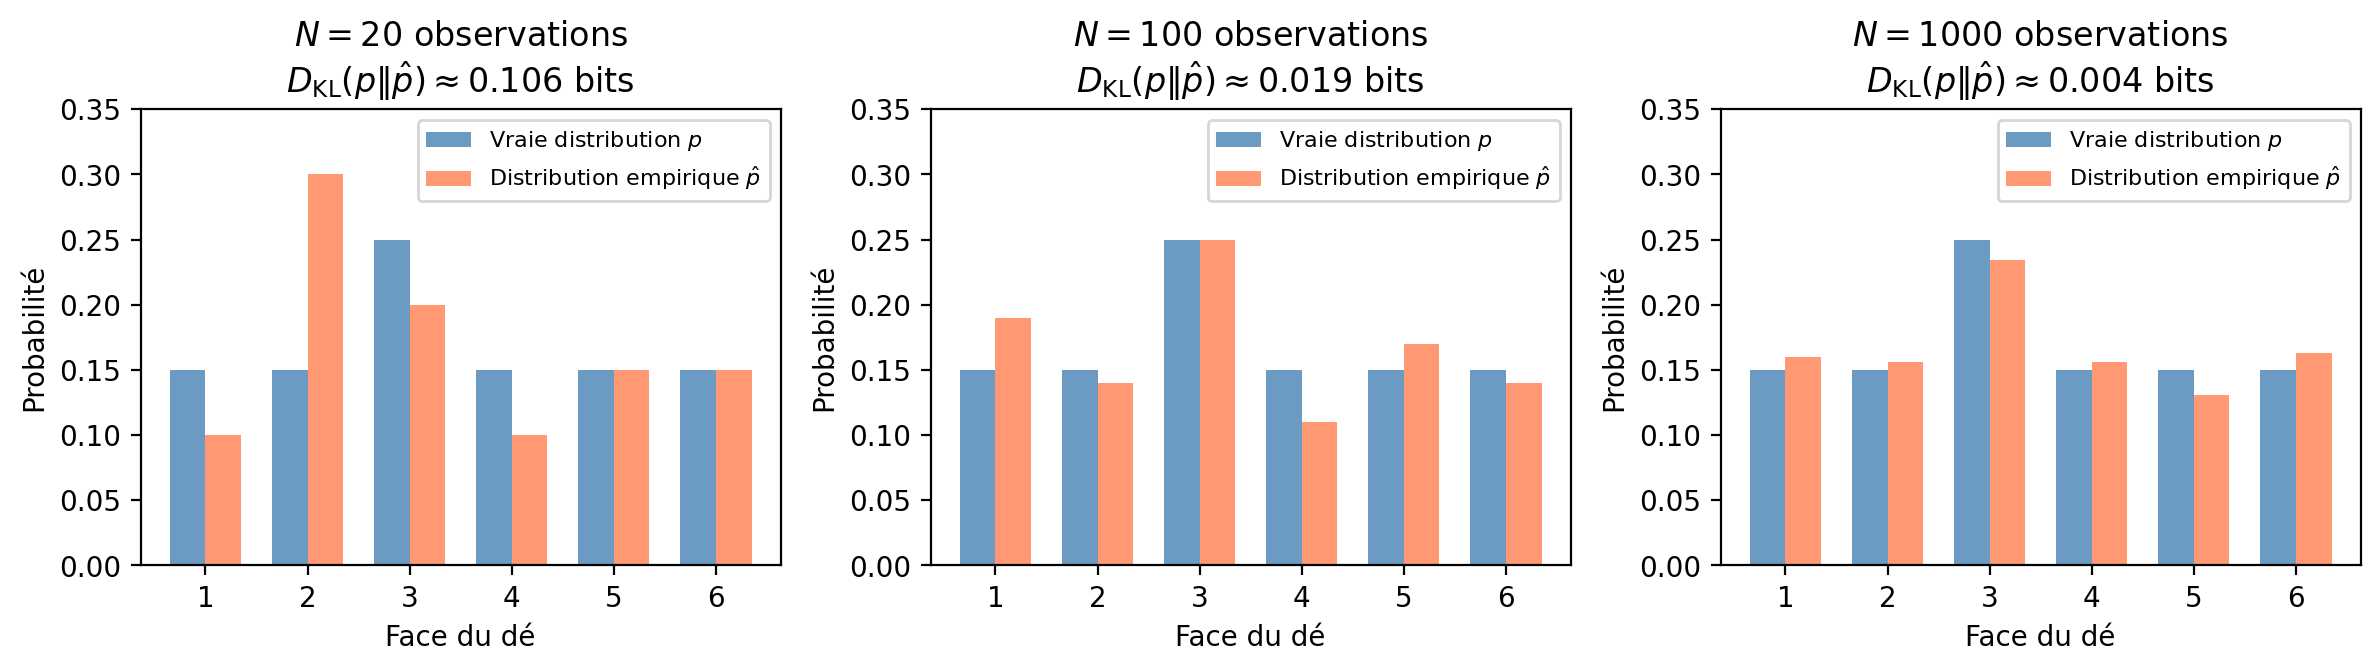
La figure montre comment la distribution empirique converge vers la vraie distribution quand le nombre d’observations augmente. Avec , la distribution empirique est bruitée et diffère notablement de la vraie. Avec , les deux distributions sont presque identiques, et la divergence KL est proche de zéro.
Le maximum de vraisemblance minimise la divergence KL
Nous pouvons maintenant faire le lien avec l’EMV. Mais avant d’écrire les équations, posons-nous une question simple: que signifie «apprendre un bon modèle»?
Imaginons que nous voulions prédire la météo. Nous avons observé qu’à Montréal en novembre, il pleut environ 30% du temps. Un bon modèle devrait refléter cette réalité: si notre modèle prédit 30% de pluie, il sera utile pour planifier. S’il prédit 10% ou 80%, ses prédictions seront systématiquement décalées par rapport à ce qui se passe vraiment.
Ce raisonnement révèle ce que nous cherchons réellement: un modèle dont les prédictions ressemblent à ce que nous observons. Si les données montrent 30% de pluie, nous voulons un modèle qui dit 30%. Si un dé tombe sur 6 dans 17% des lancers, nous voulons un modèle qui prédit 17% de chances pour cette face. En d’autres termes, nous voulons que notre modèle soit proche de la distribution empirique des données.
La divergence KL formalise cette intuition. Elle mesure à quel point notre modèle diffère de ce que nous avons observé. Minimiser cette divergence, c’est chercher le modèle qui colle le mieux aux données.
Mathématiquement, nous voulons minimiser:
Le premier terme, , est l’entropie de la distribution empirique. C’est une propriété des données elles-mêmes: si nous avons observé 70% de succès et 30% d’échecs, cette répartition a une certaine incertitude intrinsèque, et nous n’y pouvons rien. Ce terme ne dépend pas de .
Pour minimiser la divergence KL, il suffit donc de minimiser le second terme: l’entropie croisée . C’est là que se cache la surprise: cette entropie croisée n’est autre que la log-vraisemblance négative moyenne:
Le maximum de vraisemblance trouve donc les paramètres qui minimisent la divergence KL entre notre modèle et la distribution empirique des données. Ce résultat est remarquable: en maximisant la vraisemblance—une quantité qui semble purement technique—nous faisons quelque chose de très intuitif. Nous cherchons le modèle qui ressemble le plus à ce que nous avons observé.
Source
import numpy as np
import matplotlib.pyplot as plt

# Exemple: ajuster un paramètre de Bernoulli
# Données: 7 succès sur 10 essais
N = 10
k = 7  # nombre de succès

# Distribution empirique: p(Y=1) = 7/10, p(Y=0) = 3/10
p_empirical = np.array([1 - k/N, k/N])  # [p(0), p(1)]

# Modèle: Bernoulli(theta)
theta_range = np.linspace(0.01, 0.99, 200)

# Calculer KL(p_empirique || p_theta) pour chaque theta
def kl_bernoulli(p_emp, theta):
    p_model = np.array([1 - theta, theta])
    # Éviter log(0)
    mask = p_emp > 0
    return np.sum(p_emp[mask] * np.log(p_emp[mask] / p_model[mask]))

kl_values = [kl_bernoulli(p_empirical, theta) for theta in theta_range]

fig, axes = plt.subplots(1, 2, figsize=(11, 4))

# Gauche: les distributions
ax = axes[0]
theta_mle = k / N
x = np.array([0, 1])
width = 0.25
ax.bar(x - width, p_empirical, width, label='Distribution empirique',
       color='coral', alpha=0.8)
ax.bar(x, [1 - 0.5, 0.5], width, label='Modèle $\\theta = 0.5$',
       color='lightgray', alpha=0.8)
ax.bar(x + width, [1 - theta_mle, theta_mle], width, label=f'Modèle $\\theta = {theta_mle}$ (EMV)',
       color='steelblue', alpha=0.8)
ax.set_xticks(x)
ax.set_xticklabels(['$Y = 0$', '$Y = 1$'])
ax.set_ylabel('Probabilité')
ax.set_title('Distribution empirique vs modèles')
ax.legend(fontsize=9)

# Droite: KL en fonction de theta
ax = axes[1]
ax.plot(theta_range, kl_values, 'b-', linewidth=2)
ax.axvline(theta_mle, color='red', linestyle='--', linewidth=2,
           label=f'EMV: $\\hat{{\\theta}} = {theta_mle}$')
ax.set_xlabel('Paramètre $\\theta$')
ax.set_ylabel('$D_{\\mathrm{KL}}(\\hat{p} \\| p_\\theta)$')
ax.set_title('Divergence KL en fonction de $\\theta$')
ax.legend()
ax.set_xlim(0, 1)

plt.tight_layout()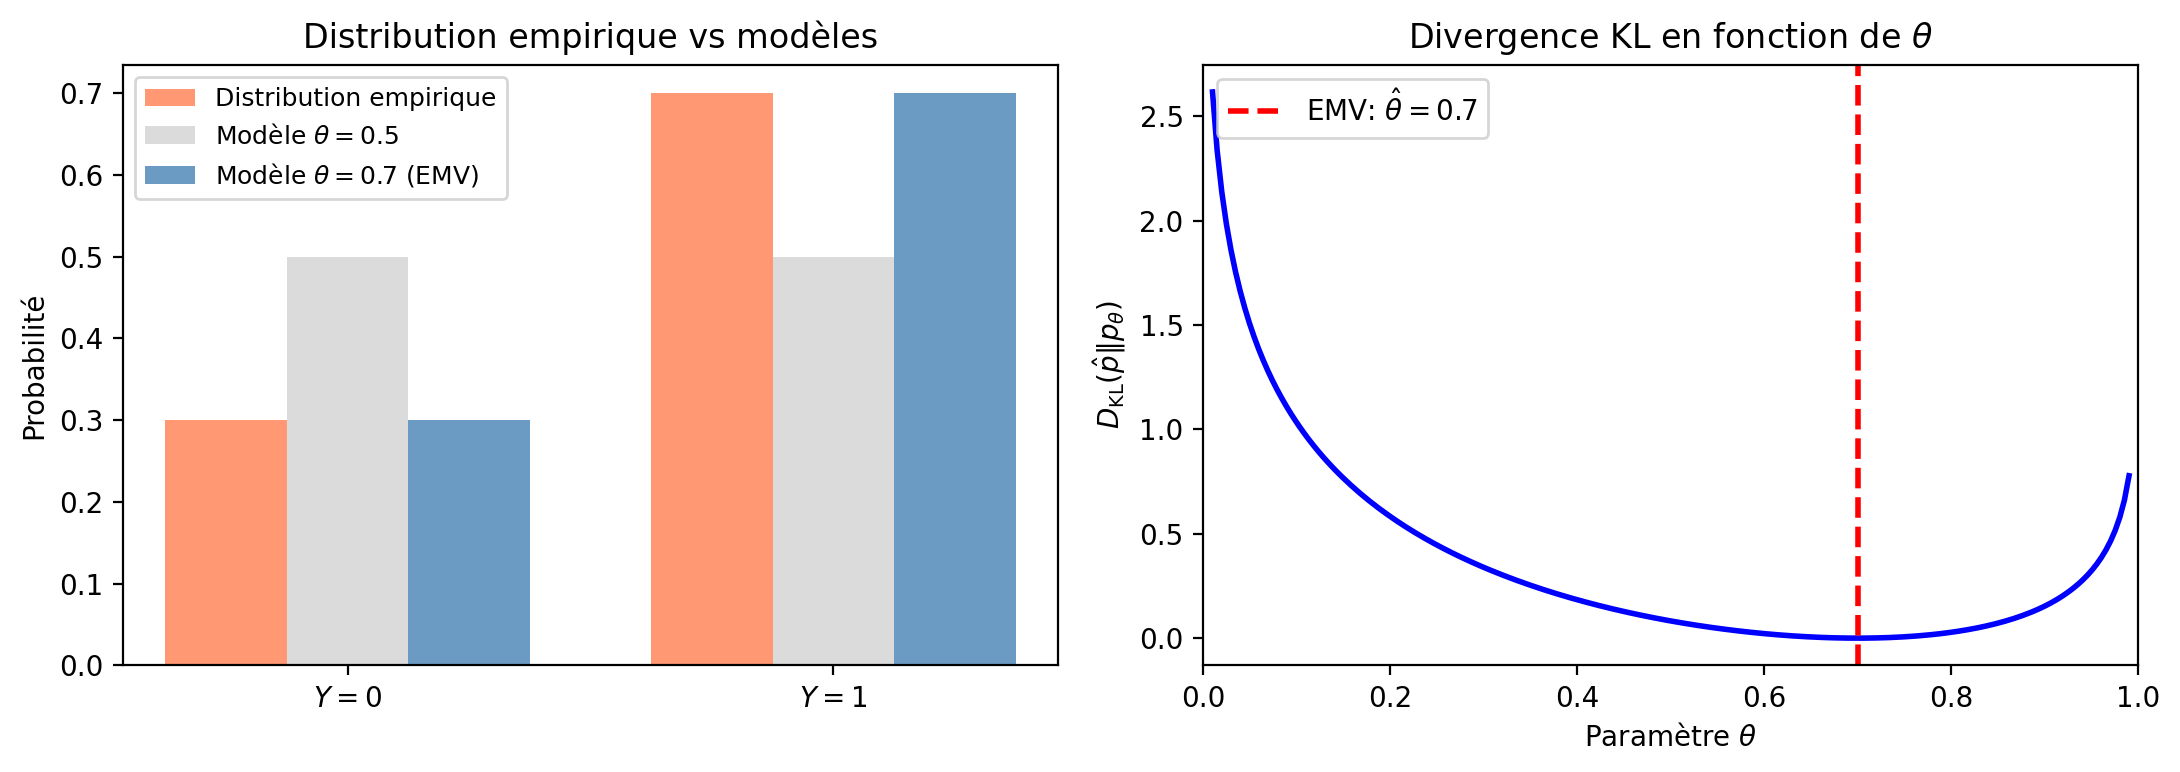
La figure illustre le lien entre EMV et divergence KL sur un exemple simple: ajuster un paramètre de Bernoulli à partir de 10 observations dont 7 sont des succès. Le panneau de gauche compare la distribution empirique (7/10 de succès) à deux modèles: (pièce équilibrée) et (l’EMV). Le panneau de droite montre que la divergence KL est minimale exactement quand égale la fréquence empirique des succès—c’est l’EMV.
On peut visualiser cette idée géométriquement. Imaginons un espace où chaque point représente une distribution de probabilité. La distribution empirique—ce que nous avons observé—est un point fixe dans cet espace. Notre famille de modèles trace une courbe (ou une surface) dans cet espace quand varie. Le maximum de vraisemblance cherche le point sur cette courbe qui est le plus proche de la distribution empirique. La divergence KL joue le rôle d’une «distance» (bien qu’elle ne soit pas symétrique): plus elle est petite, plus notre modèle ressemble à ce que nous avons observé.
Trois langages, un même algorithme
Nous venons de montrer que minimiser la log-vraisemblance négative revient à minimiser la divergence KL avec la distribution empirique. Puisque et que l’entropie des données est fixe, minimiser la KL revient à minimiser l’entropie croisée entre la distribution empirique et notre modèle. Cette observation unifie régression et classification sous un même principe.
Pour la régression, nous modélisons . La log-vraisemblance d’une observation est . Minimiser la LVN—et donc la divergence KL—revient à minimiser la somme des erreurs quadratiques . La perte quadratique découle directement de l’hypothèse gaussienne.
Pour la classification binaire, nous modélisons , où est la sigmoïde. La log-vraisemblance est . Minimiser la LVN donne l’entropie croisée binaire , où .
Pour la classification multiclasse avec classes, nous modélisons par une distribution catégorielle dont les probabilités sont données par le softmax: . La log-vraisemblance d’une observation de classe est . En utilisant l’encodage one-hot où si l’exemple appartient à la classe , minimiser la LVN donne l’entropie croisée multiclasse:
Dans les trois cas, le même principe s’applique: spécifier un modèle probabiliste pour , puis minimiser la divergence KL avec les données. Le choix du modèle détermine la perte. L’hypothèse gaussienne mène à la perte quadratique. L’hypothèse de Bernoulli mène à l’entropie croisée binaire. L’hypothèse catégorielle mène à l’entropie croisée multiclasse avec softmax. Inversement, utiliser une de ces pertes revient implicitement à supposer le modèle probabiliste correspondant.
Pourquoi maintenir trois langages—décisionnel, probabiliste, informationnel—s’ils convergent vers les mêmes algorithmes? Parce qu’ils répondent à des questions différentes. Le langage décisionnel est opérationnel: il dit comment construire un algorithme (définir une perte, minimiser). Le langage probabiliste est interprétatif: il explicite nos hypothèses sur les données et permet de quantifier l’incertitude. Le langage informationnel est géométrique: il montre que l’apprentissage consiste à trouver la distribution la plus proche des données dans un espace de modèles.
Résumé
Ce chapitre a présenté le cadre probabiliste pour l’apprentissage supervisé.
Nous avons d’abord introduit le cadre bayésien, qui traite les paramètres comme des variables aléatoires. Le théorème de Bayes permet de combiner nos croyances initiales (l’a priori) avec l’information des données (la vraisemblance) pour obtenir une distribution a posteriori sur les paramètres. Cette distribution capture notre incertitude après observation des données, mais son calcul exact est souvent coûteux.
Le maximum a posteriori (MAP) contourne cette difficulté en retenant uniquement le mode de la distribution a posteriori—la valeur des paramètres la plus probable. Avec un a priori gaussien centré en zéro, le MAP correspond exactement à la régression Ridge: le coefficient de régularisation encode la force de notre croyance que les paramètres sont petits. Le maximum de vraisemblance (EMV) est le cas particulier où l’a priori est uniforme et n’influence pas l’estimation.
La théorie de l’information offre une interprétation géométrique de l’EMV: minimiser la log-vraisemblance négative revient à minimiser la divergence de Kullback-Leibler entre notre modèle et la distribution empirique des données. Cette perspective unifie régression et classification. Dans les deux cas, nous cherchons le modèle paramétrique le plus «proche» des observations: la perte quadratique découle de l’hypothèse de bruit gaussien, l’entropie croisée découle de l’hypothèse d’étiquettes suivant une distribution de Bernoulli ou catégorielle.
Les perspectives décisionnelle, probabiliste et informationnelle sont complémentaires. La première guide la construction d’algorithmes, la deuxième explicite nos hypothèses et quantifie l’incertitude, la troisième offre une vision géométrique de l’apprentissage.
Le chapitre suivant étend ces fondations aux réseaux de neurones, où la capacité d’apprendre des représentations non linéaires ouvre de nouvelles possibilités.
Exercices
Exercice 1: Maximum de vraisemblance
Soit un échantillon i.i.d. d’une distribution exponentielle de paramètre :
Écrivez la vraisemblance et la log-vraisemblance .
Dérivez l’estimateur du maximum de vraisemblance (EMV) .
Si les observations sont , calculez .
Solution Exercice 1
Exercice 2: Maximum de vraisemblance pour classification binaire ★
Soit un problème de classification binaire avec observations où . On modélise la probabilité de la classe positive par:
Écrivez la vraisemblance pour observations i.i.d. suivant une distribution de Bernoulli.
Écrivez la log-vraisemblance .
Montrez que maximiser la log-vraisemblance revient à minimiser l’entropie croisée binaire.
Application: Pour les observations avec les scores égaux à , calculez la log-vraisemblance.
Solution Exercice 2
Exercice 3: EMV comme cas particulier de MAP ★
Le théorème de Bayes nous donne la distribution a posteriori des paramètres:
L’estimateur MAP maximise cette distribution a posteriori.
Écrivez la log-posterior en fonction de la log-vraisemblance et du log a priori.
Supposons un a priori uniforme (constant): pour tout . Montrez que l’estimateur MAP se réduit à l’estimateur du maximum de vraisemblance (EMV).
Pour quels autres types d’a priori l’EMV et le MAP coïncident-ils?
Expliquez pourquoi utiliser un a priori uniforme peut être problématique dans certains cas.
Solution Exercice 3
Log-posterior:
Le terme ne dépend pas de , donc pour l’optimisation:
A priori uniforme:
Si (constante), alors est aussi une constante.
L’EMV est donc un cas particulier du MAP avec a priori uniforme.
Autres a priori:
L’EMV et le MAP coïncident pour tout a priori qui est constant sur le domaine des paramètres, ou plus généralement, pour tout a priori dont le log est constant (à une constante additive près). Cela inclut les a priori impropres (non normalisables) qui sont uniformes sur .
Problèmes de l’a priori uniforme:
Avec peu de données: l’EMV peut être extrême. Exemple: 3 lancers de pièce donnant 3 faces → EMV = 100% de probabilité de face.
Paramètres non bornés: un a priori uniforme sur n’est pas une vraie distribution de probabilité (a priori impropre).
Invariance: un a priori uniforme sur n’est pas uniforme sur pour une transformation non-linéaire .
Pas d’information: on ignore toute connaissance préalable sur les valeurs plausibles des paramètres.
Exercice 4: Softmax et classification multiclasse ★★
La fonction softmax transforme un vecteur de scores en un vecteur de probabilités:
Pour classes et les scores , calculez manuellement . Vérifiez que les probabilités somment à 1.
Montrez que le softmax est invariant par translation: pour tout scalaire .
Pour classes, montrez que le softmax se réduit à la sigmoïde. Posez et montrez que .
Pour un problème à 3 classes avec les vraies étiquettes one-hot (classe 2) et les probabilités prédites , calculez l’entropie croisée.
Solution Exercice 4
Exercice 5: MAP avec a priori gaussien et Ridge ★★
Considérons un modèle de régression linéaire gaussien:
avec un a priori gaussien isotrope sur les paramètres:
Écrivez la log-vraisemblance pour observations i.i.d.
Écrivez le log a priori .
Montrez que l’estimateur MAP s’écrit:
et identifiez en fonction de et .
Interprétez: que signifie un grand ? Un petit ?
Solution Exercice 5
Log-vraisemblance:
Log a priori:
Estimateur MAP:
En ignorant les constantes:
En multipliant par (qui ne change pas l’argmax):
Donc .
Interprétation:
Grand (a priori large): on est peu sûr que les paramètres sont proches de zéro, donc petit, peu de régularisation, MAP proche de EMV.
Petit (a priori concentré): on croit fortement que les paramètres sont proches de zéro, donc grand, forte régularisation, coefficients tirés vers zéro.
Le rapport compare l’incertitude dans les données () à l’incertitude dans l’a priori (). Plus les données sont bruitées, plus on fait confiance à l’a priori.
Exercice 6: Inférence bayésienne complète ★★★
L’inférence bayésienne complète calcule la distribution a posteriori des paramètres, pas seulement son mode (MAP).
Considérons un modèle de régression linéaire bayésien avec:
Vraisemblance:
Prior:
Supposons et .
Pour une seule observation , calculez la distribution a posteriori . Utilisez le fait que le produit de deux gaussiennes est une gaussienne.
Quelle est la moyenne a posteriori et la variance a posteriori ?
Calculez l’estimateur MAP et comparez avec .
Ajoutez une deuxième observation . Mettez à jour la distribution a posteriori.
Tracez les distributions a priori, a posteriori après 1 observation, et a posteriori après 2 observations. Que remarquez-vous sur l’évolution de l’incertitude?
Solution Exercice 6
Calcul de la distribution a posteriori:
La distribution a posteriori est proportionnelle à:
En prenant le log:
C’est une forme quadratique en , donc la distribution a posteriori est gaussienne.
Paramètres de la distribution a posteriori:
Pour le modèle conjugué gaussien-gaussien:
Donc .
Estimateur MAP:
Pour une distribution a posteriori gaussienne, le mode = la moyenne:
Pour un modèle gaussien conjugué, MAP = moyenne a posteriori.
Mise à jour séquentielle:
On utilise la distribution a posteriori après la première observation comme nouvel a priori:
Visualisation:
theta = np.linspace(-2, 3, 200)
prior = scipy.stats.norm.pdf(theta, 0, 1)
post1 = scipy.stats.norm.pdf(theta, 1.2, np.sqrt(0.2))
post2 = scipy.stats.norm.pdf(theta, 1.083, np.sqrt(1/6))

plt.plot(theta, prior, label='A priori')
plt.plot(theta, post1, label='A posteriori (1 obs)')
plt.plot(theta, post2, label='A posteriori (2 obs)')
plt.legend()
Observations:
L’a priori est large (grande incertitude)
Après 1 observation, la distribution a posteriori se concentre autour de 1.2
Après 2 observations, la distribution a posteriori se concentre davantage (variance diminue)
La moyenne a posteriori est une moyenne pondérée de l’a priori et des données
Exercice 7: Entropie croisée et divergence de Kullback-Leibler ★★★
La divergence de Kullback-Leibler (KL) mesure la différence entre deux distributions. L’entropie croisée est liée à la KL divergence.
Définitions pour des distributions discrètes (vraie) et (modèle):
Montrez que .
Pour la vraie distribution et deux modèles et , calculez et . Quel modèle est «meilleur»?
Montrez que minimiser l’entropie croisée par rapport à revient à minimiser .
Expliquez pourquoi la KL divergence n’est pas symétrique: . Calculez les deux pour l’exemple de la question 2.
Reliez ceci au maximum de vraisemblance: si est la distribution empirique des données et est le modèle, montrez que minimiser la LVN revient à minimiser .
Solution Exercice 7
Relation entropie croisée et KL:
Calcul des KL divergences:
est meilleur car .
Minimisation:
Puisque et que ne dépend pas de :
Asymétrie de la KL:
.
L’asymétrie vient du fait que la KL pénalise différemment selon quelle distribution est au numérateur du log.
Lien avec le maximum de vraisemblance:
La distribution empirique est .
Puisque est constant:
Le maximum de vraisemblance cherche le modèle le plus proche (au sens KL) de la distribution empirique.