Le chapitre précédent a présenté le cadre bayésien et montré comment le maximum de vraisemblance découle de principes probabilistes. Ce chapitre exploite ce cadre pour construire des modèles génératifs: des modèles qui décrivent comment les données sont produites. Cette perspective ouvre de nouvelles possibilités pour la classification et le partitionnement.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

# Configuration pour des figures haute résolution
%config InlineBackend.figure_format = 'retina'
Approches générative et discriminative
Le chapitre 3 a introduit la régression logistique, qui modélise directement la probabilité qu’une observation appartienne à chaque classe:
Cette approche est dite discriminative: elle apprend à distinguer les classes sans modéliser comment les données de chaque classe sont distribuées. Le modèle répond à la question «étant donné cette observation, quelle est sa classe probable?» sans se demander «à quoi ressemblent les observations de chaque classe?».
L’approche générative procède différemment. Au lieu de modéliser directement, elle modélise:
La distribution a priori des classes:
La vraisemblance conditionnelle de chaque classe:
Le théorème de Bayes permet ensuite de calculer la probabilité a posteriori:
Le terme «génératif» vient du fait que ce modèle décrit un processus de génération des données: d’abord tirer une classe selon , puis générer une observation selon . Nous pouvons utiliser ce processus pour créer des données synthétiques.
Source
# Illustration: génératif vs discriminatif
np.random.seed(42)

# Générer des données de deux classes
n_per_class = 100
mu0, mu1 = np.array([0, 0]), np.array([2.5, 2.5])
cov = np.array([[1, 0.5], [0.5, 1]])

X0 = np.random.multivariate_normal(mu0, cov, n_per_class)
X1 = np.random.multivariate_normal(mu1, cov, n_per_class)

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))

# Gauche: vue générative (modélise chaque classe séparément)
ax = axes[0]
ax.scatter(X0[:, 0], X0[:, 1], c='steelblue', alpha=0.6, label='Classe 0', s=30)
ax.scatter(X1[:, 0], X1[:, 1], c='coral', alpha=0.6, label='Classe 1', s=30)

# Contours des distributions
x_grid = np.linspace(-3, 6, 100)
y_grid = np.linspace(-3, 6, 100)
X_grid, Y_grid = np.meshgrid(x_grid, y_grid)
pos = np.dstack((X_grid, Y_grid))

rv0 = stats.multivariate_normal(mu0, cov)
rv1 = stats.multivariate_normal(mu1, cov)

ax.contour(X_grid, Y_grid, rv0.pdf(pos), levels=3, colors='steelblue', alpha=0.7, linestyles='--')
ax.contour(X_grid, Y_grid, rv1.pdf(pos), levels=3, colors='coral', alpha=0.7, linestyles='--')

ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Approche générative\nModélise $p(\\mathbf{x} \\mid y)$ pour chaque classe')
ax.legend(loc='upper left')
ax.set_xlim(-3, 6)
ax.set_ylim(-3, 6)

# Droite: vue discriminative (modélise la frontière)
ax = axes[1]
ax.scatter(X0[:, 0], X0[:, 1], c='steelblue', alpha=0.6, label='Classe 0', s=30)
ax.scatter(X1[:, 0], X1[:, 1], c='coral', alpha=0.6, label='Classe 1', s=30)

# Frontière de décision (pour LDA avec covariance partagée)
# La frontière est là où p(y=0|x) = p(y=1|x)
cov_inv = np.linalg.inv(cov)
w = cov_inv @ (mu1 - mu0)
b = -0.5 * (mu1 @ cov_inv @ mu1 - mu0 @ cov_inv @ mu0)
# Frontière: w'x + b = 0
x_line = np.linspace(-3, 6, 100)
y_line = -(w[0] * x_line + b) / w[1]

ax.plot(x_line, y_line, 'k-', linewidth=2, label='Frontière de décision')
ax.fill_between(x_line, y_line, 6, alpha=0.1, color='coral')
ax.fill_between(x_line, -3, y_line, alpha=0.1, color='steelblue')

ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Approche discriminative\nModélise $p(y \\mid \\mathbf{x})$ directement')
ax.legend(loc='upper left')
ax.set_xlim(-3, 6)
ax.set_ylim(-3, 6)

plt.tight_layout()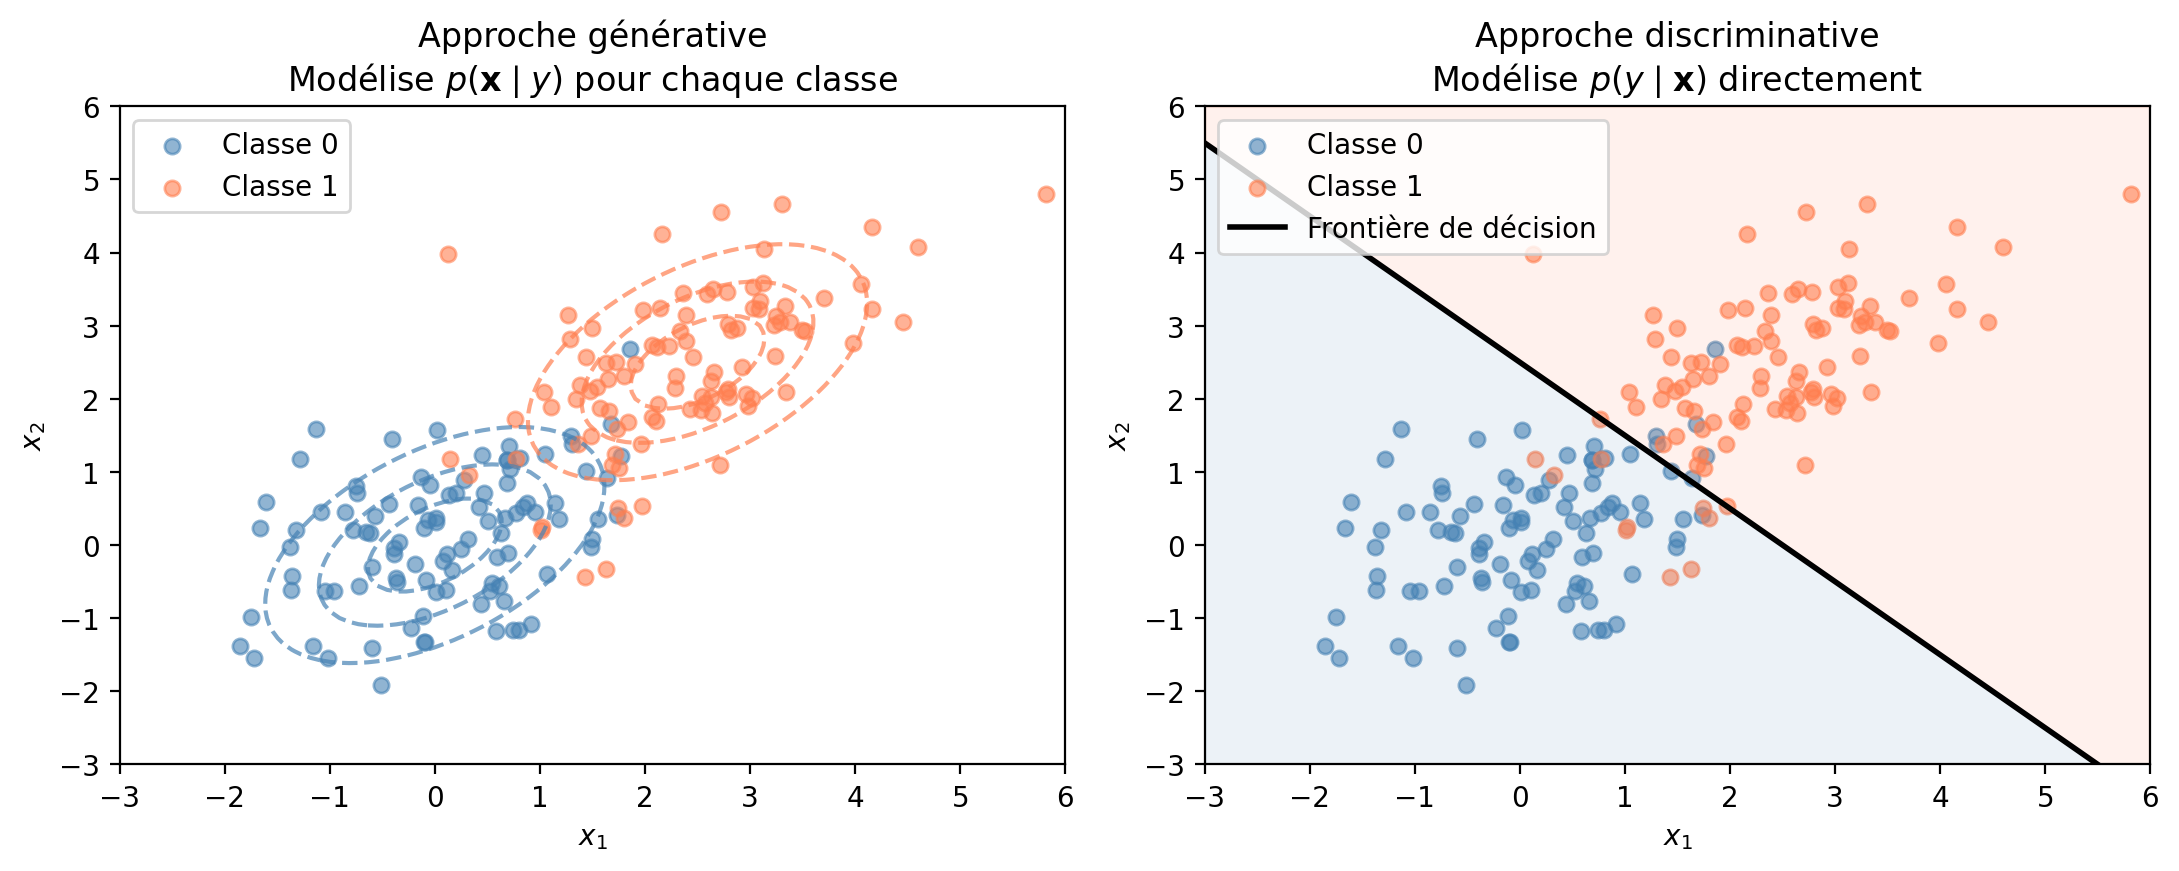
La figure illustre les deux perspectives. À gauche, l’approche générative modélise la distribution de chaque classe (les ellipses montrent les contours de densité). À droite, l’approche discriminative se concentre sur la frontière qui sépare les classes. Les deux approches peuvent donner la même frontière de décision, mais elles y arrivent par des chemins différents.
Avantages et limites
Chaque approche a ses forces. L’approche discriminative optimise directement ce qui nous intéresse: la capacité à distinguer les classes. Elle fait moins d’hypothèses sur la forme des distributions et atteint souvent une meilleure précision prédictive.
L’approche générative offre d’autres avantages:
Génération de données: nous pouvons créer des exemples synthétiques, utiles pour l’augmentation de données ou la visualisation
Données manquantes: si certaines caractéristiques sont absentes, nous pouvons marginaliser sur les valeurs manquantes
Apprentissage par classe: nous pouvons ajouter une nouvelle classe sans réentraîner les autres
Apprentissage avec peu de données: les hypothèses du modèle génératif peuvent aider quand les exemples sont rares
La suite de ce chapitre présente trois modèles génératifs: le classifieur naïf bayésien, l’analyse discriminante gaussienne, et les modèles de mélange gaussien.
Le classifieur naïf bayésien
L’hypothèse d’indépendance conditionnelle
Le classifieur naïf bayésien (Naive Bayes) est un modèle génératif simple mais efficace. Son nom vient d’une hypothèse qui simplifie considérablement le modèle: les caractéristiques sont conditionnellement indépendantes étant donné la classe.
Pour comprendre l’impact de cette hypothèse, considérons d’abord le cas général. Par la règle de chaîne, la vraisemblance conditionnelle de classe se décompose en:
Chaque facteur dépend de toutes les caractéristiques précédentes. Si chaque caractéristique prend valeurs, le dernier facteur à lui seul nécessite de spécifier une distribution conditionnelle pour chacune des combinaisons possibles des caractéristiques précédentes. Au total, la distribution conjointe requiert paramètres par classe, un nombre qui explose exponentiellement avec la dimension.
L’hypothèse d’indépendance conditionnelle élimine toutes ces dépendances. Sachant la classe, chaque caractéristique est supposée indépendante des autres:
Cette factorisation réduit drastiquement le nombre de paramètres: nous n’avons plus que paramètres par classe. Par exemple, avec caractéristiques binaires (), le modèle général nécessiterait paramètres par classe, alors que le naïf bayésien n’en utilise que 20.
Concrètement, considérons un problème de classification de courriels (pourriel ou non) avec des caractéristiques binaires indiquant la présence de certains mots. L’hypothèse d’indépendance conditionnelle suppose que, sachant qu’un courriel est un pourriel, la présence du mot «gratuit» n’influence pas la probabilité de présence du mot «urgent». Chaque mot apparaît indépendamment selon sa propre probabilité conditionnelle à la classe.
Modèle complet et classification
Pour tout modèle génératif, le théorème de Bayes donne la probabilité a posteriori d’une classe:
Le modèle naïf bayésien spécifie:
Un a priori sur les classes: avec
Pour chaque caractéristique et chaque classe , une distribution
En substituant l’hypothèse d’indépendance conditionnelle dans le théorème de Bayes, la probabilité a posteriori devient:
Pour classifier, nous choisissons la classe qui maximise le numérateur (le dénominateur est constant pour toutes les classes):
En pratique, nous travaillons avec le logarithme pour éviter les problèmes de sous-dépassement numérique (underflow):
Estimation par maximum de vraisemblance
Un atout du naïf bayésien est que l’estimation des paramètres admet des formules fermées. La log-vraisemblance se factorise en termes indépendants:
Cette factorisation permet d’optimiser chaque terme séparément.
A priori de classe. L’EMV des probabilités de classe est simplement la fréquence empirique:
où est le nombre d’exemples de classe .
Caractéristiques catégorielles. Si la caractéristique prend des valeurs parmi , l’EMV est:
où compte les exemples de classe où la caractéristique vaut .
Caractéristiques binaires. Pour des caractéristiques binaires (présent/absent), nous utilisons une distribution de Bernoulli:
où compte les exemples de classe où la caractéristique est présente.
Caractéristiques continues. Pour des caractéristiques continues, nous supposons souvent une distribution gaussienne et estimons la moyenne et la variance par classe:
Le problème des probabilités nulles et le lissage de Laplace
Un problème survient quand une combinaison caractéristique-classe n’apparaît jamais dans les données d’entraînement. Si le mot «gratuit» n’apparaît dans aucun courriel légitime, nous avons . Lors de la classification d’un nouveau courriel contenant «gratuit», le produit devient nul, quelle que soit la valeur des autres caractéristiques. Un seul mot peut ainsi dominer entièrement la décision.
Le lissage de Laplace (add-one smoothing) résout ce problème en ajoutant des pseudo-observations:
où est le nombre de valeurs possibles. Cette formule garantit que toutes les probabilités restent strictement positives.
Le lissage de Laplace a une interprétation bayésienne: c’est l’estimateur MAP avec un a priori uniforme (Beta(1,1) pour le cas binaire, Dirichlet(1,...,1) pour le cas catégoriel). Nous retrouvons ici le lien entre régularisation et a priori établi au chapitre 5.
Source
# Exemple: effet du lissage de Laplace
fig, ax = plt.subplots(figsize=(9, 4))

# Scénario: 10 pourriels, 0 avec le mot "gratuit"
N_spam = 10
N_gratuit_spam = 0
K = 2  # binaire

# EMV
theta_mle = N_gratuit_spam / N_spam

# Avec lissage de Laplace
alphas = [0, 0.1, 0.5, 1, 2, 5]
thetas = [(N_gratuit_spam + alpha) / (N_spam + K * alpha) for alpha in alphas]

bars = ax.bar(range(len(alphas)), thetas, color='steelblue', alpha=0.7, edgecolor='black')
ax.set_xticks(range(len(alphas)))
ax.set_xticklabels([f'$\\alpha = {a}$' for a in alphas])
ax.set_ylabel('$\\hat{\\theta}$ (probabilité estimée)')
ax.set_xlabel('Paramètre de lissage')
ax.set_title('Effet du lissage sur $p(\\text{«gratuit»} \\mid \\text{pourriel})$\n(0 occurrence sur 10 exemples)')
ax.axhline(0.5, color='gray', linestyle='--', alpha=0.5, label='A priori uniforme')
ax.legend()
ax.set_ylim(0, 0.6)

# Annoter les valeurs
for bar, theta in zip(bars, thetas):
    ax.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.02,
            f'{theta:.2f}', ha='center', fontsize=9)

plt.tight_layout()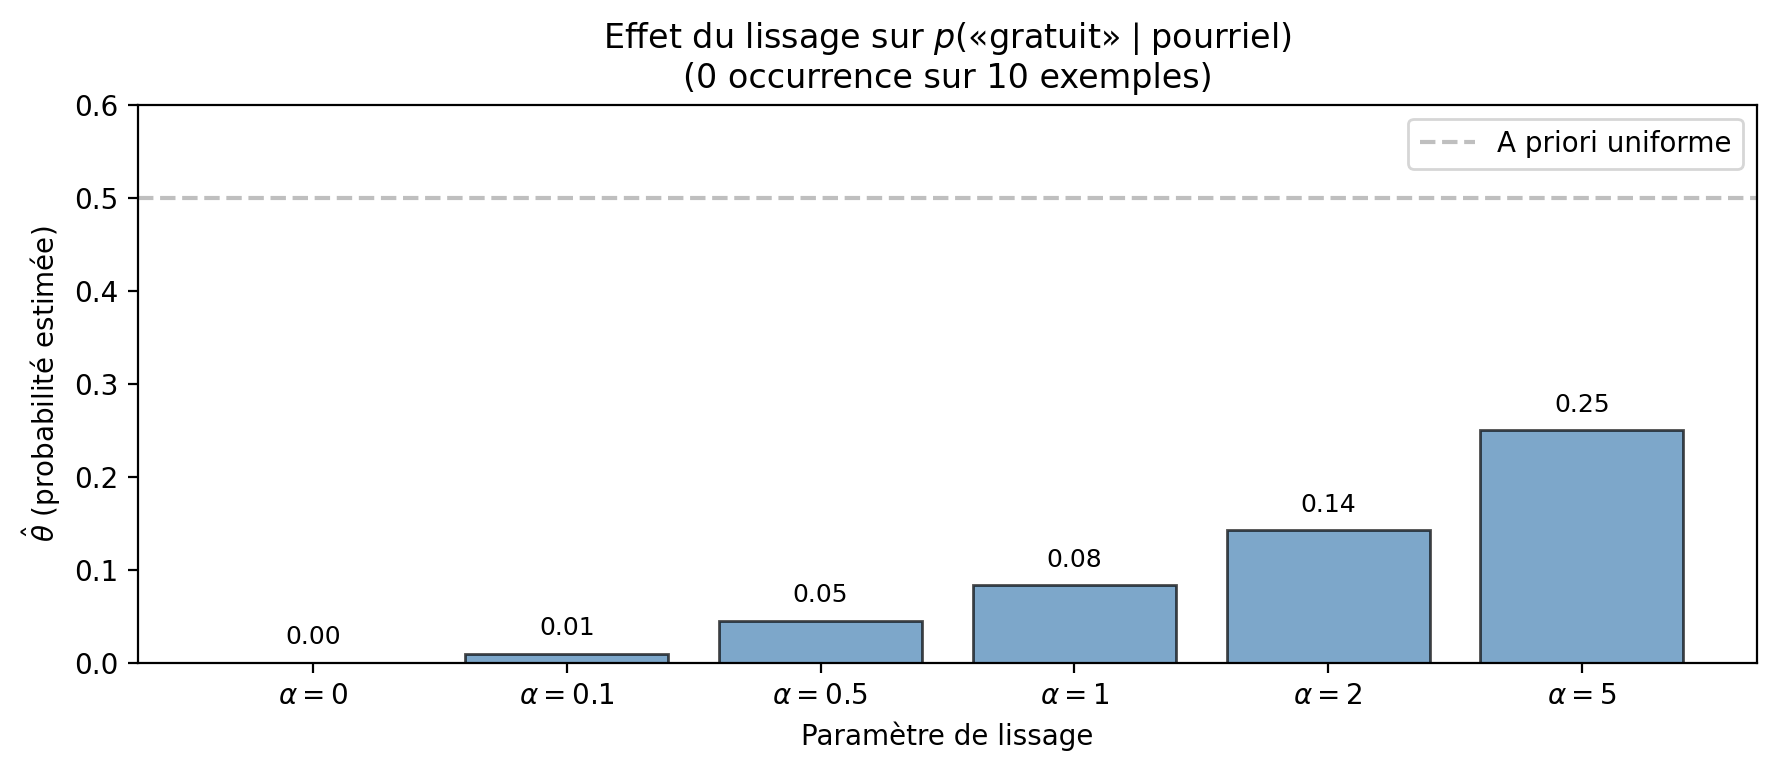
La figure montre comment le lissage affecte l’estimation. Sans lissage (), l’EMV est zéro, ce qui pose problème. Avec (lissage de Laplace standard), l’estimation devient , reflétant notre incertitude face à l’absence de données.
Pourquoi le naïf bayésien fonctionne-t-il?
L’hypothèse d’indépendance conditionnelle est presque toujours violée en pratique. Pourtant, le classifieur naïf bayésien obtient souvent de bonnes performances. Comment expliquer ce paradoxe?
La réponse tient au fait que nous utilisons le modèle pour classifier, pas pour estimer des probabilités précises. Pour classifier correctement, nous n’avons besoin que de la classe la plus probable, pas des probabilités exactes. Même si les probabilités estimées sont biaisées, l’ordre des classes peut rester correct.
Plus précisément, les dépendances entre caractéristiques peuvent affecter les probabilités absolues sans changer quelle classe domine. Si les mots «gratuit» et «offre» sont corrélés dans les pourriels, ignorer cette corrélation surestime la «surprise» de voir les deux ensemble; cette surestimation s’applique toutefois à toutes les classes et peut s’annuler dans la comparaison.
Cette observation a une conséquence pratique: les probabilités retournées par un naïf bayésien sont souvent mal calibrées (trop proches de 0 ou 1). Si vous avez besoin de probabilités fiables et pas seulement de classifications, d’autres méthodes comme la régression logistique sont préférables.
Source
# Démonstration: Naive Bayes sur un exemple de classification de texte
from sklearn.naive_bayes import MultinomialNB
from sklearn.feature_extraction.text import CountVectorizer

# Données d'exemple (classification de sentiment)
texts = [
    "ce film est excellent vraiment superbe",
    "quelle merveille un chef-d'oeuvre",
    "j'ai adoré ce film magnifique",
    "film ennuyeux et long très décevant",
    "terrible je n'ai pas aimé du tout",
    "mauvais film vraiment nul"
]
labels = [1, 1, 1, 0, 0, 0]  # 1 = positif, 0 = négatif

# Vectorisation (comptage des mots)
vectorizer = CountVectorizer()
X = vectorizer.fit_transform(texts)

# Entraînement du Naive Bayes
clf = MultinomialNB(alpha=1.0)  # alpha=1 = lissage de Laplace
clf.fit(X, labels)

# Test sur de nouveaux exemples
test_texts = ["ce film est superbe", "film terrible et ennuyeux"]
X_test = vectorizer.transform(test_texts)
predictions = clf.predict(X_test)
probas = clf.predict_proba(X_test)

fig, ax = plt.subplots(figsize=(9, 4))

x_pos = np.arange(len(test_texts))
width = 0.35

bars1 = ax.bar(x_pos - width/2, probas[:, 0], width, label='$p(\\text{négatif} \\mid \\mathbf{x})$',
               color='coral', alpha=0.7, edgecolor='black')
bars2 = ax.bar(x_pos + width/2, probas[:, 1], width, label='$p(\\text{positif} \\mid \\mathbf{x})$',
               color='steelblue', alpha=0.7, edgecolor='black')

ax.set_ylabel('Probabilité a posteriori')
ax.set_xticks(x_pos)
ax.set_xticklabels([f'«{t[:25]}...»' if len(t) > 25 else f'«{t}»' for t in test_texts], fontsize=9)
ax.legend()
ax.set_ylim(0, 1.1)
ax.set_title('Classification de sentiment avec Naive Bayes')

for bars in [bars1, bars2]:
    for bar in bars:
        height = bar.get_height()
        ax.text(bar.get_x() + bar.get_width()/2, height + 0.02, f'{height:.2f}',
                ha='center', fontsize=9)

plt.tight_layout()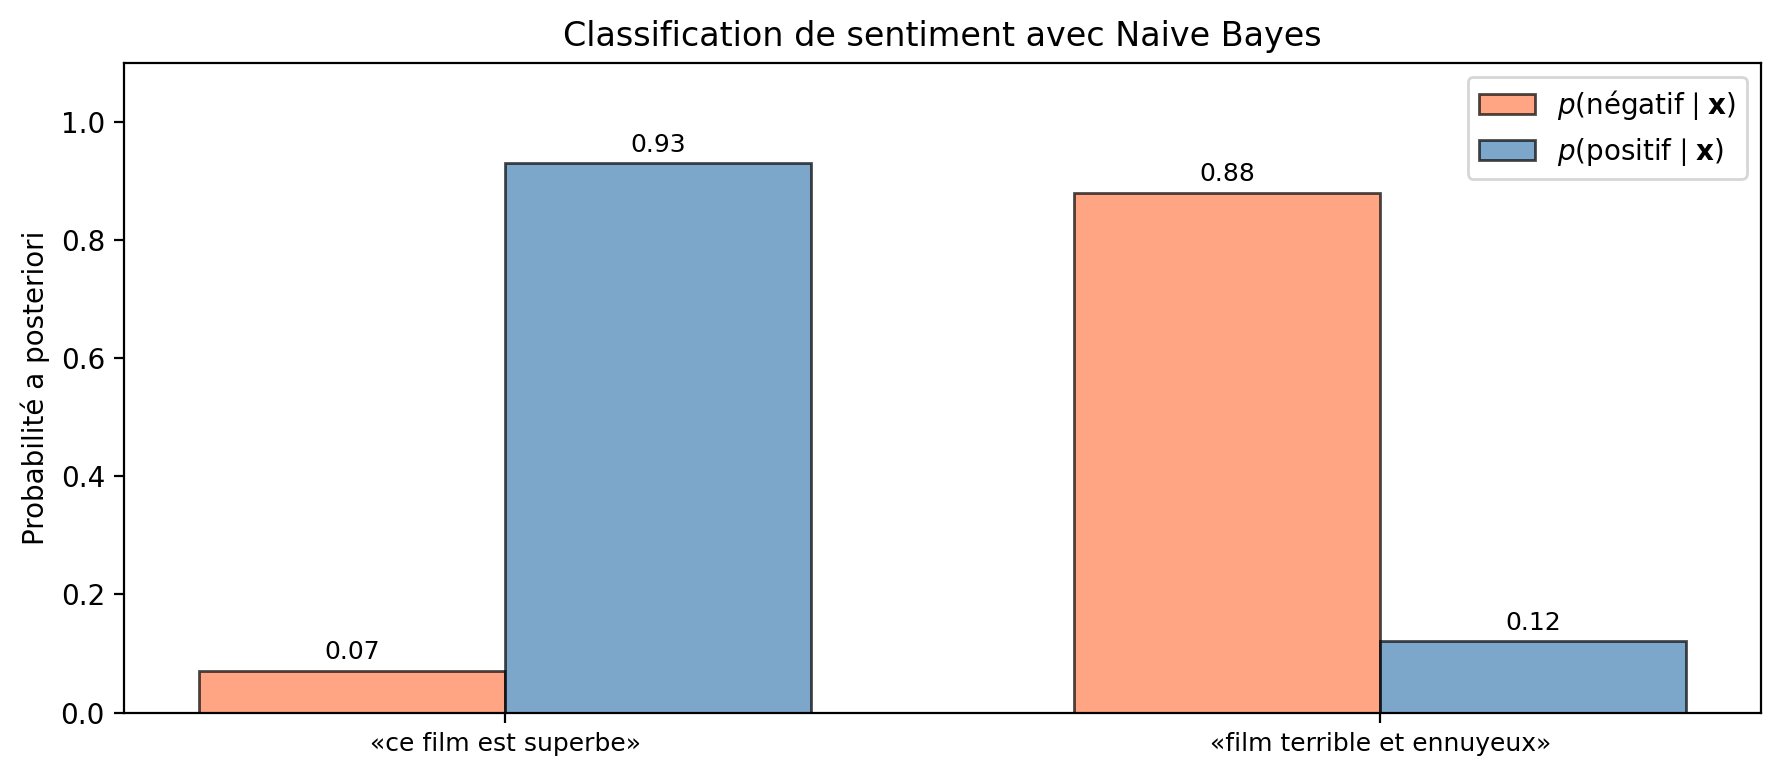
Analyse discriminante gaussienne
Modèle
L’analyse discriminante gaussienne (GDA, Gaussian Discriminant Analysis) est un cas particulier de modèle génératif où les vraisemblances conditionnelles de classe sont des distributions gaussiennes:
Chaque classe est caractérisée par:
Un vecteur moyenne
Une matrice de covariance
Le modèle complet inclut aussi les probabilités a priori .
La fonction discriminante
Pour classifier, nous calculons la probabilité a posteriori de chaque classe et choisissons la plus grande. En prenant le logarithme:
Le terme est constant pour toutes les classes et peut être ignoré pour la classification. La fonction discriminante pour la classe est:
Le terme est la distance de Mahalanobis entre et . Cette distance tient compte de la forme de la distribution: un point éloigné dans une direction de grande variance est moins «surprenant» qu’un point éloigné dans une direction de faible variance.
Analyse discriminante quadratique (QDA)
Quand chaque classe a sa propre matrice de covariance , la fonction discriminante contient un terme quadratique en . La frontière de décision entre deux classes (là où ) est une quadrique (une ellipse, une hyperbole ou une parabole selon la configuration). Cette méthode s’appelle QDA (Quadratic Discriminant Analysis).
Analyse discriminante linéaire (LDA)
Si toutes les classes partagent la même matrice de covariance , les termes quadratiques se simplifient:
Cette expression est linéaire en . La frontière de décision entre deux classes devient un hyperplan. Cette méthode s’appelle LDA (Linear Discriminant Analysis).
La différence entre LDA et QDA est analogue à celle entre un modèle linéaire et un modèle quadratique en régression: LDA est plus simple et moins sujet au surapprentissage, mais QDA peut capturer des frontières plus complexes.
Source
# Comparaison LDA vs QDA
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis, QuadraticDiscriminantAnalysis

np.random.seed(42)

# Générer des données avec covariances différentes
n_samples = 150
mu0 = np.array([0, 0])
mu1 = np.array([3, 3])
cov0 = np.array([[2, 0.5], [0.5, 0.5]])
cov1 = np.array([[0.5, -0.3], [-0.3, 2]])

X0 = np.random.multivariate_normal(mu0, cov0, n_samples)
X1 = np.random.multivariate_normal(mu1, cov1, n_samples)
X = np.vstack([X0, X1])
y = np.array([0]*n_samples + [1]*n_samples)

# Entraîner LDA et QDA
lda = LinearDiscriminantAnalysis()
qda = QuadraticDiscriminantAnalysis()
lda.fit(X, y)
qda.fit(X, y)

# Grille pour les frontières de décision
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
grid = np.c_[xx.ravel(), yy.ravel()]

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))

for ax, clf, title in [(axes[0], lda, 'LDA (covariance partagée)'),
                        (axes[1], qda, 'QDA (covariances différentes)')]:
    Z = clf.predict(grid).reshape(xx.shape)
    ax.contourf(xx, yy, Z, alpha=0.3, cmap='coolwarm')
    ax.contour(xx, yy, Z, colors='black', linewidths=1, levels=[0.5])

    ax.scatter(X0[:, 0], X0[:, 1], c='steelblue', alpha=0.6, label='Classe 0', s=20)
    ax.scatter(X1[:, 0], X1[:, 1], c='coral', alpha=0.6, label='Classe 1', s=20)

    ax.set_xlabel('$x_1$')
    ax.set_ylabel('$x_2$')
    ax.set_title(title)
    ax.legend(loc='upper left')

plt.tight_layout()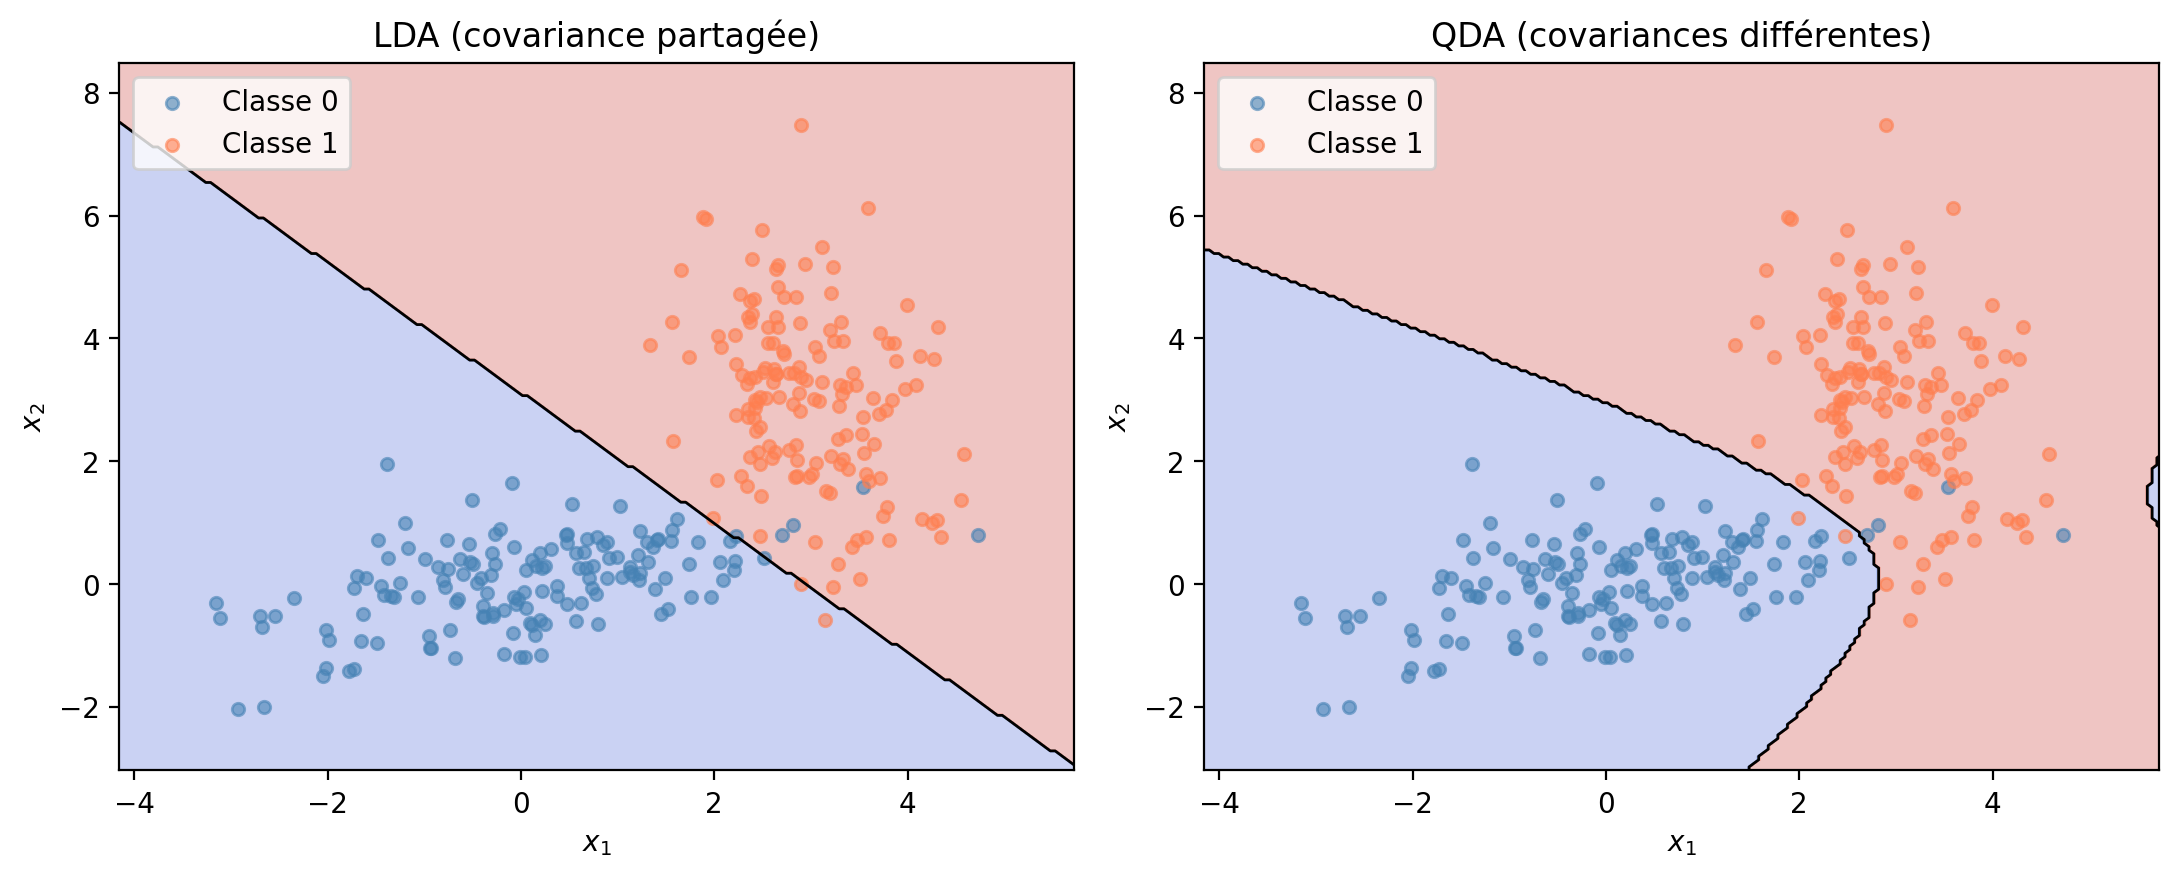
La figure montre la différence entre LDA et QDA sur des données où les classes ont des covariances différentes. LDA impose une frontière linéaire qui ne peut pas s’adapter aux formes elliptiques différentes. QDA capture mieux la structure des données avec une frontière courbe.
Estimation des paramètres
L’EMV des paramètres de GDA a des formules fermées:
A priori de classe:
Moyenne par classe:
Covariance par classe (QDA):
Covariance partagée (LDA):
Ces formules sont des moyennes et des covariances empiriques, calculables efficacement sans optimisation itérative.
Lien avec la régression logistique
LDA et la régression logistique partagent la même forme de frontière de décision (linéaire), mais diffèrent dans leurs hypothèses. LDA suppose que les données de chaque classe suivent une distribution gaussienne avec covariance partagée. La régression logistique ne fait pas d’hypothèse sur la distribution des données.
Quand l’hypothèse gaussienne est correcte, LDA peut être plus efficace avec peu de données car elle exploite cette structure. Quand l’hypothèse est incorrecte, la régression logistique est généralement plus robuste. En pratique, la régression logistique domine souvent car l’hypothèse gaussienne est rarement satisfaite exactement.
Modèles de mélange gaussien
De la classification au partitionnement
Les modèles précédents supposent que nous connaissons les classes des exemples d’entraînement. En pratique, les étiquettes sont souvent absentes. Un commerce cherche à identifier des profils de clientèle à partir de données de transactions; un généticien veut découvrir des sous-types de maladies à partir de profils d’expression génétique; un système de sécurité doit repérer des comportements atypiques sans exemples préalables d’attaques.
Le partitionnement (clustering) regroupe automatiquement les observations en groupes homogènes, sans supervision. Nous allons aborder ce problème en deux temps. D’abord, l’algorithme k-moyennes donne une solution simple et intuitive. Ensuite, nous verrons que k-moyennes fait des hypothèses implicites sur la forme des groupes, ce qui nous mènera aux modèles de mélange gaussien et à l’algorithme EM.
K-moyennes: un premier algorithme
L’idée de k-moyennes est de représenter chaque groupe par un centroïde (sa moyenne), puis d’assigner chaque observation au centroïde le plus proche. L’algorithme minimise la distorsion, c’est-à-dire la somme des distances au carré entre chaque point et le centroïde de son groupe:
où est l’assignation du point au groupe (avec ). Ce problème d’optimisation porte à la fois sur des variables continues (les centroïdes ) et des variables discrètes (les assignations ). Les assignations discrètes rendent la distorsion non différentiable par rapport aux : on ne peut pas calculer un gradient et «descendre» dans la direction des meilleures assignations. De plus, le nombre total d’assignations possibles est (chacun des points peut aller dans l’un des groupes), ce qui exclut toute recherche exhaustive dès que dépasse quelques dizaines.
On pourrait être tenté de relâcher la contrainte et d’autoriser des assignations continues , par exemple via un softmax, pour rendre le problème différentiable et appliquer la descente de gradient. C’est une bonne intuition: elle mène directement à l’algorithme EM que nous verrons plus loin, où les responsabilités sont précisément des assignations souples dans . Mais k-moyennes choisit de rester dans le monde discret: il alterne entre deux étapes, chacune ayant une solution simple:
Assignation. On fixe les centroïdes et on assigne chaque point au plus proche:
Mise à jour. On fixe les assignations et on recalcule les centroïdes:
Chaque centroïde est la moyenne des points qui lui sont assignés. On répète ces deux étapes jusqu’à ce que les assignations ne changent plus. Chaque étape réduit (ou maintient) la distorsion, et comme le nombre d’assignations possibles est fini, l’algorithme converge toujours vers un minimum local.
Source
# Animation de l'algorithme k-moyennes
from matplotlib.animation import FuncAnimation
from IPython.display import Image

np.random.seed(42)
n_samples = 300
X_kmeans = np.vstack([
    np.random.multivariate_normal([0, 0], [[1, 0], [0, 1]], n_samples // 3),
    np.random.multivariate_normal([4, 0], [[0.5, 0.3], [0.3, 0.5]], n_samples // 3),
    np.random.multivariate_normal([2, 3], [[0.8, -0.4], [-0.4, 0.8]], n_samples // 3)
])

def run_kmeans(X, K, seed=123, max_iter=20):
    rng = np.random.RandomState(seed)
    mu = X[rng.choice(len(X), K, replace=False)].copy()
    history = []
    for _ in range(max_iter):
        dists = np.linalg.norm(X[:, None] - mu[None], axis=2)
        labels = np.argmin(dists, axis=1)
        history.append((mu.copy(), labels.copy()))
        new_mu = np.array([X[labels == k].mean(axis=0) for k in range(K)])
        if np.allclose(new_mu, mu):
            break
        mu = new_mu
    return history

hist_km = run_kmeans(X_kmeans, 3, seed=123)

fig, ax = plt.subplots(figsize=(8, 6))
colors_km = ['steelblue', 'coral', 'seagreen']

def animate_km(frame):
    ax.clear()
    mu_t, labels_t = hist_km[frame]
    for k in range(3):
        mask = labels_t == k
        ax.scatter(X_kmeans[mask, 0], X_kmeans[mask, 1], c=colors_km[k], alpha=0.5, s=15)
        ax.plot(mu_t[k, 0], mu_t[k, 1], marker='X', color=colors_km[k],
                markersize=14, markeredgecolor='black', markeredgewidth=1.5, zorder=5)
    ax.set_xlim(-3, 7)
    ax.set_ylim(-4, 6)
    ax.set_xlabel('$x_1$')
    ax.set_ylabel('$x_2$')
    ax.set_title(f'K-moyennes, itération {frame}')
    return []

anim_km = FuncAnimation(fig, animate_km, frames=len(hist_km), interval=800, blit=True)
anim_km.save('_static/kmeans_convergence.gif', writer='pillow', fps=2, dpi=100)
plt.close()

Image(filename='_static/kmeans_convergence.gif')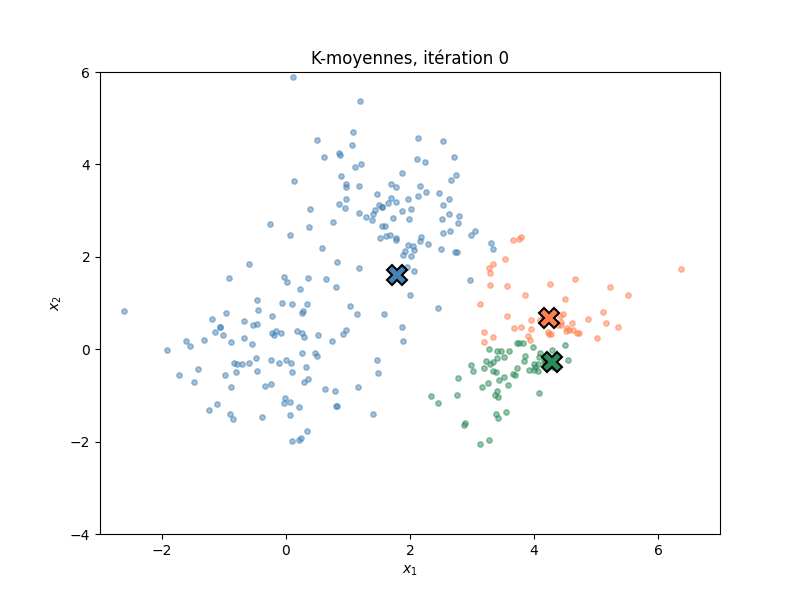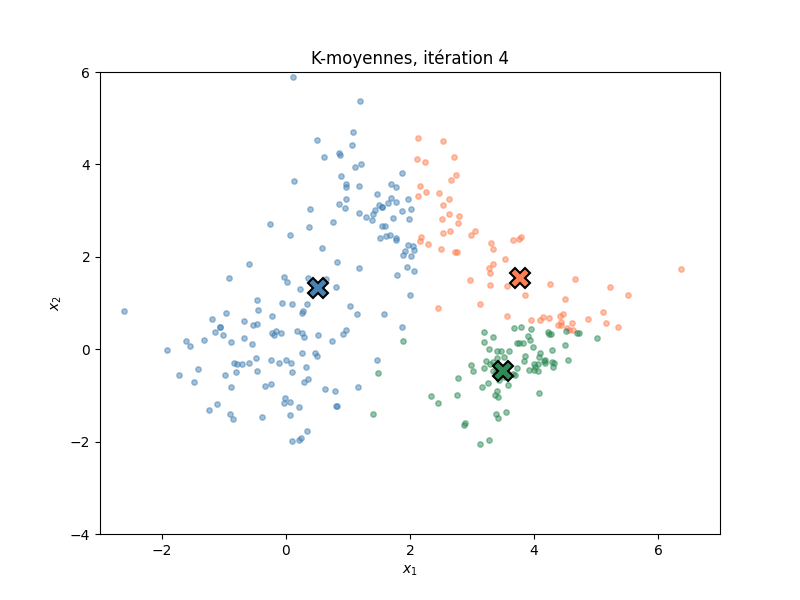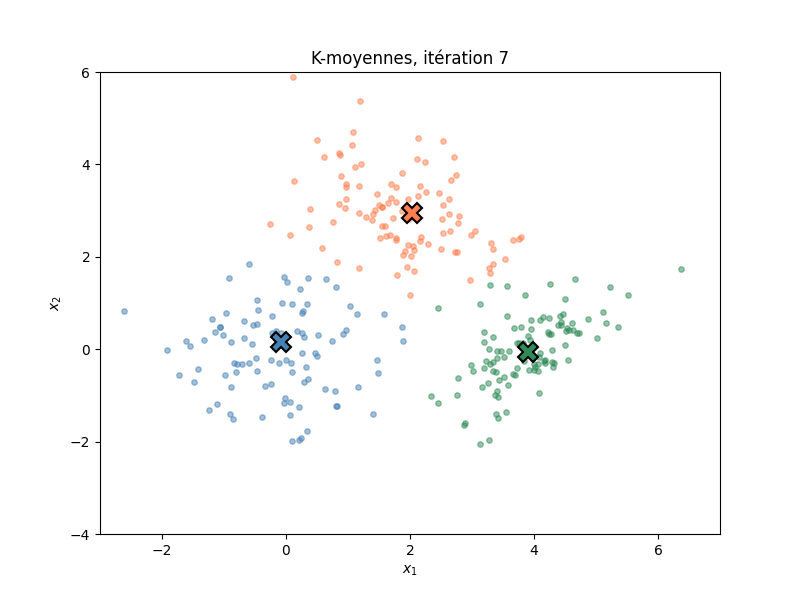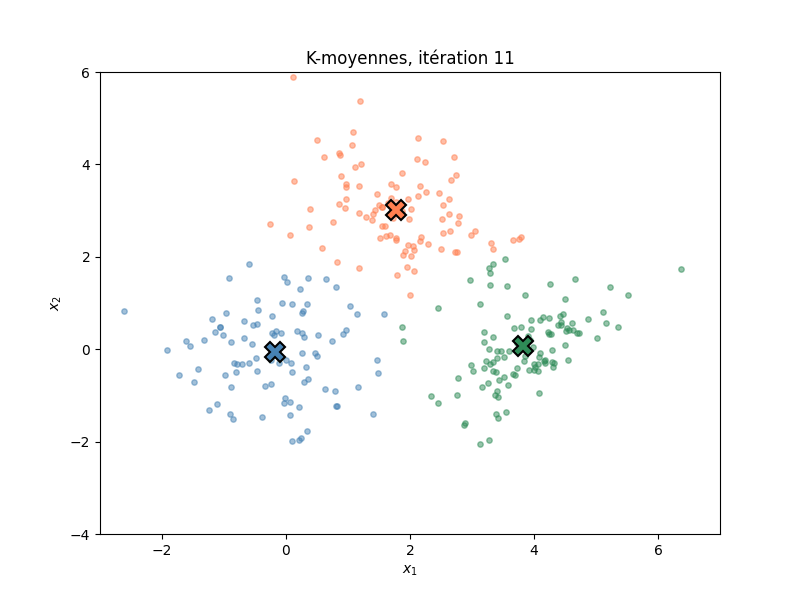
L’animation montre la convergence de k-moyennes. Les croix marquent les centroïdes, et la couleur de chaque point indique son assignation au centroïde le plus proche. À chaque itération, les centroïdes migrent vers le centre de masse de leur groupe, et les assignations se réorganisent en conséquence.
K-moyennes est rapide et simple, mais il a une limite structurelle. Puisque chaque point est assigné au centroïde le plus proche au sens de la distance euclidienne, la séparation entre deux groupes adjacents est toujours la médiatrice du segment reliant leurs centroïdes, c’est-à-dire une droite perpendiculaire passant par le milieu. L’ensemble de ces médiatrices forme un diagramme de Voronoï dont les cellules sont des polygones convexes. Les groupes retrouvés sont donc nécessairement sphériques: k-moyennes ne peut pas capturer des groupes allongés, inclinés ou de tailles différentes.
Source
# Illustration: k-moyennes (médiatrice) vs GMM (séparation adaptée)
from matplotlib.patches import Ellipse
from sklearn.mixture import GaussianMixture

np.random.seed(42)

# Données avec deux groupes elliptiques d'orientations différentes
cov_a = np.array([[3.0, 1.8], [1.8, 1.5]])
cov_b = np.array([[1.0, -0.7], [-0.7, 2.5]])
mu_a, mu_b = np.array([-1, -1]), np.array([3, 3])
X_a = np.random.multivariate_normal(mu_a, cov_a, 120)
X_b = np.random.multivariate_normal(mu_b, cov_b, 120)
X_ell = np.vstack([X_a, X_b])
y_true = np.array([0]*120 + [1]*120)

# K-moyennes
hist_ell = run_kmeans(X_ell, 2, seed=0)
mu_f, labels_f = hist_ell[-1]

# GMM
gmm_ell = GaussianMixture(n_components=2, covariance_type='full', random_state=42)
gmm_ell.fit(X_ell)

# Grille pour les frontières de décision
x_min, x_max = -6, 8
y_min, y_max = -5, 8
xx, yy = np.meshgrid(np.linspace(x_min, x_max, 300), np.linspace(y_min, y_max, 300))
grid = np.c_[xx.ravel(), yy.ravel()]

def draw_ellipse_on(ax, mu, cov, color, n_std=2):
    vals, vecs = np.linalg.eigh(cov)
    angle = np.degrees(np.arctan2(vecs[1, 0], vecs[0, 0]))
    w, h = 2 * n_std * np.sqrt(np.maximum(vals, 1e-8))
    ell = Ellipse(mu, w, h, angle=angle, fill=False, color=color,
                  linewidth=2, linestyle='--')
    ax.add_patch(ell)

fig, axes = plt.subplots(1, 2, figsize=(12, 5.5))
colors_2 = ['steelblue', 'coral']

# --- Gauche: k-moyennes ---
ax = axes[0]

# Régions d'assignation k-moyennes (colorier la grille)
dists_grid = np.linalg.norm(grid[:, None] - mu_f[None], axis=2)
Z_km = np.argmin(dists_grid, axis=1).reshape(xx.shape)
ax.contourf(xx, yy, Z_km, levels=[-0.5, 0.5, 1.5], colors=[colors_2[0], colors_2[1]], alpha=0.08)
ax.contour(xx, yy, Z_km, levels=[0.5], colors='black', linewidths=2.5)

# Points colorés par groupe réel
ax.scatter(X_a[:, 0], X_a[:, 1], c=colors_2[0], alpha=0.5, s=20, edgecolors='none')
ax.scatter(X_b[:, 0], X_b[:, 1], c=colors_2[1], alpha=0.5, s=20, edgecolors='none')

# Centroïdes et segment
ax.plot(mu_f[0, 0], mu_f[0, 1], marker='X', color=colors_2[0],
        markersize=14, markeredgecolor='black', markeredgewidth=1.5, zorder=5)
ax.plot(mu_f[1, 0], mu_f[1, 1], marker='X', color=colors_2[1],
        markersize=14, markeredgecolor='black', markeredgewidth=1.5, zorder=5)
ax.plot([mu_f[0, 0], mu_f[1, 0]], [mu_f[0, 1], mu_f[1, 1]],
        'k--', linewidth=1.5, alpha=0.4)

# Ellipses des vrais groupes
draw_ellipse_on(ax, mu_a, cov_a, colors_2[0])
draw_ellipse_on(ax, mu_b, cov_b, colors_2[1])

# Points mal classés par k-moyennes
misclassified = labels_f != y_true
ax.scatter(X_ell[misclassified, 0], X_ell[misclassified, 1],
           facecolors='none', edgecolors='black', s=60, linewidths=1.2, zorder=4)

n_errors_km = misclassified.sum()
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title(f'K-moyennes: médiatrice ({n_errors_km} erreurs)')
ax.set_xlim(x_min, x_max)
ax.set_ylim(y_min, y_max)
ax.set_aspect('equal')
ax.grid(True, alpha=0.3)

# --- Droite: GMM ---
ax = axes[1]

# Régions d'assignation GMM
Z_gmm = gmm_ell.predict(grid).reshape(xx.shape)
ax.contourf(xx, yy, Z_gmm, levels=[-0.5, 0.5, 1.5], colors=[colors_2[0], colors_2[1]], alpha=0.08)
ax.contour(xx, yy, Z_gmm, levels=[0.5], colors='black', linewidths=2.5)

# Points colorés par groupe réel
ax.scatter(X_a[:, 0], X_a[:, 1], c=colors_2[0], alpha=0.5, s=20, edgecolors='none')
ax.scatter(X_b[:, 0], X_b[:, 1], c=colors_2[1], alpha=0.5, s=20, edgecolors='none')

# Ellipses estimées par le GMM
for k in range(2):
    draw_ellipse_on(ax, gmm_ell.means_[k], gmm_ell.covariances_[k], colors_2[k])

labels_gmm = gmm_ell.predict(X_ell)
misclassified_gmm = labels_gmm != y_true
if misclassified_gmm.sum() > misclassified_gmm.size / 2:
    misclassified_gmm = ~misclassified_gmm
n_errors_gmm = misclassified_gmm.sum()
ax.scatter(X_ell[misclassified_gmm, 0], X_ell[misclassified_gmm, 1],
           facecolors='none', edgecolors='black', s=60, linewidths=1.2, zorder=4)

ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title(f'GMM: séparation adaptée ({n_errors_gmm} erreurs)')
ax.set_xlim(x_min, x_max)
ax.set_ylim(y_min, y_max)
ax.set_aspect('equal')
ax.grid(True, alpha=0.3)

plt.tight_layout()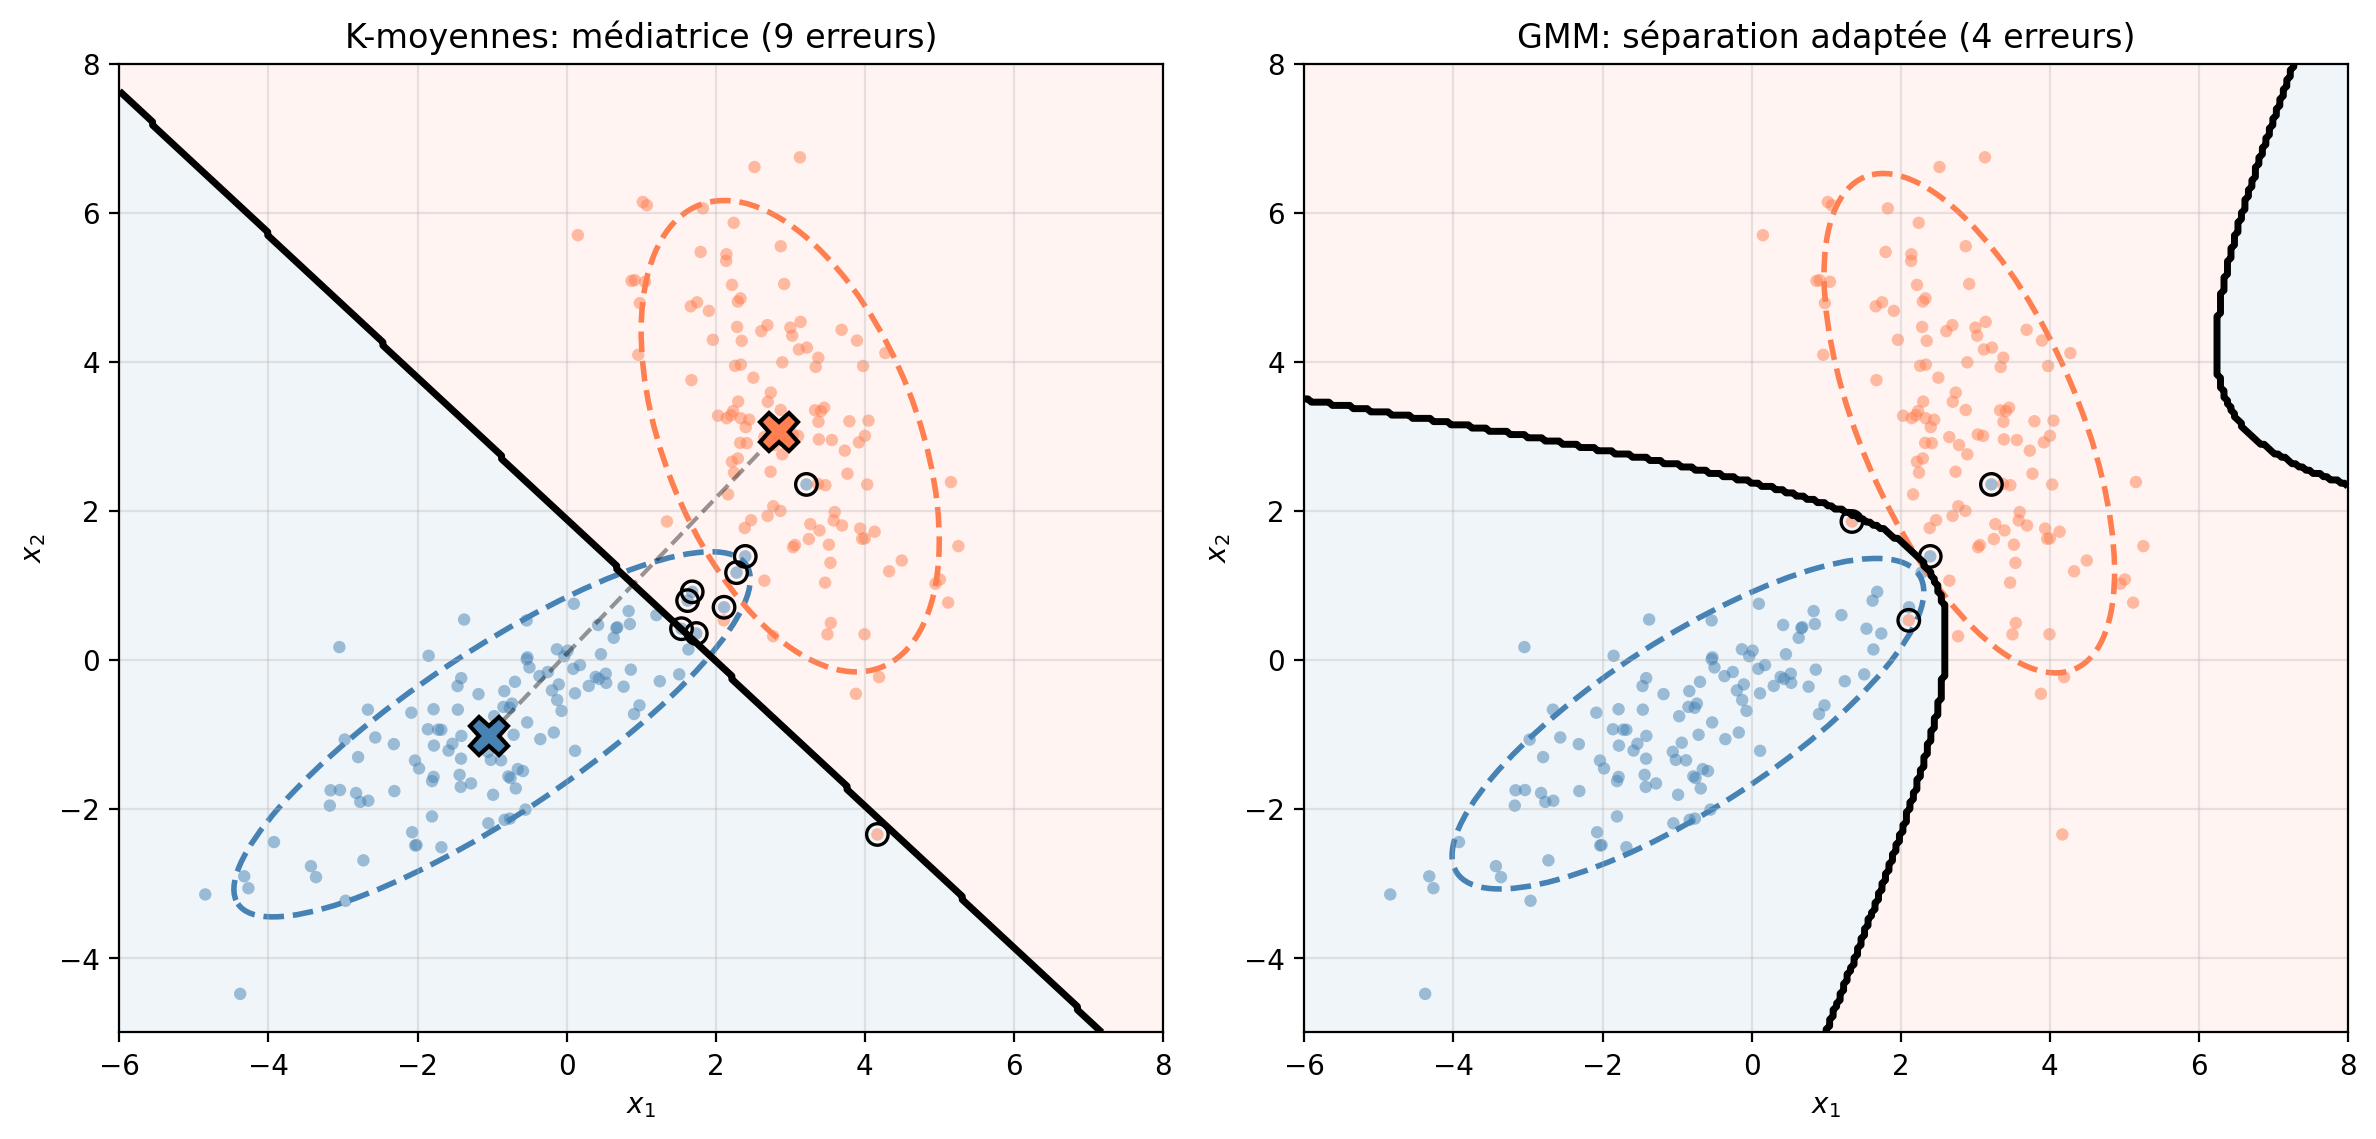
Les deux panneaux montrent les mêmes données (colorées selon leur vrai groupe d’origine) avec les ellipses de covariance à 2 écarts-types; les points mal assignés sont cerclés de noir. À gauche, k-moyennes sépare les groupes par la médiatrice du segment reliant les deux centroïdes: cette droite coupe à travers les ellipses et assigne au mauvais groupe les points qui se trouvent du côté «interdit» de la perpendiculaire. À droite, le GMM ajuste une covariance propre à chaque composant; la séparation entre les deux régions d’assignation épouse la forme elliptique des groupes et réduit le nombre d’erreurs.
Du partitionnement dur au modèle probabiliste
Comment dépasser cette limitation? Au lieu d’assigner chaque point à un seul groupe (0 ou 1), on peut lui attribuer une probabilité d’appartenir à chaque groupe. Et au lieu de groupes sphériques, on peut modéliser chaque groupe par une gaussienne avec sa propre matrice de covariance, capable de capturer des formes elliptiques.
C’est exactement ce que fait un modèle de mélange gaussien (GMM, Gaussian Mixture Model). Il suppose que les données sont générées par un mélange de distributions gaussiennes:
où est le poids du mélange pour le composant (avec et ). Nous pouvons interpréter ce modèle avec une variable latente qui indique de quel composant provient chaque observation:
Le processus de génération est: tirer un composant , puis tirer une observation . Ce cadre généralise l’analyse discriminante gaussienne au cas non supervisé: la même structure probabiliste s’applique, mais les «classes» sont maintenant inconnues.
Responsabilités
Pour une observation , la responsabilité du composant est la probabilité a posteriori que cette observation provienne du composant :
Les responsabilités sont des valeurs continues dans qui somment à 1 pour chaque observation. Un point situé exactement entre deux composants aura des responsabilités proches de pour chacun, exprimant l’ambiguïté de son appartenance. C’est un partitionnement souple (soft clustering), en contraste avec les assignations binaires de k-moyennes.
Le lien entre les deux est direct. Supposons que tous les composants partagent une covariance sphérique et des poids uniformes . Les facteurs de normalisation et les poids sont identiques pour tous les composants et s’annulent dans la fraction. Il ne reste que les exponentielles des distances, et les responsabilités prennent la forme d’un softmax, la même transformation que nous avions vue en régression logistique pour convertir des scores arbitraires en probabilités valides (, sommant à 1):
Quand est grand, les gaussiennes sont très étalées et les responsabilités sont proches de partout. Quand diminue, l’exponentielle associée au centroïde le plus proche domine de plus en plus. À la limite , les responsabilités deviennent binaires et on retrouve exactement l’assignation de k-moyennes. Passer de k-moyennes à un GMM revient donc à relâcher l’hypothèse de groupes sphériques et à remplacer les assignations dures par des probabilités d’appartenance.
Source
# Comparaison: partitionnement dur (k-moyennes) vs souple (GMM)
from sklearn.mixture import GaussianMixture

gmm = GaussianMixture(n_components=3, covariance_type='full', random_state=42)
gmm.fit(X_kmeans)
responsibilities = gmm.predict_proba(X_kmeans)

fig, axes = plt.subplots(1, 2, figsize=(11, 4.5))

# Gauche: k-moyennes (assignations dures)
ax = axes[0]
mu_final, labels_km = hist_km[-1]
colors_km_list = ['steelblue', 'coral', 'seagreen']
for k in range(3):
    mask = labels_km == k
    ax.scatter(X_kmeans[mask, 0], X_kmeans[mask, 1], c=colors_km_list[k], alpha=0.6, s=20, label=f'Groupe {k+1}')
    ax.plot(mu_final[k, 0], mu_final[k, 1], marker='X', color=colors_km_list[k],
            markersize=12, markeredgecolor='black', markeredgewidth=1.5, zorder=5)
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('K-moyennes (assignation dure)')
ax.legend()
ax.set_xlim(-3, 7)
ax.set_ylim(-3, 6)

# Droite: GMM (responsabilités souples + ellipses)
ax = axes[1]
rgb = responsibilities @ np.array([[0.27, 0.51, 0.71],
                                    [1.0, 0.5, 0.31],
                                    [0.18, 0.55, 0.34]])
ax.scatter(X_kmeans[:, 0], X_kmeans[:, 1], c=rgb, alpha=0.6, s=20)

from matplotlib.patches import Ellipse
for k in range(3):
    mean = gmm.means_[k]
    cov = gmm.covariances_[k]
    eigenvalues, eigenvectors = np.linalg.eigh(cov)
    angle = np.degrees(np.arctan2(eigenvectors[1, 0], eigenvectors[0, 0]))
    for n_std in [1, 2]:
        width, height = 2 * n_std * np.sqrt(eigenvalues)
        ellipse = Ellipse(mean, width, height, angle=angle, fill=False,
                         color=colors_km_list[k], linewidth=2, linestyle='--')
        ax.add_patch(ellipse)

ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('GMM (responsabilités souples, ellipses de covariance)')
ax.set_xlim(-3, 7)
ax.set_ylim(-3, 6)

plt.tight_layout()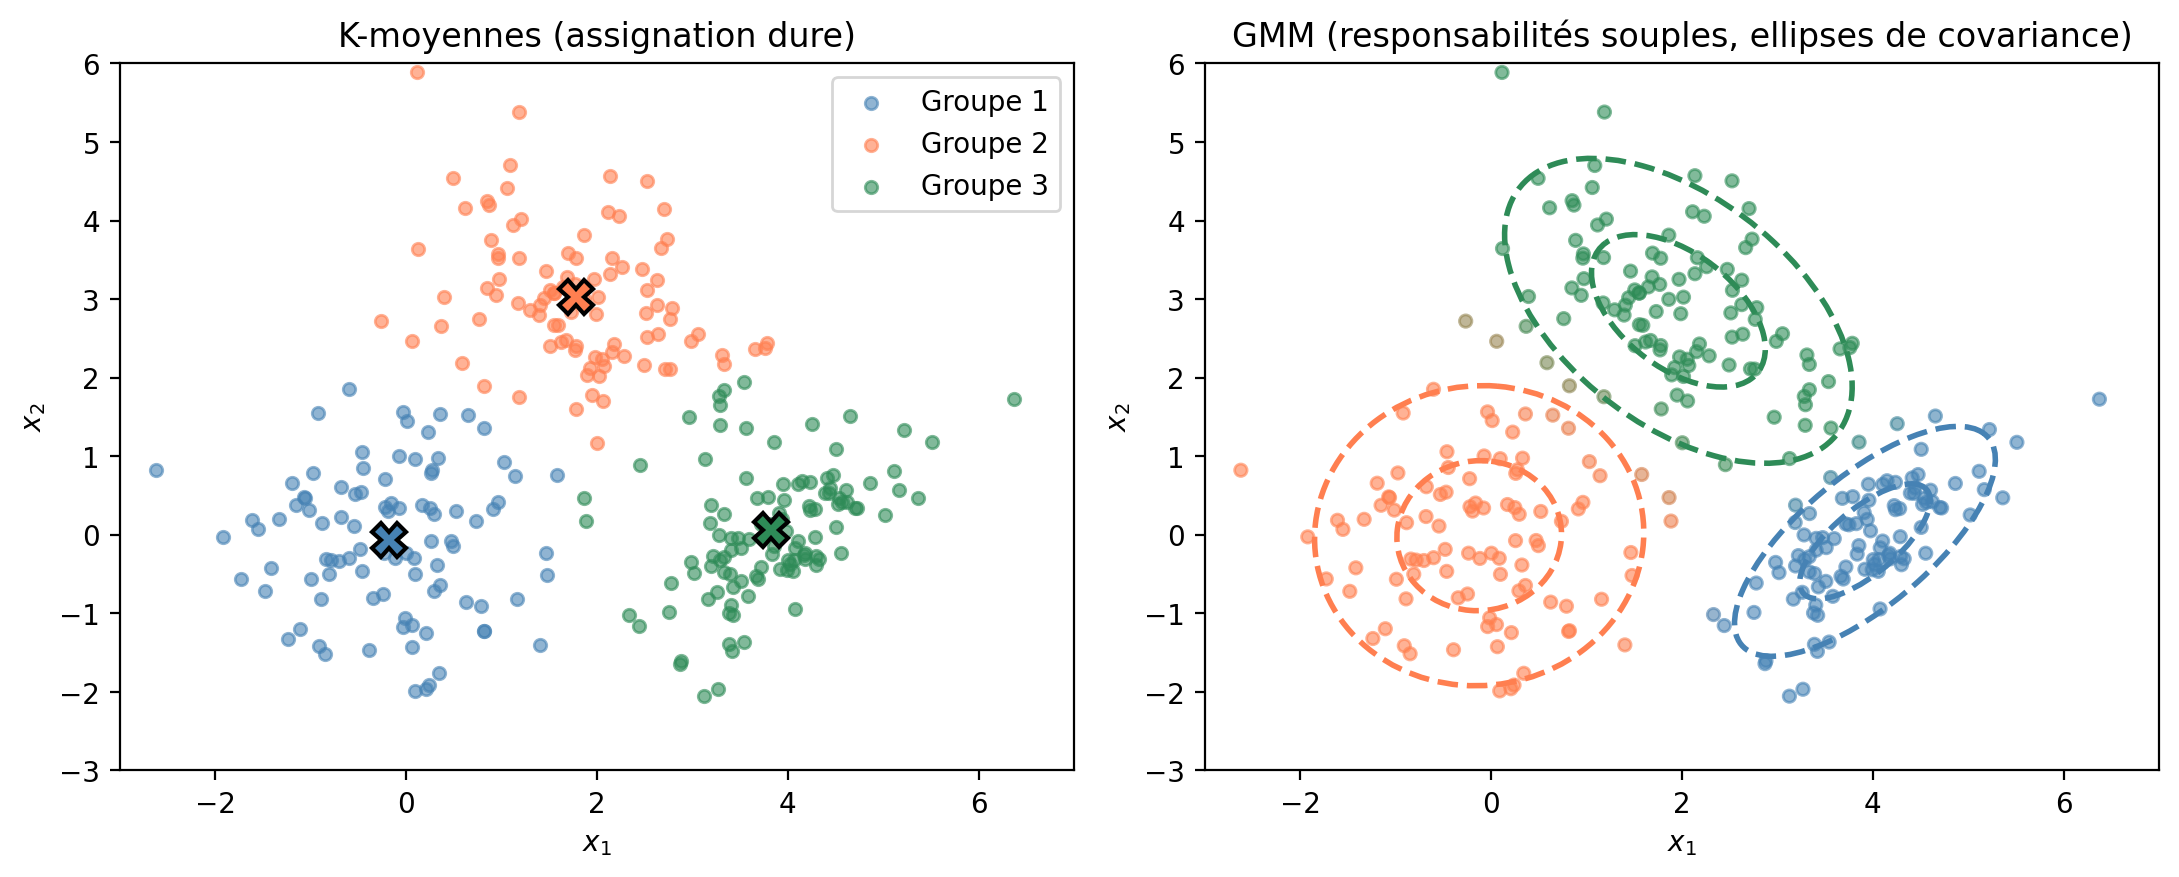
La figure met en regard les deux approches sur les mêmes données. À gauche, k-moyennes assigne chaque point à un seul groupe; les frontières sont rectilignes. À droite, le GMM exprime l’incertitude par un dégradé de couleurs et capture la forme elliptique de chaque composant grâce aux matrices de covariance.
Ce parallèle entre k-moyennes et GMM est aussi la clé pour comprendre l’algorithme EM: la même stratégie d’alternance (assigner les points, puis mettre à jour les paramètres) s’applique aux deux, mais avec des assignations souples au lieu de dures.
L’algorithme EM
Le problème d’estimation
K-moyennes alternait entre assigner les points et recalculer les centroïdes, et chaque étape avait une solution simple. Peut-on faire la même chose pour un GMM? La difficulté vient de la log-vraisemblance:
La somme à l’intérieur du logarithme empêche d’isoler la contribution de chaque composant. Il n’y a pas de solution analytique comme pour le naïf bayésien ou LDA.
Si nous connaissions les assignations de chaque point, le problème serait simple: nous estimerions séparément les paramètres de chaque composant à partir des points qui lui sont assignés, comme le fait k-moyennes. Mais les sont inconnus: ce sont des variables latentes. L’algorithme Espérance-Maximisation (EM) résout ce dilemme en reprenant la stratégie d’alternance de k-moyennes, mais avec des assignations souples.
L’intuition: k-moyennes avec des responsabilités
Dans k-moyennes, chaque itération fait deux choses: assigner les points (étape d’assignation), puis recalculer les centroïdes (étape de mise à jour). EM fait exactement la même chose, mais au lieu d’assigner chaque point à un seul groupe, il calcule des responsabilités, c’est-à-dire la probabilité que chaque point appartienne à chaque composant. Les mises à jour des paramètres deviennent alors des moyennes pondérées par ces responsabilités, plutôt que des moyennes simples sur les points assignés.
Les étapes de l’algorithme
Étape E (Espérance). Fixer les paramètres et calculer les responsabilités:
Étape M (Maximisation). Fixer les responsabilités et mettre à jour les paramètres. Définissons le «nombre effectif» de points dans le composant .
Poids du mélange:
Moyennes:
Covariances:
Ces formules sont des versions pondérées des estimateurs classiques. Au lieu de compter chaque point une fois, nous le pondérons par sa responsabilité envers le composant.
Pseudocode
Entrée: Données X, nombre de composants K

1. Initialiser les paramètres θ = (π, μ, Σ)
2. Répéter jusqu'à convergence:
   a. Étape E : calculer les responsabilités r_nk
   b. Étape M : mettre à jour π, μ, Σ
3. Calculer la log-vraisemblance et vérifier la convergence

Sortie: Paramètres θ et responsabilités r
Program 1:Algorithme EM pour un GMM
Visualisation de la convergence
Source
# Animation de l'algorithme EM sur un GMM
from matplotlib.patches import Ellipse
from matplotlib.animation import FuncAnimation
from IPython.display import HTML

np.random.seed(42)

# Données
n_samples = 300
true_means = [np.array([0, 0]), np.array([4, 0]), np.array([2, 3])]
true_covs = [np.array([[1, 0], [0, 1]]),
             np.array([[0.5, 0.3], [0.3, 0.5]]),
             np.array([[0.8, -0.4], [-0.4, 0.8]])]
X_em = np.vstack([np.random.multivariate_normal(m, c, n_samples // 3)
                  for m, c in zip(true_means, true_covs)])

# Fonction pour calculer la densité gaussienne
def gaussian_pdf(x, mean, cov):
    d = len(mean)
    diff = x - mean
    return np.exp(-0.5 * diff @ np.linalg.inv(cov) @ diff) / np.sqrt((2*np.pi)**d * np.linalg.det(cov))

# Initialisation (mauvaise, pour montrer la convergence)
K = 3
np.random.seed(123)
means = [np.random.randn(2) * 2 for _ in range(K)]
covs = [np.eye(2) * 2 for _ in range(K)]
weights = np.ones(K) / K

# Stocker l'historique
history = {'means': [means.copy()], 'covs': [covs.copy()], 'weights': [weights.copy()]}

# Exécuter EM
for iteration in range(15):
    # Étape E
    responsibilities = np.zeros((len(X_em), K))
    for n, x in enumerate(X_em):
        for k in range(K):
            responsibilities[n, k] = weights[k] * gaussian_pdf(x, means[k], covs[k])
        responsibilities[n] /= responsibilities[n].sum()

    # Étape M
    N_k = responsibilities.sum(axis=0)
    weights = N_k / len(X_em)
    for k in range(K):
        means[k] = (responsibilities[:, k:k+1] * X_em).sum(axis=0) / N_k[k]
        diff = X_em - means[k]
        covs[k] = (responsibilities[:, k:k+1] * diff).T @ diff / N_k[k]

    history['means'].append([m.copy() for m in means])
    history['covs'].append([c.copy() for c in covs])
    history['weights'].append(weights.copy())

# Créer la figure
fig, ax = plt.subplots(figsize=(8, 6))
colors = ['steelblue', 'coral', 'seagreen']

def draw_ellipse(ax, mean, cov, color, alpha=0.3):
    eigenvalues, eigenvectors = np.linalg.eigh(cov)
    angle = np.degrees(np.arctan2(eigenvectors[1, 0], eigenvectors[0, 0]))
    for n_std in [1, 2]:
        width, height = 2 * n_std * np.sqrt(np.maximum(eigenvalues, 1e-6))
        ellipse = Ellipse(mean, width, height, angle=angle, fill=True,
                         facecolor=color, alpha=alpha*0.5, edgecolor=color, linewidth=2)
        ax.add_patch(ellipse)

def animate(frame):
    ax.clear()
    ax.scatter(X_em[:, 0], X_em[:, 1], c='gray', alpha=0.3, s=10)

    for k in range(K):
        mean = history['means'][frame][k]
        cov = history['covs'][frame][k]
        draw_ellipse(ax, mean, cov, colors[k])
        ax.plot(mean[0], mean[1], 'o', color=colors[k], markersize=10, markeredgecolor='black')

    ax.set_xlim(-4, 7)
    ax.set_ylim(-4, 6)
    ax.set_xlabel('$x_1$')
    ax.set_ylabel('$x_2$')
    ax.set_title(f'Algorithme EM - Itération {frame}')
    return []

anim = FuncAnimation(fig, animate, frames=len(history['means']), interval=500, blit=True)
anim.save('_static/em_convergence.gif', writer='pillow', fps=2, dpi=100)
plt.close()

from IPython.display import Image
Image(filename='_static/em_convergence.gif')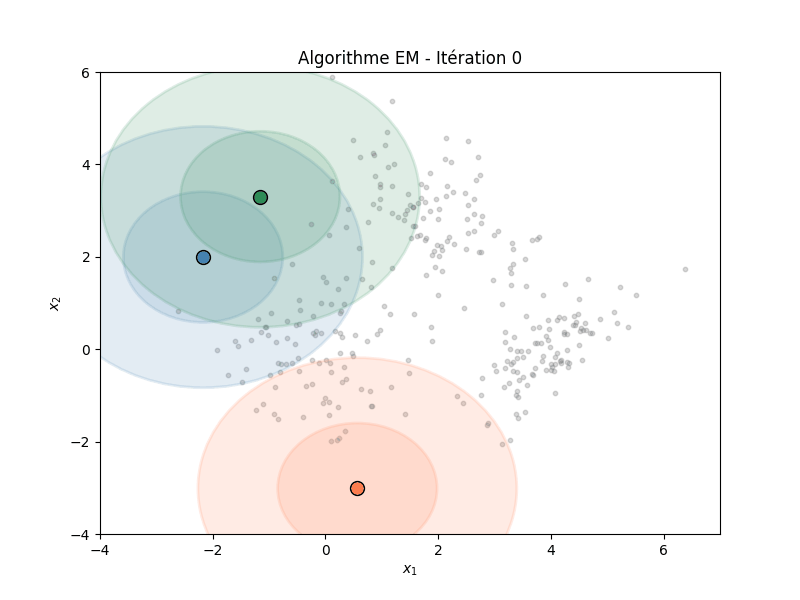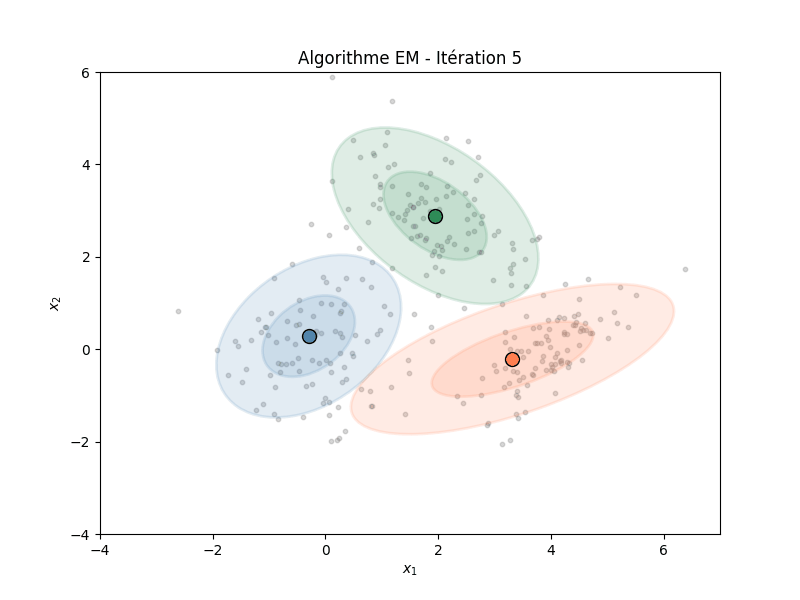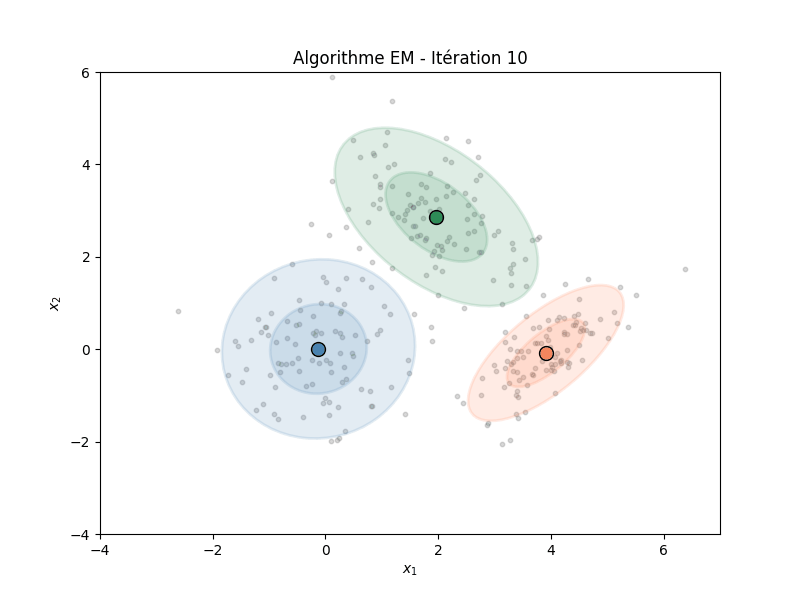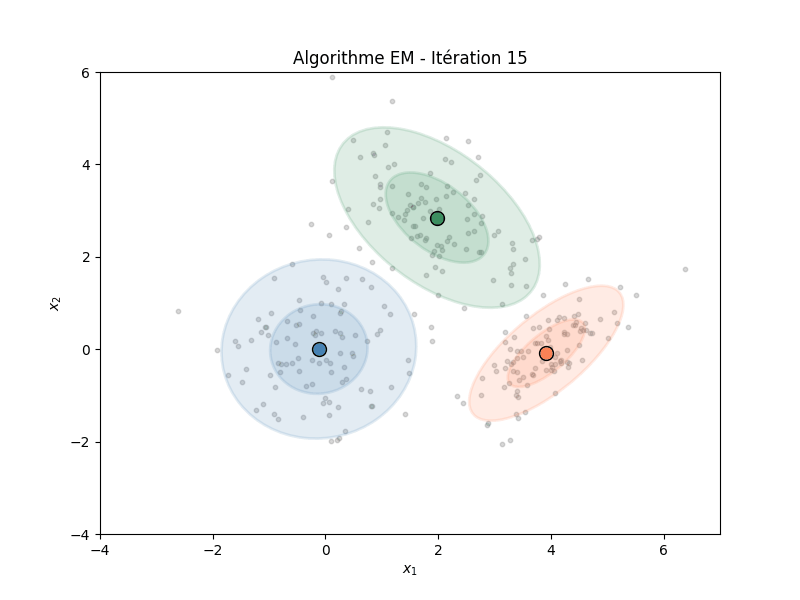
L’animation montre la convergence de l’algorithme EM. Les ellipses représentent les composants gaussiens (contours à 1 et 2 écarts-types), et les points colorés sont les moyennes. À partir d’une initialisation arbitraire, l’algorithme ajuste progressivement les paramètres pour mieux couvrir les données.
Considérations pratiques
Initialisation. EM converge vers un maximum local, et le résultat dépend de l’initialisation. Stratégies courantes:
Exécuter EM plusieurs fois avec des initialisations aléatoires différentes
Initialiser avec k-moyennes (rapide et donne souvent un bon point de départ)
Utiliser k-means++ pour une initialisation plus robuste
Choix de . Le nombre de composants est un hyperparamètre. Des critères comme le BIC (Bayesian Information Criterion) ou l’AIC (Akaike Information Criterion) pénalisent la complexité du modèle et peuvent guider ce choix.
Singularités. Si un composant contient un seul point, sa covariance estimée peut être singulière. Solutions:
Ajouter une régularisation diagonale:
Utiliser des covariances contraintes (diagonales ou partagées)
Réinitialiser les composants problématiques
Inférence variationnelle et EM
Jusqu’ici, nous avons présenté EM comme une recette: calculer les responsabilités, mettre à jour les paramètres, répéter. Mais pourquoi cette alternance converge-t-elle? Et y a-t-il un objectif que chaque itération améliore? Cette section répond à ces questions en construisant une borne inférieure de la log-vraisemblance, puis en montrant qu’EM la maximise par alternance. La dérivation qui suit est un peu plus formelle que le reste du chapitre. Prenons le temps de la parcourir étape par étape; si certains passages semblent abstraits en première lecture, le point à retenir est résumé à la fin de la section.
Le problème: la somme dans le logarithme
Revenons à notre GMM. La log-vraisemblance que nous voulons maximiser est:
La somme sur les composants se trouve à l’intérieur du logarithme. Si nous connaissions l’assignation de chaque point, le log passerait directement sur chaque gaussienne et le problème serait séparable. Comme les sont inconnus, il nous faut un moyen de « pousser » le logarithme à travers cette somme. L’idée est de construire un objectif auxiliaire, une borne inférieure de , que l’on peut optimiser même sans connaître les .
Construire une borne inférieure
Introduisons une distribution auxiliaire sur les variables latentes (les assignations de tous les points). Cette distribution est un outil de calcul: nous sommes libres de la choisir comme nous voulons. Partons de la règle de Bayes, qui relie la conjointe et l’a posteriori:
Cette égalité est vraie pour tout . En prenant le logarithme des deux côtés:
Le membre de gauche ne dépend pas de : c’est une constante par rapport aux latentes. Si nous prenons la moyenne de cette égalité sous notre distribution auxiliaire , le membre de gauche ne change pas, et nous obtenons:
Maintenant, ajoutons et retranchons dans le membre de droite. Cela revient à réarranger les termes, sans rien changer à l’égalité. En regroupant:
Le second terme est la divergence de Kullback-Leibler entre et l’a posteriori exact. Cette divergence mesure à quel point diffère de la vraie distribution des latentes, et elle est toujours (elle vaut zéro uniquement quand coïncide exactement avec l’a posteriori).
Puisque la log-vraisemblance est la somme de ces deux termes et que la KL est positive, le premier terme est nécessairement plus petit (ou égal) à la log-vraisemblance:
Ce premier terme porte le nom de borne inférieure de l’évidence (en anglais Evidence Lower Bound, d’où l’acronyme ELBO). L’« évidence » désigne ici , la vraisemblance marginale des données. L’ELBO est une borne inférieure de cette quantité, et la borne est serrée (l’égalité est atteinte) quand .
EM maximise l’ELBO par alternance
Nous avons maintenant un objectif, l’ELBO, qui dépend de deux choses: la distribution auxiliaire et les paramètres . Comment le maximiser?
Optimiser à fixé. Si les paramètres du modèle sont fixés, quel donne le meilleur ELBO? L’égalité nous le dit: puisque la log-vraisemblance ne dépend pas de , augmenter l’ELBO revient exactement à diminuer la KL. Le maximum est atteint quand la KL vaut zéro, c’est-à-dire quand . Pour le GMM, cet a posteriori correspond aux responsabilités que nous calculons à l’étape E.
Optimiser à fixé. Maintenant que est fixée, l’ELBO se simplifie: moins une constante (le terme ne dépend pas de ). Maximiser l’ELBO en revient à maximiser la log-vraisemblance conjointe pondérée par les responsabilités. Ce sont exactement les formules de l’étape M (moyennes pondérées, covariances pondérées, etc.).
L’alternance E/M est donc une maximisation par coordonnées de l’ELBO: l’étape E ajuste pour serrer la borne au maximum, puis l’étape M ajuste pour pousser cette borne vers le haut. À chaque demi-pas, l’ELBO augmente (ou reste stable), et comme il reste toujours inférieur à la log-vraisemblance, la log-vraisemblance elle-même ne peut pas diminuer. Cela garantit la convergence vers un maximum local.
En résumé: EM n’est pas une heuristique ad hoc, mais une procédure d’optimisation bien fondée. Chaque itération améliore un objectif précis (l’ELBO), et la convergence découle de cette monotonie.
L’inférence variationnelle: au-delà d’EM
Le raisonnement que nous venons de mener, maximiser l’ELBO par rapport à une distribution auxiliaire et des paramètres , porte un nom: l’inférence variationnelle. EM en est le cas le plus favorable: l’a posteriori est calculable (les responsabilités du GMM ont une formule fermée), et nous pouvons choisir exactement égal à cet a posteriori.
Mélange d’experts
Du partitionnement à la prédiction
Un GMM partitionne l’espace des observations en groupes, mais il ne fait pas de prédiction. Pourtant, l’idée de «diviser un problème entre plusieurs spécialistes» s’applique naturellement à la régression et à la classification. Considérons des données où la relation entre l’entrée et la sortie change selon la région: par exemple, un système physique qui se comporte différemment à basse et haute température, ou un marché dont la dynamique varie selon la conjoncture. Un seul modèle linéaire ne peut pas capturer ces régimes. Mais si l’on dispose de plusieurs modèles linéaires (un par régime) et d’un mécanisme pour aiguiller chaque observation vers le bon modèle, on obtient une prédiction flexible à partir de composants simples.
Source
# Données de régression par morceaux: deux régimes linéaires
np.random.seed(42)
n_moe = 200
x_moe = np.random.uniform(-3, 3, n_moe)
noise_moe = np.random.normal(0, 0.3, n_moe)
y_moe = np.where(x_moe < 0, 2 * x_moe + 1, -1.5 * x_moe + 2) + noise_moe

# Régression linéaire unique
X_moe = np.column_stack([np.ones(n_moe), x_moe])
w_lin = np.linalg.lstsq(X_moe, y_moe, rcond=None)[0]

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))

ax = axes[0]
ax.scatter(x_moe, y_moe, c='gray', alpha=0.5, s=20)
x_grid_moe = np.linspace(-3, 3, 200)
ax.plot(x_grid_moe, w_lin[0] + w_lin[1] * x_grid_moe, 'k-', linewidth=2, label='Régression linéaire')
ax.set_xlabel('$x$')
ax.set_ylabel('$y$')
ax.set_title('Un seul modèle linéaire')
ax.legend()
ax.grid(True, alpha=0.3)

ax = axes[1]
mask_neg = x_moe < 0
mask_pos = ~mask_neg
ax.scatter(x_moe[mask_neg], y_moe[mask_neg], c='steelblue', alpha=0.5, s=20, label='Régime 1')
ax.scatter(x_moe[mask_pos], y_moe[mask_pos], c='coral', alpha=0.5, s=20, label='Régime 2')
ax.plot(x_grid_moe[x_grid_moe < 0], 2 * x_grid_moe[x_grid_moe < 0] + 1,
        'steelblue', linewidth=2, label='Expert 1')
ax.plot(x_grid_moe[x_grid_moe >= 0], -1.5 * x_grid_moe[x_grid_moe >= 0] + 2,
        'coral', linewidth=2, label='Expert 2')
ax.set_xlabel('$x$')
ax.set_ylabel('$y$')
ax.set_title('Deux experts, un par régime')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)

plt.tight_layout()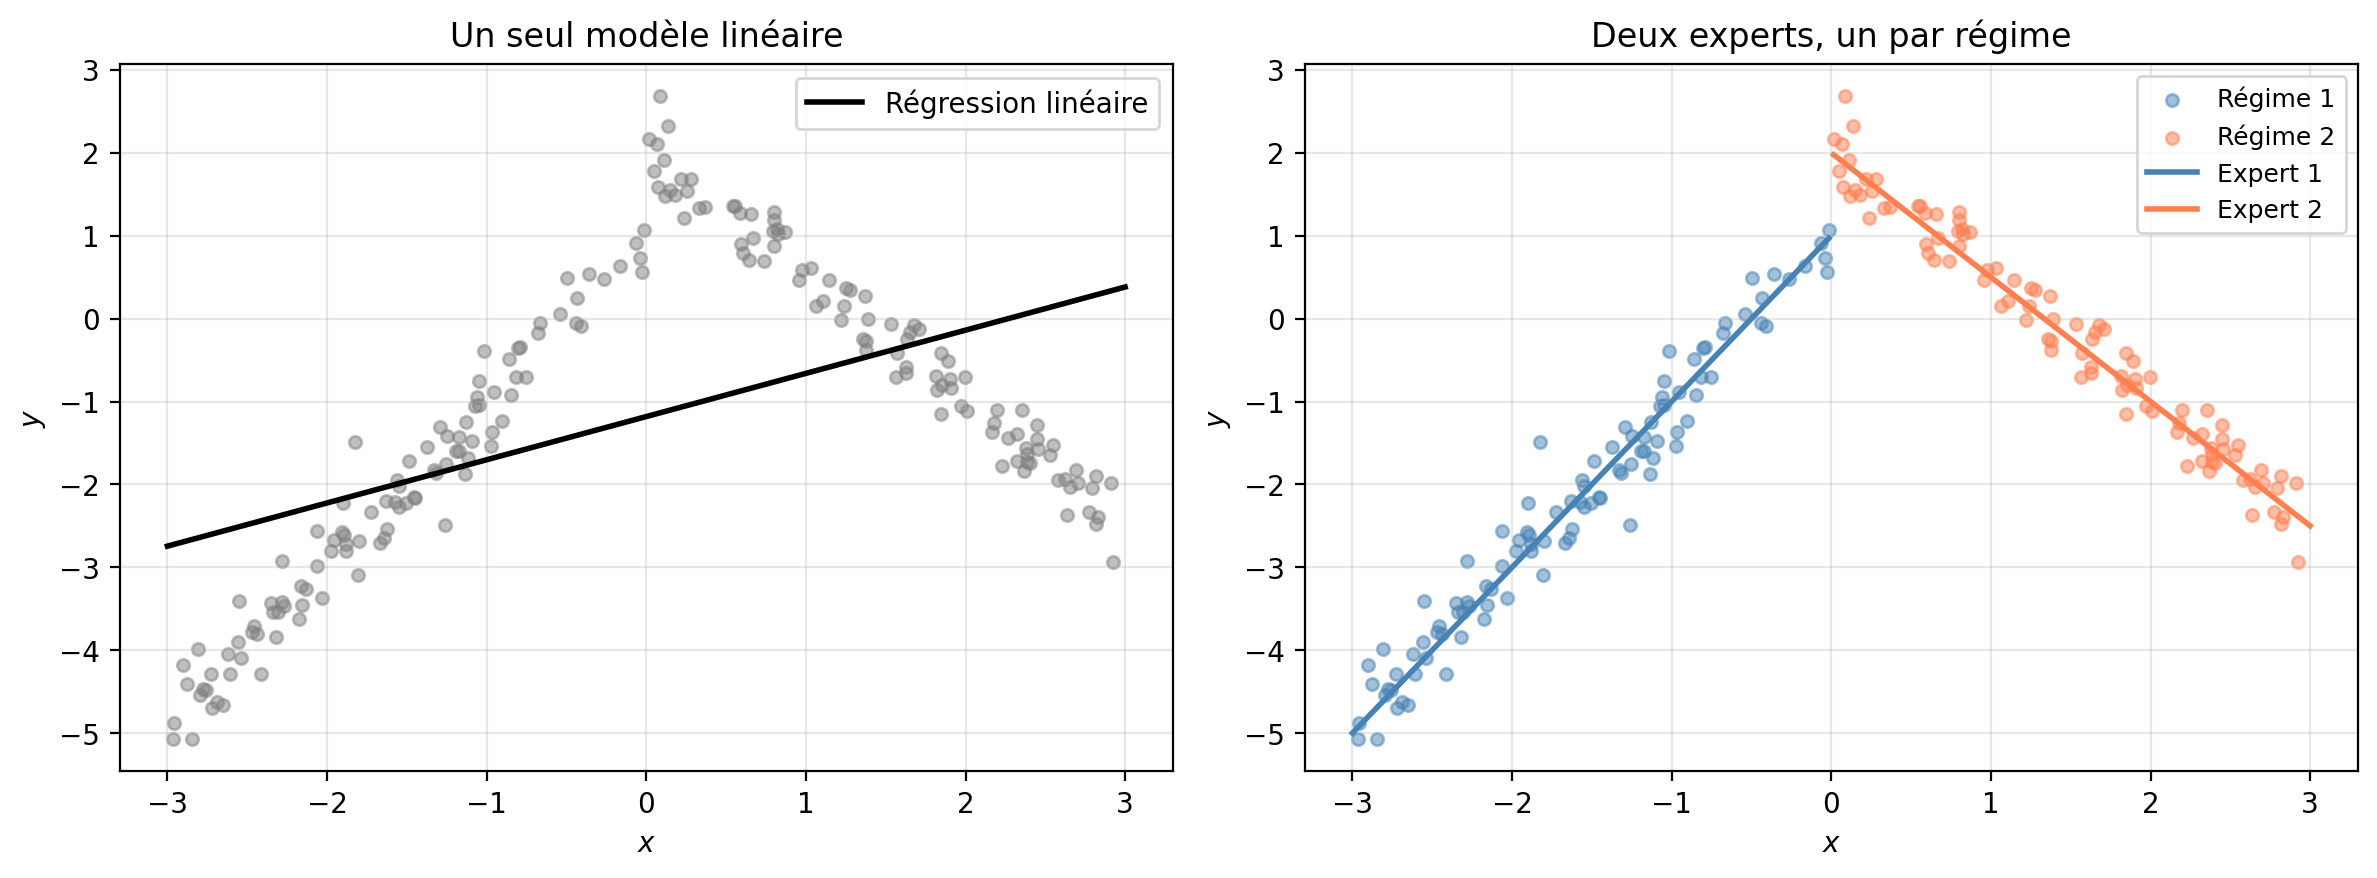
La figure illustre le problème. À gauche, une seule droite de régression ne capture ni la pente ascendante pour ni la pente descendante pour : elle passe au milieu sans bien prédire aucune des deux régions. À droite, deux experts linéaires se partagent le travail et chacun s’ajuste à son régime. Le mélange d’experts (Mixture of Experts, MoE) formalise cette idée.
Le modèle
Un mélange d’experts modélise la distribution conditionnelle comme un mélange de modèles simples, les experts, dont les poids dépendent de l’entrée:
La structure rappelle le GMM, mais avec deux différences. D’abord, c’est un modèle supervisé: on prédit à partir de , au lieu de modéliser la densité de seul. Ensuite, les poids du mélange ne sont plus des constantes : ils sont calculés par un réseau de routage (ou gating network) qui dépend de l’entrée.
Le réseau de routage utilise un softmax sur des scores linéaires:
où les sont des paramètres appris. Les sorties sont positives et somment à 1: elles représentent la probabilité que l’expert soit responsable de l’observation . Si est beaucoup plus grand que les autres scores, le routage attribue presque tout le poids à l’expert 1.
Chaque expert est un modèle de régression linéaire gaussien:
L’expert prédit avec une incertitude . La prédiction globale du MoE est la moyenne pondérée des prédictions de chaque expert:
EM pour le mélange d’experts
L’estimation des paramètres suit la même logique EM que pour le GMM. La variable latente indique quel expert est responsable de l’observation .
Étape E. On calcule les responsabilités, soit la probabilité a posteriori que l’expert soit responsable de :
La structure est identique à celle du GMM: le numérateur est le produit du poids (ici au lieu de ) par la vraisemblance du point sous le composant . La différence est que la vraisemblance porte sur conditionné à , et que les poids dépendent de .
Étape M. On met à jour les paramètres en deux temps.
Pour les experts, la mise à jour de est une régression linéaire pondérée par les responsabilités. Au lieu de minimiser comme en régression ordinaire, on minimise : chaque point contribue proportionnellement à la responsabilité de l’expert pour ce point. La solution en forme fermée est:
où . La variance se met à jour de manière analogue:
Pour le routage, on maximise par rapport aux paramètres . Contrairement aux experts, il n’y a pas de formule fermée pour le softmax; on utilise quelques itérations de montée de gradient avec le gradient:
Ce gradient a une interprétation simple: si la responsabilité est plus grande que le poids actuel , le gradient pousse le routage à donner plus de poids à l’expert pour les entrées proches de .
Source
# Implémentation complète du MoE et visualisation
def softmax_stable(logits):
    logits = logits - logits.max(axis=1, keepdims=True)
    e = np.exp(logits)
    return e / e.sum(axis=1, keepdims=True)

def moe_fit(X, y, K=2, n_iter=40, seed=42):
    """Ajuste un MoE par EM."""
    N, D = X.shape
    rng = np.random.RandomState(seed)

    # Initialisation
    V = rng.randn(K, D) * 0.1
    w_list = [np.linalg.lstsq(X, y, rcond=None)[0] + rng.randn(D) * 0.3 for _ in range(K)]
    sig2 = np.ones(K) * 0.5
    ll_hist = []

    for _ in range(n_iter):
        # Étape E
        g = softmax_stable(X @ V.T)
        weighted = np.zeros((N, K))
        for k in range(K):
            mu_k = X @ w_list[k]
            weighted[:, k] = g[:, k] * np.exp(-0.5 * (y - mu_k)**2 / sig2[k]) / np.sqrt(2 * np.pi * sig2[k])
        r = weighted / (weighted.sum(axis=1, keepdims=True) + 1e-300)

        # Étape M : experts (régression pondérée)
        for k in range(K):
            rk = r[:, k]
            Xr = np.sqrt(rk)[:, None] * X
            yr = np.sqrt(rk) * y
            w_list[k] = np.linalg.lstsq(Xr, yr, rcond=None)[0]
            pred_k = X @ w_list[k]
            sig2[k] = np.sum(rk * (y - pred_k)**2) / (rk.sum() + 1e-10) + 1e-6

        # Étape M : routage (montée de gradient)
        for _ in range(30):
            g = softmax_stable(X @ V.T)
            for k in range(K):
                V[k] += 0.05 * X.T @ (r[:, k] - g[:, k])

        # Log-vraisemblance
        g = softmax_stable(X @ V.T)
        ll = 0
        for k in range(K):
            mu_k = X @ w_list[k]
            ll += g[:, k] * np.exp(-0.5 * (y - mu_k)**2 / sig2[k]) / np.sqrt(2 * np.pi * sig2[k])
        ll_hist.append(np.sum(np.log(ll + 1e-300)))

    return V, w_list, sig2, r, ll_hist

V_fit, w_fit, sig_fit, r_fit, ll_fit = moe_fit(X_moe, y_moe, K=2, n_iter=40)

# Grille de prédiction
x_g = np.linspace(-3.2, 3.2, 300)
X_g = np.column_stack([np.ones(300), x_g])
g_g = softmax_stable(X_g @ V_fit.T)
mu_experts = np.column_stack([X_g @ w_fit[k] for k in range(2)])
y_pred_moe = (g_g * mu_experts).sum(axis=1)

fig, axes = plt.subplots(1, 3, figsize=(15, 4.5))

# Panel 1: experts et prédiction globale
ax = axes[0]
ax.scatter(x_moe, y_moe, c='gray', alpha=0.4, s=15)
ax.plot(x_g, mu_experts[:, 0], color='steelblue', linewidth=2, alpha=0.7, label='Expert 1')
ax.plot(x_g, mu_experts[:, 1], color='coral', linewidth=2, alpha=0.7, label='Expert 2')
ax.plot(x_g, y_pred_moe, 'k-', linewidth=2.5, label='Prédiction MoE')
ax.set_xlabel('$x$')
ax.set_ylabel('$y$')
ax.set_title('Prédictions des experts')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)

# Panel 2: réseau de routage
ax = axes[1]
ax.plot(x_g, g_g[:, 0], color='steelblue', linewidth=2.5, label='$g_1(x)$ (expert 1)')
ax.plot(x_g, g_g[:, 1], color='coral', linewidth=2.5, label='$g_2(x)$ (expert 2)')
ax.axhline(0.5, color='gray', linestyle=':', alpha=0.5)
ax.set_xlabel('$x$')
ax.set_ylabel('Poids du routage')
ax.set_title('Réseau de routage')
ax.legend(fontsize=9)
ax.set_ylim(-0.05, 1.05)
ax.grid(True, alpha=0.3)

# Panel 3: points colorés par responsabilité
ax = axes[2]
rgb_moe = r_fit @ np.array([[0.27, 0.51, 0.71], [0.99, 0.50, 0.31]])
ax.scatter(x_moe, y_moe, c=rgb_moe, alpha=0.7, s=25)
ax.plot(x_g, y_pred_moe, 'k-', linewidth=2)
ax.set_xlabel('$x$')
ax.set_ylabel('$y$')
ax.set_title('Responsabilités (couleur = assignation souple)')
ax.grid(True, alpha=0.3)

plt.tight_layout()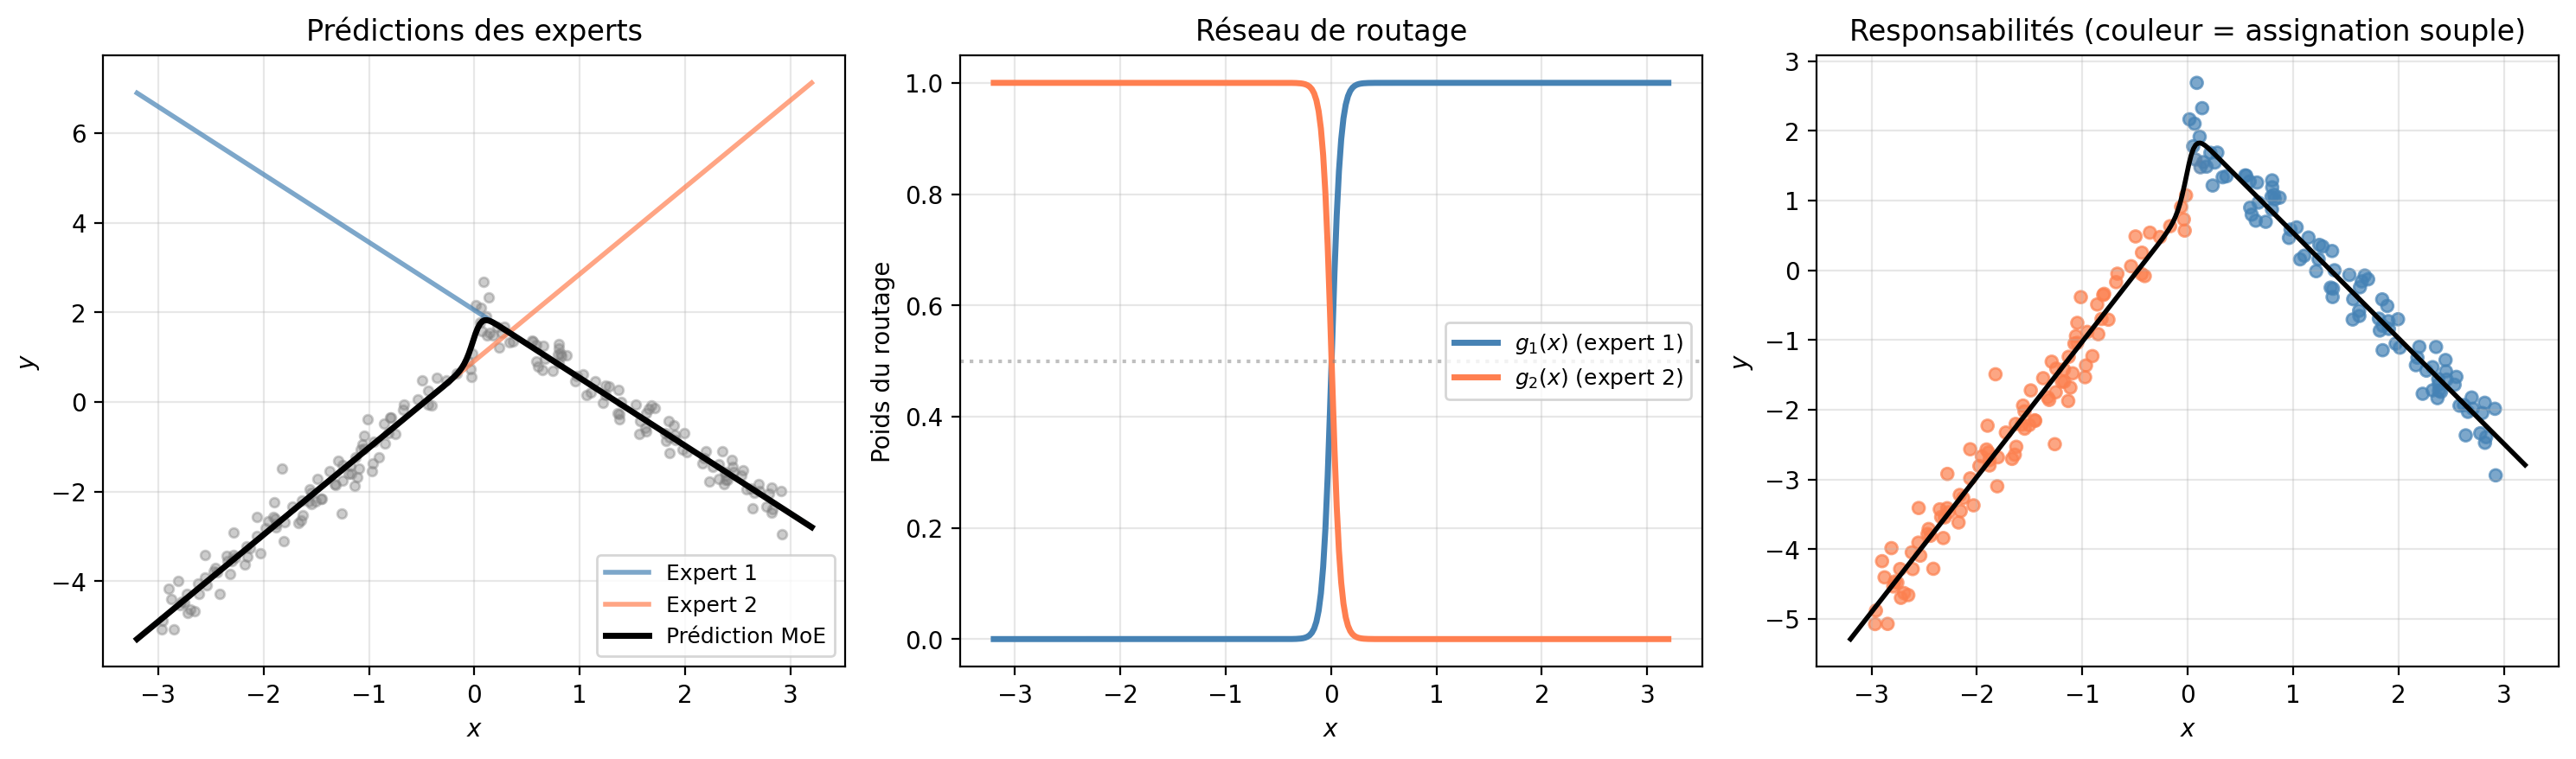
Le panneau de gauche montre les deux experts (droites colorées) et la prédiction globale du MoE (courbe noire), qui passe d’un expert à l’autre dans la zone de transition. Le panneau central montre le réseau de routage: domine pour et domine pour , avec une transition sigmoïdale autour de zéro. Le panneau de droite colore chaque point selon ses responsabilités: les points bleus sont gérés par l’expert 1, les points orangés par l’expert 2, et les points dans la zone de transition ont une couleur intermédiaire.
L’animation suivante montre comment EM fait converger le MoE. Au départ, les deux experts sont mal orientés et le routage est presque uniforme. Au fil des itérations, chaque expert se spécialise sur son régime et le routage apprend à les séparer.
Source
# Animation de la convergence EM pour le MoE
from matplotlib.animation import FuncAnimation
from IPython.display import Image as IPImage

def moe_fit_history(X, y, K=2, n_iter=40, seed=42):
    """Ajuste un MoE par EM et stocke l'historique de chaque itération."""
    N, D = X.shape
    rng = np.random.RandomState(seed)
    V = rng.randn(K, D) * 0.1
    w_list = [np.linalg.lstsq(X, y, rcond=None)[0] + rng.randn(D) * 0.3 for _ in range(K)]
    sig2 = np.ones(K) * 0.5
    history = []
    # Stocker état initial
    history.append({'V': V.copy(), 'w': [w.copy() for w in w_list],
                    'sig2': sig2.copy(), 'r': np.ones((N, K)) / K})
    for _ in range(n_iter):
        g = softmax_stable(X @ V.T)
        weighted = np.zeros((N, K))
        for k in range(K):
            mu_k = X @ w_list[k]
            weighted[:, k] = g[:, k] * np.exp(-0.5 * (y - mu_k)**2 / sig2[k]) / np.sqrt(2 * np.pi * sig2[k])
        r = weighted / (weighted.sum(axis=1, keepdims=True) + 1e-300)
        for k in range(K):
            rk = r[:, k]
            Xr = np.sqrt(rk)[:, None] * X
            yr = np.sqrt(rk) * y
            w_list[k] = np.linalg.lstsq(Xr, yr, rcond=None)[0]
            pred_k = X @ w_list[k]
            sig2[k] = np.sum(rk * (y - pred_k)**2) / (rk.sum() + 1e-10) + 1e-6
        for _ in range(30):
            g = softmax_stable(X @ V.T)
            for k in range(K):
                V[k] += 0.05 * X.T @ (r[:, k] - g[:, k])
        history.append({'V': V.copy(), 'w': [w.copy() for w in w_list],
                        'sig2': sig2.copy(), 'r': r.copy()})
    return history

hist_moe = moe_fit_history(X_moe, y_moe, K=2, n_iter=25)

x_anim = np.linspace(-3.2, 3.2, 200)
X_anim = np.column_stack([np.ones(200), x_anim])
colors_ex = ['steelblue', 'coral']
rgb_basis = np.array([[0.27, 0.51, 0.71], [0.99, 0.50, 0.31]])

fig_moe, axes_moe = plt.subplots(1, 3, figsize=(15, 4.5))

def animate_moe(frame):
    state = hist_moe[frame]
    V_t, w_t, sig_t, r_t = state['V'], state['w'], state['sig2'], state['r']
    g_t = softmax_stable(X_anim @ V_t.T)
    mu_t = np.column_stack([X_anim @ w_t[k] for k in range(2)])
    y_pred_t = (g_t * mu_t).sum(axis=1)

    # Panel 1: experts + prédiction
    ax = axes_moe[0]
    ax.clear()
    ax.scatter(x_moe, y_moe, c='gray', alpha=0.3, s=12)
    ax.plot(x_anim, mu_t[:, 0], color=colors_ex[0], linewidth=2, alpha=0.7, label='Expert 1')
    ax.plot(x_anim, mu_t[:, 1], color=colors_ex[1], linewidth=2, alpha=0.7, label='Expert 2')
    ax.plot(x_anim, y_pred_t, 'k-', linewidth=2.5, label='Prédiction MoE')
    ax.set_xlabel('$x$')
    ax.set_ylabel('$y$')
    ax.set_title(f'Experts, itération {frame}')
    ax.legend(fontsize=8, loc='upper right')
    ax.set_xlim(-3.3, 3.3)
    ax.set_ylim(-7, 6)
    ax.grid(True, alpha=0.3)

    # Panel 2: routage
    ax = axes_moe[1]
    ax.clear()
    ax.plot(x_anim, g_t[:, 0], color=colors_ex[0], linewidth=2.5, label='$g_1(x)$')
    ax.plot(x_anim, g_t[:, 1], color=colors_ex[1], linewidth=2.5, label='$g_2(x)$')
    ax.axhline(0.5, color='gray', linestyle=':', alpha=0.5)
    ax.set_xlabel('$x$')
    ax.set_ylabel('Poids du routage')
    ax.set_title(f'Routage, itération {frame}')
    ax.legend(fontsize=8)
    ax.set_xlim(-3.3, 3.3)
    ax.set_ylim(-0.05, 1.05)
    ax.grid(True, alpha=0.3)

    # Panel 3: responsabilités
    ax = axes_moe[2]
    ax.clear()
    pt_colors = r_t @ rgb_basis
    ax.scatter(x_moe, y_moe, c=pt_colors, alpha=0.7, s=20)
    ax.plot(x_anim, y_pred_t, 'k-', linewidth=2)
    ax.set_xlabel('$x$')
    ax.set_ylabel('$y$')
    ax.set_title(f'Responsabilités, itération {frame}')
    ax.set_xlim(-3.3, 3.3)
    ax.set_ylim(-7, 6)
    ax.grid(True, alpha=0.3)
    return []

anim_moe = FuncAnimation(fig_moe, animate_moe,
                          frames=len(hist_moe), interval=600, blit=True)
anim_moe.save('_static/moe_convergence.gif', writer='pillow', fps=2, dpi=100)
plt.close()

IPImage(filename='_static/moe_convergence.gif')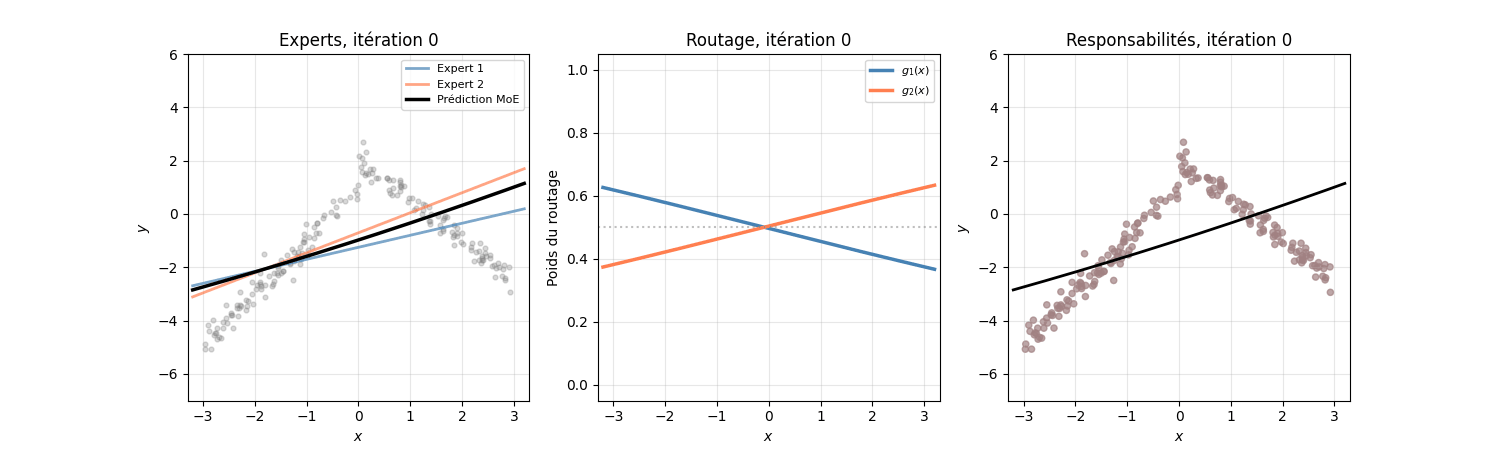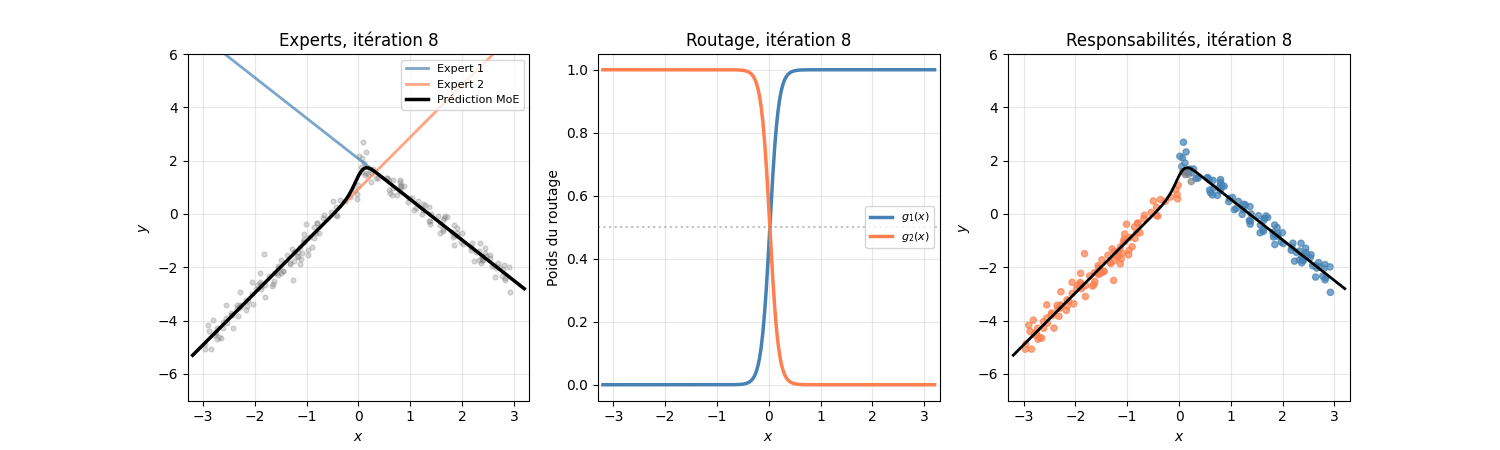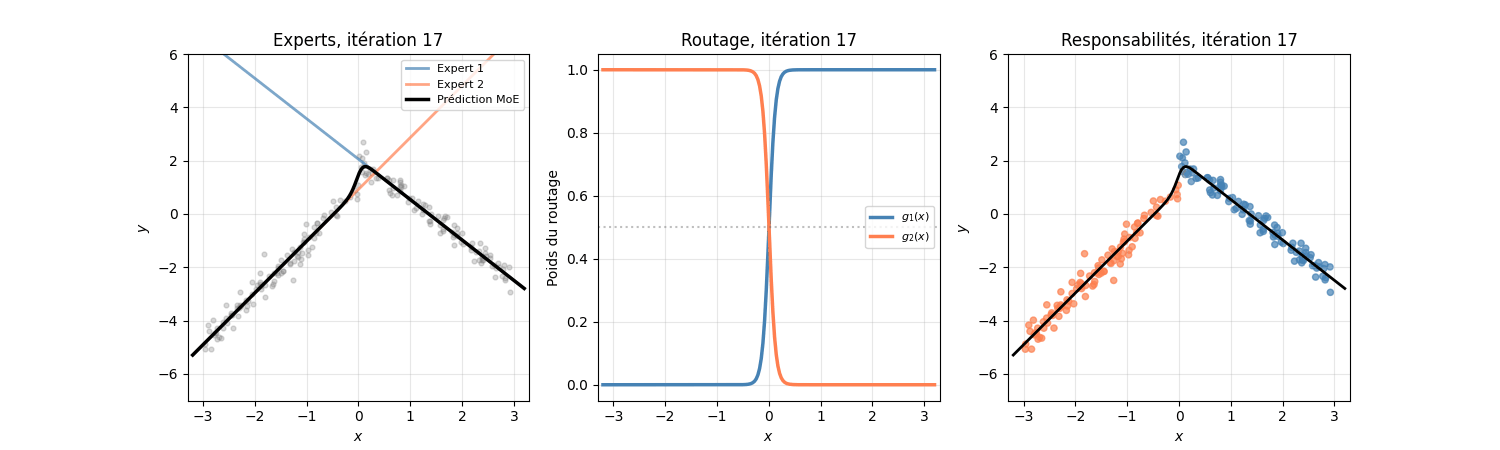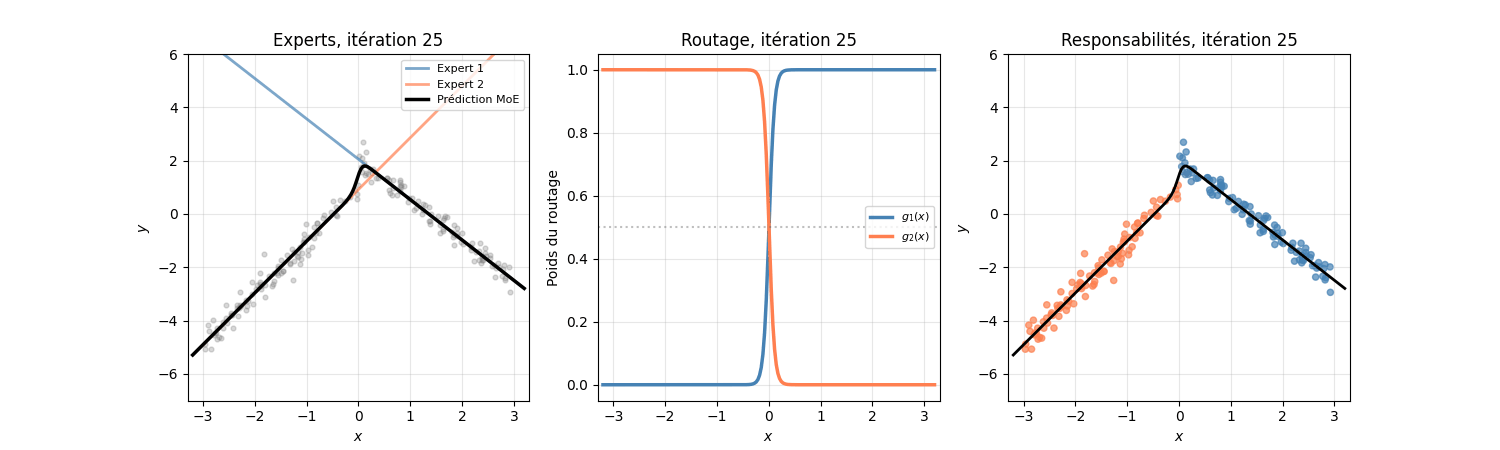
Au départ, les deux experts ont des pentes proches et le routage est presque plat à : le modèle ne distingue pas les deux régimes. Itération après itération, un expert adopte la pente positive (régime ) et l’autre la pente négative (régime ), pendant que le réseau de routage apprend une transition sigmoïdale autour de . La couleur des points passe progressivement de gris mélangé à bleu franc ou orange franc, reflétant la spécialisation croissante.
Pourquoi le routage dépendant de l’entrée est nécessaire
La différence entre un GMM et un MoE tient à un seul changement: les poids du mélange. Dans un GMM, les poids sont des constantes. Dans un MoE, les poids dépendent de l’entrée. Ce changement a des conséquences profondes.
Avec des poids constants, le modèle ne peut pas aiguiller une entrée vers un expert plutôt qu’un autre. Chaque expert contribue toujours dans les mêmes proportions, quel que soit . Pour des données de régression par morceaux comme celles de notre exemple, cela empêche la spécialisation: les deux experts tentent de s’ajuster à l’ensemble des données, au lieu de se partager le travail.
Source
# Comparaison: MoE (routage adaptatif) vs poids fixes
# Simulation d'un "GMM-régression" avec poids constants
def moe_fixed_weights(X, y, K=2, n_iter=40, seed=42):
    """MoE avec poids constants pi_k (pas de routage)."""
    N, D = X.shape
    rng = np.random.RandomState(seed)
    pi = np.ones(K) / K
    w_list = [np.linalg.lstsq(X, y, rcond=None)[0] + rng.randn(D) * 0.3 for _ in range(K)]
    sig2 = np.ones(K) * 0.5

    for _ in range(n_iter):
        weighted = np.zeros((N, K))
        for k in range(K):
            mu_k = X @ w_list[k]
            weighted[:, k] = pi[k] * np.exp(-0.5 * (y - mu_k)**2 / sig2[k]) / np.sqrt(2 * np.pi * sig2[k])
        r = weighted / (weighted.sum(axis=1, keepdims=True) + 1e-300)
        for k in range(K):
            rk = r[:, k]
            Xr = np.sqrt(rk)[:, None] * X
            yr = np.sqrt(rk) * y
            w_list[k] = np.linalg.lstsq(Xr, yr, rcond=None)[0]
            pred_k = X @ w_list[k]
            sig2[k] = np.sum(rk * (y - pred_k)**2) / (rk.sum() + 1e-10) + 1e-6
        pi = r.mean(axis=0)

    return w_list, sig2, pi, r

w_fixed, sig_fixed, pi_fixed, r_fixed = moe_fixed_weights(X_moe, y_moe, K=2)

mu_fixed = np.column_stack([X_g @ w_fixed[k] for k in range(2)])
y_pred_fixed = sum(pi_fixed[k] * X_g @ w_fixed[k] for k in range(2))

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))

ax = axes[0]
ax.scatter(x_moe, y_moe, c='gray', alpha=0.4, s=15)
ax.plot(x_g, mu_fixed[:, 0], color='steelblue', linewidth=2, alpha=0.7, label='Expert 1')
ax.plot(x_g, mu_fixed[:, 1], color='coral', linewidth=2, alpha=0.7, label='Expert 2')
ax.plot(x_g, y_pred_fixed, 'k-', linewidth=2.5, label='Prédiction')
ax.set_xlabel('$x$')
ax.set_ylabel('$y$')
ax.set_title('Poids constants $\\pi_k$ (pas de routage)')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)

ax = axes[1]
ax.scatter(x_moe, y_moe, c='gray', alpha=0.4, s=15)
ax.plot(x_g, mu_experts[:, 0], color='steelblue', linewidth=2, alpha=0.7, label='Expert 1')
ax.plot(x_g, mu_experts[:, 1], color='coral', linewidth=2, alpha=0.7, label='Expert 2')
ax.plot(x_g, y_pred_moe, 'k-', linewidth=2.5, label='Prédiction MoE')
ax.set_xlabel('$x$')
ax.set_ylabel('$y$')
ax.set_title('Routage $g_k(\\mathbf{x})$ dépendant de l\'entrée')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)

plt.tight_layout()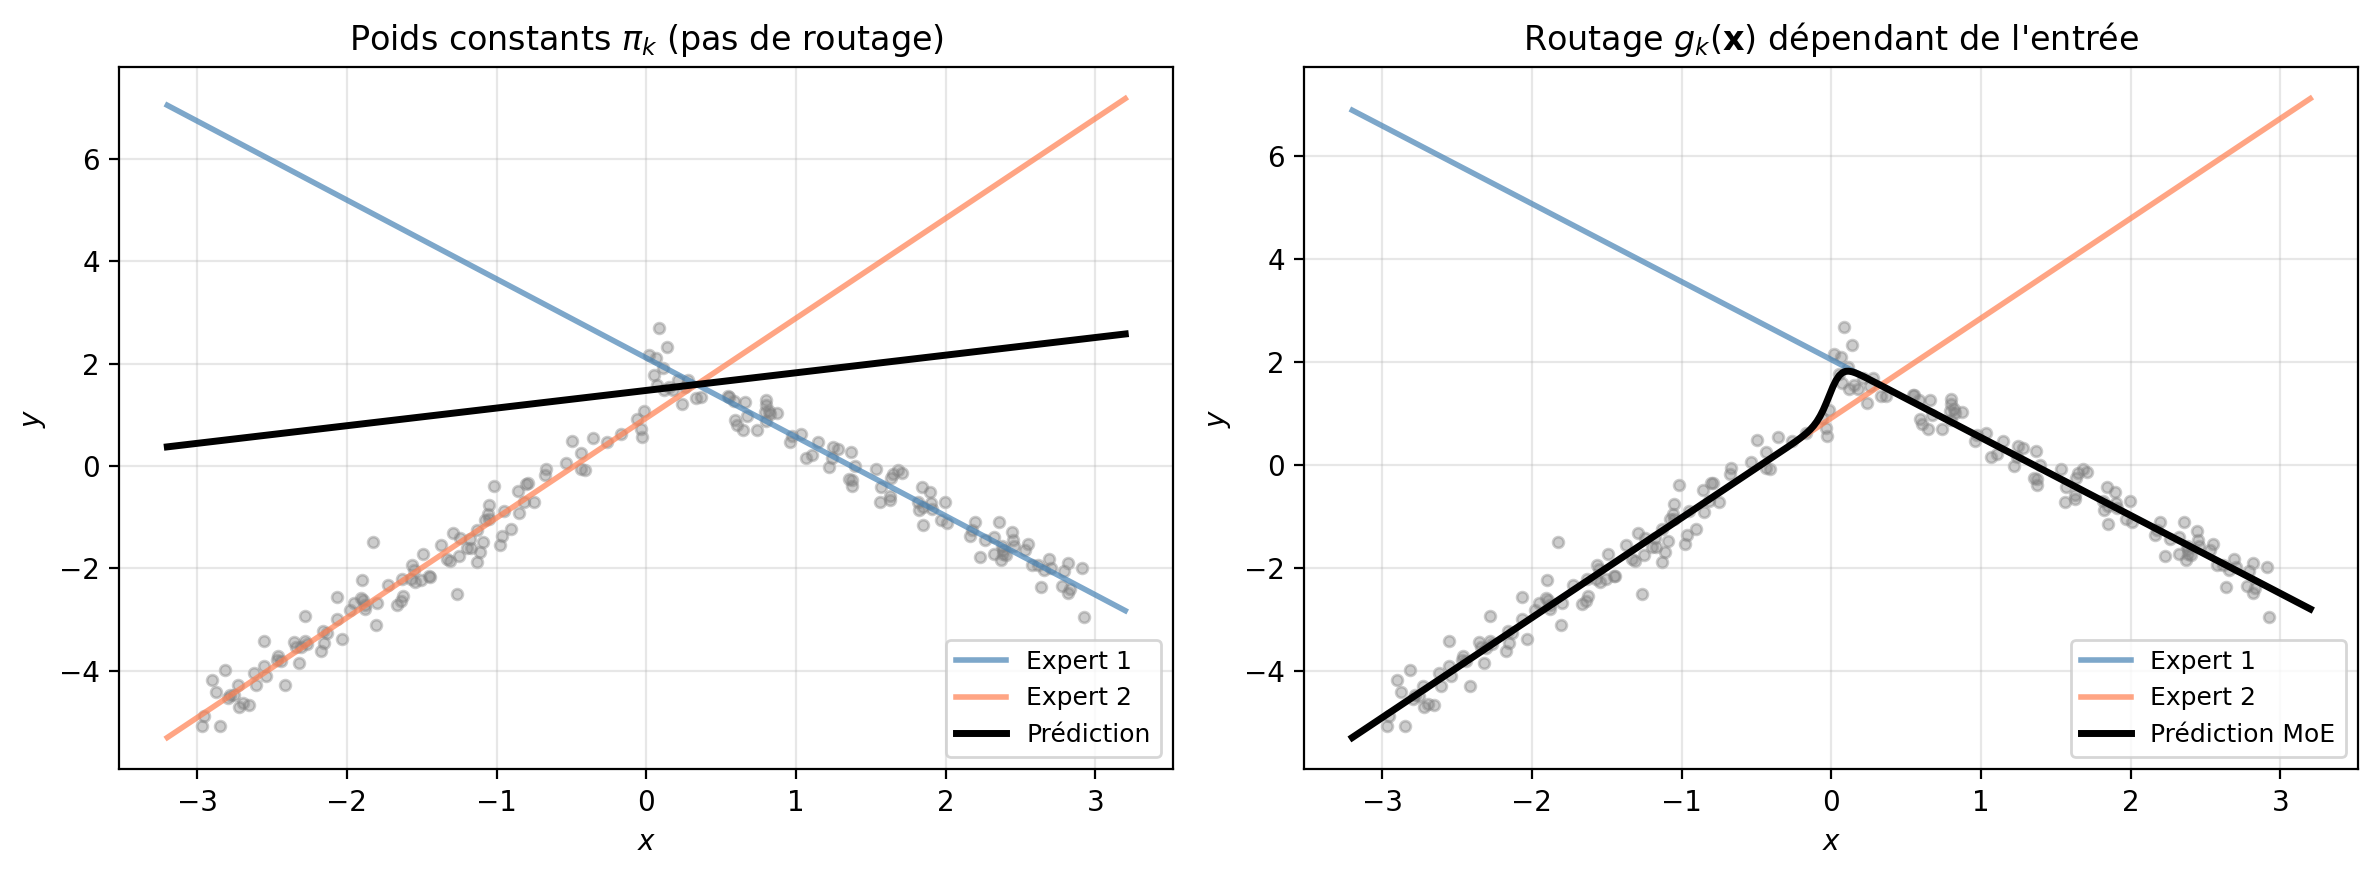
La comparaison est parlante. Avec des poids constants (à gauche), les experts peinent à se spécialiser: chacun tente de couvrir l’ensemble des données, et la prédiction globale reste un compromis insatisfaisant. Avec un routage dépendant de l’entrée (à droite), chaque expert se concentre sur la région où il excelle, et la prédiction suit la structure par morceaux des données.
Le mélange d’experts illustre comment la machinerie EM (responsabilités, moyennes pondérées, alternance E/M) s’adapte au cadre supervisé. Ces notions ne sont pas qu’un exercice de cours: elles réapparaissent en apprentissage profond et dans les grands modèles de langage (LLM). Dans ces contextes, une «couche MoE» désigne un ensemble d’experts (souvent des sous-réseaux) et un routage qui aiguille chaque entrée vers un petit nombre d’experts actifs; le but reste le même, soit spécialiser des composants et n’utiliser que ceux qui conviennent à l’entrée. Nous n’entrerons pas ici dans les détails des architectures (transformers, etc.), que nous aborderons plus tard, mais retenir l’idée (routage dépendant de l’entrée, experts locaux, combinaison pondérée) facilitera la lecture lorsque vous rencontrerez des modèles comme Mixtral ou des discussions sur le sparse MoE.
Résumé
Ce chapitre a présenté les modèles génératifs pour la classification et le partitionnement, puis montré comment l’algorithme EM s’étend au cadre supervisé.
L’approche générative modélise comment les données sont produites: une classe est d’abord tirée selon un a priori, puis une observation est générée selon la distribution de cette classe. Le théorème de Bayes permet ensuite de calculer la probabilité a posteriori des classes.
Le classifieur naïf bayésien simplifie ce cadre en supposant que les caractéristiques sont conditionnellement indépendantes étant donné la classe. Cette hypothèse, rarement vraie en pratique, permet néanmoins une estimation efficace (formules fermées) et donne souvent de bons résultats en classification. Le lissage de Laplace évite les probabilités nulles et correspond à un estimateur MAP avec a priori uniforme.
L’analyse discriminante gaussienne suppose que chaque classe suit une distribution gaussienne. LDA (covariance partagée) donne des frontières linéaires, QDA (covariances différentes) des frontières quadratiques.
K-moyennes partitionne les données en groupes sphériques en alternant assignation et mise à jour des centroïdes. Les modèles de mélange gaussien généralisent cette approche en remplaçant les assignations dures par des responsabilités souples et les sphères par des ellipsoïdes. L’algorithme EM estime les paramètres en alternant le calcul des responsabilités (étape E) et la mise à jour des paramètres par des moyennes pondérées (étape M). EM maximise en fait une borne inférieure de la log-vraisemblance (l’ELBO); vue comme inférence variationnelle, EM correspond au cas où la distribution approchée sur les latentes est choisie égale à l’a posteriori exact à chaque itération.
Le mélange d’experts transpose cette logique au cadre supervisé: les experts se spécialisent dans différentes régions de l’espace d’entrée, et un réseau de routage apprend à aiguiller chaque observation vers l’expert approprié. L’algorithme EM s’y applique avec le même schéma d’alternance.
Exercices
Exercice 1: Naive Bayes sur des données binaires ★
Un classifieur naïf bayésien est entraîné pour détecter les pourriels. Les données d’entraînement comprennent deux caractéristiques binaires: la présence du mot «gratuit» () et la présence du mot «urgent» ().
Données:
Pourriels (10 courriels): 8 contiennent «gratuit», 6 contiennent «urgent»
Légitimes (20 courriels): 2 contiennent «gratuit», 4 contiennent «urgent»
Calculez les estimateurs EMV de tous les paramètres du modèle.
Classifiez un courriel contenant «gratuit» mais pas «urgent».
Appliquez le lissage de Laplace () et recalculez la classification.
Solution Exercice 1
Estimateurs EMV:
A priori de classe:
Probabilités conditionnelles (sans lissage):
Classification sans lissage:
Pour (gratuit présent, urgent absent):
Puisque , le courriel est classé comme pourriel.
Avec lissage de Laplace:
Recalcul:
La classification reste pourriel.
Exercice 2: Distance de Mahalanobis ★
Soit une classe avec et .
Calculez la distance de Mahalanobis du point à .
Calculez la distance de Mahalanobis du point à .
Ces points ont la même distance euclidienne à l’origine. Pourquoi leurs distances de Mahalanobis diffèrent-elles?
Dessinez l’ellipse des points à distance de Mahalanobis 1 de l’origine.
Solution Exercice 2
La distance de Mahalanobis est .
Avec :
Point :
Donc .
Point :
Donc .
Interprétation: Les deux points sont à distance euclidienne 2 de l’origine. Mais la distribution a une grande variance (4) dans la direction et une petite variance (1) dans la direction . Un écart de 2 dans la direction correspond à 1 écart-type, tandis qu’un écart de 2 dans la direction correspond à 2 écarts-types. La distance de Mahalanobis mesure les écarts en «unités d’écart-type» dans chaque direction.
Ellipse: Les points à distance de Mahalanobis 1 satisfont:
C’est une ellipse avec demi-grand axe 2 (direction ) et demi-petit axe 1 (direction ).
Exercice 3: LDA vs régression logistique ★★
Considérez deux classes en 1D:
Classe 0: moyenne , 50 exemples
Classe 1: moyenne , 50 exemples
Covariance partagée:
A priori égaux:
Écrivez la fonction discriminante LDA pour chaque classe.
Trouvez le seuil de décision (la valeur où les deux classes sont équiprobables).
Pour la régression logistique avec , montrez que le seuil de décision est .
Dans quelles situations LDA sera-t-il meilleur que la régression logistique? Et vice versa?
Solution Exercice 3
Fonctions discriminantes LDA:
Pour LDA avec covariance partagée :
Avec nos paramètres:
Seuil de décision:
On cherche tel que :
Le seuil est au milieu entre les deux moyennes (car les a priori sont égaux).
Régression logistique:
quand , donc , d’où .
Comparaison:
LDA meilleur:
Quand les données suivent effectivement une distribution gaussienne
Avec peu de données (les hypothèses fortes aident)
Quand les classes ont des covariances similaires
Régression logistique meilleure:
Quand les distributions ne sont pas gaussiennes
Avec beaucoup de données (les hypothèses deviennent moins nécessaires)
Quand on veut des probabilités bien calibrées
Pour des données non continues (ex: caractéristiques catégorielles)
Exercice 4: Responsabilités GMM ★★
Un GMM à 2 composants en 1D a les paramètres:
, ,
, ,
Pour l’observation , calculez les responsabilités et .
Pour l’observation , calculez les responsabilités.
Trouvez la valeur où .
Pourquoi n’est-il pas au milieu entre et ?
Solution Exercice 4
La densité gaussienne 1D est .
Avec : .
Pour :
Pour :
Au point équidistant des moyennes, les densités sont égales, donc les responsabilités sont proportionnelles aux poids .
Point où :
On cherche tel que :
En prenant le logarithme:
Interprétation: Le point est plus proche de que du milieu () car le composant 2 a un poids plus élevé (). Pour que les responsabilités soient égales, il faut que le point soit plus proche du composant de plus faible poids.
Exercice 5: Étape M de l’algorithme EM ★★
Soit un GMM à 2 composants en 1D avec les données et les responsabilités suivantes après l’étape E:
| 1 | 0,9 | 0,1 |
| 2 | 0,8 | 0,2 |
| 4 | 0,2 | 0,8 |
| 5 | 0,1 | 0,9 |
Calculez et (les «nombres effectifs» de points par composant).
Calculez les nouvelles moyennes et .
Calculez les nouvelles variances et .
Calculez les nouveaux poids et .
Solution Exercice 5
Exercice 6: Convergence de k-moyennes et EM ★★★
Expliquez pourquoi k-moyennes converge toujours vers un minimum local de la distorsion.
Montrez que k-moyennes est un cas particulier de l’algorithme EM pour un GMM avec:
Covariances sphériques identiques:
Dans la limite , que deviennent les responsabilités?
Pourquoi EM peut-il être préférable à k-moyennes même quand on ne veut qu’un partitionnement dur?
Solution Exercice 6
Convergence de k-moyennes:
K-moyennes minimise la distorsion où .
Étape d’assignation: Pour fixé, assigner chaque point au centroïde le plus proche minimise (car on choisit le terme avec la plus petite distance).
Étape de mise à jour: Pour fixé, la moyenne minimise la somme des distances carrées (c’est un résultat classique de statistique).
Chaque étape réduit ou maintient . Comme et le nombre d’assignations possibles est fini, l’algorithme converge.
K-moyennes comme GMM limite:
Avec , la densité gaussienne est:
Les responsabilités sont:
Limite :
Quand , l’exponentielle avec la plus petite distance domine:
Les responsabilités deviennent binaires: c’est l’assignation de k-moyennes.
Avantages de EM sur k-moyennes:
Détection des cas ambigus: Les responsabilités souples identifient les points mal assignés
Formes des groupes: GMM capture des ellipses, k-moyennes ne fait que des sphères
Initialisation plus robuste: EM est moins sensible à l’initialisation grâce au ramollissement
Critère de sélection de modèle: La vraisemblance permet de comparer différents
Incertitude quantifiée: Utile pour l’analyse en aval
Exercice 7: Générer des données avec un modèle génératif ★★★
Vous avez entraîné un GMM à 3 composants sur des données 2D et obtenu les paramètres suivants:
| 1 | 0,2 | ||
| 2 | 0,5 | ||
| 3 | 0,3 |
Décrivez l’algorithme pour générer nouveaux échantillons à partir de ce modèle.
Implémentez cet algorithme en Python (sans utiliser
sklearn.mixture).Générez 500 points et visualisez-les. Les groupes sont-ils visibles?
Calculez la log-vraisemblance moyenne de vos données générées. Est-ce cohérent?
Solution Exercice 7
Algorithme de génération:
Pour générer un échantillon:
Tirer un composant
Tirer
Répéter fois.
Implémentation Python:
import numpy as np

# Paramètres
pis = [0.2, 0.5, 0.3]
mus = [np.array([0, 0]), np.array([3, 3]), np.array([0, 4])]
sigmas = [np.eye(2), 2*np.eye(2), np.array([[1, 0.5], [0.5, 1]])]

def generate_gmm_samples(n_samples, pis, mus, sigmas):
    K = len(pis)
    samples = []
    labels = []

    for _ in range(n_samples):
        # Étape 1: tirer un composant
        k = np.random.choice(K, p=pis)
        labels.append(k)

        # Étape 2: tirer de la gaussienne correspondante
        x = np.random.multivariate_normal(mus[k], sigmas[k])
        samples.append(x)

    return np.array(samples), np.array(labels)

X, z = generate_gmm_samples(500, pis, mus, sigmas)
Visualisation: Les trois groupes devraient être visibles, avec le groupe 2 plus étalé (variance 2) et le groupe 3 légèrement allongé (corrélation positive).
Log-vraisemblance: Elle devrait être proche de celle des données d’entraînement originales, car les échantillons viennent de la même distribution. Une valeur typique serait autour de -3 à -4 par point (dépend de la normalisation).