Le chapitre précédent a posé le problème d’apprentissage supervisé comme un problème d’optimisation: minimiser le risque empirique sur une classe de fonctions. Ce chapitre applique ce cadre au cas le plus simple et le plus fondamental: la régression linéaire. Nous verrons comment résoudre analytiquement ce problème, comment interpréter la solution géométriquement, et comment la régularisation permet de contrôler la complexité du modèle.
Source
import numpy as np
import matplotlib.pyplot as plt

# Configuration pour des figures haute résolution
%config InlineBackend.figure_format = 'retina'
Les moindres carrés ordinaires
Rappelons le problème. Un modèle linéaire suppose que la sortie est une combinaison linéaire des entrées:
où est le vecteur d’entrée augmenté d’un 1 pour le biais (), et est le vecteur de paramètres.
Avec la perte quadratique, l’objectif est de minimiser la somme des carrés des résidus (RSS, ou SCR en français):
où est la matrice des entrées (avec une colonne de 1 pour le biais) et est le vecteur des sorties.
Dérivation de la solution analytique
En développant et en calculant le gradient:
En posant le gradient égal à zéro, nous obtenons les équations normales:
Si la matrice est inversible, la solution unique est:
Cette solution porte le nom d’estimateur des moindres carrés ordinaires (MCO, ou ordinary least squares, OLS). Elle peut être calculée directement sans itération, ce qui en fait un exemple classique de solution analytique.
Interprétation probabiliste: MCO = EMV sous bruit gaussien
Pourquoi minimiser la somme des carrés? Le chapitre 1 a introduit le maximum de vraisemblance comme principe pour choisir les paramètres. Appliquons-le à la régression.
Supposons que les observations suivent le modèle:
Le bruit est gaussien, de moyenne nulle et de variance constante. Ce modèle implique que, pour chaque observation:
Sous l’hypothèse i.i.d., la log-vraisemblance négative est:
Le premier terme est une constante (ne dépend pas de ). Minimiser la LVN revient donc à minimiser:
Nous retrouvons exactement la somme des carrés des résidus. Ainsi, les moindres carrés ordinaires sont l’estimateur du maximum de vraisemblance sous l’hypothèse de bruit gaussien. Ce n’est pas un choix arbitraire: c’est la solution optimale si nous croyons que le bruit suit une distribution normale.
Généralisation et surapprentissage
La différence entre le risque et le risque empirique est l’écart de généralisation:
Un modèle qui minimise le risque empirique peut avoir un risque élevé si cet écart est grand. Ce phénomène est le surapprentissage: le modèle s’ajuste aux particularités de l’échantillon d’entraînement, y compris le bruit, plutôt qu’aux régularités sous-jacentes. L’erreur d’entraînement est faible, mais l’erreur sur de nouvelles données est élevée.
À l’inverse, un modèle trop simple peut avoir un risque empirique et un risque tous deux élevés. C’est le sous-apprentissage: le modèle n’a pas la capacité de capturer la structure des données.
Extrapolation
Un cas particulier de mauvaise généralisation est l’extrapolation: prédire pour des entrées en dehors de la plage des données d’entraînement. Même un modèle bien ajusté peut échouer spectaculairement lorsqu’on lui demande de prédire au-delà de ce qu’il a vu.
Considérons des essais en soufflerie pour mesurer la portance d’une aile à différentes vitesses. Les tests sont effectués entre 20 et 60 m/s. L’ingénieur veut prédire la portance à 100 m/s.
Source
import numpy as np
import matplotlib.pyplot as plt

# Données de portance aérodynamique (simulées)
np.random.seed(42)
rho, S, C_L = 1.225, 20.0, 0.5
v_train = np.linspace(20, 60, 8)
L_true_train = 0.5 * rho * v_train**2 * S * C_L
L_train = L_true_train + np.random.normal(0, 400, len(v_train))

coeffs_2 = np.polyfit(v_train, L_train, 2)
coeffs_5 = np.polyfit(v_train, L_train, 5)

v_extrap = np.linspace(15, 110, 200)
L_true_extrap = 0.5 * rho * v_extrap**2 * S * C_L

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

for ax, coeffs, deg in zip(axes, [coeffs_2, coeffs_5], [2, 5]):
    ax.scatter(v_train, L_train, s=50, zorder=5, label='Observations')
    ax.plot(v_extrap, L_true_extrap, 'g-', alpha=0.5, label='Vraie relation')
    L_pred = np.polyval(coeffs, v_extrap)
    ax.plot(v_extrap, L_pred, 'k--', label=f'Polynôme degré {deg}')
    ax.axvline(60, color='gray', linestyle=':', alpha=0.5)
    ax.axvspan(60, 110, alpha=0.1, color='red')
    ax.set_xlabel('Vitesse (m/s)')
    ax.set_ylabel('Portance (N)')
    ax.set_title(f'Degré {deg}')
    ax.legend(loc='upper left')
    ax.set_ylim(-5000, 80000)
    ax.text(85, 5000, 'Extrapolation', ha='center', fontsize=10, color='red', alpha=0.7)

plt.tight_layout()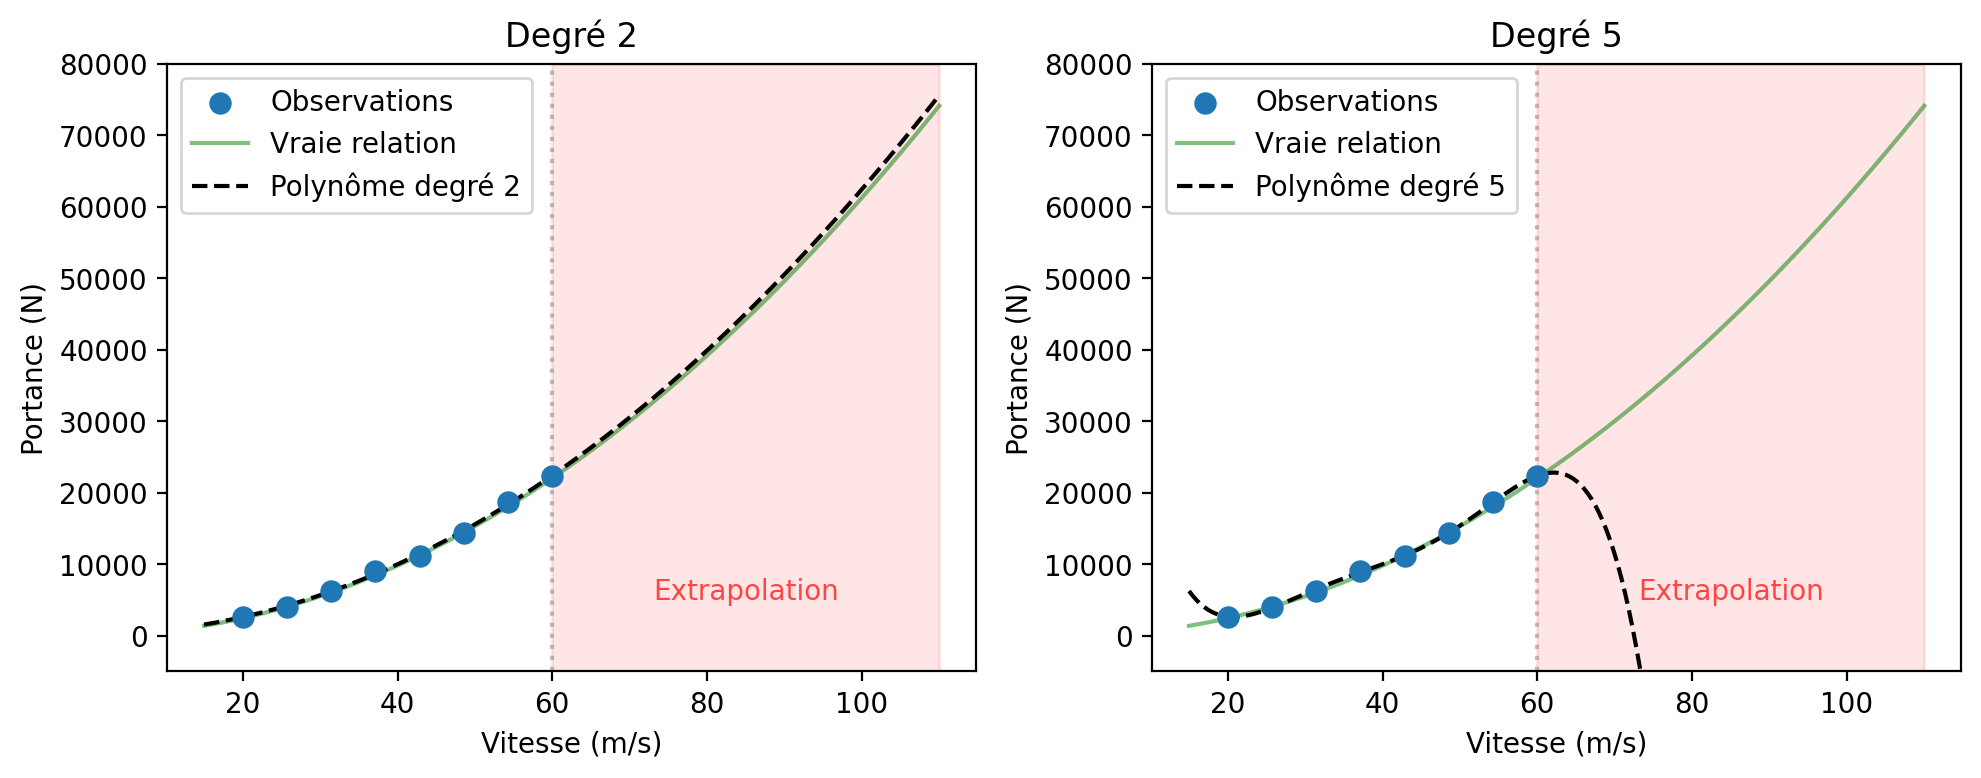
Le polynôme de degré 2 (qui correspond au vrai modèle physique ) extrapole correctement. Le polynôme de degré 5, bien qu’il ajuste aussi bien les données d’entraînement, diverge complètement en dehors de la plage observée.
Application: Résistance du béton
Appliquons les moindres carrés ordinaires à un problème concret d’ingénierie civile: prédire la résistance à la compression du béton à partir de sa composition. Ce jeu de données classique contient 1030 échantillons de béton avec 8 caractéristiques mesurées en kg/m³ (sauf l’âge en jours):
Ciment: le liant principal
Laitier de haut fourneau (blast furnace slag): sous-produit de l’industrie sidérurgique
Cendres volantes (fly ash): résidu de combustion du charbon
Eau: pour l’hydratation du ciment
Superplastifiant: additif pour améliorer la fluidité
Granulat grossier et fin: le squelette du béton
Âge: temps de cure en jours
La cible est la résistance à la compression en MPa (mégapascals).
Source
import numpy as np
import matplotlib.pyplot as plt
from ucimlrepo import fetch_ucirepo

# Charger les données
concrete = fetch_ucirepo(id=165)
X_df = concrete.data.features
y = concrete.data.targets.values.ravel()

# Noms des caractéristiques en français
feature_names = ['Ciment', 'Laitier', 'Cendres', 'Eau', 'Plastifiant',
                 'Granulat gros', 'Granulat fin', 'Âge']
X = X_df.values

# Ajouter colonne de 1 pour le biais
X_bias = np.column_stack([np.ones(len(X)), X])

# Solution MCO
theta_ols = np.linalg.lstsq(X_bias, y, rcond=None)[0]

# Afficher les coefficients
fig, ax = plt.subplots(figsize=(10, 5))
colors = ['tab:green' if c > 0 else 'tab:red' for c in theta_ols[1:]]
bars = ax.barh(feature_names, theta_ols[1:], color=colors, alpha=0.7)
ax.axvline(0, color='black', linewidth=0.5)
ax.set_xlabel('Coefficient MCO (MPa par kg/m³)')
ax.set_title('Influence de chaque composant sur la résistance du béton')

# Annoter les valeurs
for bar, val in zip(bars, theta_ols[1:]):
    x_pos = val + 0.002 if val > 0 else val - 0.002
    ha = 'left' if val > 0 else 'right'
    ax.text(x_pos, bar.get_y() + bar.get_height()/2, f'{val:.3f}',
            va='center', ha=ha, fontsize=9)

plt.tight_layout()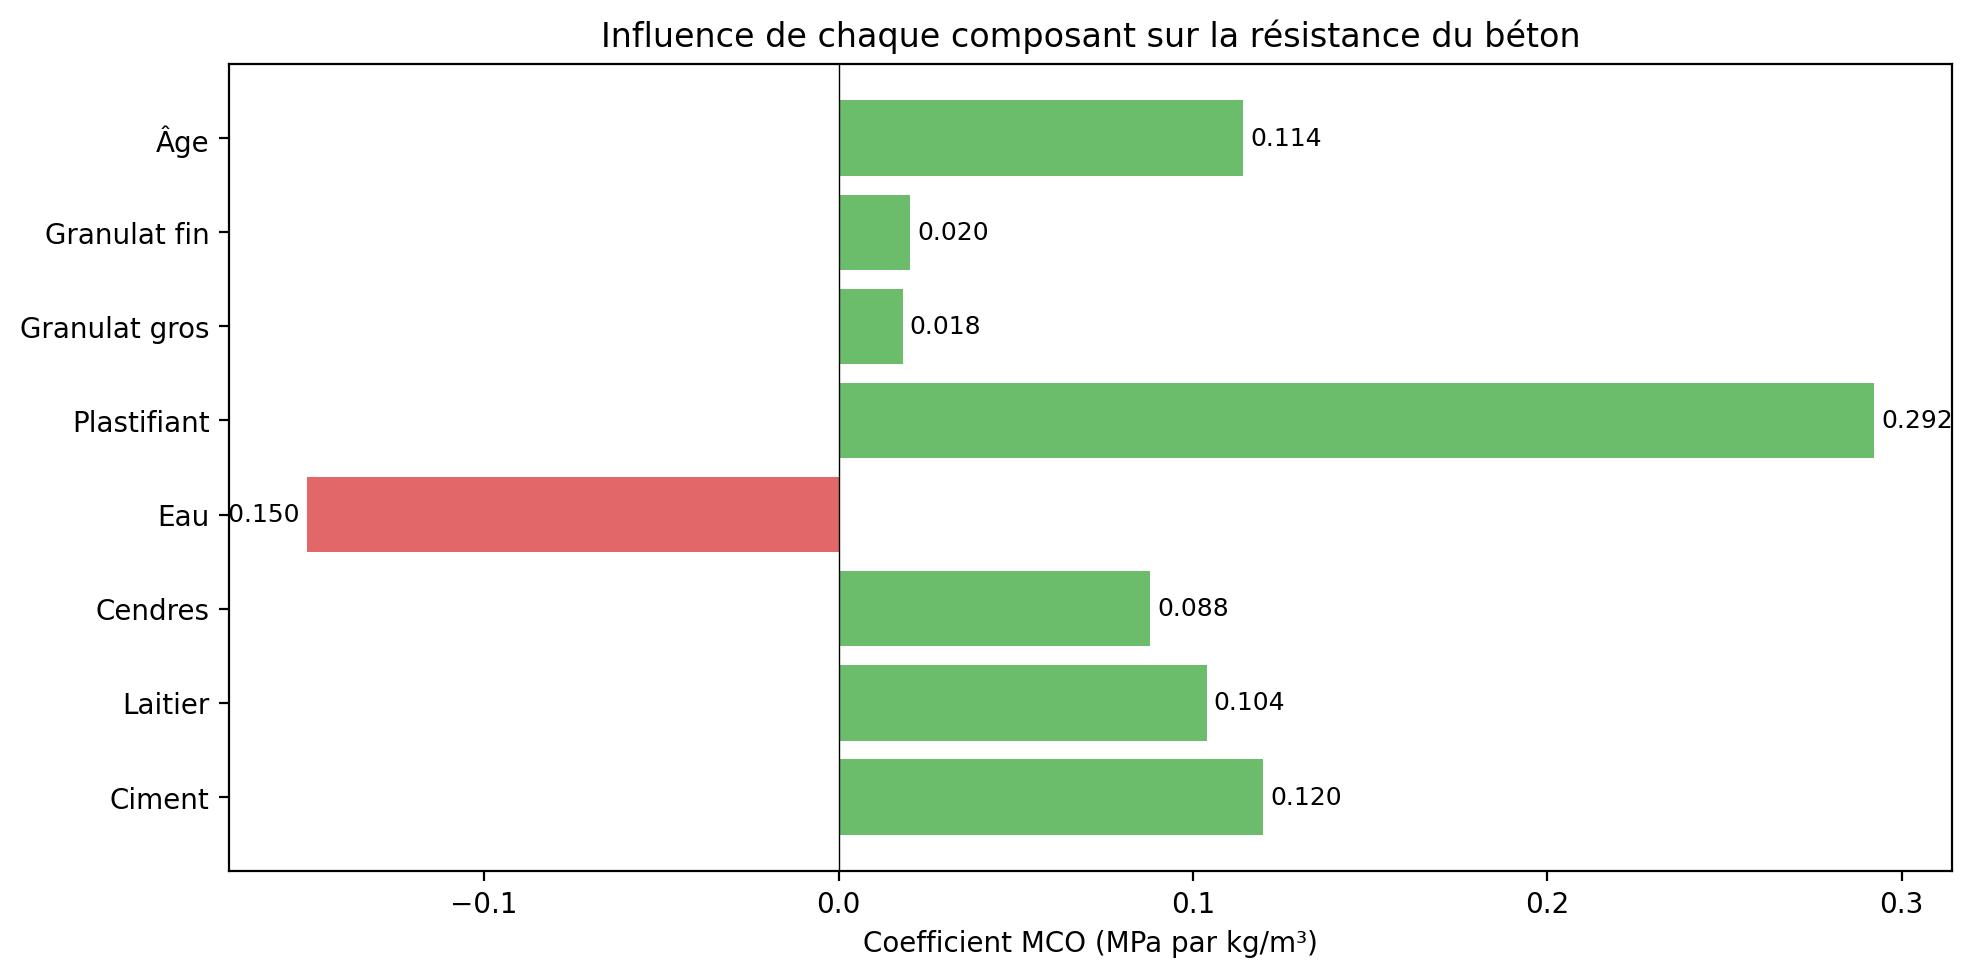
Les coefficients révèlent la physique du matériau:
Ciment (): effet positif attendu — plus de ciment augmente la résistance
Eau (): effet négatif — l’excès d’eau crée des pores et affaiblit le béton
Âge (): le béton durcit avec le temps (réaction d’hydratation)
Laitier et cendres (): ces substituts au ciment contribuent aussi à la résistance
Ingénierie des caractéristiques: le ratio eau/ciment
Le ratio eau/ciment () est fondamental en technologie du béton. Créons cette caractéristique et comparons les modèles:
Source
import numpy as np
import matplotlib.pyplot as plt

# Extraire les colonnes
cement = X_df['Cement'].values
water = X_df['Water'].values

# Créer le ratio eau/ciment (éviter division par zéro)
wc_ratio = water / np.maximum(cement, 1e-6)

# Modèle 1: Toutes les caractéristiques originales
X1 = np.column_stack([np.ones(len(X)), X])
theta1 = np.linalg.lstsq(X1, y, rcond=None)[0]
y_pred1 = X1 @ theta1
mse1 = np.mean((y - y_pred1)**2)

# Modèle 2: Avec ratio eau/ciment ajouté
X2 = np.column_stack([np.ones(len(X)), X, wc_ratio])
theta2 = np.linalg.lstsq(X2, y, rcond=None)[0]
y_pred2 = X2 @ theta2
mse2 = np.mean((y - y_pred2)**2)

# Modèle 3: Seulement ratio eau/ciment et âge
age = X_df['Age'].values
X3 = np.column_stack([np.ones(len(X)), wc_ratio, age])
theta3 = np.linalg.lstsq(X3, y, rcond=None)[0]
y_pred3 = X3 @ theta3
mse3 = np.mean((y - y_pred3)**2)

fig, axes = plt.subplots(1, 3, figsize=(12, 4))

for ax, y_pred, mse, title in zip(axes,
                                   [y_pred1, y_pred2, y_pred3],
                                   [mse1, mse2, mse3],
                                   ['8 caractéristiques', '+ ratio w/c', 'w/c + âge seulement']):
    ax.scatter(y, y_pred, alpha=0.3, s=10)
    ax.plot([0, 80], [0, 80], 'k--', alpha=0.5)
    ax.set_xlabel('Résistance réelle (MPa)')
    ax.set_ylabel('Résistance prédite (MPa)')
    ax.set_title(f'{title}\nEQM = {mse:.1f}')
    ax.set_xlim(0, 85)
    ax.set_ylim(0, 85)
    ax.set_aspect('equal')

plt.tight_layout()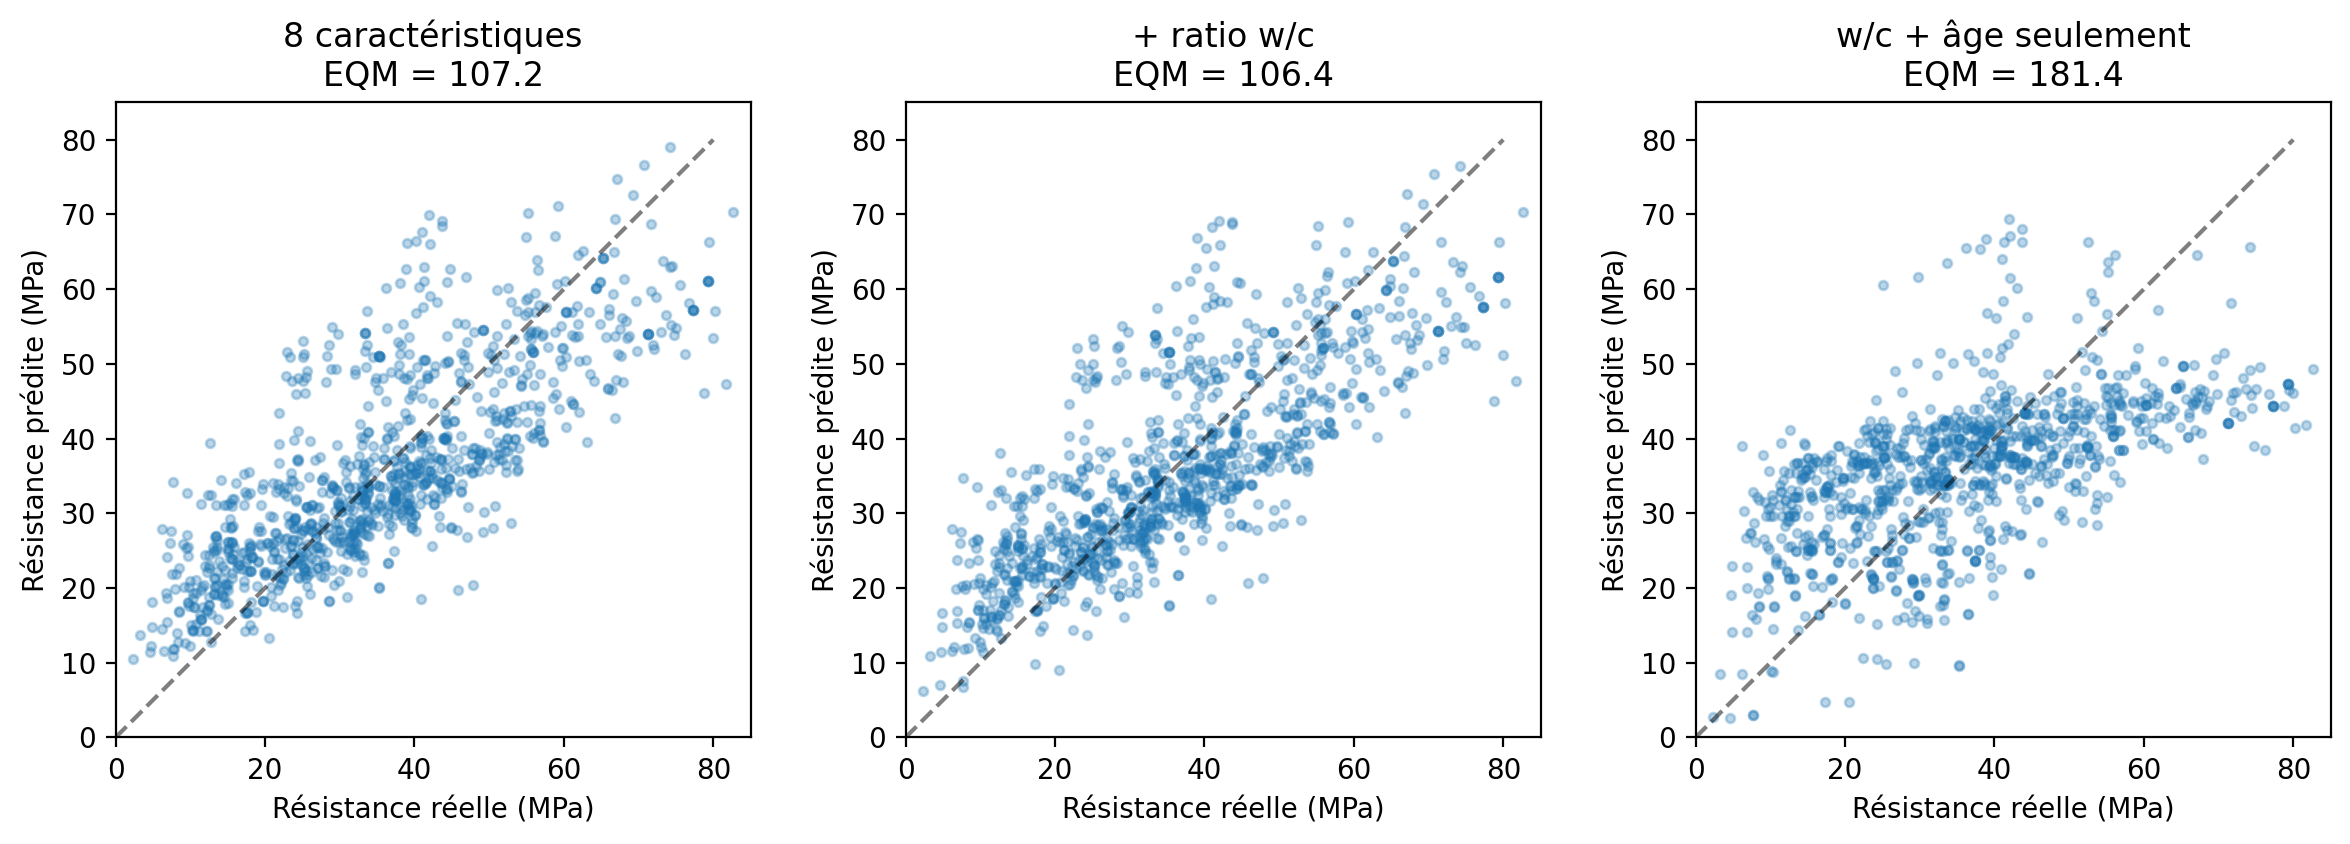
Le ratio seul avec l’âge capture une grande partie de la variance, confirmant son importance en pratique. Cependant, le modèle complet reste meilleur, suggérant que les autres composants (plastifiant, granulats) apportent de l’information supplémentaire.
Limites du modèle linéaire: l’effet de l’âge
La résistance du béton ne croît pas linéairement avec l’âge — elle suit plutôt une loi en ou logarithmique. Visualisons cette non-linéarité:
Source
import numpy as np
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

# Panneau gauche: résidus vs âge
residuals = y - y_pred1
ax = axes[0]
ax.scatter(X_df['Age'].values, residuals, alpha=0.3, s=10)
ax.axhline(0, color='black', linewidth=0.5)
ax.set_xlabel('Âge (jours)')
ax.set_ylabel('Résidu (MPa)')
ax.set_title('Résidus vs Âge: pattern non-linéaire')

# Ajouter une courbe de tendance (moyenne mobile)
ages_sorted = np.sort(np.unique(X_df['Age'].values))
mean_residuals = [residuals[X_df['Age'].values == a].mean() for a in ages_sorted]
ax.plot(ages_sorted, mean_residuals, 'r-', linewidth=2, label='Moyenne')
ax.legend()

# Panneau droit: transformation sqrt(age)
age_sqrt = np.sqrt(X_df['Age'].values)
X_sqrt = np.column_stack([np.ones(len(X)), X[:, :-1], age_sqrt])  # Remplacer âge par sqrt(âge)
theta_sqrt = np.linalg.lstsq(X_sqrt, y, rcond=None)[0]
y_pred_sqrt = X_sqrt @ theta_sqrt
residuals_sqrt = y - y_pred_sqrt

ax = axes[1]
ax.scatter(X_df['Age'].values, residuals_sqrt, alpha=0.3, s=10)
ax.axhline(0, color='black', linewidth=0.5)
ax.set_xlabel('Âge (jours)')
ax.set_ylabel('Résidu (MPa)')
ax.set_title('Résidus après transformation $\\sqrt{\\text{âge}}$')

ages_sorted = np.sort(np.unique(X_df['Age'].values))
mean_residuals_sqrt = [residuals_sqrt[X_df['Age'].values == a].mean() for a in ages_sorted]
ax.plot(ages_sorted, mean_residuals_sqrt, 'r-', linewidth=2, label='Moyenne')
ax.legend()

plt.tight_layout()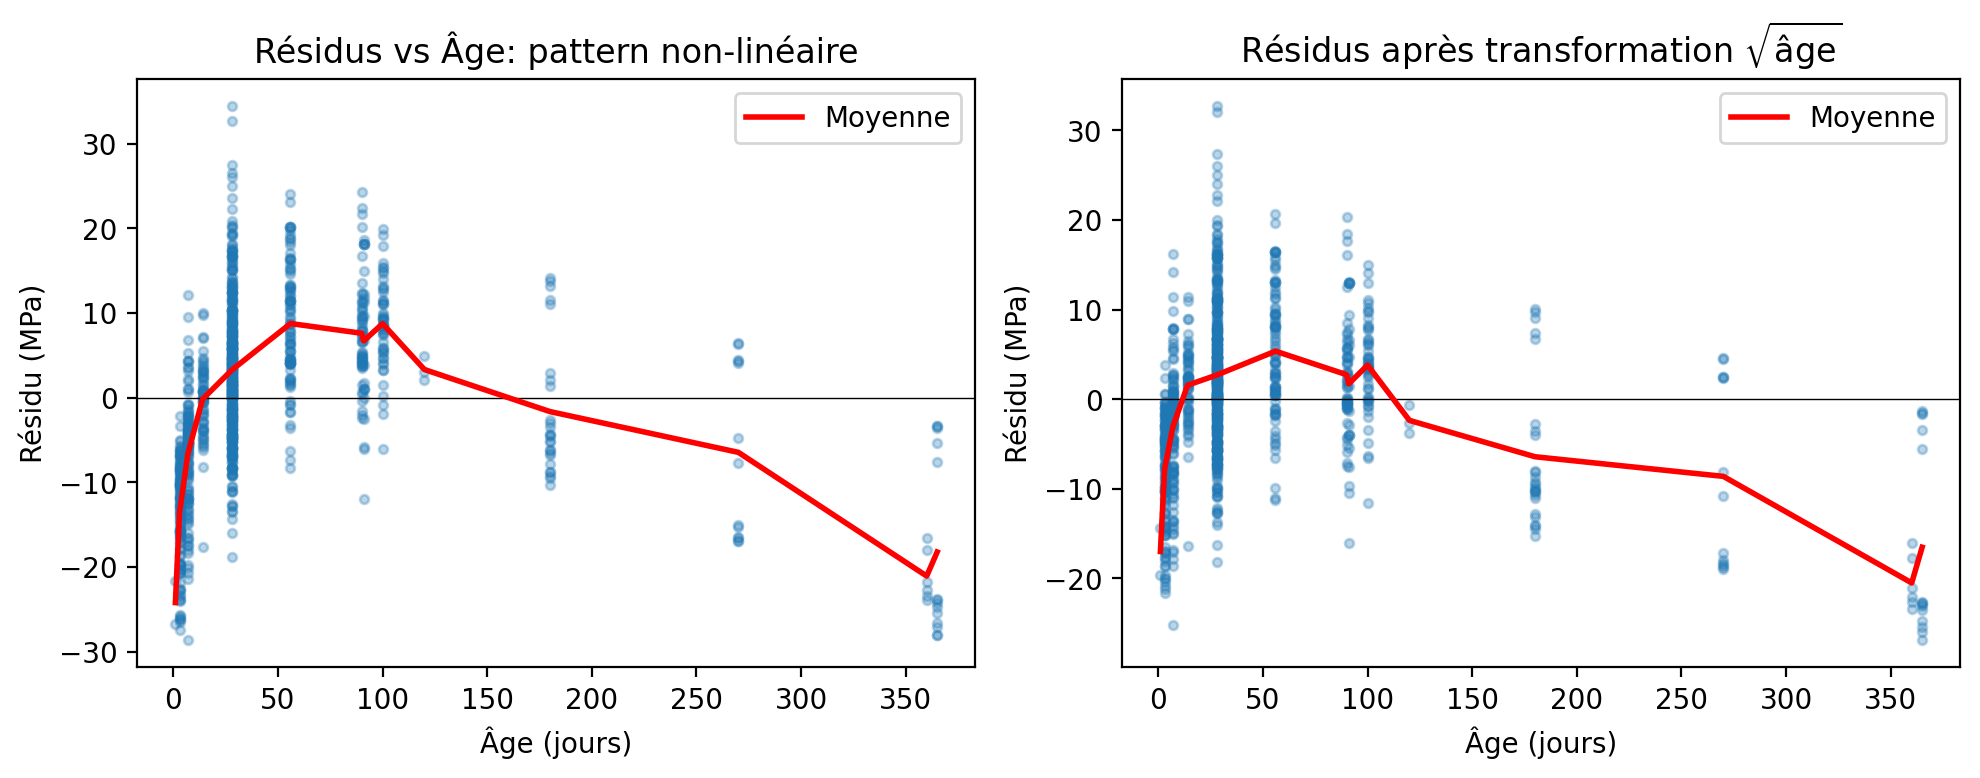
Le panneau de gauche montre un pattern caractéristique dans les résidus: le modèle sous-estime la résistance pour les âges intermédiaires. La transformation (panneau de droite) corrige partiellement ce biais, illustrant comment la connaissance du domaine guide l’ingénierie des caractéristiques.
Régularisation Ridge
Une manière de contrôler le surapprentissage consiste à pénaliser la complexité du modèle directement dans la fonction objectif. Le risque empirique régularisé est:
où mesure la complexité du modèle et contrôle l’intensité de la pénalisation. Un choix courant est la régularisation (ou weight decay):
Cette pénalisation pousse les paramètres vers zéro, ce qui a pour effet de lisser la fonction apprise. En régression linéaire, l’ajout de cette pénalité donne la régularisation Ridge:
Illustrons l’effet de la régularisation sur le même problème de régression polynomiale. Avec un polynôme de degré 15 et différentes valeurs de :
Source
import numpy as np
import matplotlib.pyplot as plt

# Données de freinage
speed = np.array([4, 4, 7, 7, 8, 9, 10, 10, 10, 11, 11, 12, 12, 12, 12, 13, 13, 13, 13, 14,
                  14, 14, 14, 15, 15, 15, 16, 16, 17, 17, 17, 18, 18, 18, 18, 19, 19, 19,
                  20, 20, 20, 20, 20, 22, 23, 24, 24, 24, 24, 25], dtype=float)
dist = np.array([2, 10, 4, 22, 16, 10, 18, 26, 34, 17, 28, 14, 20, 24, 28, 26, 34, 34, 46,
                 26, 36, 60, 80, 20, 26, 54, 32, 40, 32, 40, 50, 42, 56, 76, 84, 36, 46,
                 68, 32, 48, 52, 56, 64, 66, 54, 70, 92, 93, 120, 85], dtype=float)

# Train/test split
np.random.seed(42)
indices = np.random.permutation(len(speed))
train_idx, test_idx = indices[:35], indices[35:]
speed_train, dist_train = speed[train_idx], dist[train_idx]
speed_test, dist_test = speed[test_idx], dist[test_idx]

# Build polynomial features (degree 15)
degree = 15
def poly_features(x, deg):
    return np.vstack([x**i for i in range(deg+1)]).T

X_train = poly_features(speed_train, degree)
X_test = poly_features(speed_test, degree)

# Ridge regression for different lambda values
lambdas = [0, 1e-6, 1e-3, 1]
fig, axes = plt.subplots(2, 2, figsize=(10, 8))

for ax, lam in zip(axes.flat, lambdas):
    # Ridge solution: (X^T X + lambda I)^{-1} X^T y
    I = np.eye(X_train.shape[1])
    I[0, 0] = 0  # Don't regularize bias
    w = np.linalg.solve(X_train.T @ X_train + lam * I, X_train.T @ dist_train)

    # Predictions
    pred_train = X_train @ w
    pred_test = X_test @ w
    mse_train = np.mean((dist_train - pred_train)**2)
    mse_test = np.mean((dist_test - pred_test)**2)

    # Plot
    ax.scatter(speed_train, dist_train, alpha=0.6, s=30, label='Entraînement')
    ax.scatter(speed_test, dist_test, alpha=0.6, s=30, marker='s', label='Test')

    speed_grid = np.linspace(3, 26, 200)
    X_grid = poly_features(speed_grid, degree)
    pred_grid = X_grid @ w
    pred_grid = np.clip(pred_grid, -50, 200)
    ax.plot(speed_grid, pred_grid, 'k-', alpha=0.7)

    ax.set_xlim(3, 26)
    ax.set_ylim(-20, 150)
    ax.set_xlabel('Vitesse (mph)')
    ax.set_ylabel('Distance (ft)')
    ax.set_title(f'$\\lambda$ = {lam}: Entr. EQM={mse_train:.1f}, Test EQM={mse_test:.1f}')
    if lam == 0:
        ax.legend()

plt.tight_layout()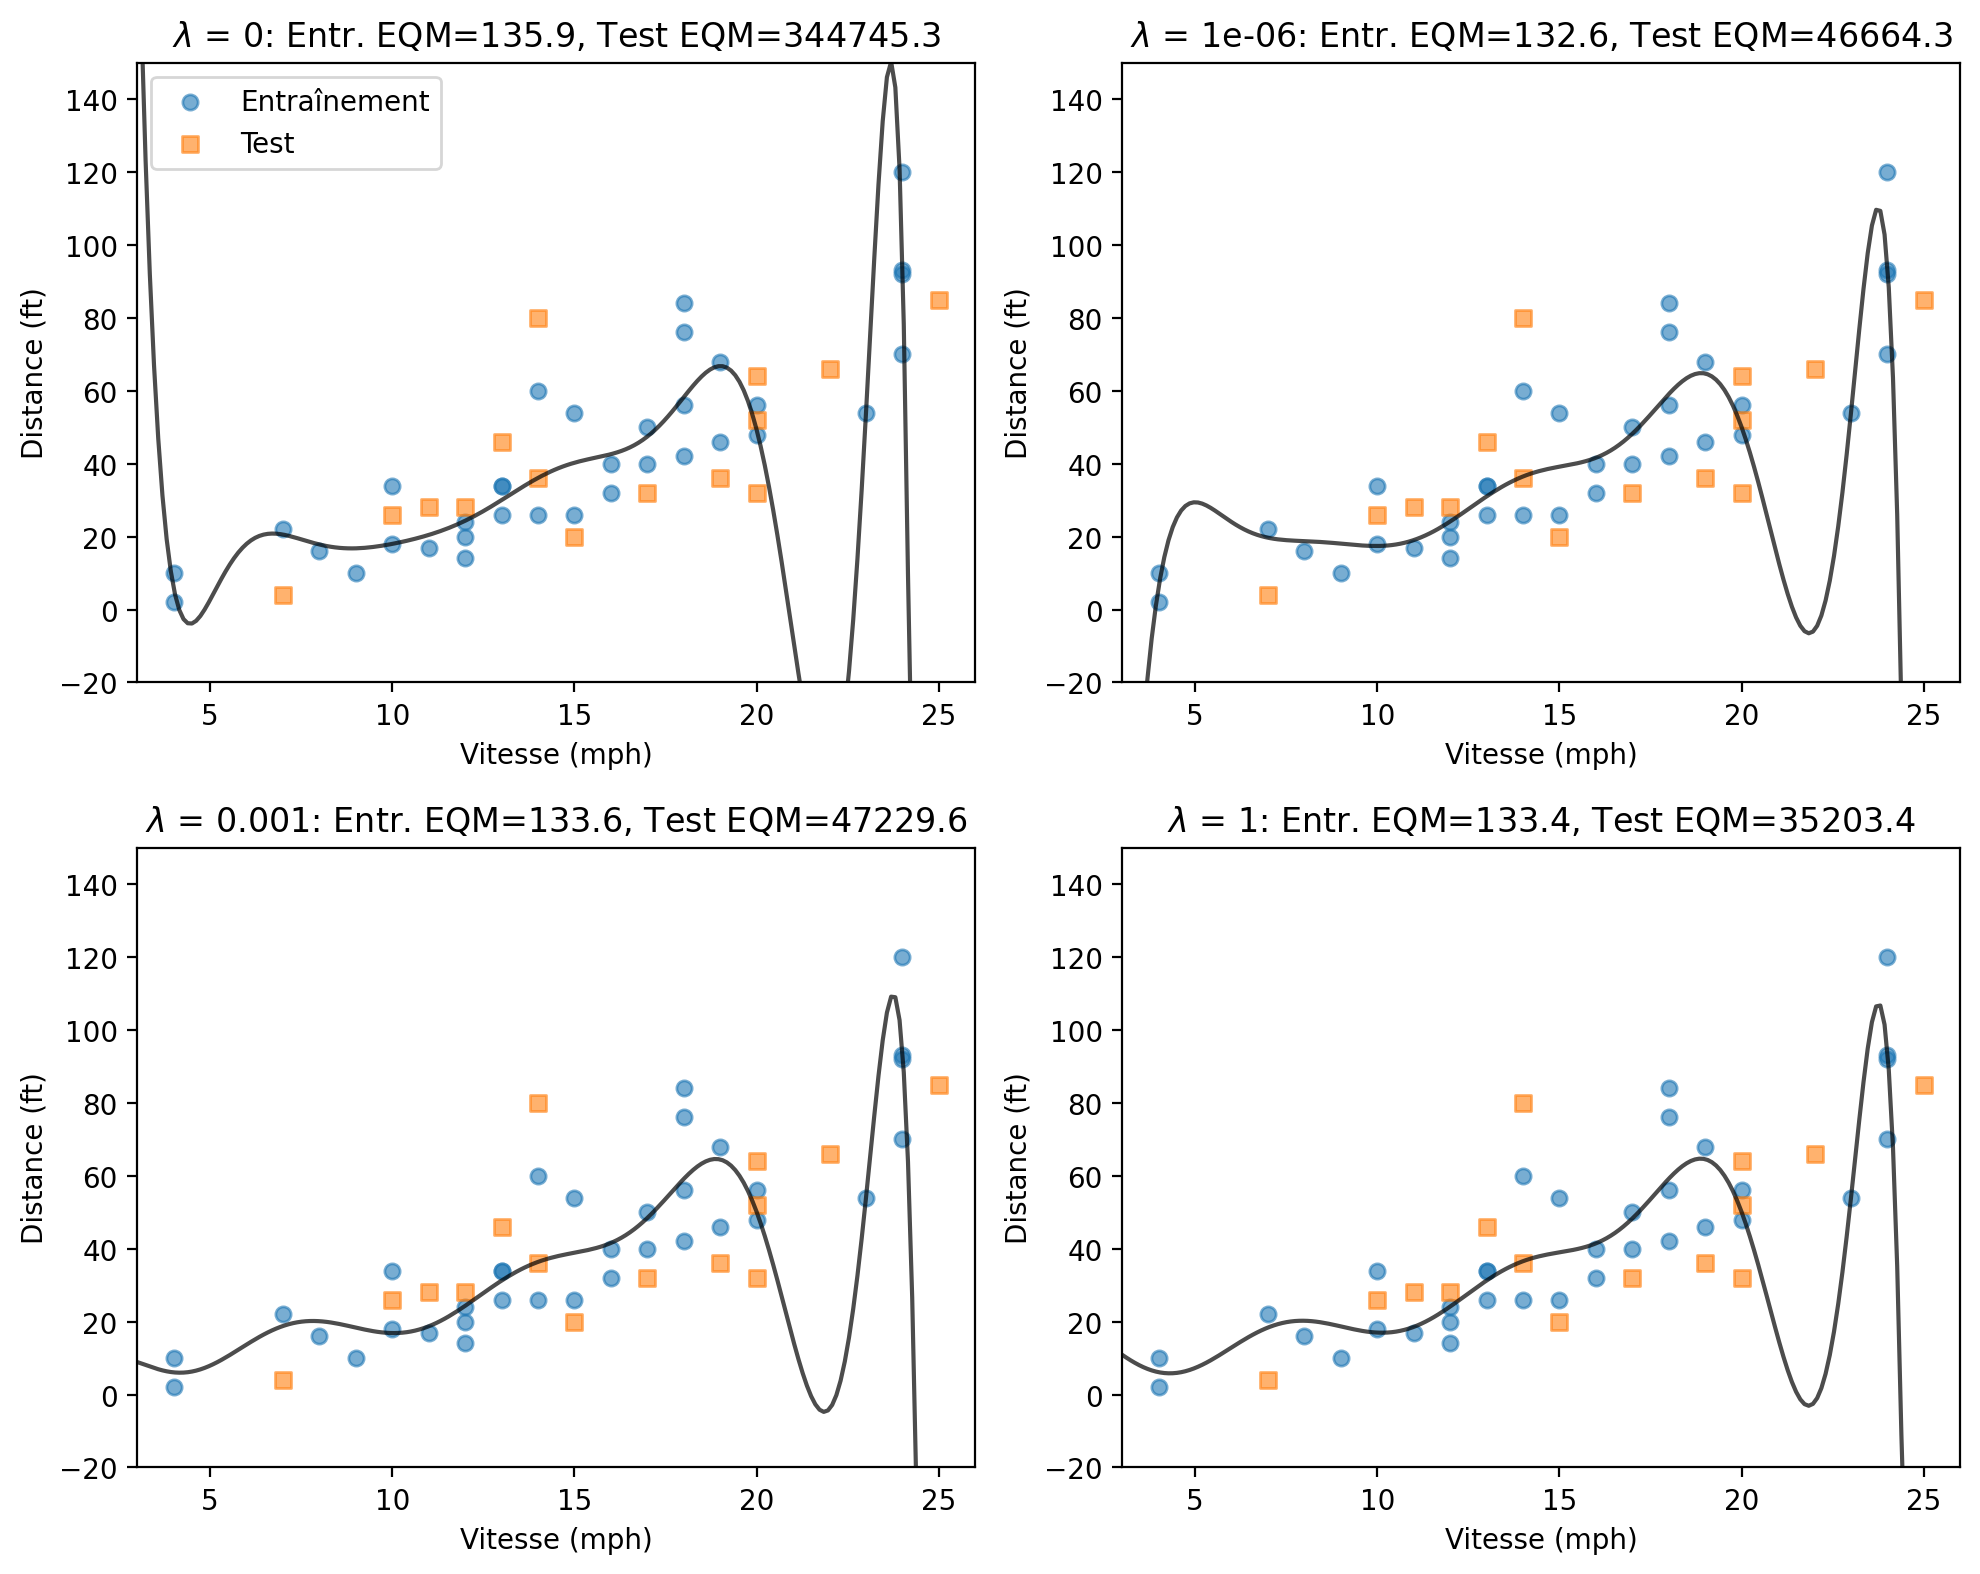
Sans régularisation (), le polynôme de degré 15 oscille fortement. Avec une régularisation modérée (), les oscillations sont atténuées et l’erreur de test diminue. Avec une régularisation trop forte (), le modèle devient trop contraint et sous-apprend.
Solution analytique de Ridge
Comme pour les moindres carrés ordinaires, Ridge admet une solution analytique. L’objectif régularisé est:
En développant et en calculant le gradient:
En posant le gradient égal à zéro, nous obtenons les équations normales régularisées:
La solution est:
Comparons avec la solution MCO: . La seule différence est l’ajout du terme à la matrice .
Application: Température critique des supraconducteurs
Quand la régularisation devient-elle vraiment nécessaire? Considérons un problème avec 81 caractéristiques: prédire la température critique de supraconducteurs à partir de leur composition chimique. Ce jeu de données contient 21 263 matériaux supraconducteurs, avec des caractéristiques extraites automatiquement (moyennes, écarts-types, entropies des propriétés atomiques).
Source
import numpy as np
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings('ignore')

# Charger les données des supraconducteurs
from ucimlrepo import fetch_ucirepo
superconductor = fetch_ucirepo(id=464)
X_super = superconductor.data.features.values
y_super = superconductor.data.targets.values.ravel()

print(f"Dimensions: {X_super.shape[0]} échantillons, {X_super.shape[1]} caractéristiques")
print(f"Température critique: min={y_super.min():.1f} K, max={y_super.max():.1f} K, médiane={np.median(y_super):.1f} K")
Dimensions: 21263 échantillons, 81 caractéristiques
Température critique: min=0.0 K, max=185.0 K, médiane=20.0 K
Avec 81 caractéristiques potentiellement corrélées, la matrice risque d’être mal conditionnée. Comparons MCO et Ridge:
Source
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# Préparer les données
X_train, X_test, y_train, y_test = train_test_split(
    X_super, y_super, test_size=0.2, random_state=42)

# Standardiser (important pour Ridge!)
scaler = StandardScaler()
X_train_std = scaler.fit_transform(X_train)
X_test_std = scaler.transform(X_test)

# Ajouter biais
X_train_bias = np.column_stack([np.ones(len(X_train_std)), X_train_std])
X_test_bias = np.column_stack([np.ones(len(X_test_std)), X_test_std])

# MCO
try:
    theta_ols = np.linalg.solve(X_train_bias.T @ X_train_bias, X_train_bias.T @ y_train)
    y_pred_ols = X_test_bias @ theta_ols
    mse_ols = np.mean((y_test - y_pred_ols)**2)
    ols_ok = True
except np.linalg.LinAlgError:
    ols_ok = False
    mse_ols = np.inf

# Ridge pour différentes valeurs de lambda
lambdas = np.logspace(-4, 4, 50)
mse_train_ridge = []
mse_test_ridge = []
coef_norms = []

for lam in lambdas:
    I = np.eye(X_train_bias.shape[1])
    I[0, 0] = 0  # Ne pas régulariser le biais
    theta_ridge = np.linalg.solve(
        X_train_bias.T @ X_train_bias + lam * I,
        X_train_bias.T @ y_train
    )

    y_pred_train = X_train_bias @ theta_ridge
    y_pred_test = X_test_bias @ theta_ridge

    mse_train_ridge.append(np.mean((y_train - y_pred_train)**2))
    mse_test_ridge.append(np.mean((y_test - y_pred_test)**2))
    coef_norms.append(np.linalg.norm(theta_ridge[1:]))

# Trouver le meilleur lambda
best_idx = np.argmin(mse_test_ridge)
best_lambda = lambdas[best_idx]
best_mse = mse_test_ridge[best_idx]

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))

# Panneau gauche: EQM vs lambda
ax = axes[0]
ax.semilogx(lambdas, mse_train_ridge, 'b-', label='Entraînement', linewidth=2)
ax.semilogx(lambdas, mse_test_ridge, 'r-', label='Test', linewidth=2)
ax.axvline(best_lambda, color='green', linestyle='--', alpha=0.7)
ax.axhline(mse_ols, color='gray', linestyle=':', label=f'MCO (test): {mse_ols:.1f}')
ax.scatter([best_lambda], [best_mse], color='green', s=100, zorder=5)
ax.set_xlabel('$\\lambda$')
ax.set_ylabel('Erreur quadratique moyenne (K²)')
ax.set_title('Sélection de $\\lambda$ par validation')
ax.legend()
ax.set_ylim(0, min(500, max(mse_test_ridge[:10])))
ax.text(best_lambda * 1.5, best_mse + 20, f'$\\lambda^* = {best_lambda:.1f}$\nEQM = {best_mse:.1f}', fontsize=10)

# Panneau droit: norme des coefficients
ax = axes[1]
ax.semilogx(lambdas, coef_norms, 'k-', linewidth=2)
ax.axvline(best_lambda, color='green', linestyle='--', alpha=0.7)
ax.set_xlabel('$\\lambda$')
ax.set_ylabel('$\\|\\boldsymbol{\\theta}\\|_2$')
ax.set_title('Rétrécissement des coefficients')

plt.tight_layout()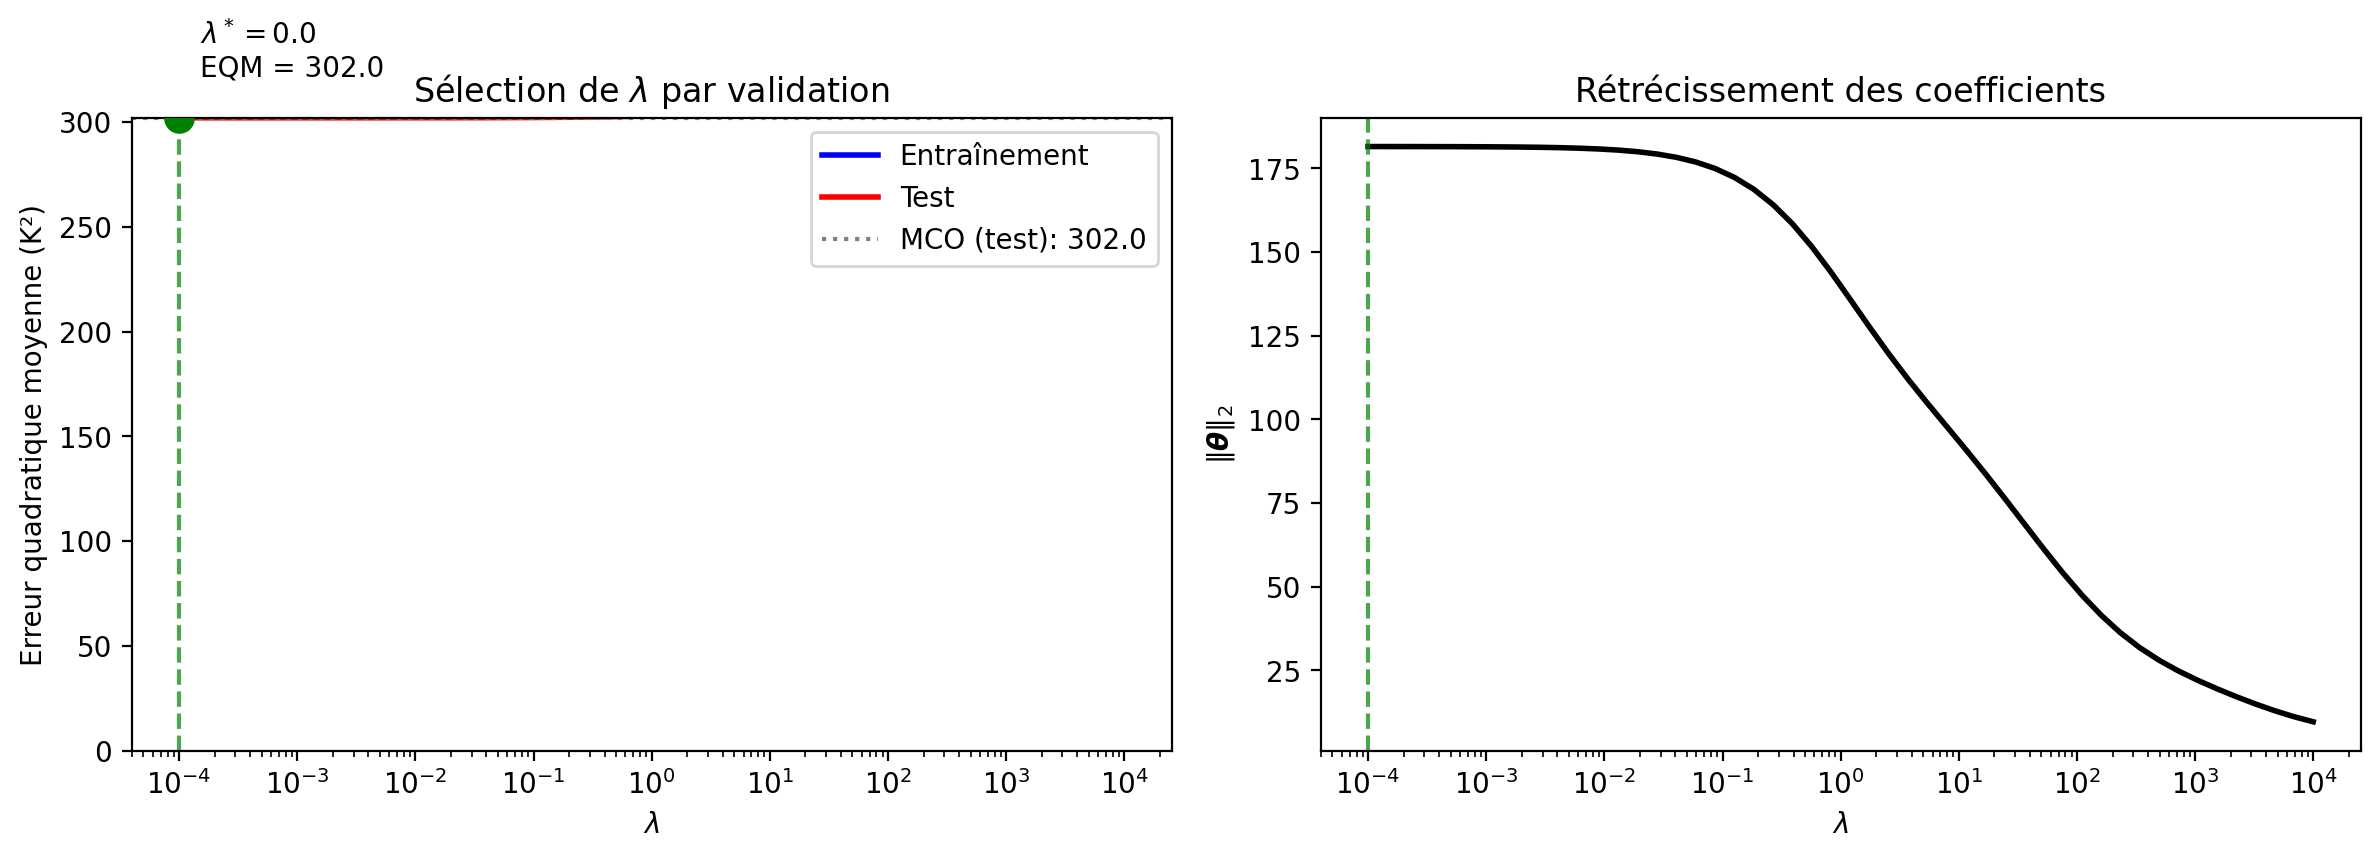
Le panneau de gauche illustre le compromis biais-variance typique:
Pour petit, l’erreur de test est élevée (variance d’estimation trop grande)
Pour grand, les deux erreurs augmentent (biais trop important)
Le optimal se situe entre ces extrêmes
Le chemin de régularisation
Le chemin de régularisation montre comment chaque coefficient évolue en fonction de . C’est un outil de diagnostic précieux:
Source
import numpy as np
import matplotlib.pyplot as plt

# Calculer les coefficients pour chaque lambda
lambdas_path = np.logspace(-2, 4, 100)
coefs_path = []

for lam in lambdas_path:
    I = np.eye(X_train_bias.shape[1])
    I[0, 0] = 0
    theta = np.linalg.solve(
        X_train_bias.T @ X_train_bias + lam * I,
        X_train_bias.T @ y_train
    )
    coefs_path.append(theta[1:])  # Exclure le biais

coefs_path = np.array(coefs_path)

fig, ax = plt.subplots(figsize=(10, 5))

# Tracer un sous-ensemble de coefficients (les 20 plus variables)
coef_variance = np.var(coefs_path, axis=0)
top_indices = np.argsort(coef_variance)[-20:]

for i in top_indices:
    ax.semilogx(lambdas_path, coefs_path[:, i], alpha=0.7, linewidth=1.5)

ax.axvline(best_lambda, color='green', linestyle='--', alpha=0.7, label=f'$\\lambda^* = {best_lambda:.1f}$')
ax.axhline(0, color='black', linewidth=0.5)
ax.set_xlabel('$\\lambda$')
ax.set_ylabel('Coefficient $\\theta_j$')
ax.set_title('Chemin de régularisation (20 coefficients les plus variables)')
ax.legend()

plt.tight_layout()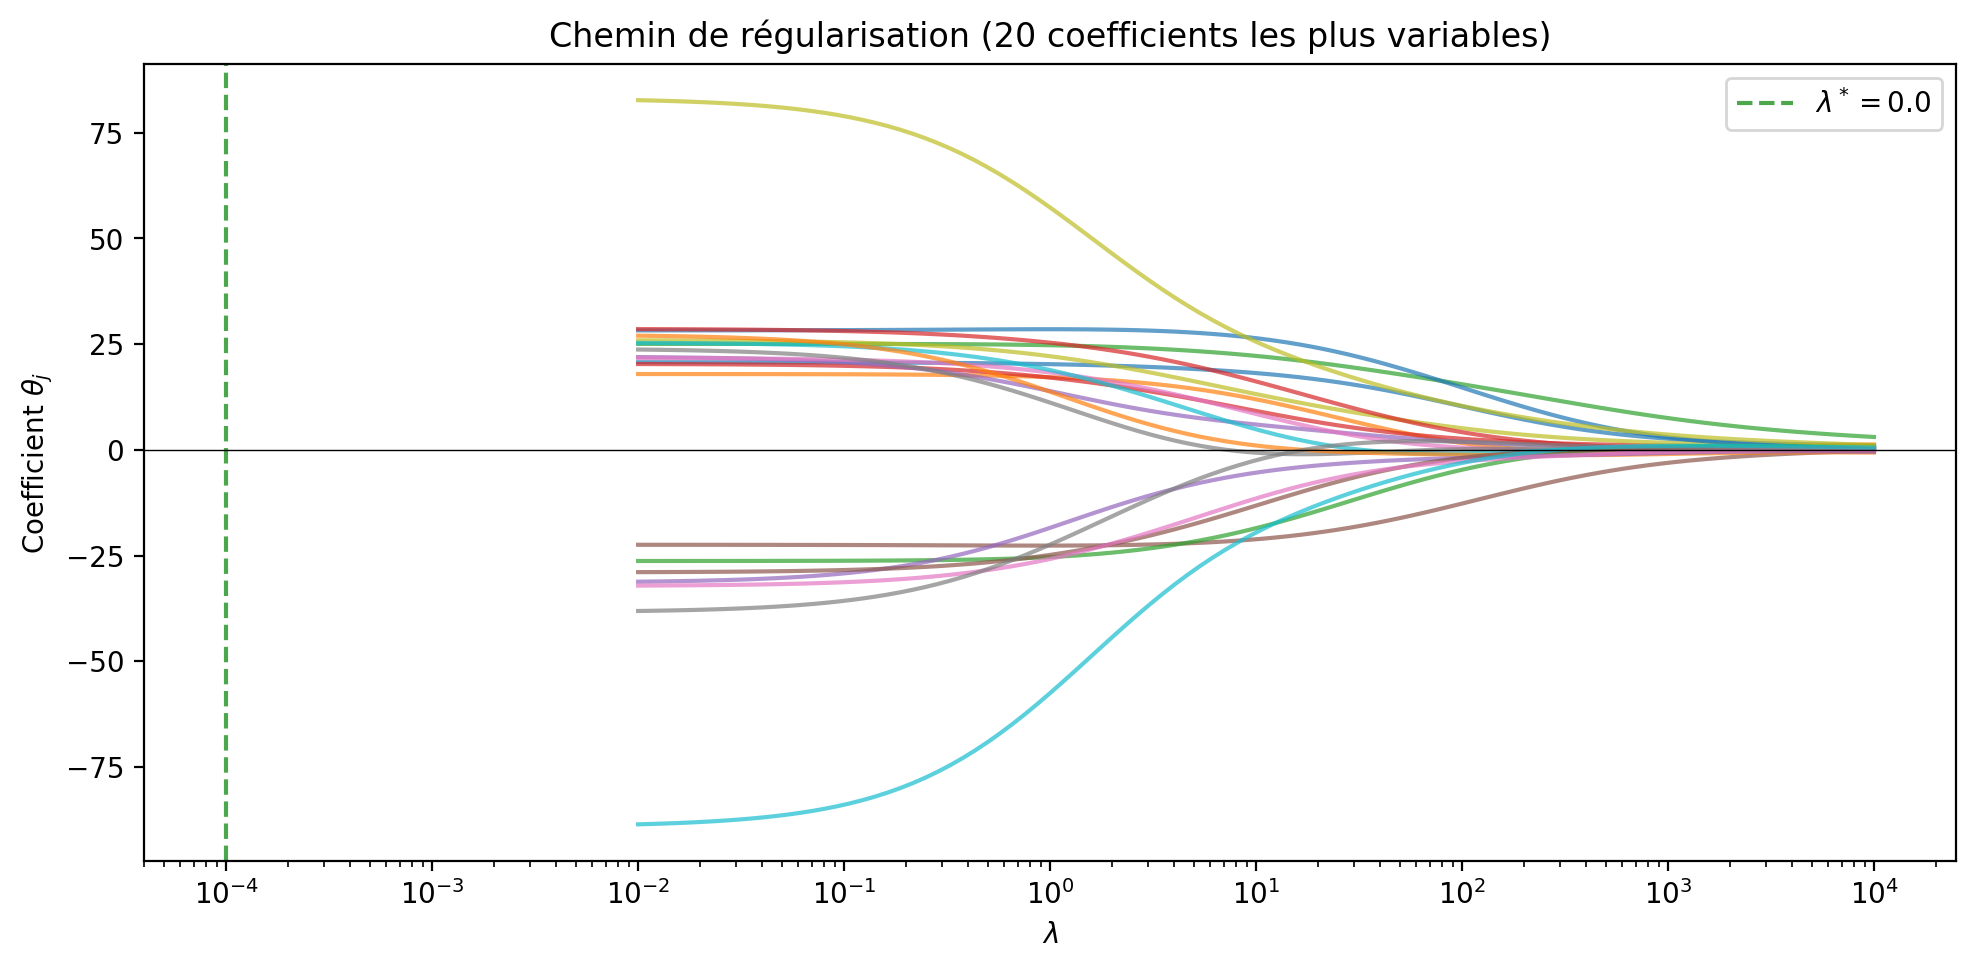
À gauche ( petit), les coefficients prennent des valeurs extrêmes et instables. À mesure que augmente, ils sont progressivement « rétrécis » vers zéro. Les coefficients qui résistent le plus longtemps à ce rétrécissement correspondent aux caractéristiques les plus importantes pour la prédiction.
Interprétation via la SVD
Cette section présente une autre façon d’exprimer les solutions MCO et Ridge, en utilisant la décomposition en valeurs singulières (SVD). Si vous n’avez jamais rencontré la SVD, ne vous inquiétez pas: nous allons l’introduire progressivement. Cette approche n’est pas strictement nécessaire pour comprendre Ridge, mais elle offre une interprétation géométrique très éclairante qui révèle pourquoi la régularisation fonctionne.
Qu’est-ce que la SVD?
Si vous avez déjà rencontré la décomposition en valeurs propres, la SVD en est une généralisation. Pour une matrice carrée symétrique , la décomposition en valeurs propres s’écrit , où contient les vecteurs propres et les valeurs propres. La SVD généralise cette idée à n’importe quelle matrice, même rectangulaire.
Pour une matrice de données, la SVD la réécrit comme le produit de trois matrices:
Lien avec la décomposition en valeurs propres: Les colonnes de sont les vecteurs propres de , et les valeurs singulières sont les racines carrées des valeurs propres de . Autrement dit, si est la décomposition en valeurs propres de , alors où sont les valeurs propres. De même, les colonnes de sont les vecteurs propres de .
Cette connexion est utile car apparaît naturellement dans la régression (c’est la matrice que nous inversons pour MCO). Les valeurs singulières nous renseignent donc directement sur le “conditionnement” de cette matrice: si certaines valeurs singulières sont très petites, alors est proche d’être singulière (non inversible).
Interprétation géométrique
contient les directions principales dans l’espace des caractéristiques (les colonnes sont orthonormales). Ces directions correspondent aux axes le long desquels la matrice transforme les vecteurs de manière la plus efficace.
est une matrice diagonale contenant les valeurs singulières , ordonnées du plus grand au plus petit. Chaque valeur singulière mesure l’amplitude de la transformation le long de la direction . Une grande valeur singulière signifie que la transformation est forte dans cette direction; une petite valeur singulière signifie que la transformation est faible.
contient les directions correspondantes dans l’espace des observations (les colonnes sont orthonormales). Chaque indique comment les observations se projettent sur la direction principale .
Solution MCO via SVD
En utilisant cette décomposition, la solution MCO peut s’écrire:
Cette formule décompose la solution en une somme de contributions le long de chaque direction principale . Le terme mesure combien la sortie s’aligne avec la direction , divisé par l’amplitude de cette direction. Notez que diviser par une petite valeur singulière peut amplifier le bruit, ce qui explique pourquoi MCO peut être instable quand certaines directions ont de petites valeurs singulières.
Solution Ridge via SVD
Pour Ridge, la solution devient:
La différence avec MCO est le facteur de rétrécissement qui multiplie chaque terme. Ce facteur est toujours inférieur à 1, ce qui “rétrécit” chaque composante vers zéro. L’effet clé est que ce rétrécissement est différencié: les directions avec de petites valeurs singulières sont rétrécies plus fortement que celles avec de grandes valeurs singulières.
Avantages numériques: Au-delà de l’interprétation, la SVD offre aussi des avantages pratiques. Elle est plus stable numériquement que l’inversion directe de , surtout quand cette matrice est mal conditionnée (c’est-à-dire quand certaines valeurs singulières sont très petites). Les algorithmes SVD gèrent mieux ces cas délicats.
Visualisation: ellipse des données et vecteurs singuliers
Pour rendre ces concepts concrets, visualisons ce que la SVD capture sur un nuage de données 2D. Générons des points suivant une distribution gaussienne avec une covariance non triviale (les deux variables sont corrélées).
Source
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

np.random.seed(42)

# Générer des données gaussiennes corrélées
n_points = 200
mean = [0, 0]
cov = [[2.0, 1.2], [1.2, 1.0]]  # Covariance non diagonale
X = np.random.multivariate_normal(mean, cov, n_points)

# Centrer les données
X_centered = X - X.mean(axis=0)

# SVD de la matrice de données centrée
U, d, Vt = np.linalg.svd(X_centered, full_matrices=False)
V = Vt.T

# Les valeurs singulières sont liées aux écarts-types: d_j / sqrt(N-1)
# Pour l'ellipse, nous utilisons les écarts-types dans chaque direction
std_1 = d[0] / np.sqrt(n_points - 1)
std_2 = d[1] / np.sqrt(n_points - 1)

# Créer la figure
fig, ax = plt.subplots(figsize=(8, 6))

# Tracer les points
ax.scatter(X_centered[:, 0], X_centered[:, 1], alpha=0.5, s=20, c='tab:blue', label='Données')

# Tracer les vecteurs singuliers (directions principales)
origin = [0, 0]
scale = 2  # Facteur d'échelle pour la visualisation

# Premier vecteur singulier (direction de plus grande variance)
ax.annotate('', xy=V[:, 0] * std_1 * scale, xytext=origin,
            arrowprops=dict(arrowstyle='->', color='tab:red', lw=2.5))
ax.annotate('', xy=-V[:, 0] * std_1 * scale, xytext=origin,
            arrowprops=dict(arrowstyle='->', color='tab:red', lw=2.5))

# Deuxième vecteur singulier (direction de plus petite variance)
ax.annotate('', xy=V[:, 1] * std_2 * scale, xytext=origin,
            arrowprops=dict(arrowstyle='->', color='tab:orange', lw=2.5))
ax.annotate('', xy=-V[:, 1] * std_2 * scale, xytext=origin,
            arrowprops=dict(arrowstyle='->', color='tab:orange', lw=2.5))

# Ellipse de confiance (2 écarts-types)
angle = np.degrees(np.arctan2(V[1, 0], V[0, 0]))
ellipse = Ellipse(xy=(0, 0), width=4*std_1, height=4*std_2, angle=angle,
                  fill=False, edgecolor='gray', linestyle='--', linewidth=1.5)
ax.add_patch(ellipse)

# Annotations
ax.text(V[0, 0] * std_1 * scale * 1.15, V[1, 0] * std_1 * scale * 1.15,
        f'$\\mathbf{{v}}_1$ ($d_1 = {d[0]:.1f}$)', fontsize=11, color='tab:red')
ax.text(V[0, 1] * std_2 * scale * 1.3, V[1, 1] * std_2 * scale * 1.3,
        f'$\\mathbf{{v}}_2$ ($d_2 = {d[1]:.1f}$)', fontsize=11, color='tab:orange')

ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Nuage gaussien et directions principales (SVD)')
ax.set_aspect('equal')
ax.grid(True, alpha=0.3)
ax.axhline(0, color='gray', linewidth=0.5)
ax.axvline(0, color='gray', linewidth=0.5)
ax.set_xlim(-4, 4)
ax.set_ylim(-3, 3)

plt.tight_layout()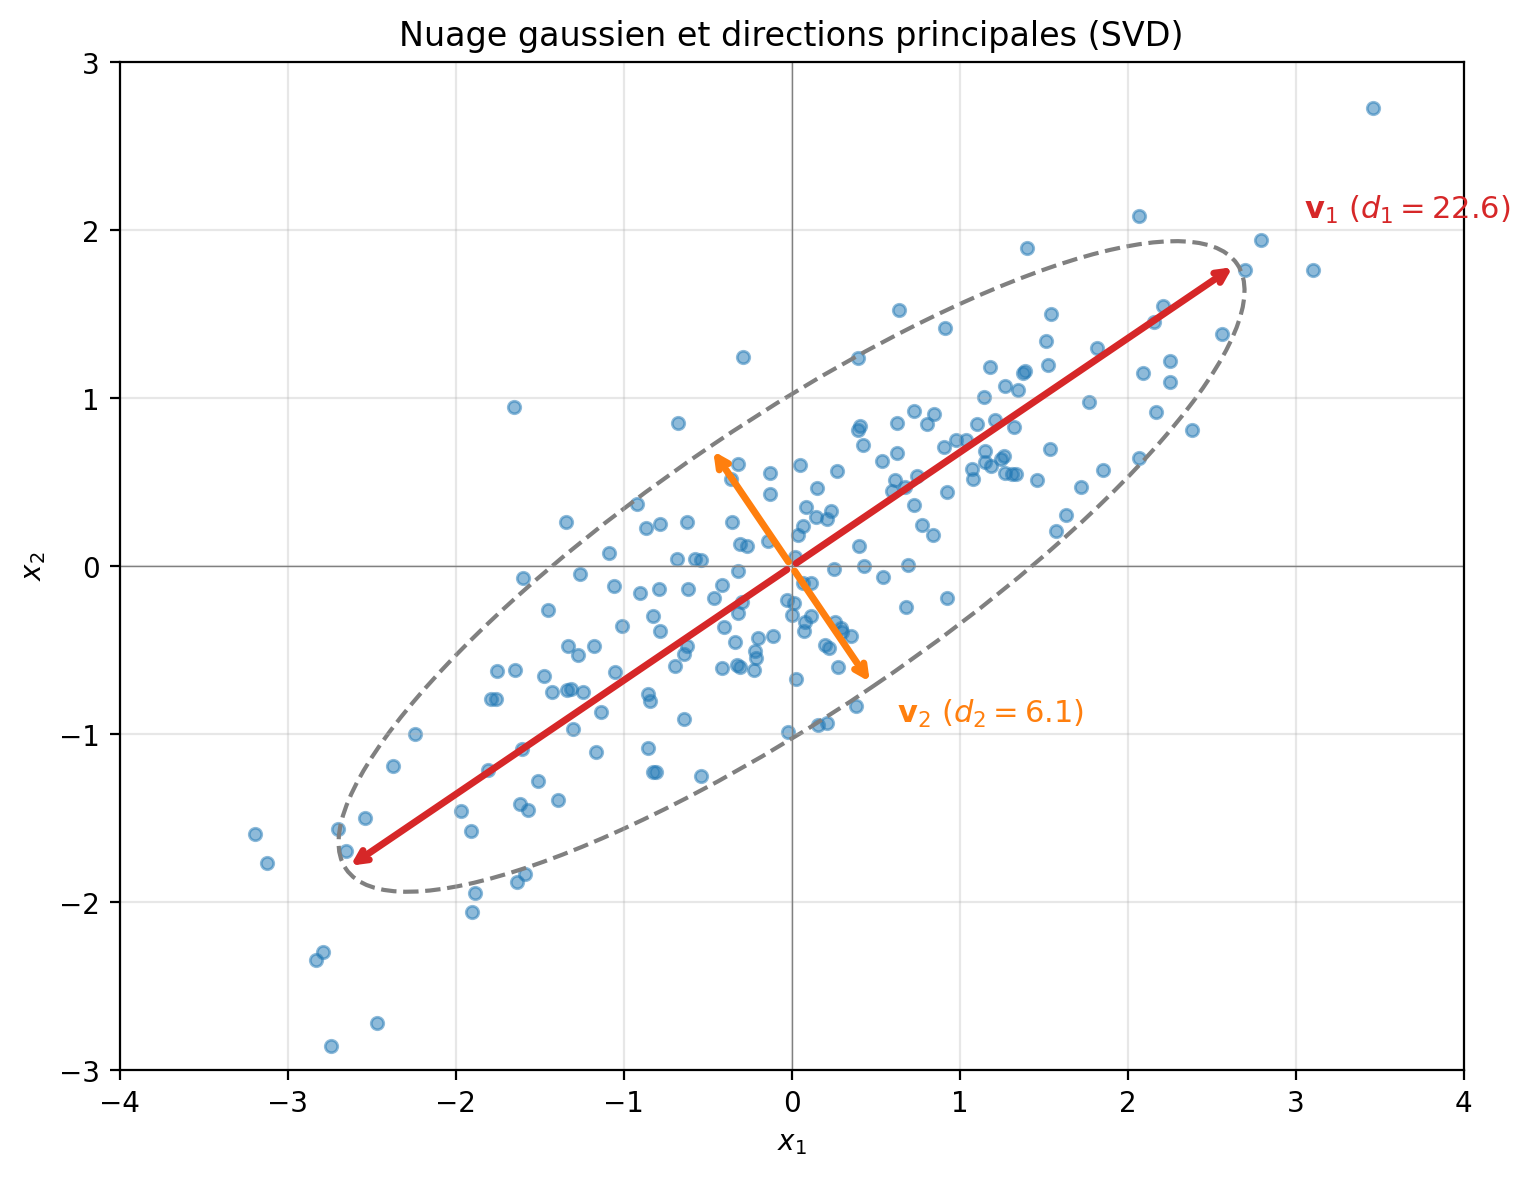
La figure montre un nuage de 200 points tirés d’une gaussienne 2D. Les flèches représentent les vecteurs singuliers et :
Le vecteur (rouge) pointe dans la direction de plus grande variance. La valeur singulière mesure l’amplitude de la dispersion dans cette direction.
Le vecteur (orange) pointe dans la direction de plus petite variance, perpendiculaire à . La valeur singulière est plus petite.
L’ellipse en pointillés représente la région contenant environ 95% des données si elles suivent exactement la distribution gaussienne. Ses axes coïncident avec les vecteurs singuliers, et les longueurs des demi-axes sont proportionnelles aux valeurs singulières.
Cette visualisation illustre pourquoi la SVD est si utile: elle identifie automatiquement les axes naturels des données. Dans le contexte de la régression, si les caractéristiques forment un nuage allongé (valeurs singulières très différentes), alors certaines directions contiennent beaucoup d’information (grandes valeurs singulières) tandis que d’autres en contiennent peu (petites valeurs singulières).
Deux variances: données vs estimation
Avant d’aller plus loin, clarifions une source fréquente de confusion. Le mot variance apparaît dans deux contextes très différents lorsqu’on parle de SVD et de régularisation:
Variance des données (dispersion): mesure l’étalement des données le long d’une direction . Elle est proportionnelle à . Une grande valeur singulière signifie que les données sont très dispersées dans cette direction.
Variance d’estimation (incertitude): mesure l’incertitude sur notre estimé du paramètre correspondant à la direction . Elle est proportionnelle à . Une petite valeur singulière signifie que notre estimé est très incertain.
Ces deux variances sont inversement reliées:
| Valeur singulière | Variance des données | Variance d’estimation | Interprétation |
|---|---|---|---|
| Grande | Élevée (données étalées) | Faible (estimé précis) | Beaucoup d’information |
| Petite | Faible (données concentrées) | Élevée (estimé incertain) | Peu d’information |
Intuition: Imaginez estimer une pente à partir de données. Si les points sont très étalés horizontalement (grande variance des données en ), la pente est facile à déterminer avec précision (faible variance d’estimation). Si les points sont tous regroupés (petite variance des données), la pente est très incertaine (grande variance d’estimation).
C’est cette relation inverse qui explique le comportement de Ridge:
Ridge rétrécit les directions où est petit (faible variance des données)
Ce sont précisément les directions où la variance d’estimation est grande
En rétrécissant ces directions, Ridge réduit la variance d’estimation au prix d’un biais
Ainsi, quand nous disons que « Ridge contrôle la variance », nous parlons de la variance d’estimation des paramètres, pas de la variance des données. La régularisation n’affecte pas la dispersion des données; elle réduit l’incertitude de nos estimés en les « tirant » vers zéro.
Spectre des valeurs singulières et rang effectif
En pratique, les données réelles ont souvent des dizaines ou des centaines de dimensions. Comment se comportent les valeurs singulières dans ce cas? Examinons un exemple avec des données de dimension plus élevée.
Source
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(123)

# Simuler des données avec une structure de rang bas + bruit
n_samples = 100
n_features = 30

# Vraie structure: combinaison de 5 facteurs latents
n_latent = 5
latent = np.random.randn(n_samples, n_latent)
loadings = np.random.randn(n_latent, n_features)
X_signal = latent @ loadings

# Ajouter du bruit
noise_level = 0.5
X = X_signal + noise_level * np.random.randn(n_samples, n_features)

# Centrer
X_centered = X - X.mean(axis=0)

# SVD
U, d, Vt = np.linalg.svd(X_centered, full_matrices=False)

# Variance expliquée
variance_explained = d**2 / np.sum(d**2)
cumulative_variance = np.cumsum(variance_explained)

# Créer la figure
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))

# Panneau gauche: spectre des valeurs singulières
ax1 = axes[0]
ax1.semilogy(range(1, len(d)+1), d, 'o-', markersize=6, linewidth=1.5, color='tab:blue')
ax1.axhline(d[n_latent], color='tab:red', linestyle='--', linewidth=1.5,
            label=f'Seuil (rang effectif = {n_latent})')
ax1.fill_between(range(1, n_latent+1), d[:n_latent], alpha=0.3, color='tab:green', label='Signal')
ax1.fill_between(range(n_latent+1, len(d)+1), d[n_latent:], alpha=0.3, color='tab:orange', label='Bruit')
ax1.set_xlabel('Indice $j$')
ax1.set_ylabel('Valeur singulière $d_j$ (échelle log)')
ax1.set_title('Spectre des valeurs singulières')
ax1.legend(loc='upper right')
ax1.grid(True, alpha=0.3, which='both')
ax1.set_xlim(0.5, len(d)+0.5)

# Panneau droit: variance expliquée cumulative
ax2 = axes[1]
ax2.plot(range(1, len(d)+1), cumulative_variance * 100, 'o-', markersize=6,
         linewidth=1.5, color='tab:blue')
ax2.axhline(95, color='gray', linestyle='--', linewidth=1, label='Seuil 95%')
ax2.axvline(n_latent, color='tab:red', linestyle='--', linewidth=1.5)

# Trouver k pour 95% de variance
k_95 = np.searchsorted(cumulative_variance, 0.95) + 1
ax2.scatter([k_95], [cumulative_variance[k_95-1]*100], s=100, color='tab:red', zorder=5)
ax2.annotate(f'{k_95} composantes\npour 95%', xy=(k_95, cumulative_variance[k_95-1]*100),
             xytext=(k_95+5, cumulative_variance[k_95-1]*100-10), fontsize=10,
             arrowprops=dict(arrowstyle='->', color='gray'))

ax2.set_xlabel('Nombre de composantes $k$')
ax2.set_ylabel('Variance expliquée cumulative (%)')
ax2.set_title('Variance expliquée')
ax2.grid(True, alpha=0.3)
ax2.set_xlim(0.5, len(d)+0.5)
ax2.set_ylim(0, 105)

plt.tight_layout()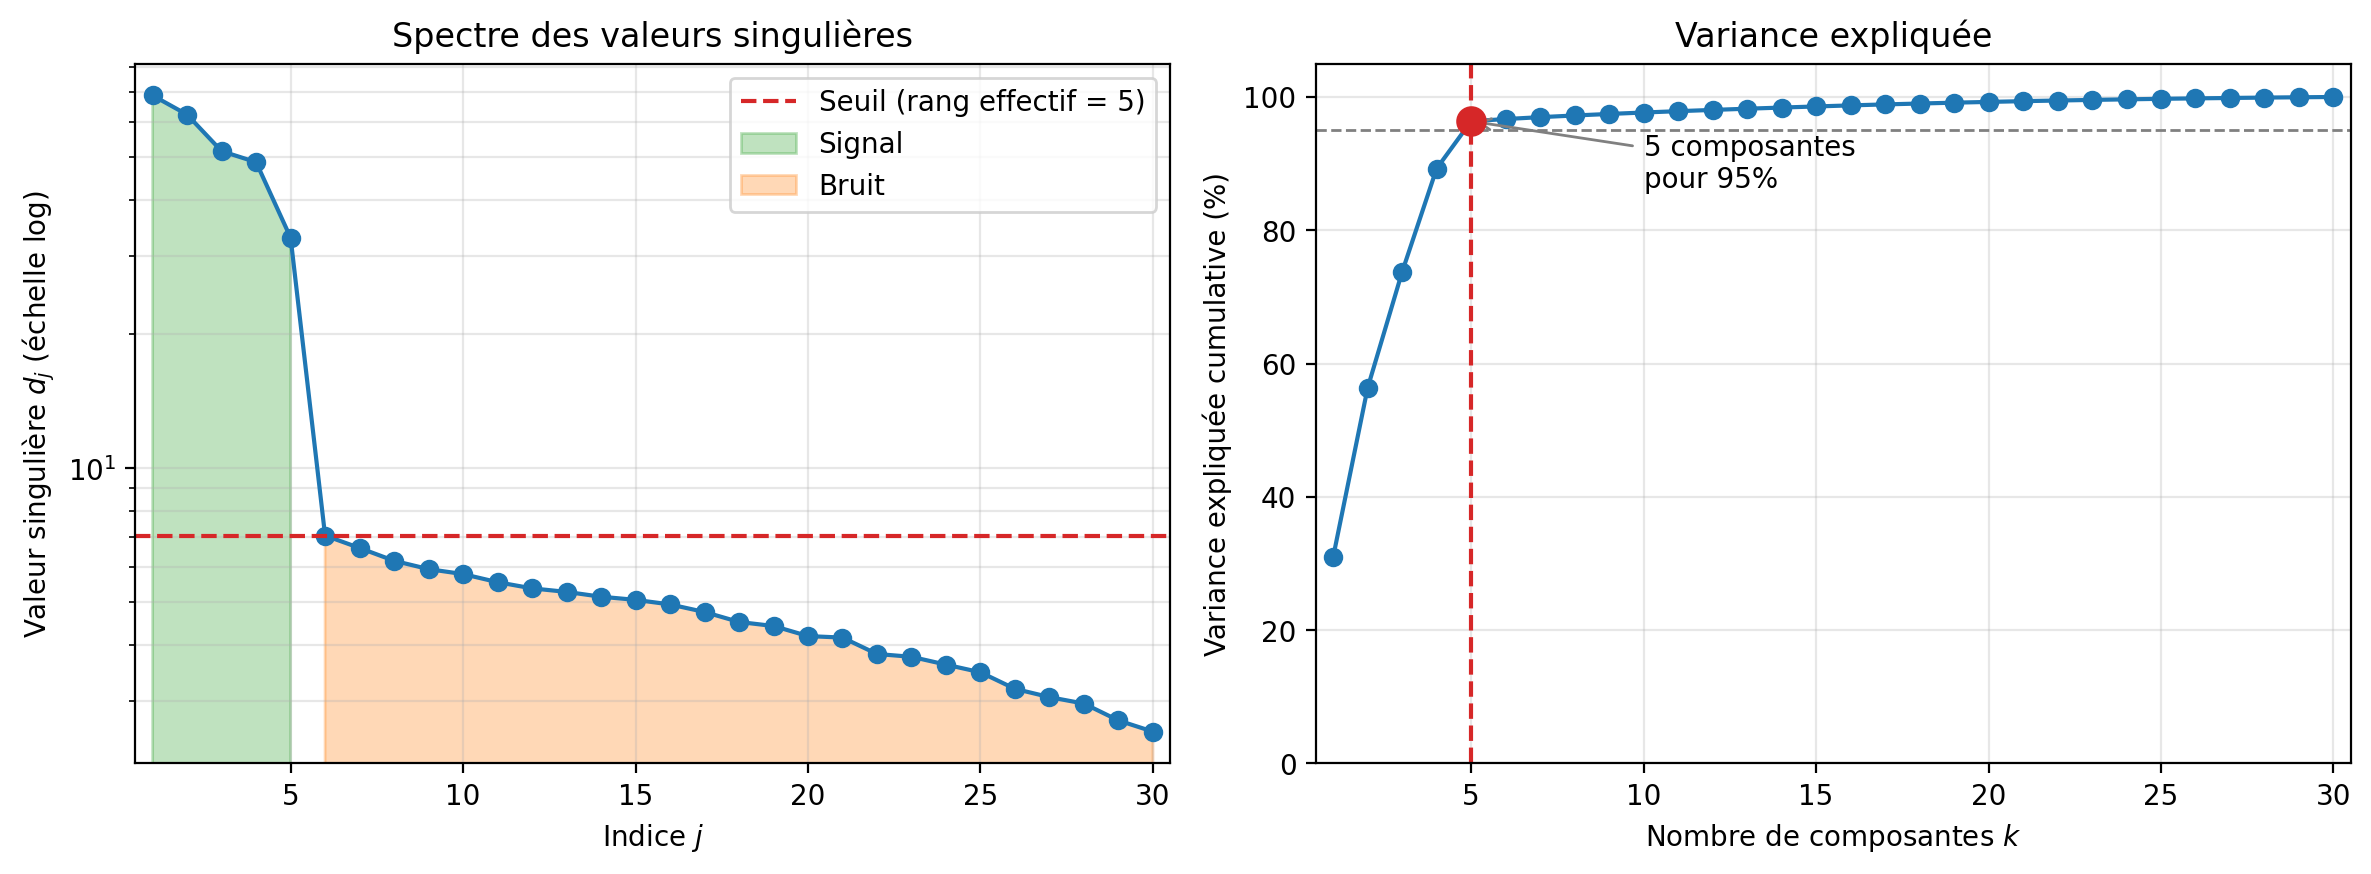
Le panneau de gauche montre le spectre des valeurs singulières en échelle logarithmique. On observe un schéma typique:
Les premières valeurs singulières sont grandes: elles correspondent aux directions du signal, la vraie structure sous-jacente des données.
Après un certain point (ici, autour de ), les valeurs singulières chutent et forment un “plancher”: ce sont les directions du bruit.
Le rang effectif est le nombre de valeurs singulières significativement au-dessus du plancher de bruit. Dans cet exemple, nous avons simulé 5 facteurs latents, et le spectre révèle bien cette structure: les 5 premières valeurs singulières dominent.
Le panneau de droite montre la variance expliquée cumulative. C’est un outil pratique pour choisir combien de composantes retenir:
Critère du seuil: Retenir assez de composantes pour expliquer 95% (ou 99%) de la variance.
Critère du coude: Chercher le “coude” dans le spectre où les valeurs singulières cessent de décroître rapidement.
Critère du gap: Si le spectre présente un saut net (comme ici entre et ), c’est un bon point de coupure.
De la troncature à la réduction de dimension (ACP)
L’analyse ci-dessus suggère une idée: si les dernières directions ne contiennent que du bruit, pourquoi ne pas simplement les ignorer? Au lieu de rétrécir les coefficients comme Ridge, nous pourrions tronquer la représentation en ne gardant que les premières directions principales.
C’est exactement l’idée de l’analyse en composantes principales (ACP). Au lieu de travailler avec les caractéristiques originales, nous projetons les données sur les premiers vecteurs singuliers:
où contient les premiers vecteurs singuliers (les colonnes de correspondant aux plus grandes valeurs singulières).
Cette projection préserve au mieux la variance des données: les composantes principales capturent la direction où les données varient le plus. La reconstruction à partir de cette représentation compressée s’écrit:
L’erreur de reconstruction est minimale parmi toutes les projections linéaires sur un sous-espace de dimension .
Lien entre Ridge et ACP: Les deux approches traitent le même problème (les directions à faible valeur singulière sont bruitées) mais différemment:
| Approche | Traitement des directions bruitées | Type de régularisation |
|---|---|---|
| Ridge | Rétrécit (soft thresholding) | Continue: garde tout, pénalise |
| ACP | Élimine (hard thresholding) | Discrète: garde , ignore le reste |
Ridge est appropriée pour la régression supervisée, où même les petites directions peuvent contenir du signal utile pour prédire . L’ACP est appropriée pour la réduction de dimension non supervisée, où nous voulons une représentation compacte des données elles-mêmes.
Pourquoi λI aide: trois perspectives
Le terme diagonal ajouté à a plusieurs effets bénéfiques:
1. Amélioration du conditionnement
La matrice peut être mal conditionnée (ses valeurs propres varient sur plusieurs ordres de grandeur) ou même singulière. L’ajout de augmente toutes les valeurs propres de , rendant la matrice inversible et mieux conditionnée.
2. Rétrécissement des coefficients
Comme nous l’avons vu dans la section SVD ci-dessus, la solution Ridge s’écrit:
Le facteur de rétrécissement est toujours inférieur à 1, ce qui “rétrécit” chaque composante vers zéro. L’effet est différencié selon les directions:
Pour une grande valeur singulière (fort signal), le facteur reste proche de 1 même pour des valeurs modérées de . La direction est peu affectée.
Pour une petite valeur singulière (faible signal), le facteur décroît rapidement avec . La direction est fortement pénalisée.
3. Stabilité numérique
Quand est presque singulière, de petites perturbations dans les données causent de grandes variations dans . La régularisation réduit cette sensibilité.
Géométrie de la régularisation Ridge
Pour visualiser le rétrécissement et comprendre son effet, examinons un exemple concret. L’animation suivante montre simultanément trois perspectives sur la régularisation Ridge: les données et la droite ajustée, le paysage de perte avec la contrainte, et les facteurs de rétrécissement.
Source
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.animation import FuncAnimation
from matplotlib.patches import Circle
from IPython.display import Image

# Générer des données de régression simple
np.random.seed(42)
n = 30

# Une seule caractéristique pour visualisation claire
x = np.random.uniform(-2, 2, n)
# Relation linéaire avec bruit
theta_true = 1.5
y = theta_true * x + np.random.normal(0, 0.8, n)

# Ajouter une caractéristique corrélée (pour créer de la colinéarité)
x2 = 0.9 * x + 0.3 * np.random.randn(n)

# Matrice de design avec les deux caractéristiques
X = np.column_stack([x, x2])

# Solution MCO
theta_ols = np.linalg.lstsq(X, y, rcond=None)[0]

# SVD pour analyse
U, d_svd, Vt = np.linalg.svd(X, full_matrices=False)
V = Vt.T

# Fonction pour calculer la solution Ridge
def ridge_solution(X, y, lam):
    n_features = X.shape[1]
    return np.linalg.solve(X.T @ X + lam * np.eye(n_features), X.T @ y)

# Préparer la grille pour les contours RSS
theta1_range = np.linspace(-0.5, 3, 100)
theta2_range = np.linspace(-1.5, 2, 100)
T1, T2 = np.meshgrid(theta1_range, theta2_range)

# Calculer RSS pour chaque point de la grille
RSS = np.zeros_like(T1)
for i in range(T1.shape[0]):
    for j in range(T1.shape[1]):
        theta = np.array([T1[i, j], T2[i, j]])
        residuals = y - X @ theta
        RSS[i, j] = np.sum(residuals**2)

# Créer la figure avec trois panneaux
fig = plt.figure(figsize=(15, 5))

# === Panneau 1: Données et droite ajustée ===
ax1 = fig.add_subplot(1, 3, 1)

# Données
ax1.scatter(x, y, c='tab:blue', s=50, alpha=0.7, label='Données', zorder=3)

# Grille pour tracer les droites
x_grid = np.linspace(-2.5, 2.5, 100)

# Droite MCO (fixe) - on utilise seulement theta1 car x et x2 sont très corrélés
# La prédiction effective est environ (theta1 + 0.9*theta2) * x
slope_ols = theta_ols[0] + 0.9 * theta_ols[1]  # Pente effective
y_ols = slope_ols * x_grid
ax1.plot(x_grid, y_ols, 'k-', linewidth=2, alpha=0.7, label='MCO')

# Droite Ridge (animée)
line_ridge, = ax1.plot([], [], '-', color='tab:orange', linewidth=2.5, label='Ridge')

# Ligne horizontale (prédiction = moyenne, lambda infini)
y_mean = np.mean(y)
ax1.axhline(y_mean, color='gray', linestyle=':', alpha=0.5, label=f'Moyenne ($\\lambda \\to \\infty$)')

ax1.set_xlabel('$x$')
ax1.set_ylabel('$y$')
ax1.set_title('Données et droite de régression')
ax1.legend(loc='upper left', fontsize=9)
ax1.grid(True, alpha=0.3)
ax1.set_xlim(-2.5, 2.5)
ax1.set_ylim(-4, 5)

# Texte pour les coefficients
coef_text = ax1.text(0.98, 0.02, '', transform=ax1.transAxes, fontsize=10,
                     ha='right', va='bottom',
                     bbox=dict(boxstyle='round', facecolor='white', alpha=0.8))

# === Panneau 2: Paysage de perte ===
ax2 = fig.add_subplot(1, 3, 2)

# Contours RSS (ellipses centrées sur OLS)
levels = np.percentile(RSS.flatten(), [5, 15, 30, 50, 70, 85, 95])
contours = ax2.contour(T1, T2, RSS, levels=levels, colors='gray', alpha=0.6)
ax2.clabel(contours, inline=True, fontsize=8, fmt='%.0f')

# Solution MCO (fixe)
ax2.plot(theta_ols[0], theta_ols[1], 'ko', markersize=12, label='MCO', zorder=5)
ax2.annotate('MCO', xy=(theta_ols[0], theta_ols[1]),
             xytext=(theta_ols[0] + 0.2, theta_ols[1] + 0.2),
             fontsize=11, ha='left')

# Origine = coefficients nuls (prédiction constante)
ax2.plot(0, 0, 'k+', markersize=15, markeredgewidth=2, zorder=4)
ax2.annotate('$\\boldsymbol{\\theta} = 0$\n(pente nulle)', xy=(0, 0),
             xytext=(-0.4, -1.2), fontsize=9, ha='center', color='gray')

# Cercle de contrainte Ridge (animé)
circle_ridge = Circle((0, 0), radius=np.linalg.norm(theta_ols),
                       fill=False, edgecolor='tab:orange', linewidth=2.5,
                       linestyle='-', alpha=0.8, zorder=3)
ax2.add_patch(circle_ridge)

# Solution Ridge (animée)
point_ridge, = ax2.plot([], [], 'o', color='tab:orange', markersize=10,
                        label='Ridge', zorder=6)

# Chemin de régularisation
lambda_path = np.logspace(-3, 1.5, 50)
theta_path = np.array([ridge_solution(X, y, l) for l in lambda_path])
ax2.plot(theta_path[:, 0], theta_path[:, 1], 'tab:orange', linewidth=1.5,
         alpha=0.4, linestyle='--', label='Chemin')

ax2.set_xlabel('$\\theta_1$')
ax2.set_ylabel('$\\theta_2$')
ax2.set_title('Paysage RSS et chemin de régularisation')
ax2.legend(loc='upper right', fontsize=9)
ax2.grid(True, alpha=0.3)
ax2.set_xlim(-0.5, 3)
ax2.set_ylim(-1.5, 2)
ax2.set_aspect('equal')

# Texte pour lambda
lambda_text = ax2.text(0.02, 0.98, '', transform=ax2.transAxes, fontsize=11,
                       va='top', ha='left',
                       bbox=dict(boxstyle='round', facecolor='white', alpha=0.9))

# === Panneau 3: Facteurs de rétrécissement ===
ax3 = fig.add_subplot(1, 3, 3)

lambda_range = np.linspace(0, 10, 200)
shrink1_curve = d_svd[0]**2 / (d_svd[0]**2 + lambda_range)
shrink2_curve = d_svd[1]**2 / (d_svd[1]**2 + lambda_range)

ax3.plot(lambda_range, shrink1_curve, 'b-', linewidth=2,
         label=f'Direction forte ($d_1={d_svd[0]:.1f}$)')
ax3.plot(lambda_range, shrink2_curve, 'r-', linewidth=2,
         label=f'Direction faible ($d_2={d_svd[1]:.2f}$)')

# Zone de surapprentissage et sous-apprentissage
ax3.axvspan(0, 0.5, alpha=0.1, color='red', label='Surapprentissage')
ax3.axvspan(5, 10, alpha=0.1, color='blue', label='Sous-apprentissage')

point_shrink1, = ax3.plot([], [], 'bo', markersize=10, zorder=3)
point_shrink2, = ax3.plot([], [], 'ro', markersize=10, zorder=3)

ax3.axhline(1.0, color='gray', linestyle='--', alpha=0.5)
ax3.set_xlabel('$\\lambda$')
ax3.set_ylabel('Facteur de rétrécissement')
ax3.set_title('Rétrécissement par direction SVD')
ax3.legend(loc='center right', fontsize=8)
ax3.grid(True, alpha=0.3)
ax3.set_xlim(0, 10)
ax3.set_ylim(0, 1.1)

shrink_text = ax3.text(0.02, 0.5, '', transform=ax3.transAxes, fontsize=10,
                       va='center', ha='left',
                       bbox=dict(boxstyle='round', facecolor='white', alpha=0.8))

plt.tight_layout()

# Fonction d'animation
def animate(frame):
    if frame < 80:
        lam = (frame / 80) * 10
    else:
        lam = 10

    # Solution Ridge
    theta_ridge = ridge_solution(X, y, lam)

    # Panneau 1: Mettre à jour la droite
    slope_ridge = theta_ridge[0] + 0.9 * theta_ridge[1]
    y_ridge = slope_ridge * x_grid
    line_ridge.set_data(x_grid, y_ridge)
    coef_text.set_text(f'Pente MCO: {slope_ols:.2f}\nPente Ridge: {slope_ridge:.2f}')

    # Panneau 2: Mettre à jour le cercle et le point
    norm_ridge = np.linalg.norm(theta_ridge)
    circle_ridge.set_radius(norm_ridge)
    point_ridge.set_data([theta_ridge[0]], [theta_ridge[1]])
    lambda_text.set_text(f'$\\lambda = {lam:.1f}$')

    # Panneau 3: Mettre à jour les points de rétrécissement
    shrink1 = d_svd[0]**2 / (d_svd[0]**2 + lam)
    shrink2 = d_svd[1]**2 / (d_svd[1]**2 + lam)
    point_shrink1.set_data([lam], [shrink1])
    point_shrink2.set_data([lam], [shrink2])
    shrink_text.set_text(f'Facteur dir. 1: {shrink1:.2f}\nFacteur dir. 2: {shrink2:.2f}')

    return (line_ridge, point_ridge, circle_ridge, lambda_text,
            point_shrink1, point_shrink2, coef_text, shrink_text)

# Créer l'animation
anim = FuncAnimation(fig, animate, frames=90, interval=80, blit=False, repeat=True)
anim.save('_static/ridge_geometry.gif', writer='pillow', fps=12, dpi=100)
plt.close()

# Afficher le GIF
Image(filename='_static/ridge_geometry.gif')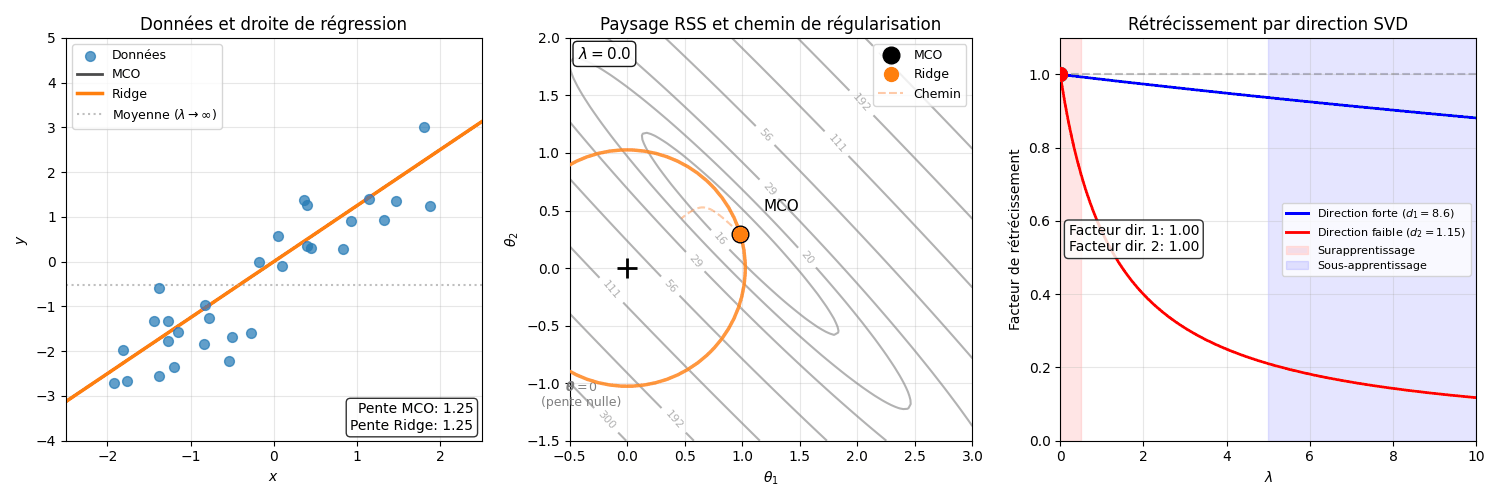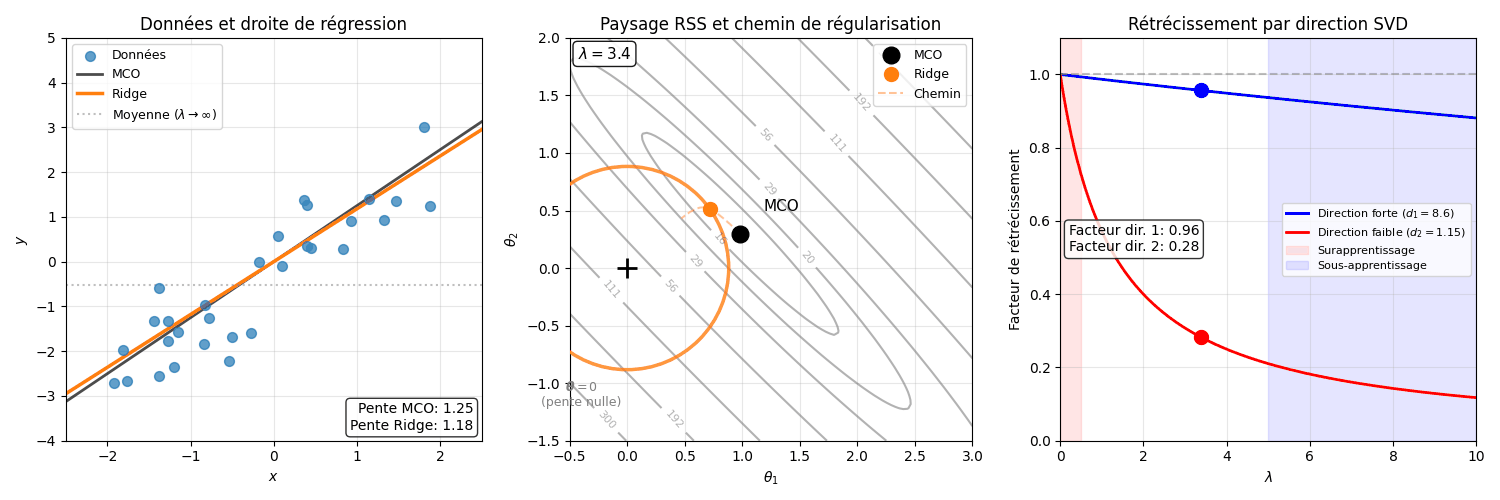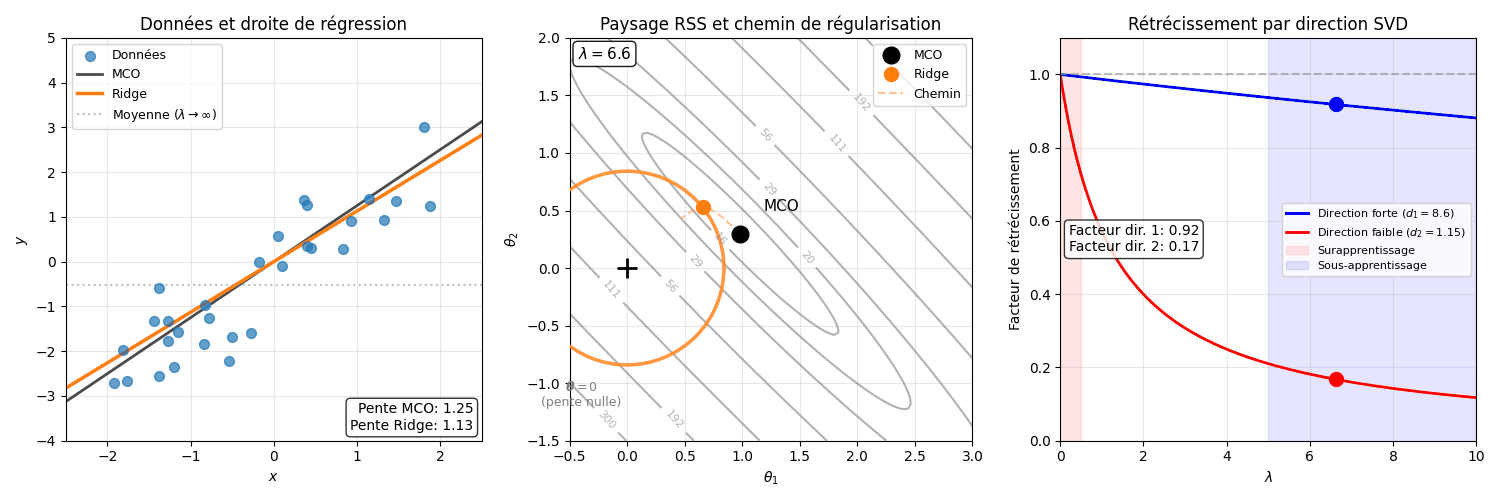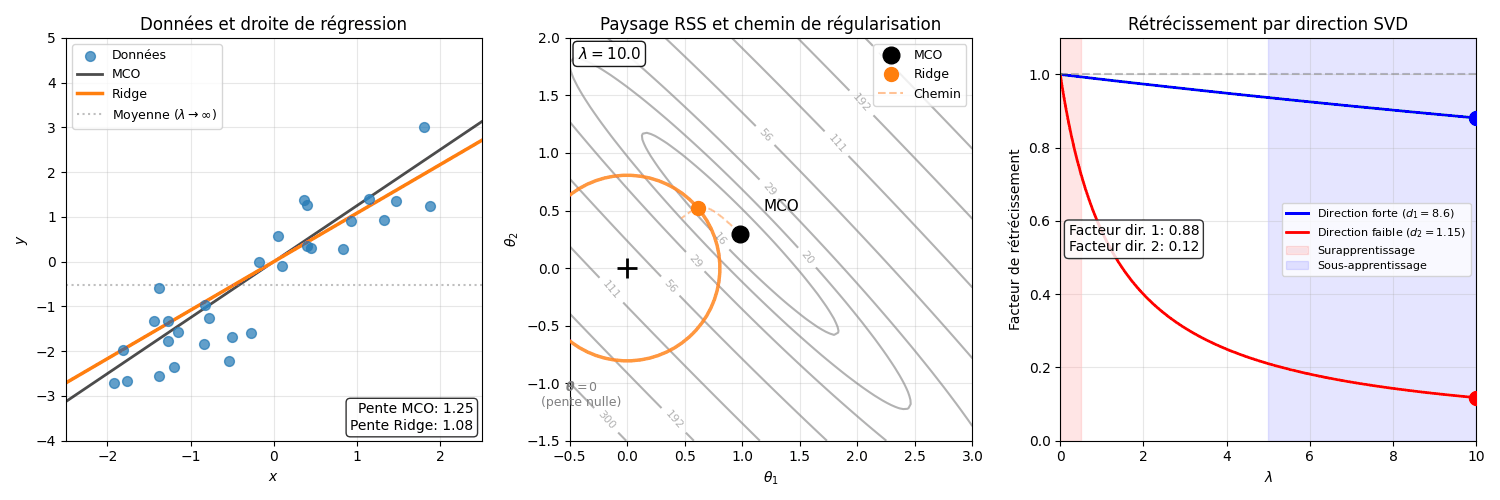
L’animation relie trois perspectives sur la régularisation Ridge lorsque augmente de 0 à 10:
Panneau de gauche (données et ajustement): Les points bleus sont les données d’entraînement. La droite noire est l’ajustement MCO (), la droite orange est l’ajustement Ridge. À mesure que augmente, la pente de la droite Ridge diminue, se rapprochant de la ligne horizontale (prédiction constante égale à la moyenne). C’est le rétrécissement vers zéro: Ridge “tire” les coefficients vers l’origine, ce qui réduit la pente.
Panneau central (paysage de perte): Chaque point de ce plan représente un choix de coefficients . Les contours gris montrent la fonction de coût RSS: plus on est proche du point noir (MCO), plus l’erreur sur les données d’entraînement est faible. L’ellipse est allongée car et sont corrélées (colinéarité). L’origine correspond à une pente nulle (prédiction constante). Le cercle orange montre la norme de la solution Ridge courante . La formulation pénalisée est équivalente à la formulation contrainte sous , où joue le rôle du multiplicateur de Lagrange: pour chaque , il existe un tel que les deux problèmes ont la même solution. À mesure que augmente, la solution se déplace le long du chemin de régularisation vers l’origine.
Panneau de droite (rétrécissement différencié): La direction “forte” (grande valeur singulière , où les données sont dispersées) est peu affectée par la régularisation. La direction “faible” (petite valeur singulière , direction de colinéarité) est rétrécit beaucoup plus rapidement. C’est le cœur de l’effet Ridge: pénaliser davantage les directions où le signal est faible et l’estimation instable.
L’intuition géométrique est la suivante: quand les données sont colinéaires, l’ellipse RSS est très allongée. De petites perturbations dans les données causent de grands déplacements de la solution MCO le long de l’axe allongé. La pénalité Ridge ajoute un terme qui « tire » la solution vers l’origine. Dans la formulation contrainte équivalente, cela correspond à chercher le minimum de RSS à l’intérieur d’une boule de rayon . Plus la boule est petite (plus est grand), plus la solution est proche de l’origine et donc plus stable.
Résumé
Ce chapitre a développé les outils fondamentaux pour la régression linéaire:
Les moindres carrés ordinaires (MCO) minimisent la somme des carrés des résidus et admettent une solution analytique: .
La décomposition en valeurs singulières (SVD) offre une interprétation géométrique: MCO amplifie le bruit le long des directions de faibles valeurs singulières.
La régularisation Ridge ajoute une pénalité qui rétrécit les coefficients vers zéro, avec un rétrécissement différencié: les directions faibles sont pénalisées plus fortement.
Il faut distinguer deux types de variance: la variance des données (dispersion, ) et la variance d’estimation (incertitude, ). Ridge réduit la variance d’estimation.
Le spectre des valeurs singulières révèle la structure des données et permet de distinguer signal et bruit.
Nous avons vu comment résoudre la régression. Mais la régression n’est qu’un type de problème supervisé. Le chapitre suivant aborde la classification linéaire, où la sortie est une catégorie plutôt qu’un nombre réel.
Applications supplémentaires
Cette section présente deux applications supplémentaires de la régression linéaire à des domaines d’ingénierie: la modélisation thermique des bâtiments et la production hydroélectrique. Ces exemples illustrent comment la connaissance physique guide la construction de modèles.
Modélisation thermique d’un bâtiment (HVAC)
La prédiction de la température intérieure d’un bâtiment est cruciale pour l’optimisation énergétique et le confort des occupants. Les données proviennent du Oak Ridge National Laboratory (ORNL), mesurées dans un bâtiment commercial expérimental sous différentes conditions de chauffage et climatisation.
Analogie avec un circuit RC. Le comportement thermique d’un bâtiment est analogue à celui d’un circuit électrique résistance-condensateur (RC). La résistance thermique correspond à l’isolation: un mur bien isolé résiste au flux de chaleur comme une grande résistance électrique limite le courant. La capacitance thermique correspond à la masse thermique (béton, meubles, air): elle stocke la chaleur comme un condensateur stocke la charge. La différence de température entre l’intérieur et l’extérieur joue le rôle de la tension: elle « pousse » le flux de chaleur à travers l’enveloppe. La constante de temps gouverne la vitesse de réponse du bâtiment aux changements de conditions extérieures. Un bâtiment massif avec bonne isolation (grand ) réagit lentement; une construction légère mal isolée (petit ) suit rapidement les fluctuations extérieures.
Le modèle thermique simplifié d’un bâtiment s’écrit:
où est la température intérieure, la température extérieure, le setpoint du thermostat, et le rayonnement solaire incident.
Source
import numpy as np
import matplotlib.pyplot as plt

# Simuler des données HVAC réalistes (inspirées des données ORNL)
np.random.seed(42)
n_hours = 24 * 30  # Un mois de données horaires

# Variables explicatives
hour = np.arange(n_hours) % 24
day = np.arange(n_hours) // 24

# Température extérieure: cycle journalier + tendance saisonnière
T_ext = 15 + 8 * np.sin(2 * np.pi * hour / 24 - np.pi/2) + 0.1 * day + np.random.normal(0, 2, n_hours)

# Rayonnement solaire (W/m²): nul la nuit, pic à midi
solar = np.maximum(0, 600 * np.sin(np.pi * (hour - 6) / 12)) * (hour >= 6) * (hour <= 18)
solar = solar + np.random.normal(0, 30, n_hours) * (solar > 0)
solar = np.maximum(0, solar)

# Consigne: 21°C le jour (8h-18h), 18°C la nuit
setpoint = np.where((hour >= 8) & (hour <= 18), 21.0, 18.0)

# Modèle physique simplifié pour la température intérieure
# T_int = alpha * T_ext + beta * setpoint + gamma * solar + bruit
alpha = 0.15  # Effet de la température extérieure (isolation)
beta = 0.80   # Effet de la consigne (efficacité du système HVAC)
gamma = 0.005 # Effet du rayonnement solaire (gains solaires)

T_int_true = 5 + alpha * T_ext + beta * setpoint + gamma * solar
T_int = T_int_true + np.random.normal(0, 0.5, n_hours)

# Construire la matrice de design
X_hvac = np.column_stack([np.ones(n_hours), T_ext, setpoint, solar])

# Solution MCO
theta_hvac = np.linalg.lstsq(X_hvac, T_int, rcond=None)[0]
T_int_pred = X_hvac @ theta_hvac

# Visualisation
fig, axes = plt.subplots(2, 2, figsize=(12, 8))

# Panneau 1: Températures sur 3 jours
ax = axes[0, 0]
idx = slice(0, 72)  # 3 premiers jours
hours_plot = np.arange(72)
ax.plot(hours_plot, T_ext[idx], 'b-', alpha=0.7, label='$T_{ext}$')
ax.plot(hours_plot, T_int[idx], 'r-', alpha=0.7, label='$T_{int}$ (mesuré)')
ax.plot(hours_plot, T_int_pred[idx], 'k--', alpha=0.7, label='$T_{int}$ (prédit)')
ax.plot(hours_plot, setpoint[idx], 'g:', alpha=0.7, label='Consigne')
ax.set_xlabel('Heure')
ax.set_ylabel('Température (°C)')
ax.set_title('Évolution des températures (3 jours)')
ax.legend(loc='upper right', fontsize=8)
ax.set_xlim(0, 72)

# Panneau 2: Coefficients
ax = axes[0, 1]
coef_names = ['Biais', '$T_{ext}$', 'Consigne', 'Solaire']
colors = ['gray', 'blue', 'green', 'orange']
bars = ax.bar(coef_names, theta_hvac, color=colors, alpha=0.7)
ax.axhline(0, color='black', linewidth=0.5)
ax.set_ylabel('Coefficient')
ax.set_title('Coefficients du modèle thermique')

# Annoter avec les vraies valeurs
true_coefs = [5, alpha, beta, gamma]
for i, (bar, true_val) in enumerate(zip(bars, true_coefs)):
    ax.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.02,
            f'vrai: {true_val}', ha='center', fontsize=9, color='red')

# Panneau 3: Prédiction vs réalité
ax = axes[1, 0]
ax.scatter(T_int, T_int_pred, alpha=0.2, s=5)
ax.plot([16, 24], [16, 24], 'k--', alpha=0.5)
ax.set_xlabel('$T_{int}$ mesuré (°C)')
ax.set_ylabel('$T_{int}$ prédit (°C)')
mse_hvac = np.mean((T_int - T_int_pred)**2)
ax.set_title(f'Prédiction vs Réalité (EQM = {mse_hvac:.3f})')
ax.set_aspect('equal')

# Panneau 4: Résidus vs heure
ax = axes[1, 1]
residuals_hvac = T_int - T_int_pred
ax.scatter(hour, residuals_hvac, alpha=0.2, s=5)
ax.axhline(0, color='black', linewidth=0.5)
ax.set_xlabel('Heure du jour')
ax.set_ylabel('Résidu (°C)')
ax.set_title('Résidus par heure: y a-t-il un pattern?')

# Moyenne par heure
mean_resid_hour = [residuals_hvac[hour == h].mean() for h in range(24)]
ax.plot(range(24), mean_resid_hour, 'r-', linewidth=2, label='Moyenne')
ax.legend()

plt.tight_layout()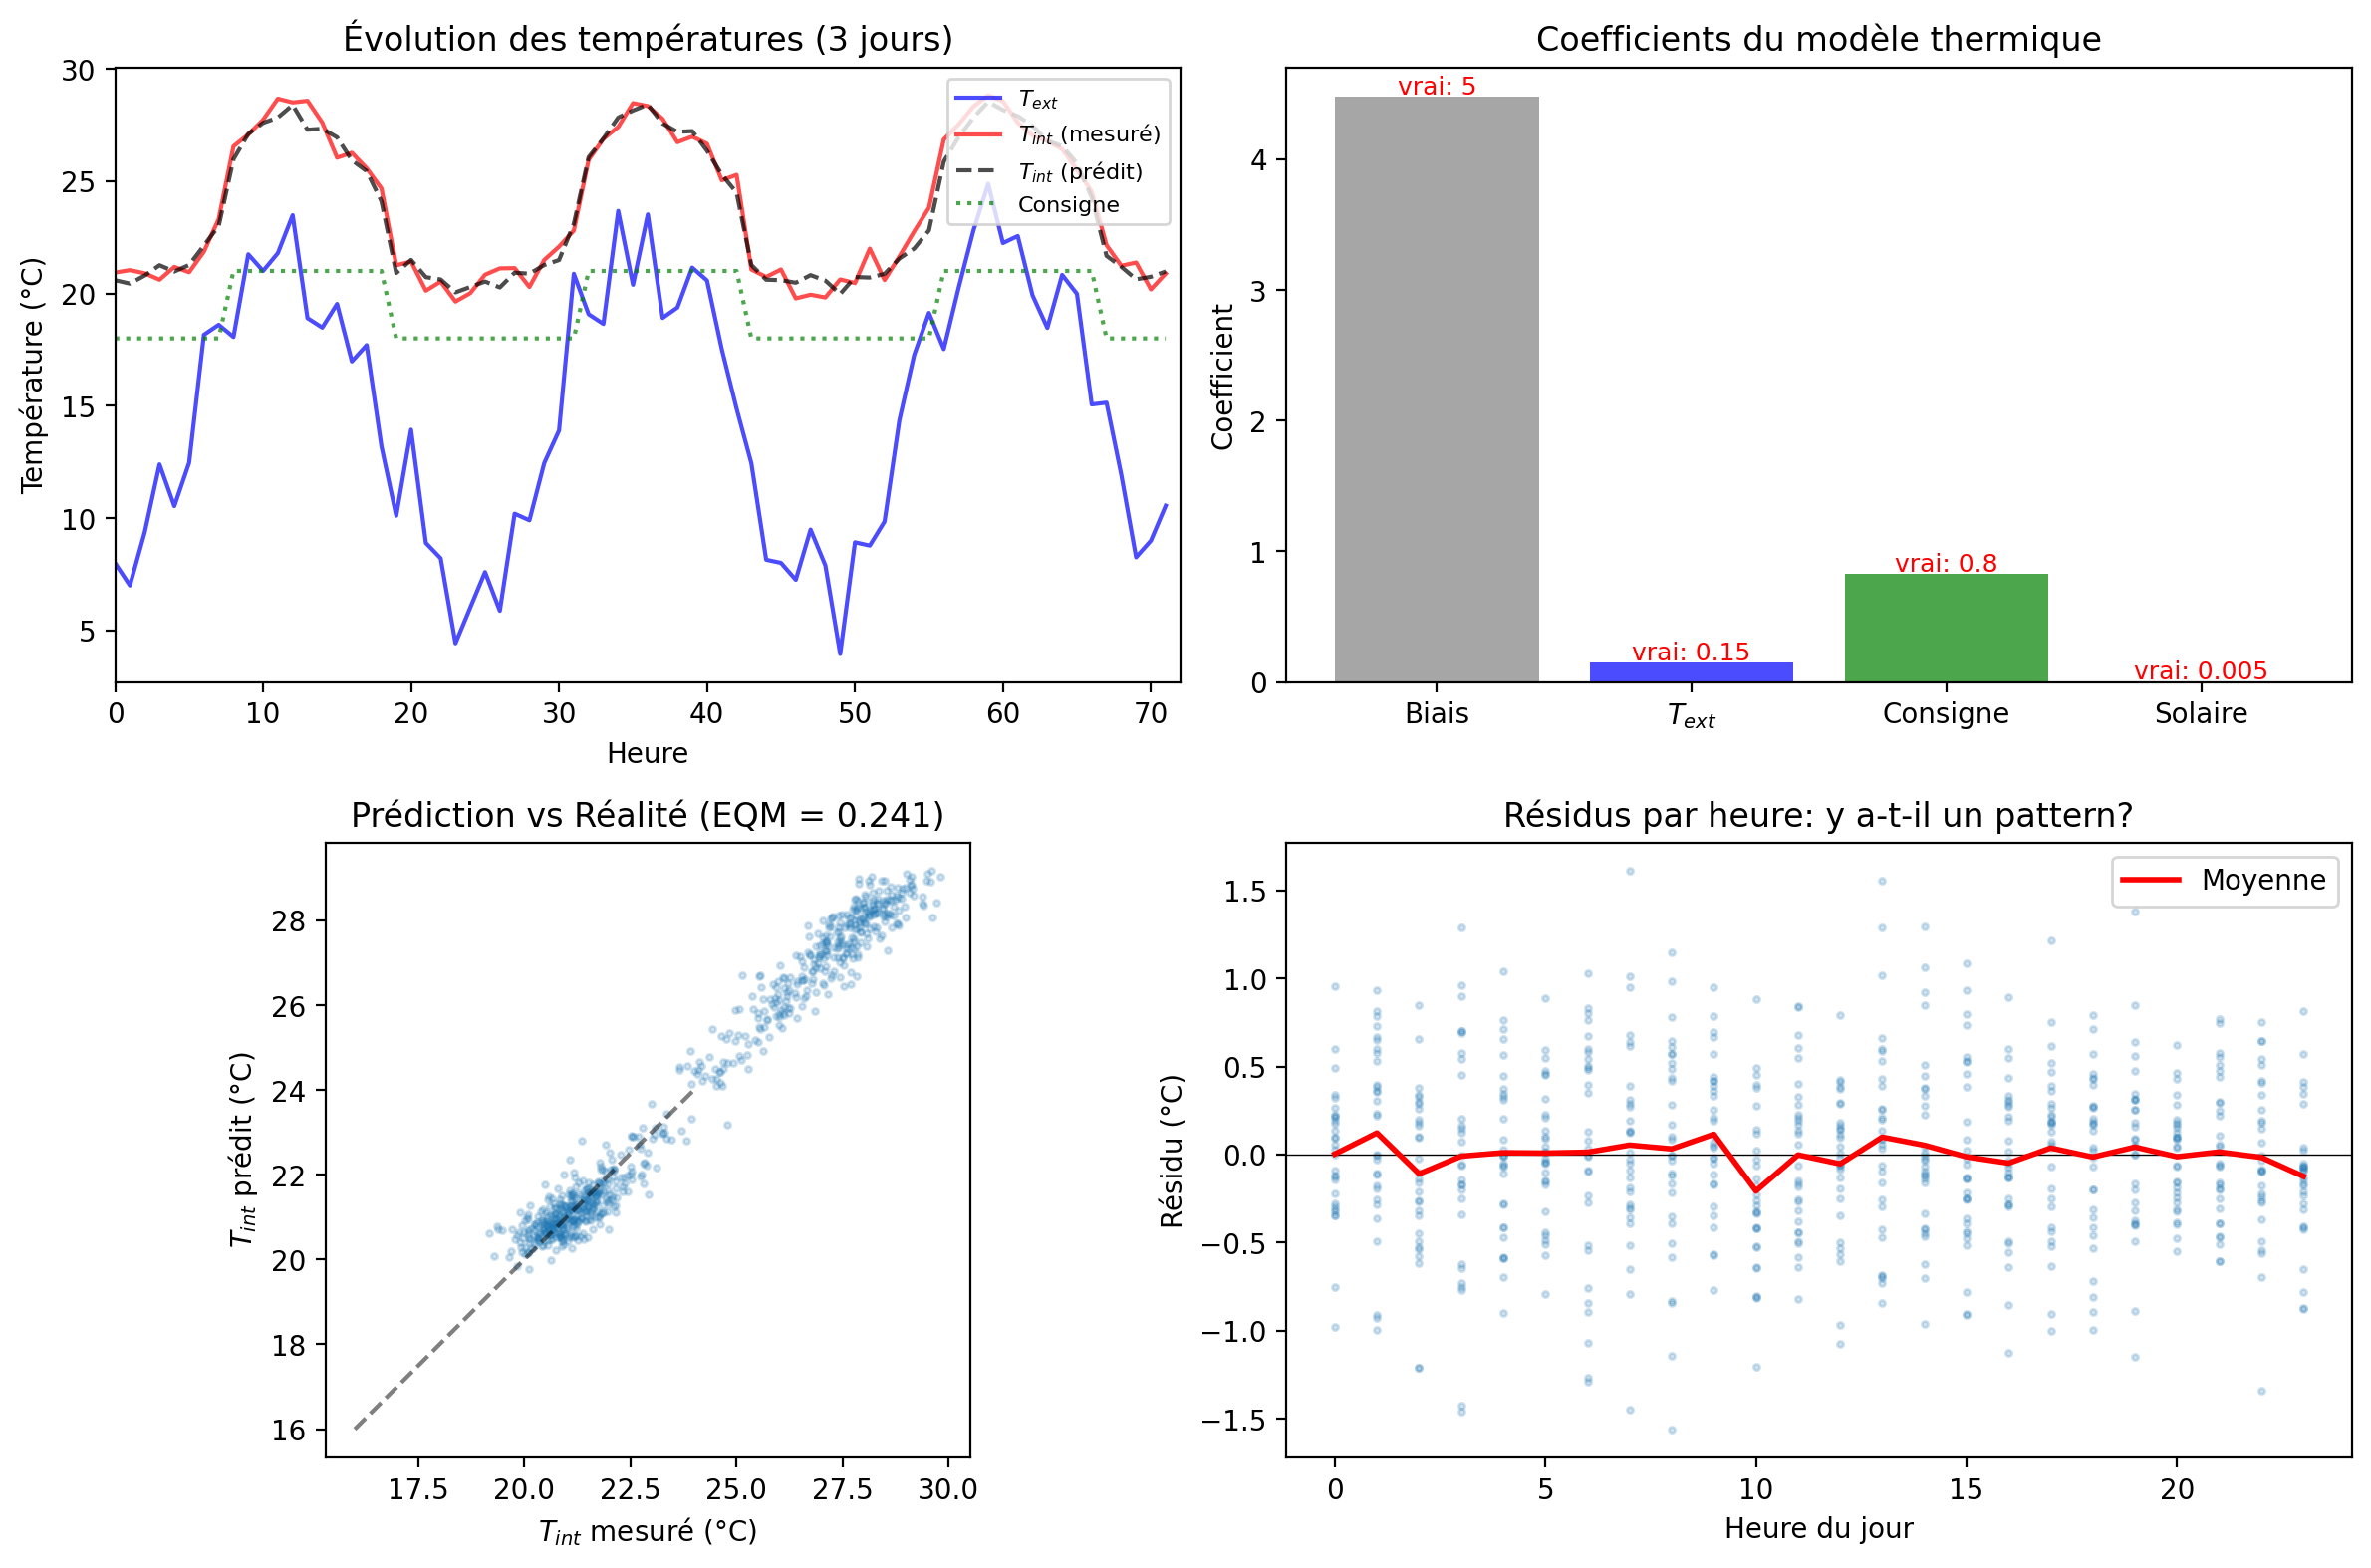
Les coefficients estimés révèlent la physique du bâtiment:
: l’isolation atténue l’effet de la température extérieure
: le système HVAC maintient efficacement la consigne
: les gains solaires contribuent modestement au chauffage
Production hydroélectrique
La puissance d’une centrale hydroélectrique est gouvernée par une équation physique fondamentale:
où est la puissance (W), l’efficacité de la turbine, la densité de l’eau (1000 kg/m³), l’accélération gravitationnelle (9.81 m/s²), le débit (m³/s), et la hauteur de chute (m).
En prenant le logarithme des deux côtés:
C’est un modèle log-linéaire: la régression linéaire dans l’espace logarithmique permet d’estimer l’efficacité moyenne des turbines.
Source
import numpy as np
import matplotlib.pyplot as plt

# Simuler des données de centrales hydroélectriques (inspirées de GloHydroRes)
np.random.seed(123)
n_plants = 500

# Types de centrales: au fil de l'eau (run-of-river) vs réservoir
plant_type = np.random.choice(['Fil de l\'eau', 'Réservoir'], n_plants, p=[0.6, 0.4])

# Hauteur de chute (m): log-normale, plus élevée pour les barrages
H = np.where(plant_type == 'Réservoir',
             np.exp(np.random.normal(4.5, 0.8, n_plants)),  # ~90m médian
             np.exp(np.random.normal(3.0, 0.7, n_plants)))  # ~20m médian
H = np.clip(H, 5, 500)

# Débit (m³/s): corrélé inversement à la hauteur (grands fleuves = faible chute)
log_Q = 5 - 0.3 * np.log(H) + np.random.normal(0, 0.8, n_plants)
Q = np.exp(log_Q)
Q = np.clip(Q, 1, 5000)

# Efficacité: varie entre 0.80 et 0.95
eta = 0.85 + 0.05 * np.random.randn(n_plants)
eta = np.clip(eta, 0.75, 0.95)

# Puissance installée (MW)
rho, g = 1000, 9.81
P_true = eta * rho * g * Q * H / 1e6  # En MW
P = P_true * np.exp(np.random.normal(0, 0.1, n_plants))  # Bruit multiplicatif

# Régression log-linéaire
log_P = np.log(P)
log_Q_col = np.log(Q)
log_H_col = np.log(H)

X_hydro = np.column_stack([np.ones(n_plants), log_Q_col, log_H_col])
theta_hydro = np.linalg.lstsq(X_hydro, log_P, rcond=None)[0]
log_P_pred = X_hydro @ theta_hydro

# Visualisation
fig, axes = plt.subplots(1, 3, figsize=(14, 4.5))

# Panneau 1: P vs Q*H (échelle log-log)
ax = axes[0]
QH = Q * H
colors = np.where(plant_type == 'Réservoir', 'tab:blue', 'tab:orange')
ax.scatter(QH, P, c=colors, alpha=0.5, s=20)
ax.set_xscale('log')
ax.set_yscale('log')

# Ligne théorique P = eta * rho * g * Q * H
QH_line = np.logspace(1, 7, 100)
P_line = 0.85 * rho * g * QH_line / 1e6
ax.plot(QH_line, P_line, 'k--', linewidth=2, label='Théorique ($\\eta = 0.85$)')

ax.set_xlabel('$Q \\times H$ (m$^4$/s)')
ax.set_ylabel('Puissance installée (MW)')
ax.set_title('Relation puissance-débit-hauteur')
ax.legend()

# Légende des types
from matplotlib.patches import Patch
legend_elements = [Patch(facecolor='tab:blue', alpha=0.5, label='Réservoir'),
                   Patch(facecolor='tab:orange', alpha=0.5, label='Fil de l\'eau')]
ax.legend(handles=legend_elements, loc='upper left')

# Panneau 2: Résidus log vs prédiction
ax = axes[1]
residuals_log = log_P - log_P_pred
ax.scatter(log_P_pred, residuals_log, alpha=0.3, s=15)
ax.axhline(0, color='black', linewidth=0.5)
ax.set_xlabel('$\\log P$ prédit')
ax.set_ylabel('Résidu (log)')
ax.set_title('Résidus en échelle logarithmique')

# Panneau 3: Coefficients vs théorie
ax = axes[2]
coef_names = ['$\\log(\\eta \\rho g)$', '$\\beta_Q$', '$\\beta_H$']
true_coefs = [np.log(0.85 * rho * g / 1e6), 1.0, 1.0]
estimated_coefs = theta_hydro

x_pos = np.arange(3)
width = 0.35
bars1 = ax.bar(x_pos - width/2, true_coefs, width, label='Théorique', color='tab:green', alpha=0.7)
bars2 = ax.bar(x_pos + width/2, estimated_coefs, width, label='Estimé (MCO)', color='tab:blue', alpha=0.7)

ax.set_xticks(x_pos)
ax.set_xticklabels(coef_names)
ax.set_ylabel('Valeur du coefficient')
ax.set_title('Coefficients: théorie vs estimation')
ax.legend()
ax.axhline(0, color='black', linewidth=0.5)

plt.tight_layout()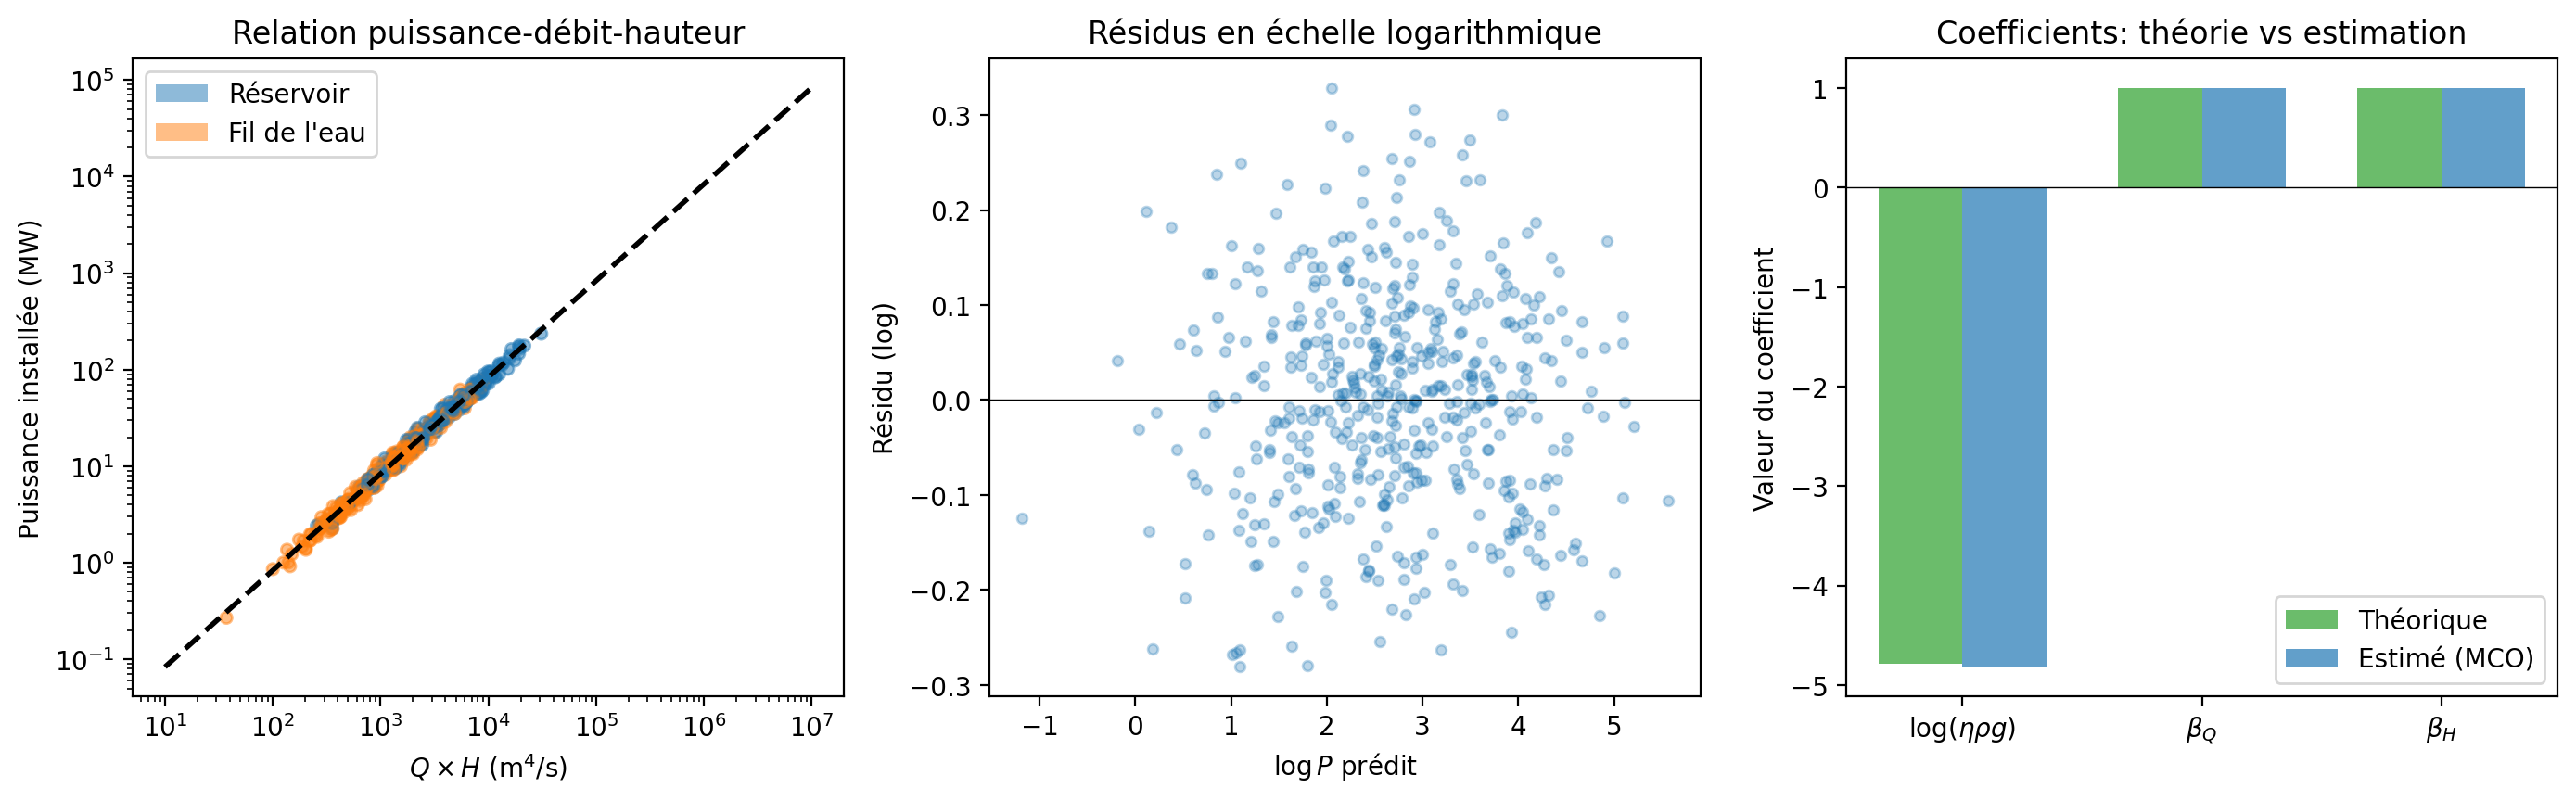
La physique prédit (relation linéaire en log-log). Les coefficients estimés sont proches de 1, validant le modèle physique. L’ordonnée à l’origine permet d’estimer l’efficacité moyenne:
Exercices
Exercice 1: Dérivation des moindres carrés ordinaires ★
Soit un problème de régression linéaire simple avec observations:
Écrivez la somme des carrés des résidus .
Calculez les dérivées partielles et .
En posant ces dérivées égales à zéro, résolvez le système d’équations pour obtenir les estimateurs et .
Application numérique: Pour les données , calculez les coefficients MCO et , puis la prédiction pour .
Solution Exercice 1
Exercice 2: Régression ridge et colinéarité ★★
La colinéarité entre les caractéristiques rend la matrice mal conditionnée, ce qui peut déstabiliser la solution MCO.
Générez des données avec deux caractéristiques presque colinéaires:
np.random.seed(42)
n = 30
x1 = np.random.randn(n)
x2 = x1 + 0.01 * np.random.randn(n)  # x2 ≈ x1
y = 2*x1 + 3*x2 + 0.5*np.random.randn(n)
Calculez le nombre de conditionnement de (avec
np.linalg.cond). Que signifie un grand nombre de conditionnement?Ajustez un modèle MCO. Les coefficients et sont-ils proches des vraies valeurs (2 et 3)?
Ajustez des modèles Ridge pour . Comment les coefficients évoluent-ils?
Tracez le «chemin de régularisation»: les coefficients en fonction de .
Solution Exercice 2
Génération des données: (code fourni dans l’énoncé)
Nombre de conditionnement:
X = np.column_stack([np.ones(n), x1, x2])
cond = np.linalg.cond(X.T @ X)
print(f"Conditionnement: {cond:.0f}")
Le nombre de conditionnement est très élevé (de l’ordre de 106 ou plus). Cela signifie que de petites perturbations dans les données peuvent causer de grandes variations dans la solution. La matrice est proche d’être singulière.
Modèle MCO:
theta_ols = np.linalg.solve(X.T @ X, X.T @ y)Les coefficients MCO sont très instables: et peuvent être très différents de 2 et 3, et parfois de signes opposés avec de grandes magnitudes. Le modèle «distribue» l’effet entre les deux variables de manière arbitraire.
Modèles Ridge:
from sklearn.linear_model import Ridge
for lam in [0.01, 0.1, 1, 10]:
    model = Ridge(alpha=lam, fit_intercept=True)
    model.fit(np.column_stack([x1, x2]), y)
    print(f"λ={lam}: θ1={model.coef_[0]:.2f}, θ2={model.coef_[1]:.2f}")
Avec croissant, les coefficients se rapprochent de zéro et deviennent plus stables. Les deux coefficients convergent vers des valeurs similaires (autour de 2,5 chacun), ce qui reflète mieux la symétrie du problème.
Chemin de régularisation:
lambdas = np.logspace(-3, 2, 50)
coefs = []
for lam in lambdas:
    model = Ridge(alpha=lam, fit_intercept=True)
    model.fit(np.column_stack([x1, x2]), y)
    coefs.append(model.coef_)
coefs = np.array(coefs)

plt.plot(np.log10(lambdas), coefs[:, 0], label='θ1')
plt.plot(np.log10(lambdas), coefs[:, 1], label='θ2')
plt.xlabel('log10(λ)')
plt.ylabel('Coefficients')
plt.legend()
On observe que pour petit, les coefficients sont instables et peuvent être extrêmes. Pour grand, ils convergent vers zéro. Il existe une zone intermédiaire où les coefficients sont raisonnables.
Exercice 3: Homoscédasticité et hétéroscédasticité ★★
En régression, l’homoscédasticité suppose que la variance du bruit est constante: . L’hétéroscédasticité suppose que la variance dépend de .
Générez deux jeux de données (, ):
Homoscédastique: avec
Hétéroscédastique: avec
Visualisez les deux jeux de données. Quelle différence observez-vous?
Ajustez un modèle linéaire sur chaque jeu. Les coefficients sont-ils similaires?
Tracez les résidus en fonction de pour les deux cas. Que remarquez-vous?
Pourquoi l’hétéroscédasticité peut-elle être problématique pour l’inférence statistique (intervalles de confiance, tests)?
Solution Exercice 3
Génération des données:
np.random.seed(42)
x = np.random.uniform(0, 10, 100)

# Homoscédastique
y_homo = 2*x + np.random.normal(0, 1, 100)

# Hétéroscédastique
y_hetero = 2*x + np.random.normal(0, 0.3*x, 100)
Visualisation:
Dans le cas homoscédastique, les points sont dispersés uniformément autour de la droite sur toute la plage de . Dans le cas hétéroscédastique, la dispersion augmente avec : les points sont serrés près de et très dispersés pour les grandes valeurs de .
Coefficients:
Les coefficients MCO sont similaires dans les deux cas (proches de , ). MCO reste non biaisé sous hétéroscédasticité, mais n’est plus optimal (pas de variance minimale).
Résidus:
Homoscédastique: les résidus sont répartis uniformément autour de zéro, avec une dispersion constante.
Hétéroscédastique: les résidus montrent un «cône» ou «éventail» (fan shape): la dispersion augmente avec . C’est le signe classique d’hétéroscédasticité.
Problèmes d’inférence:
Les erreurs standard des coefficients sont incorrectes: elles supposent une variance constante.
Les intervalles de confiance et tests t ne sont pas valides.
Les tests de significativité peuvent être trop optimistes ou trop pessimistes.
Solution: utiliser des erreurs standard robustes (Huber-White) ou des moindres carrés pondérés.
Exercice 4: SVD et facteurs de rétrécissement ★★★
La décomposition en valeurs singulières (SVD) de révèle pourquoi Ridge «rétrécit» les coefficients de manière différenciée.
Pour la matrice de données suivante, calculez la SVD :
Vérifiez que (les colonnes de sont les vecteurs propres de ).
Pour , calculez les facteurs de rétrécissement pour chaque direction .
Expliquez pourquoi la direction avec la plus petite valeur singulière est plus fortement rétrécée.
Tracez les facteurs de rétrécissement et en fonction de pour .
Solution Exercice 4
SVD:
X = np.array([[2, 1], [2, 2], [2, 3]])
U, d, Vt = np.linalg.svd(X, full_matrices=False)
V = Vt.T
D = np.diag(d)
Résultat (approximatif):
,
,
Vérification:
XtX = X.T @ X
VD2Vt = V @ D**2 @ V.T
np.allclose(XtX, VD2Vt)  # True
On peut aussi vérifier que les valeurs propres de sont et .
Facteurs de rétrécissement pour λ = 1:
Explication:
La direction 2 a une petite valeur singulière (), ce qui signifie que les données varient peu dans cette direction. L’information est donc «faible» et potentiellement bruitée. Ridge pénalise plus fortement cette direction ( vs ) pour éviter d’ajuster le bruit.
En termes de conditionnement: le rapport indique que la matrice est mal conditionnée. Ridge améliore ce conditionnement en réduisant l’effet des petites valeurs singulières.
Visualisation:
lambdas = np.linspace(0, 10, 100)
s1 = d[0]**2 / (d[0]**2 + lambdas)
s2 = d[1]**2 / (d[1]**2 + lambdas)

plt.plot(lambdas, s1, label=f's1 (d1={d[0]:.2f})')
plt.plot(lambdas, s2, label=f's2 (d2={d[1]:.2f})')
plt.xlabel('λ')
plt.ylabel('Facteur de rétrécissement')
plt.legend()
On observe que reste proche de 1 même pour modéré, tandis que décroît rapidement. C’est le rétrécissement différencié de Ridge.
Exercice 5: Conditionnement et stabilité numérique ★★★
Le nombre de conditionnement mesure la sensibilité de la solution d’un système linéaire aux perturbations.
Pour une matrice symétrique définie positive, où sont les valeurs propres.
Calculez le nombre de conditionnement de pour:
Résolvez le système pour .
Perturbez légèrement en et résolvez à nouveau. Comment change la solution?
Montrez que pour Ridge, .
Calculez le conditionnement de la matrice Ridge pour . Comparez avec le cas MCO.
Solution Exercice 5
Conditionnement de X’X:
X = np.array([[1, 1], [1, 1.001], [1, 0.999]])
A = X.T @ X
eigvals = np.linalg.eigvalsh(A)
kappa = eigvals.max() / eigvals.min()
print(f"Conditionnement: {kappa:.0f}")
Le conditionnement est très élevé (de l’ordre de 106) car les colonnes sont presque colinéaires.
Solution MCO:
y = np.array([1, 2, 3])
theta = np.linalg.solve(A, X.T @ y)
La solution peut être numériquement instable.
Perturbation:
y_perturb = np.array([1.01, 2, 3])  # 1% de perturbation sur y[0]
theta_perturb = np.linalg.solve(A, X.T @ y_perturb)
print(f"Changement: {np.linalg.norm(theta_perturb - theta)}")
Une perturbation de 1% sur peut causer un changement de plusieurs centaines de % sur . C’est le signe d’un système mal conditionné.
Conditionnement Ridge:
La matrice Ridge est . Ses valeurs propres sont (où sont les valeurs propres de ).
Pour , le numérateur et le dénominateur sont tous deux augmentés, mais le dénominateur relativement plus (puisque est petit). Le conditionnement diminue.
Comparaison:
lambda_reg = 0.1
A_ridge = A + lambda_reg * np.eye(2)
eigvals_ridge = np.linalg.eigvalsh(A_ridge)
kappa_ridge = eigvals_ridge.max() / eigvals_ridge.min()
print(f"Conditionnement MCO: {kappa:.0f}")
print(f"Conditionnement Ridge: {kappa_ridge:.0f}")
Le conditionnement Ridge est beaucoup plus faible (quelques dizaines au lieu de millions), ce qui rend le système numériquement stable.