Les chapitres précédents ont développé les deux modèles linéaires fondamentaux: la régression (MCO, Ridge) et la classification (régression logistique, entropie croisée). Mais un problème fondamental demeure: comment savoir si notre modèle généralisera bien à de nouvelles données? Ce chapitre explore cette question à travers le compromis biais-variance, les techniques d’expansion de caractéristiques, et les méthodes de sélection de modèle.
Source
import numpy as np
import matplotlib.pyplot as plt

# Configuration pour des figures haute résolution
%config InlineBackend.figure_format = 'retina'
Classes de modèles et expansion de caractéristiques
Les exemples de régularisation du chapitre précédent utilisaient des caractéristiques polynomiales: au lieu de prédire directement à partir de , nous avons construit des caractéristiques et appliqué un modèle linéaire dans cet espace étendu. Cette technique s’appelle l’expansion de caractéristiques et mérite d’être formalisée.
Trois familles de modèles
Situons les modèles linéaires dans une hiérarchie plus large. Nous distinguons trois familles de complexité croissante:
Modèles linéaires: . La sortie est une combinaison linéaire des entrées. Simple, interprétable, mais limité aux relations linéaires.
Modèles à expansion de caractéristiques: , où est une transformation non linéaire fixée à l’avance (par exemple, polynomiale). Le modèle reste linéaire dans les paramètres , ce qui facilite l’optimisation, mais peut capturer des relations non linéaires en . L’espace de redescription a souvent une dimension .
Réseaux de neurones: . Une composition de fonctions non linéaires, chacune avec ses propres paramètres. Contrairement aux modèles à expansion fixe, les réseaux de neurones apprennent la représentation en même temps que les paramètres .
Cette progression capture l’évolution historique du domaine: des modèles linéaires classiques aux méthodes à noyaux (expansion implicite), puis aux réseaux profonds qui apprennent leurs propres représentations. Nous verrons les réseaux de neurones en détail dans les chapitres suivants; concentrons-nous ici sur les deux premières familles.
Expansion de caractéristiques
Pour capturer des relations non linéaires tout en gardant un modèle linéaire dans les paramètres, nous transformons les entrées. En régression polynomiale, nous appliquons une fonction :
La prédiction devient . Le modèle est polynomial en mais linéaire en , ce qui permet d’utiliser les mêmes algorithmes d’optimisation (MCO, Ridge).
Le degré contrôle la capacité du modèle. Avec , nous avons une droite. Avec élevé, le polynôme peut osciller pour passer par tous les points d’entraînement. Avec , nous pouvons interpoler exactement les points: le risque empirique atteint zéro. Mais un polynôme qui passe exactement par les points d’entraînement n’a aucune raison de bien prédire les nouveaux points.
Illustrons ce phénomène avec les données de freinage. Nous ajustons des polynômes de degrés 1, 2, 5 et 15, et comparons leurs erreurs sur les ensembles d’entraînement et de test.
Source
import numpy as np
import matplotlib.pyplot as plt
import warnings

# Suppress polyfit warnings for high-degree polynomials (expected for this demo)
warnings.filterwarnings('ignore', message='Polyfit may be poorly conditioned')

# Données de freinage
speed = np.array([4, 4, 7, 7, 8, 9, 10, 10, 10, 11, 11, 12, 12, 12, 12, 13, 13, 13, 13, 14,
                  14, 14, 14, 15, 15, 15, 16, 16, 17, 17, 17, 18, 18, 18, 18, 19, 19, 19,
                  20, 20, 20, 20, 20, 22, 23, 24, 24, 24, 24, 25], dtype=float)
dist = np.array([2, 10, 4, 22, 16, 10, 18, 26, 34, 17, 28, 14, 20, 24, 28, 26, 34, 34, 46,
                 26, 36, 60, 80, 20, 26, 54, 32, 40, 32, 40, 50, 42, 56, 76, 84, 36, 46,
                 68, 32, 48, 52, 56, 64, 66, 54, 70, 92, 93, 120, 85], dtype=float)

# Train/test split
np.random.seed(42)
indices = np.random.permutation(len(speed))
train_idx, test_idx = indices[:35], indices[35:]
speed_train, dist_train = speed[train_idx], dist[train_idx]
speed_test, dist_test = speed[test_idx], dist[test_idx]

degrees_to_plot = [1, 2, 5, 15]
degrees_eval = range(1, 16)
fig, axes = plt.subplots(2, 2, figsize=(10, 8))

# Pre-compute all errors for the summary plot later
all_train_errors = []
all_test_errors = []
for deg in degrees_eval:
    coeffs = np.polyfit(speed_train, dist_train, deg)
    all_train_errors.append(np.mean((dist_train - np.polyval(coeffs, speed_train))**2))
    all_test_errors.append(np.mean((dist_test - np.polyval(coeffs, speed_test))**2))

for ax, deg in zip(axes.flat, degrees_to_plot):
    # Fit polynomial
    coeffs = np.polyfit(speed_train, dist_train, deg)

    # Predictions
    pred_train = np.polyval(coeffs, speed_train)
    pred_test = np.polyval(coeffs, speed_test)

    # MSE
    mse_train = np.mean((dist_train - pred_train)**2)
    mse_test = np.mean((dist_test - pred_test)**2)

    # Plot
    ax.scatter(speed_train, dist_train, alpha=0.6, s=30, label='Entraînement')
    ax.scatter(speed_test, dist_test, alpha=0.6, s=30, marker='s', label='Test')

    speed_grid = np.linspace(3, 26, 200)
    pred_grid = np.polyval(coeffs, speed_grid)
    # Clip extreme predictions for visualization
    pred_grid = np.clip(pred_grid, -50, 200)
    ax.plot(speed_grid, pred_grid, 'k-', alpha=0.7)

    ax.set_xlim(3, 26)
    ax.set_ylim(-20, 150)
    ax.set_xlabel('Vitesse (mph)')
    ax.set_ylabel('Distance (ft)')
    ax.set_title(f'Degré {deg}: Entr. EQM={mse_train:.1f}, Test EQM={mse_test:.1f}')
    if deg == 1:
        ax.legend()

plt.tight_layout()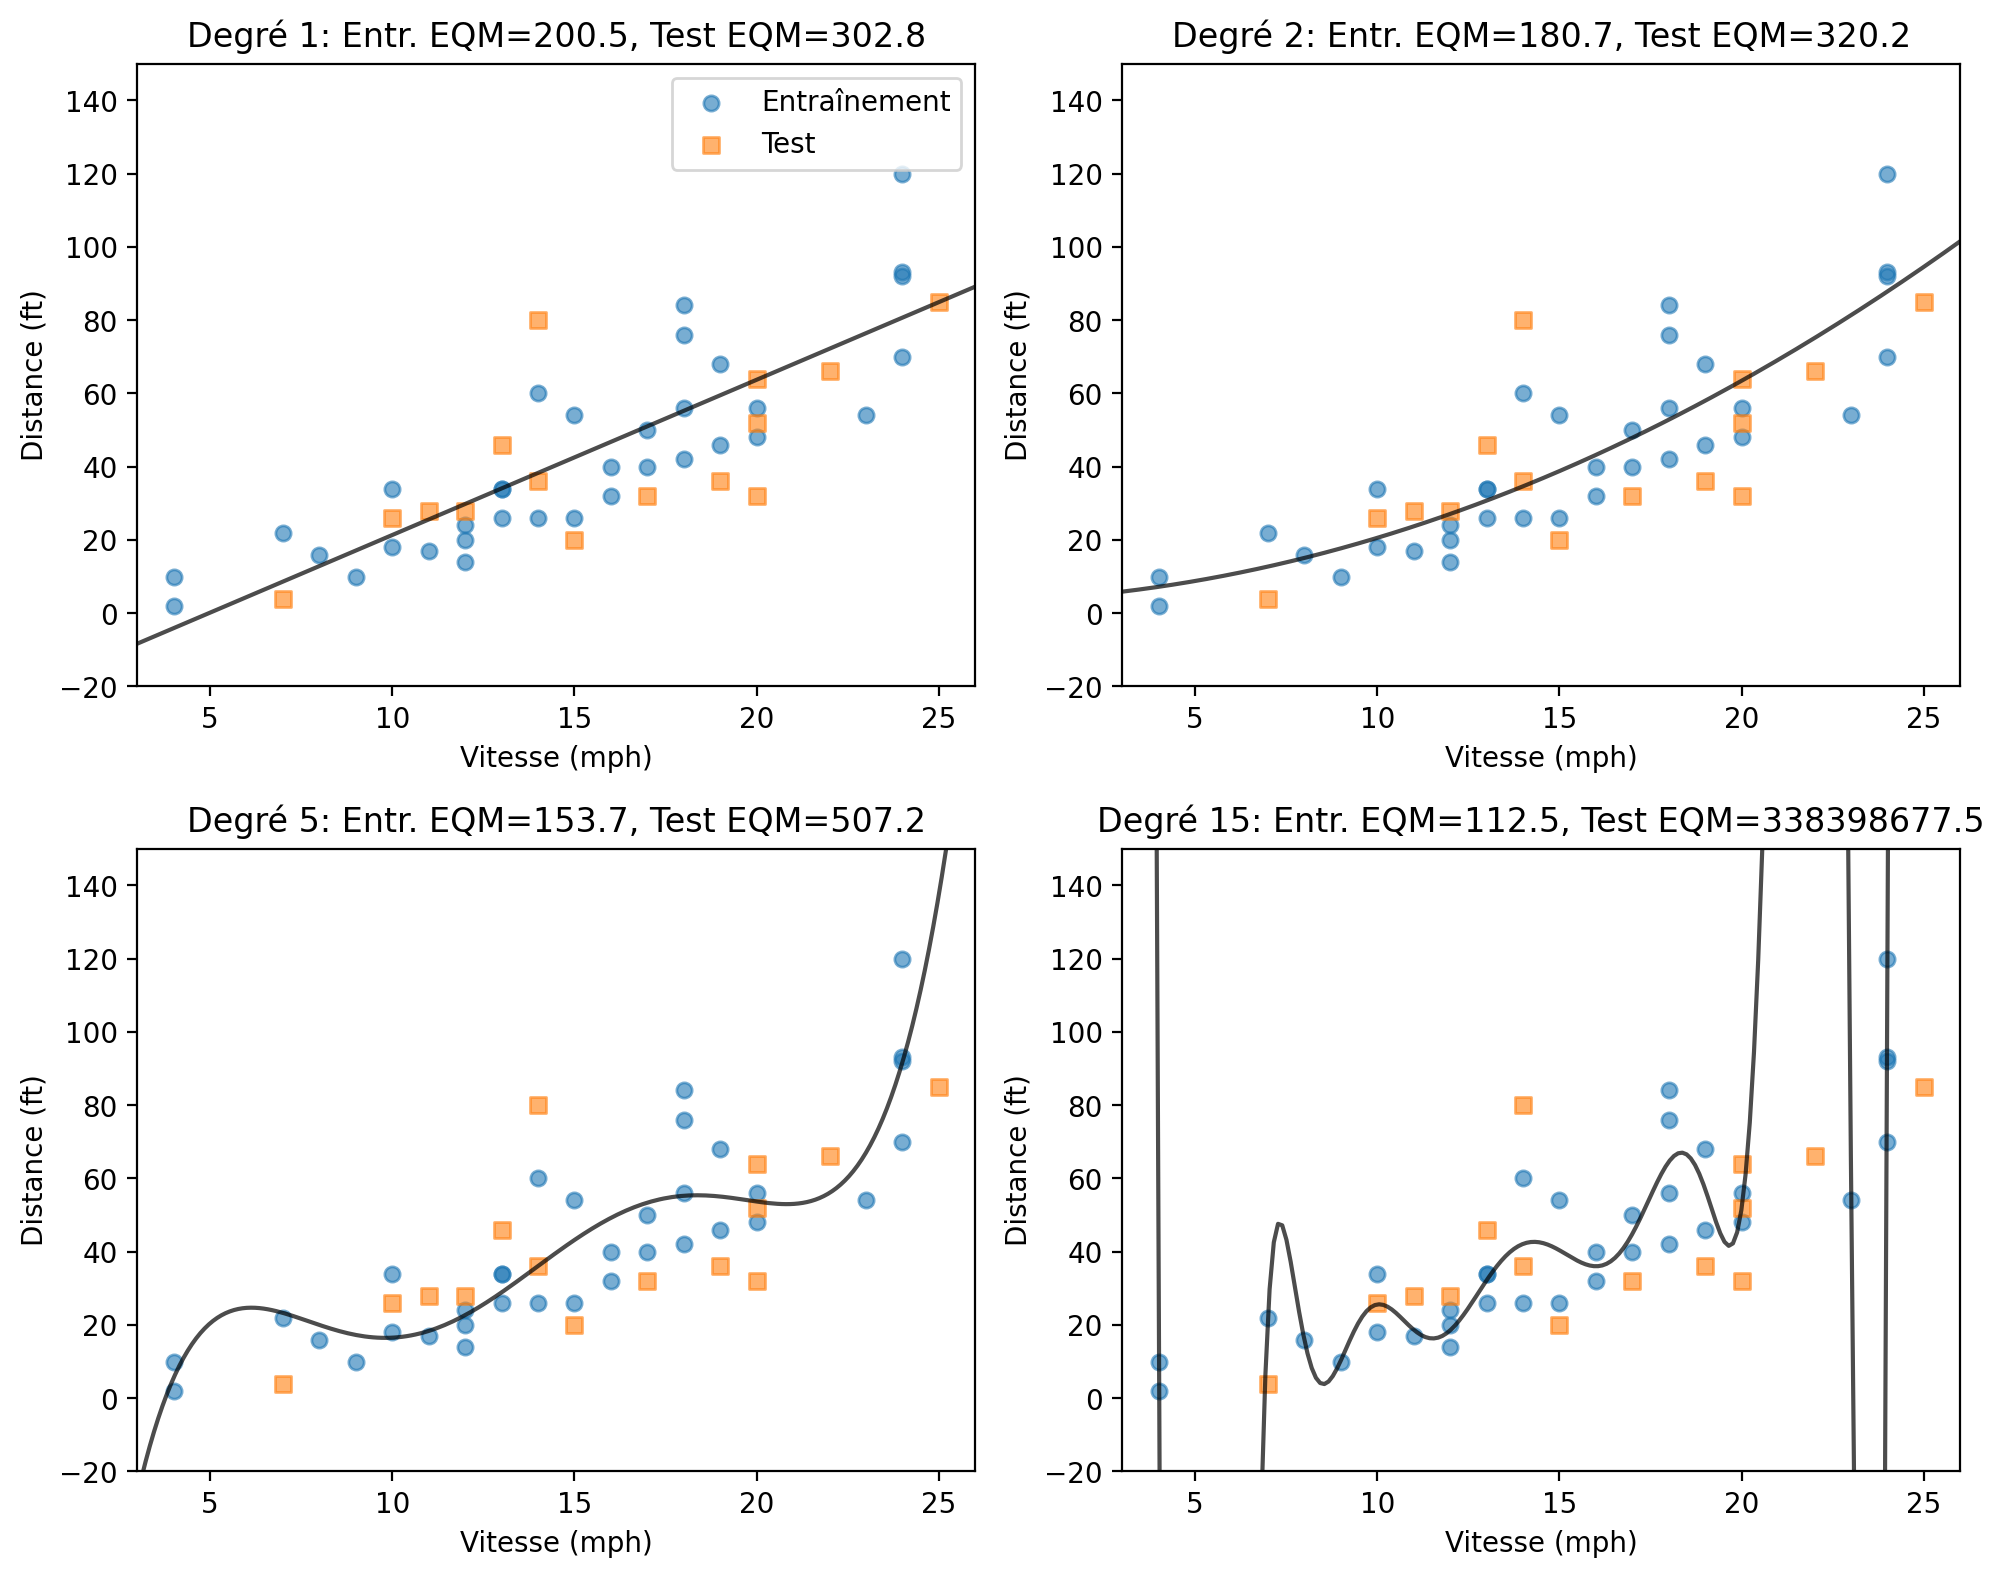
Le polynôme de degré 1 (droite) ne capture pas la courbure des données: c’est du sous-apprentissage. Le polynôme de degré 2 capture bien la relation quadratique. Le polynôme de degré 5 commence à osciller. Le polynôme de degré 15 passe près de tous les points d’entraînement, mais ses oscillations produisent des prédictions absurdes entre les points: c’est du surapprentissage.
Source
fig, ax = plt.subplots(figsize=(8, 5))
ax.plot(degrees_eval, all_train_errors, 'o-', linewidth=2, label='Erreur entraînement')
ax.plot(degrees_eval, all_test_errors, 's-', linewidth=2, label='Erreur test')

# Utiliser une échelle logarithmique car l'erreur de test explose
ax.set_yscale('log')

ax.set_xlabel('Degré du polynôme (complexité)')
ax.set_ylabel('EQM (échelle log)')
ax.set_xticks(range(1, 16, 2))
ax.grid(True, which="both", ls="-", alpha=0.2)
ax.legend()

ax.set_title('Compromis biais-variance')
plt.tight_layout()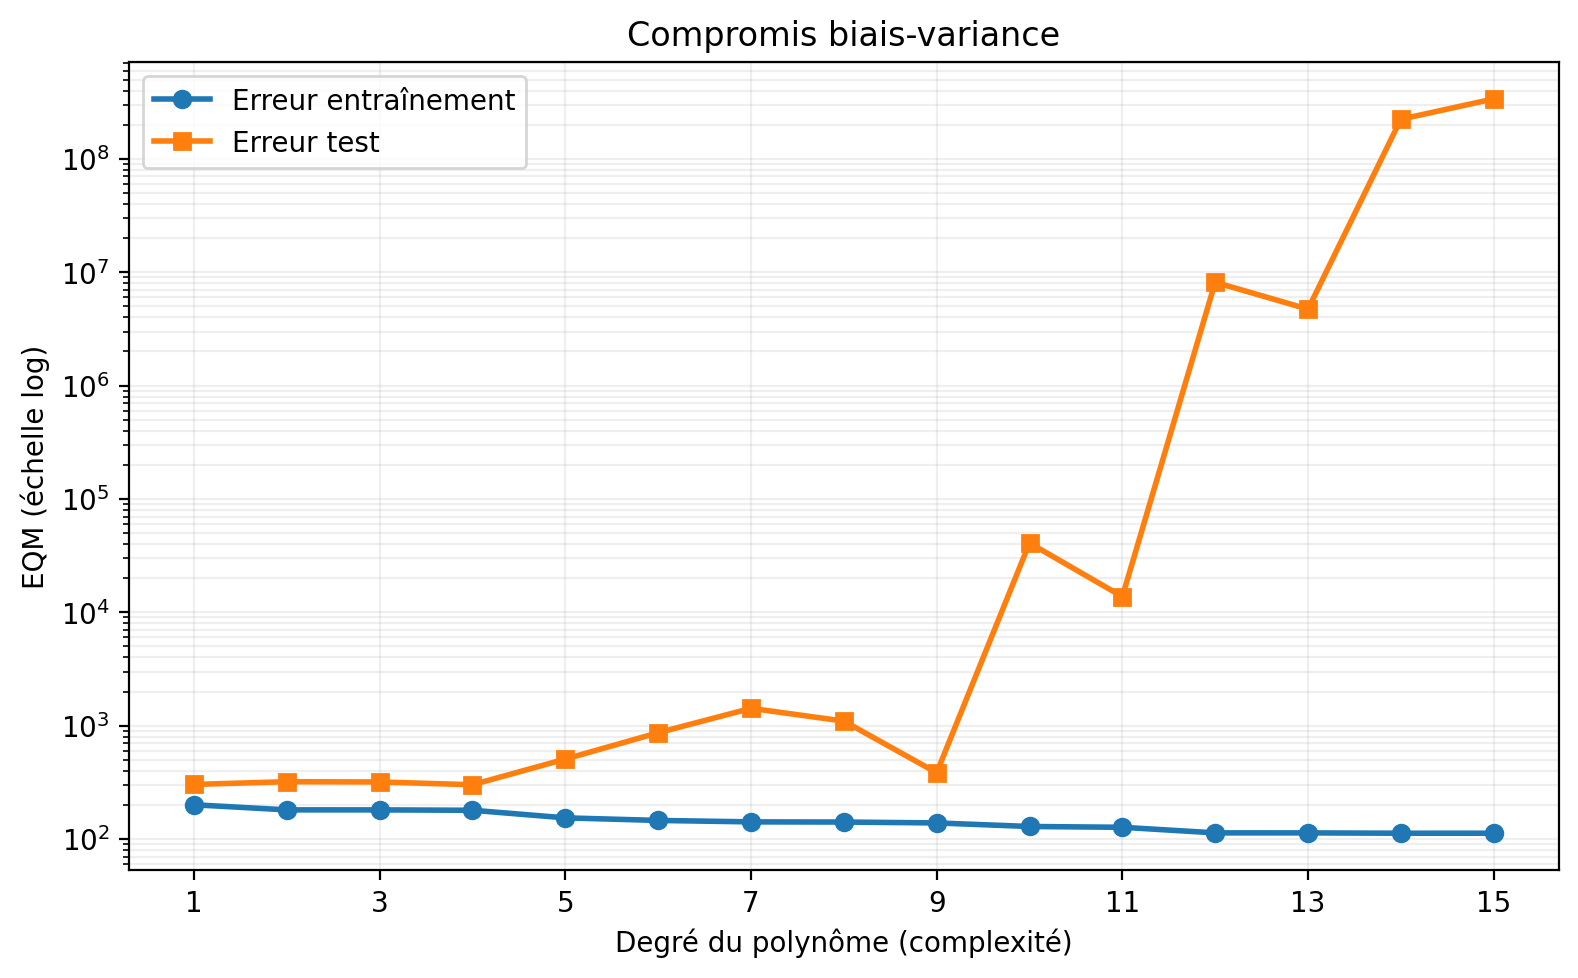
L’erreur d’entraînement diminue avec le degré du polynôme. L’erreur de test diminue d’abord (quand le modèle gagne en expressivité), puis augmente (quand le modèle commence à mémoriser le bruit). Le meilleur modèle se trouve à l’intersection de ces deux tendances. La régularisation Ridge, vue précédemment, est une alternative au choix du degré: elle permet d’utiliser un modèle de haute capacité tout en contrôlant le surapprentissage.
Encodage cyclique des variables périodiques
Les polynômes ne sont pas la seule expansion de caractéristiques utile. Considérons les variables périodiques comme l’heure de la journée, le jour de la semaine ou le mois de l’année. Ces variables posent un problème particulier lorsqu’on les utilise directement comme entrées d’un modèle linéaire.
Prenons l’heure de la journée. Si nous utilisons la valeur brute (un entier de 0 à 23), le modèle linéaire ne peut apprendre qu’une relation monotone: soit la cible augmente avec l’heure, soit elle diminue. Or, la consommation d’énergie n’est ni monotone croissante ni décroissante; elle est élevée le matin et le soir, faible la nuit et en milieu de journée. Un modèle linéaire avec l’heure brute ne peut pas capturer ce comportement cyclique.
Le problème est encore plus grave à la frontière du cycle. L’heure 23 et l’heure 0 sont adjacentes (une heure d’écart), mais numériquement elles diffèrent de 23. Un modèle linéaire n’a aucun moyen de « savoir » que ces valeurs sont proches. Si nous entraînons un modèle à prédire la température et qu’il observe que 22h et 23h ont des températures similaires, il n’a aucune raison d’extrapoler cette similarité à 0h et 1h.
L’encodage cyclique résout ces deux problèmes en projetant la variable sur un cercle à l’aide des fonctions sinus et cosinus:
où est la période (24 pour les heures, 7 pour les jours de la semaine, 12 pour les mois). Cette transformation a plusieurs propriétés importantes. Les valeurs adjacentes dans le cycle, y compris 23h et 0h, sont proches dans l’espace des caractéristiques. La représentation est continue et différentiable partout. Nous avons besoin de deux composantes (sin et cos) pour identifier de façon unique chaque point du cycle, car une seule ne suffirait pas.
Pour comprendre l’avantage de cet encodage, examinons la distance entre heures consécutives. Avec l’encodage naïf, la « distance » est simplement la différence absolue entre les valeurs numériques: . Avec l’encodage cyclique, chaque heure devient un point dans le plan, et la distance entre deux heures est la distance euclidienne entre ces points: .
Source
import numpy as np
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 3, figsize=(12, 4))

# Heures de la journée
heures = np.arange(24)
T = 24

# Encodage naïf: distance entre heures consécutives
ax = axes[0]
distances_naif = []
for h in range(24):
    h_suivant = (h + 1) % 24
    dist = abs(h_suivant - h) if h != 23 else abs(0 - 23)
    distances_naif.append(dist)
ax.bar(heures, distances_naif, color='steelblue', edgecolor='black')
ax.set_xlabel('Heure')
ax.set_ylabel('Distance à l\'heure suivante')
ax.set_title('Encodage naïf: discontinuité à minuit')
ax.set_xticks([0, 6, 12, 18, 23])
ax.axhline(1, color='green', linestyle='--', alpha=0.7, label='Distance idéale')
ax.legend()

# Encodage cyclique: projection sur le cercle
ax = axes[1]
theta = 2 * np.pi * heures / T
x_circle = np.cos(theta)
y_circle = np.sin(theta)

# Dessiner le cercle
circle_theta = np.linspace(0, 2*np.pi, 100)
ax.plot(np.cos(circle_theta), np.sin(circle_theta), 'k-', alpha=0.3)
ax.scatter(x_circle, y_circle, c=heures, cmap='twilight', s=100, zorder=5)

# Annoter quelques heures
for h in [0, 6, 12, 18, 23]:
    ax.annotate(f'{h}h', (x_circle[h]*1.15, y_circle[h]*1.15), ha='center', va='center')

ax.set_xlim(-1.4, 1.4)
ax.set_ylim(-1.4, 1.4)
ax.set_aspect('equal')
ax.set_xlabel(r'$\cos(2\pi h / 24)$')
ax.set_ylabel(r'$\sin(2\pi h / 24)$')
ax.set_title('Encodage cyclique: projection sur le cercle')
ax.axhline(0, color='gray', linewidth=0.5)
ax.axvline(0, color='gray', linewidth=0.5)

# Distance euclidienne entre heures consécutives (encodage cyclique)
ax = axes[2]
distances_cyclique = []
for h in range(24):
    h_suivant = (h + 1) % 24
    dist = np.sqrt((x_circle[h_suivant] - x_circle[h])**2 +
                   (y_circle[h_suivant] - y_circle[h])**2)
    distances_cyclique.append(dist)
ax.bar(heures, distances_cyclique, color='coral', edgecolor='black')
ax.set_xlabel('Heure')
ax.set_ylabel('Distance euclidienne')
ax.set_title('Encodage cyclique: distances uniformes')
ax.set_xticks([0, 6, 12, 18, 23])
ax.axhline(distances_cyclique[0], color='green', linestyle='--', alpha=0.7, label='Distance constante')
ax.legend()

plt.tight_layout()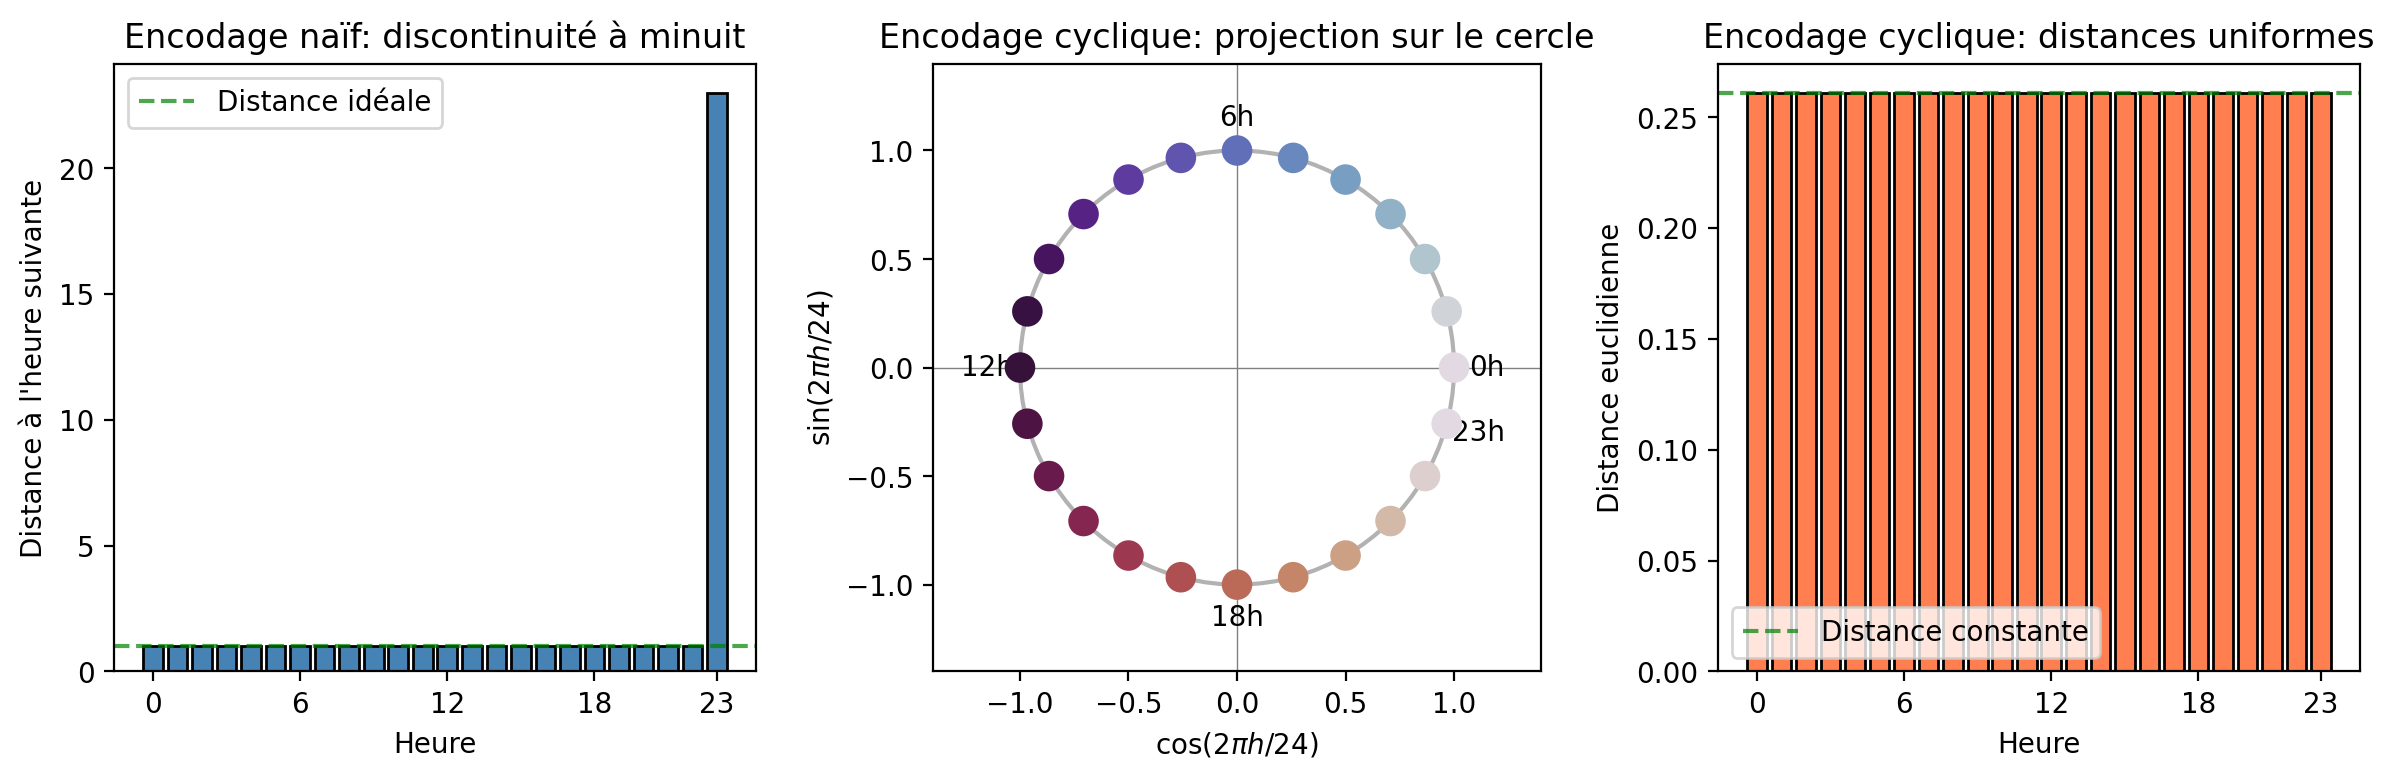
Le panneau de gauche montre le problème de l’encodage naïf: la distance entre 23h et 0h est de 23, alors qu’entre toutes les autres heures consécutives elle est de 1. Cette discontinuité est problématique pour un modèle linéaire. Le panneau du centre illustre la projection sur le cercle unitaire: chaque heure occupe une position, et les heures adjacentes (y compris 23h et 0h) sont géométriquement proches. Le panneau de droite montre la distance euclidienne dans l’espace entre heures consécutives: elle est maintenant constante pour toutes les paires, y compris entre 23h et 0h.
Source
# Encodage cyclique pour différentes variables temporelles
def encodage_cyclique(valeurs, periode):
    """
    Transforme une variable périodique en deux composantes (sin, cos).

    Paramètres:
        valeurs: array de valeurs (ex: heures 0-23)
        periode: la période du cycle (ex: 24 pour les heures)

    Retourne:
        (composante_sin, composante_cos)
    """
    angle = 2 * np.pi * valeurs / periode
    return np.sin(angle), np.cos(angle)

# Exemple d'utilisation
heures = np.array([0, 6, 12, 18, 23])
heure_sin, heure_cos = encodage_cyclique(heures, periode=24)

print("Heure | sin | cos")
print("-" * 25)
for h, s, c in zip(heures, heure_sin, heure_cos):
    print(f"  {h:2d}  | {s:+.2f} | {c:+.2f}")
Heure | sin | cos
-------------------------
0 | +0.00 | +1.00
6 | +1.00 | +0.00
12 | +0.00 | -1.00
18 | -1.00 | -0.00
23 | -0.26 | +0.97
| Variable | Période | Exemple |
|---|---|---|
| Heure du jour | 24 | 0h (0, 1), 12h (0, -1) |
| Jour de la semaine | 7 | Lundi (0.78, 0.62), Dimanche (-0.78, 0.62) |
| Mois de l’année | 12 | Janvier (0.5, 0.87), Juillet (-0.5, -0.87) |
Décomposition biais-variance
Ce compromis peut être formalisé mathématiquement. Supposons que les données suivent le modèle , où est la vraie fonction (le prédicteur de Bayes optimal pour la perte quadratique), et est un bruit de moyenne nulle et de variance .
Clarification sur les variables aléatoires: Dans cette analyse, il y a trois sources d’aléa qu’il faut bien distinguer:
est une valeur déterministe (fixe) pour chaque . C’est la vraie fonction sous-jacente, qui ne dépend d’aucun tirage aléatoire.
est une variable aléatoire représentant le bruit d’observation. C’est l’aléa intrinsèque aux données.
est notre estimateur, une fonction apprise à partir de l’échantillon d’entraînement . Comme est tiré aléatoirement, différents tirages de produisent différentes fonctions . Pour un point test fixé, la prédiction est donc une variable aléatoire (un scalaire qui varie selon ), même si elle-même est une fonction.
Autrement dit, l’espérance moyenne sur tous les échantillons d’entraînement possibles: si nous pouvions répéter l’expérience d’apprentissage un grand nombre de fois avec différents , quelle serait la prédiction moyenne pour ce ?
Dérivation mathématique
L’erreur quadratique moyenne, moyennée sur les échantillons d’entraînement possibles et le bruit, se décompose comme suit:
En développant le carré et utilisant ainsi que l’indépendance entre et :
Pour le premier terme, ajoutons et retranchons :
En développant et utilisant :
Nous obtenons la décomposition biais-variance:
Interprétation des termes
Chaque terme a une interprétation précise:
Biais²: L’écart entre la prédiction moyenne de notre estimateur et la vraie fonction . Un modèle trop simple (classe trop restrictive) aura un biais élevé car il ne peut pas approcher .
Variance: La sensibilité de notre estimateur à l’échantillon d’entraînement particulier. Un modèle trop complexe aura une variance élevée car de petites variations dans les données causent de grandes variations dans les prédictions.
: Le bruit irréductible, inhérent aux données. Aucun estimateur ne peut faire mieux que cette erreur.
Cette décomposition explique pourquoi l’erreur de test a une forme en U: à faible complexité, le biais domine; à haute complexité, la variance domine. Le minimum se trouve au point où la somme des deux est minimale.
Lien avec Ridge
Cette décomposition éclaire aussi pourquoi Ridge fonctionne. Rappelons que Ridge rétrécit les coefficients vers zéro, avec un rétrécissement différencié selon les valeurs singulières:
Effet sur le biais: En rétrécissant, Ridge introduit un biais (l’estimé s’éloigne de la vraie valeur)
Effet sur la variance: En rétrécissant, Ridge réduit la variance (l’estimé devient moins sensible aux fluctuations des données)
Le coefficient contrôle ce compromis. Un trop petit n’aide pas assez (variance élevée). Un trop grand introduit trop de biais. Le optimal minimise l’erreur totale.
Intuition géométrique: pourquoi la dimension supérieure aide
L’expansion de caractéristiques semble être un simple changement de variables, mais elle cache une idée géométrique profonde. Pour comprendre pourquoi projeter les données dans un espace de dimension supérieure permet de capturer des relations non linéaires, examinons d’abord le cas de la régression, puis celui de la classification.
Régression polynomiale comme modèle linéaire
Considérons une régression quadratique: . Cette fonction est non linéaire en (c’est une parabole), mais linéaire dans les paramètres . Que signifie cette distinction géométriquement?
Introduisons l’espace des caractéristiques . Chaque valeur de correspond à un point dans . Ces points ne sont pas dispersés arbitrairement: ils vivent sur une courbe particulière, la courbe des moments (moment curve), qui ressemble à une rampe tordue.
Source
import numpy as np
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D

# Créer la courbe des moments: (x, x², x³) pour visualisation
# On utilise (1, x, x²) mais on projette sur (x, x², y) pour la visualisation
fig = plt.figure(figsize=(12, 5))

# Gauche: les fonctions de base
ax1 = fig.add_subplot(121)
x = np.linspace(-2, 2, 100)
ax1.plot(x, np.ones_like(x), 'b-', linewidth=2, label=r'$\phi_0(x) = 1$')
ax1.plot(x, x, 'orange', linewidth=2, label=r'$\phi_1(x) = x$')
ax1.plot(x, x**2, 'g-', linewidth=2, label=r'$\phi_2(x) = x^2$')
ax1.axhline(0, color='gray', linewidth=0.5)
ax1.axvline(0, color='gray', linewidth=0.5)
ax1.set_xlabel('$x$')
ax1.set_ylabel(r'$\phi_j(x)$')
ax1.set_title('Les fonctions de base')
ax1.legend()
ax1.set_ylim(-2.5, 4.5)
ax1.grid(True, alpha=0.3)

# Droite: combinaisons linéaires
ax2 = fig.add_subplot(122)
x = np.linspace(-2, 2, 100)

# Différentes combinaisons de coefficients
combinations = [
    ((1, 0, 0), 'Constante: $1$'),
    ((0, 1, 0), 'Linéaire: $x$'),
    ((0, 0, 1), 'Quadratique: $x^2$'),
    ((1, -0.5, 0.5), 'Combinaison: $1 - 0.5x + 0.5x^2$'),
]

colors = ['tab:blue', 'tab:orange', 'tab:green', 'tab:red']
for (theta0, theta1, theta2), label in combinations:
    y = theta0 + theta1 * x + theta2 * x**2
    ax2.plot(x, y, linewidth=2, label=label)

ax2.axhline(0, color='gray', linewidth=0.5)
ax2.axvline(0, color='gray', linewidth=0.5)
ax2.set_xlabel('$x$')
ax2.set_ylabel('$f(x)$')
ax2.set_title('Combinaisons linéaires des fonctions de base')
ax2.legend(loc='upper center')
ax2.set_ylim(-2.5, 4.5)
ax2.grid(True, alpha=0.3)

plt.tight_layout()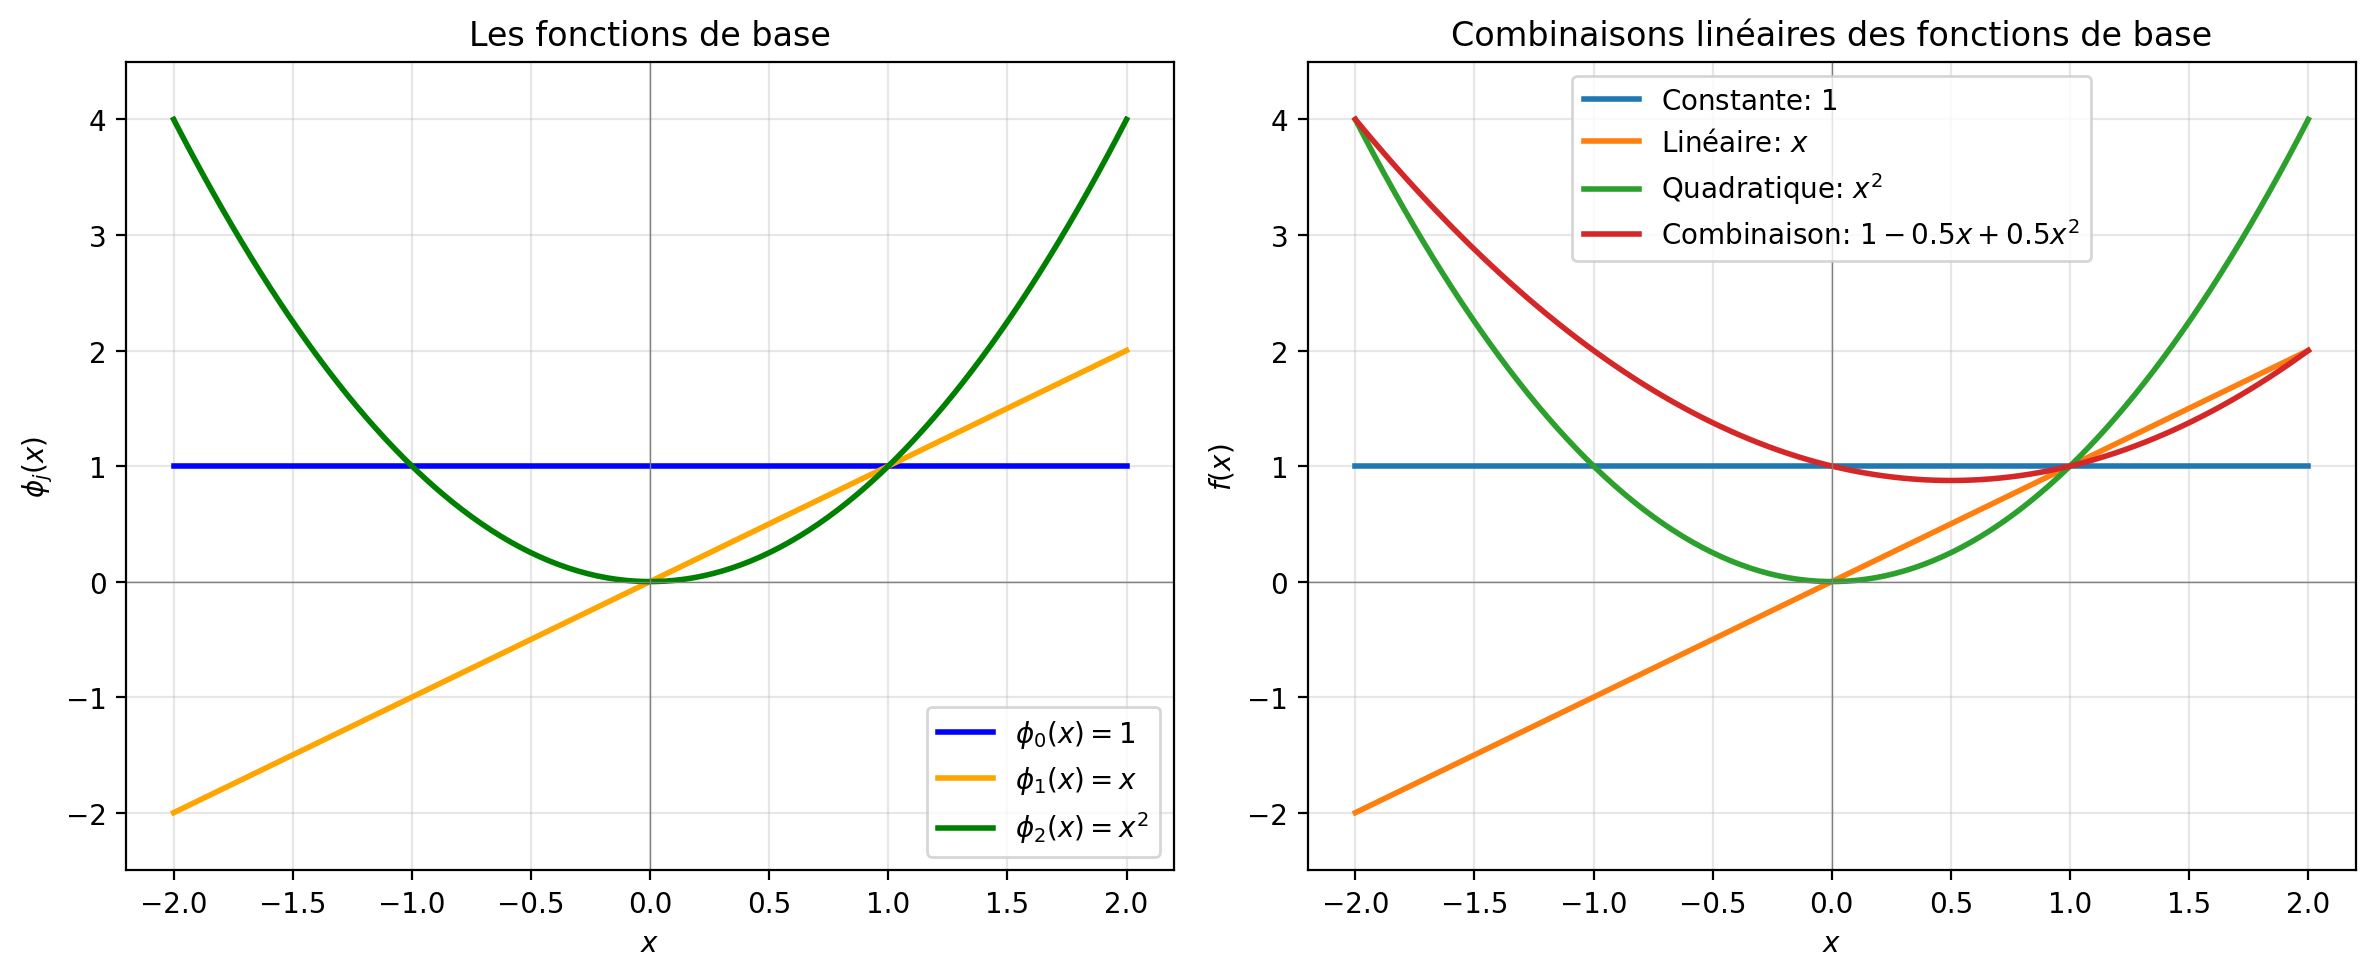
Les fonctions de base sont les “ingrédients” du modèle. La régression polynomiale cherche les coefficients qui mélangent ces ingrédients de façon optimale. Chaque combinaison produit une courbe différente, mais toutes sont des paraboles (ou des cas dégénérés: droites, constantes).
Voici l’insight géométrique clé: dans l’espace , le modèle définit un plan. La parabole que nous voyons dans le graphique est simplement la projection de ce plan sur notre espace de visualisation.
Exemple en 1D: données sur une droite
Considérons des points sur une droite, répartis en deux classes: les points bleus au centre, les points orange aux extrémités. Aucun seuil unique ne peut séparer ces deux classes.
Source
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)

# Classe bleue: points au centre
x_blue = np.random.uniform(-0.5, 0.5, 15)
# Classe orange: points aux extrémités
x_orange = np.concatenate([np.random.uniform(-1.5, -0.8, 8),
                           np.random.uniform(0.8, 1.5, 8)])

fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# Gauche: espace original avec tentative de séparation
ax = axes[0]
ax.scatter(x_blue, np.zeros_like(x_blue), c='tab:blue', s=80, zorder=3)
ax.scatter(x_orange, np.zeros_like(x_orange), c='tab:orange', s=80, zorder=3)
ax.axhline(0, color='gray', linewidth=0.5, zorder=1)
ax.axvline(0.3, color='red', linestyle='--', linewidth=2, label='Seuil?')
ax.set_xlim(-2, 2)
ax.set_ylim(-0.5, 0.5)
ax.set_xlabel('$x$')
ax.set_yticks([])
ax.set_title('Espace original: pas de séparation linéaire')
ax.legend()

# Droite: espace transformé
ax = axes[1]
ax.scatter(x_blue, x_blue**2, c='tab:blue', s=80, zorder=3, label='Classe A')
ax.scatter(x_orange, x_orange**2, c='tab:orange', s=80, zorder=3, label='Classe B')

# Ligne de séparation dans l'espace transformé
x_line = np.linspace(-2, 2, 100)
threshold = 0.6
ax.axhline(threshold, color='green', linestyle='-', linewidth=2, label='Frontière linéaire')
ax.fill_between(x_line, 0, threshold, alpha=0.1, color='blue')
ax.fill_between(x_line, threshold, 2.5, alpha=0.1, color='orange')

# Parabole de référence
x_curve = np.linspace(-1.6, 1.6, 100)
ax.plot(x_curve, x_curve**2, 'k--', alpha=0.3, linewidth=1)

ax.set_xlim(-2, 2)
ax.set_ylim(-0.1, 2.5)
ax.set_xlabel('$x$')
ax.set_ylabel('$x^2$')
ax.set_title(r'Espace transformé $\phi(x) = (x, x^2)$: séparation linéaire!')
ax.legend()

plt.tight_layout()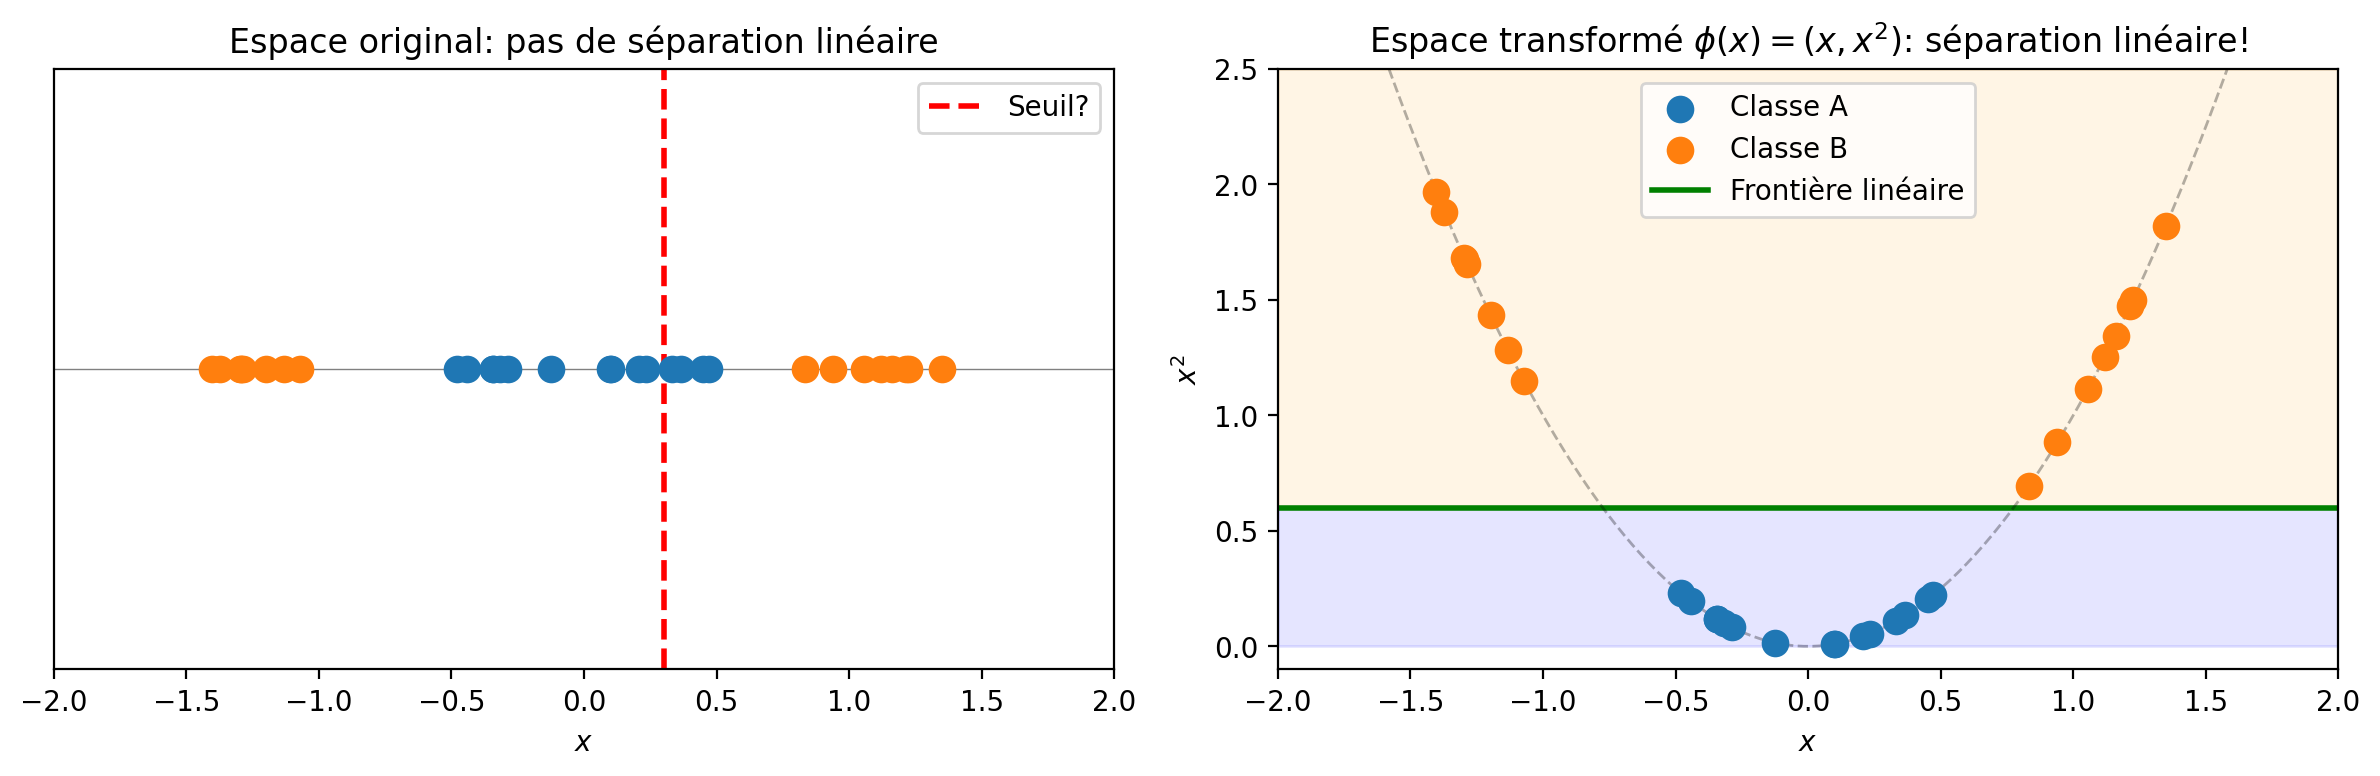
Dans l’espace transformé, une simple droite horizontale sépare les deux classes. Cette droite correspond, dans l’espace original, à deux seuils: , soit . L’expansion de caractéristiques a transformé une frontière de décision non linéaire (un intervalle) en une frontière linéaire (une droite).
Exemple en 2D: cercles concentriques
Passons à un exemple plus visuel. Considérons deux classes disposées en cercles concentriques: la classe bleue forme un disque central, la classe orange forme un anneau extérieur. Aucune droite ne peut séparer ces deux régions.
Appliquons l’expansion . La troisième coordonnée est le carré de la distance à l’origine: . Les points proches du centre (petit ) sont “soulevés” moins haut que les points éloignés (grand ).
Source
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(123)

# Classe bleue: disque central
n_blue = 50
r_blue = np.random.uniform(0, 0.7, n_blue)
theta_blue = np.random.uniform(0, 2*np.pi, n_blue)
x_blue = r_blue * np.cos(theta_blue)
y_blue = r_blue * np.sin(theta_blue)

# Classe orange: anneau extérieur
n_orange = 70
r_orange = np.random.uniform(1.0, 1.5, n_orange)
theta_orange = np.random.uniform(0, 2*np.pi, n_orange)
x_orange = r_orange * np.cos(theta_orange)
y_orange = r_orange * np.sin(theta_orange)

fig, axes = plt.subplots(1, 2, figsize=(12, 5))

# Gauche: vue 2D originale
ax = axes[0]
ax.scatter(x_blue, y_blue, c='tab:blue', s=40, alpha=0.7, label='Classe A')
ax.scatter(x_orange, y_orange, c='tab:orange', s=40, alpha=0.7, label='Classe B')
ax.set_xlim(-2, 2)
ax.set_ylim(-2, 2)
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_aspect('equal')
ax.legend()
ax.set_title('Cercles concentriques: pas de séparation linéaire en 2D')

# Droite: vue 2D avec frontière circulaire
ax = axes[1]
ax.scatter(x_blue, y_blue, c='tab:blue', s=40, alpha=0.7, label='Classe A')
ax.scatter(x_orange, y_orange, c='tab:orange', s=40, alpha=0.7, label='Classe B')

# Cercle de décision (projection du plan z = 0.75)
theta_circle = np.linspace(0, 2*np.pi, 100)
r_decision = np.sqrt(0.75)
ax.plot(r_decision * np.cos(theta_circle), r_decision * np.sin(theta_circle),
        'g-', linewidth=2.5, label=f'Frontière: $r = {r_decision:.2f}$')

ax.set_xlim(-2, 2)
ax.set_ylim(-2, 2)
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_aspect('equal')
ax.legend()
ax.set_title('Frontière de décision projetée en 2D')

plt.tight_layout()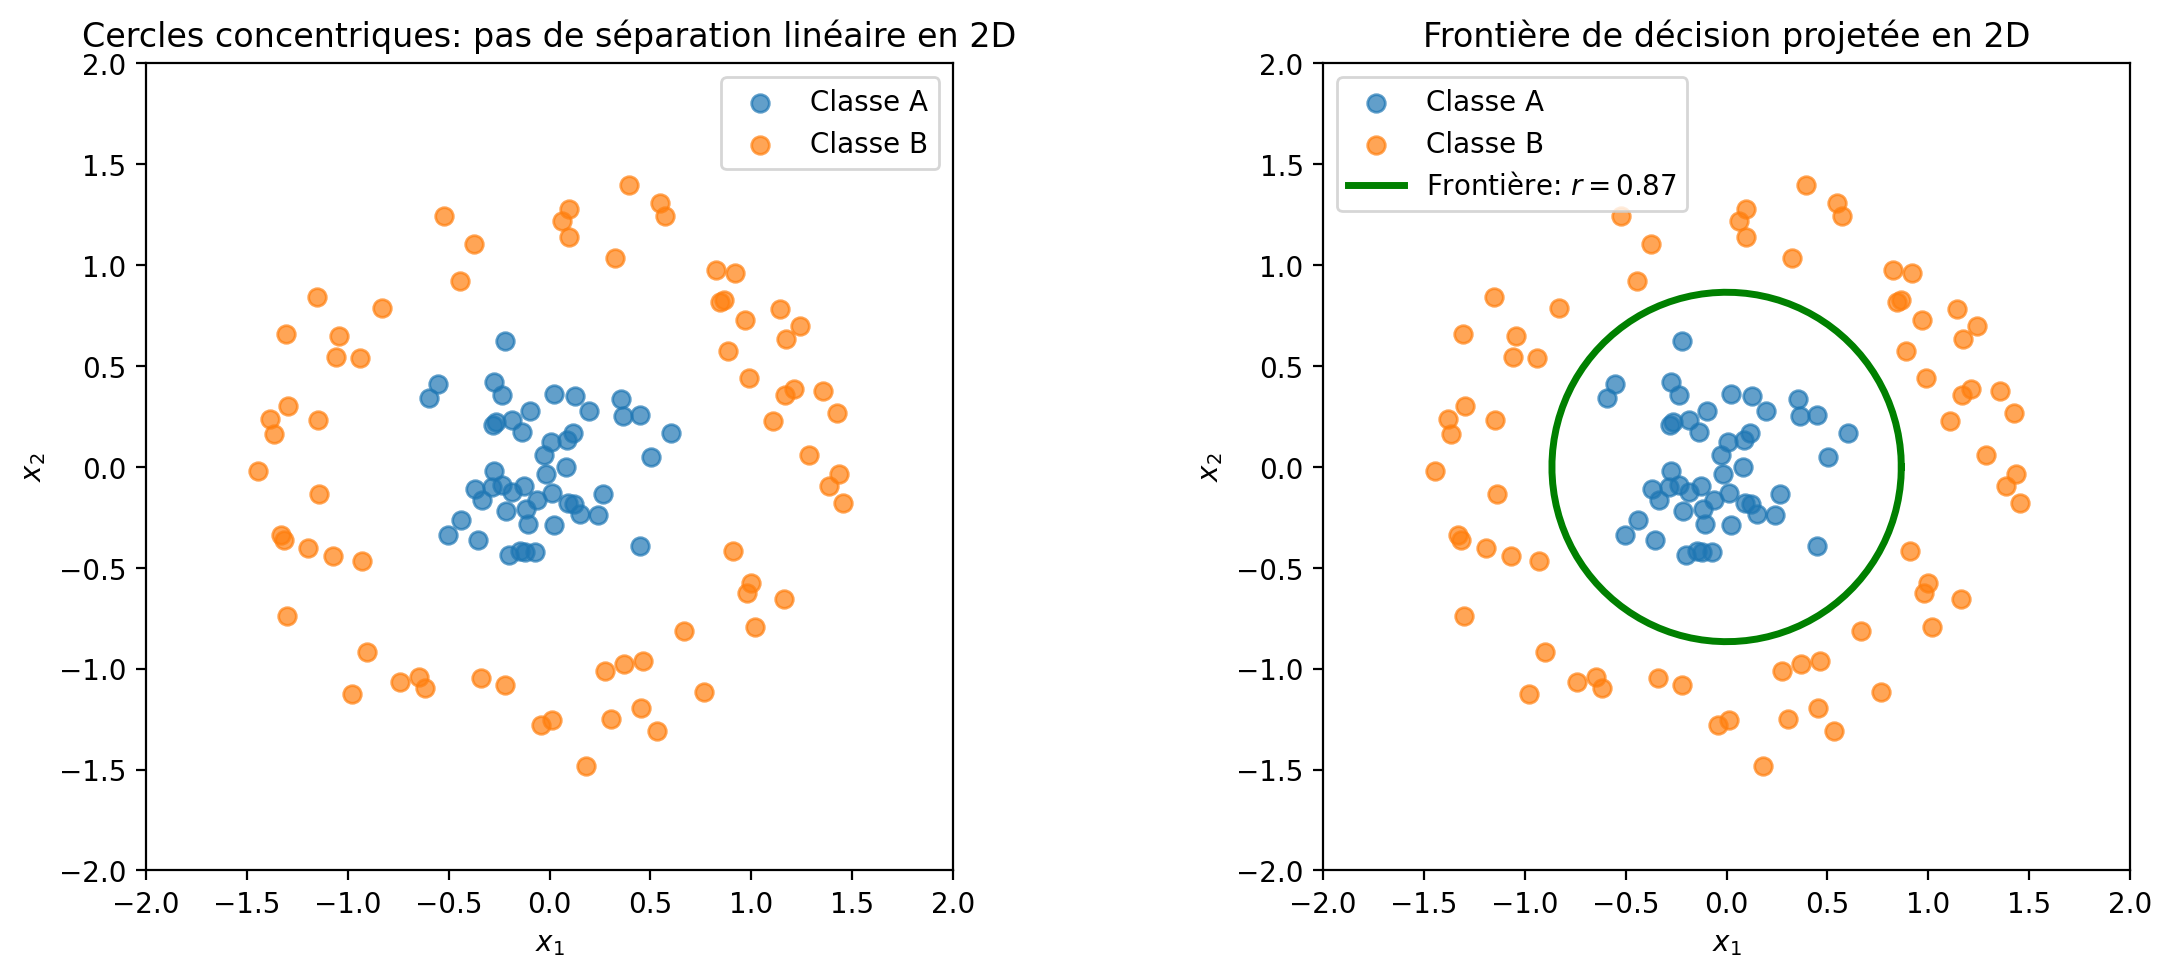
Dans l’espace 3D , un plan horizontal sépare les deux classes. Ce plan correspond, dans l’espace original 2D, à un cercle de rayon . La frontière de décision linéaire en 3D devient une frontière circulaire en 2D.
Le principe unificateur
Ces exemples de régression et de classification illustrent le même principe géométrique:
| Régression | Classification | |
|---|---|---|
| Objectif | Ajuster les données | Séparer les classes |
| Dans l’espace original | Courbe (parabole, etc.) | Frontière courbe (cercle, etc.) |
| Dans l’espace des caractéristiques | Hyperplan d’ajustement | Hyperplan séparateur |
| La courbe/frontière est... | L’intersection du plan avec la surface | La projection de l’hyperplan |
L’expansion de caractéristiques transforme un problème non linéaire en un problème linéaire dans un espace de dimension supérieure. Les modèles linéaires, simples à optimiser et à analyser, deviennent alors suffisants pour capturer des structures complexes.
En augmentant la dimension de l’espace de représentation, nous augmentons la capacité du modèle. Mais cette flexibilité a un coût: plus l’espace est grand, plus le modèle risque de mémoriser les particularités des données d’entraînement plutôt que d’apprendre la structure sous-jacente. C’est le compromis biais-variance, et c’est pourquoi la régularisation est si importante pour les modèles à haute capacité.
Évaluation et choix de modèle
En pratique, nous estimons le risque par le risque empirique sur un ensemble de test disjoint de l’ensemble d’entraînement. Un troisième ensemble, l’ensemble de validation, sert à choisir parmi plusieurs modèles ou à régler des hyperparamètres. L’ensemble de test doit rester intact jusqu’à l’évaluation finale, pour fournir une estimation non biaisée.
Cette séparation est importante. Si nous utilisons l’ensemble de test pour faire des choix (quel modèle garder, quelle valeur d’hyperparamètre utiliser), l’estimation de performance sur ce même ensemble devient optimiste.
Hyperparamètres et validation
De nombreux modèles ont des hyperparamètres: des choix qui doivent être faits avant l’entraînement et qui ne sont pas appris à partir des données. Le degré d’un polynôme, le nombre de voisins dans les plus proches voisins, ou le coefficient de régularisation sont des exemples d’hyperparamètres.
Un hyperparamètre mal choisi peut mener au surapprentissage (modèle trop complexe) ou au sous-apprentissage (modèle trop simple). La méthode standard pour choisir un hyperparamètre est la validation: on réserve une partie des données (typiquement 20%) comme ensemble de validation, on entraîne le modèle pour plusieurs valeurs de l’hyperparamètre, et on retient celle qui minimise l’erreur sur l’ensemble de validation.
Plus formellement, pour un hyperparamètre , définissons le risque de validation:
où est le modèle entraîné avec l’hyperparamètre . La recherche par grille consiste à évaluer ce risque pour un ensemble de valeurs candidates et à retenir:
Une fois choisi, on peut ré-entraîner le modèle sur l’ensemble des données (entraînement + validation) pour obtenir le modèle final.
Validation croisée
Quand les données sont peu nombreuses, réserver 20% pour la validation peut être coûteux. La validation croisée offre une alternative.
L’idée est de partitionner les données en blocs. Pour chaque bloc , on entraîne le modèle sur les autres blocs et on évalue sur le bloc . Le risque de validation croisée est la moyenne des évaluations:
où désigne toutes les données sauf le bloc .
Source
import numpy as np
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(10, 3))

K = 5
for fold in range(K):
    for k in range(K):
        if k == fold:
            ax.barh(fold, 1, left=k, color='C1', edgecolor='black', linewidth=1, label='Validation' if fold == 0 else '')
        else:
            ax.barh(fold, 1, left=k, color='C0', edgecolor='black', linewidth=1, label='Entraînement' if fold == 0 and k == 0 else '')

ax.set_yticks(range(K))
ax.set_yticklabels([f'Itération {k+1}' for k in range(K)])
ax.set_xticks(np.arange(K) + 0.5)
ax.set_xticklabels([f'Bloc {k+1}' for k in range(K)])
ax.set_xlabel('Blocs de données')
ax.legend(loc='upper right')
ax.set_title(f'Validation croisée à {K} blocs')
ax.set_xlim(0, K)

plt.tight_layout()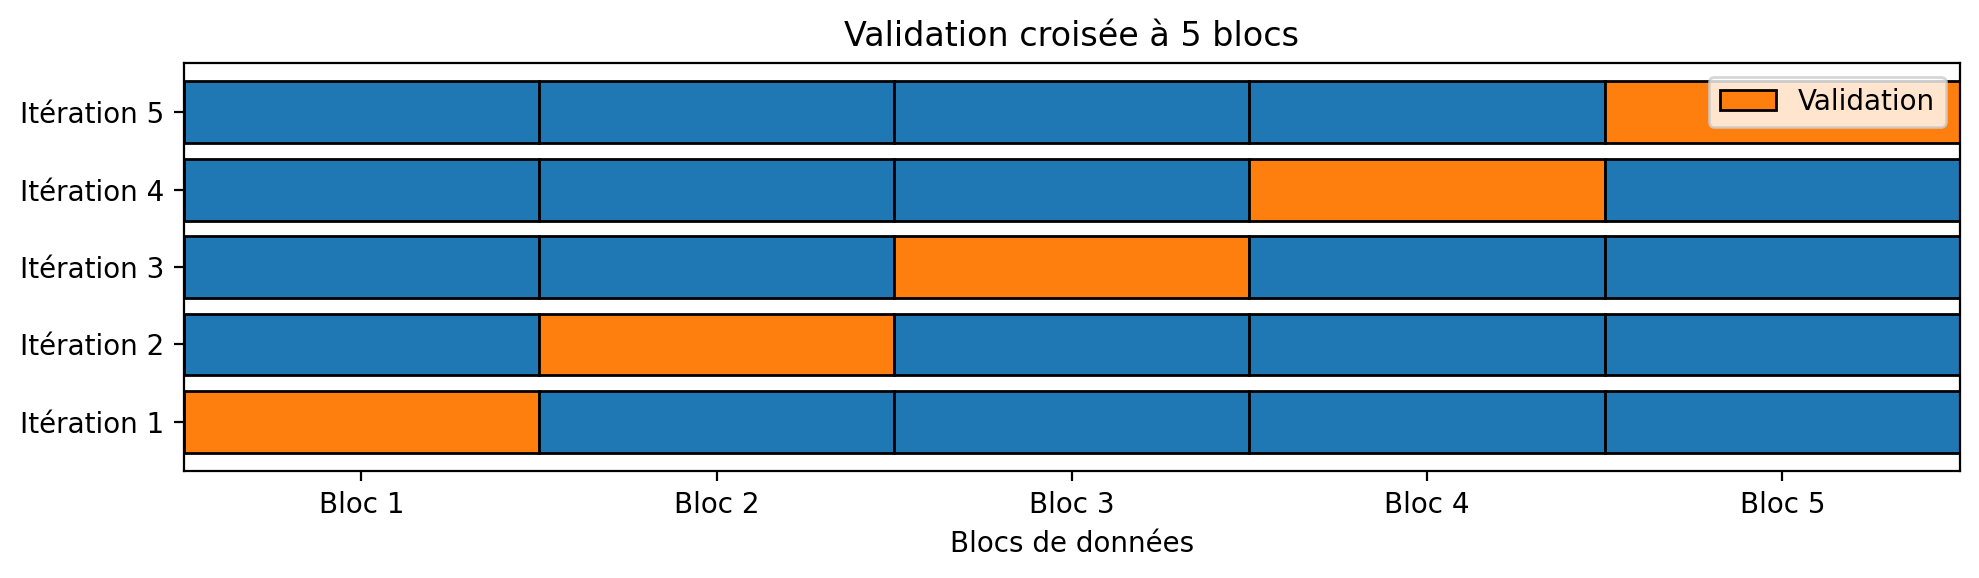
Le cas particulier (un bloc par exemple) est appelé validation croisée leave-one-out. Elle utilise au maximum les données disponibles, mais est coûteuse en calcul. En pratique, ou offrent un bon compromis.
Biais inductifs
Il n’existe pas de modèle universel qui fonctionne optimalement pour tous les problèmes. Ce résultat, connu sous le nom de théorème du no free lunch, affirme qu’un algorithme d’apprentissage qui performe bien sur une classe de problèmes performe nécessairement moins bien sur d’autres.
Tout modèle encode des biais inductifs: des hypothèses implicites ou explicites sur la structure du problème. La régression linéaire suppose que la relation entre entrées et sorties est linéaire. Les k plus proches voisins supposent que les points proches dans l’espace des entrées ont des sorties similaires. Les modèles plus complexes, comme les réseaux de neurones, encodent d’autres hypothèses sur la structure des données.
Ces hypothèses sont nécessaires pour que l’apprentissage soit possible. Sans elles, nous n’aurions aucune raison de croire que la performance sur l’échantillon d’entraînement prédit la performance sur de nouvelles données. Le choix du modèle et de ses hypothèses est une décision que l’algorithme ne peut pas prendre seul; elle requiert une connaissance du domaine.
Fonctions de perte de substitution
La perte 0-1 pose un problème pratique. Les méthodes d’optimisation itératives, comme la descente de gradient, requièrent que la fonction objectif soit différentiable. Or la perte 0-1 est constante par morceaux: sa dérivée est nulle presque partout et indéfinie aux points de discontinuité.
Nous contournons ce problème en utilisant des fonctions de perte de substitution: des approximations convexes et différentiables de la perte originale. L’entropie croisée, que nous avons dérivée dans le chapitre précédent à partir du maximum de vraisemblance, en est un exemple central. Examinons ici une vue unifiée des pertes de substitution les plus courantes.
Pour la classification binaire, plutôt que de prédire directement une classe, les modèles produisent souvent un score (un nombre réel). La prédiction de classe se fait ensuite en prenant le signe de ce score: si , on prédit la classe +1; si , on prédit la classe -1. La valeur absolue de mesure la confiance: plus est grand, plus le modèle est confiant dans sa prédiction.
Avec la convention (plutôt que ), la perte logistique s’écrit:
où est le score produit par le modèle. Cette formulation est équivalente à l’entropie croisée binaire du chapitre 3, mais avec la convention plutôt que . La fonction est convexe et différentiable partout. Lorsque et ont le même signe (prédiction correcte avec confiance), la perte est faible. Lorsqu’ils ont des signes opposés (erreur), la perte croît linéairement avec l’amplitude de l’erreur.
La perte à charnière (hinge loss) est utilisée dans les machines à vecteurs de support:
Cette fonction est convexe mais non différentiable au point . Elle est nulle lorsque la prédiction est correcte avec une marge suffisante (), et croît linéairement sinon.
Ces deux fonctions majorent la perte 0-1: pour tout et , nous avons et . Minimiser ces substituts garantit donc un certain contrôle sur la perte originale.
Source
import numpy as np
import matplotlib.pyplot as plt

# Margin: y * s (positive = correct prediction, negative = error)
margin = np.linspace(-3, 3, 500)

# 0-1 loss: 1 if margin < 0, else 0
loss_01 = (margin < 0).astype(float)

# Logistic loss: log(1 + exp(-margin))
loss_log = np.log(1 + np.exp(-margin))

# Hinge loss: max(0, 1 - margin)
loss_hinge = np.maximum(0, 1 - margin)

fig, ax = plt.subplots(figsize=(8, 5))

ax.plot(margin, loss_01, 'k-', linewidth=2, label='Perte 0-1')
ax.plot(margin, loss_log, 'C0-', linewidth=2, label='Perte logistique')
ax.plot(margin, loss_hinge, 'C1-', linewidth=2, label='Perte à charnière')

ax.axvline(0, color='gray', linestyle=':', alpha=0.5)
ax.axhline(1, color='gray', linestyle=':', alpha=0.3)

ax.set_xlabel(r'Marge $y \cdot s$')
ax.set_ylabel('Perte')
ax.set_xlim(-3, 3)
ax.set_ylim(-0.1, 4)
ax.legend()
ax.set_title('Fonctions de perte de substitution comme bornes supérieures convexes')

# Annotate regions
ax.text(-1.5, 3.5, 'Erreur\n(prédiction incorrecte)', ha='center', fontsize=9, color='gray')
ax.text(1.5, 0.3, 'Correct\n(prédiction juste)', ha='center', fontsize=9, color='gray')

plt.tight_layout()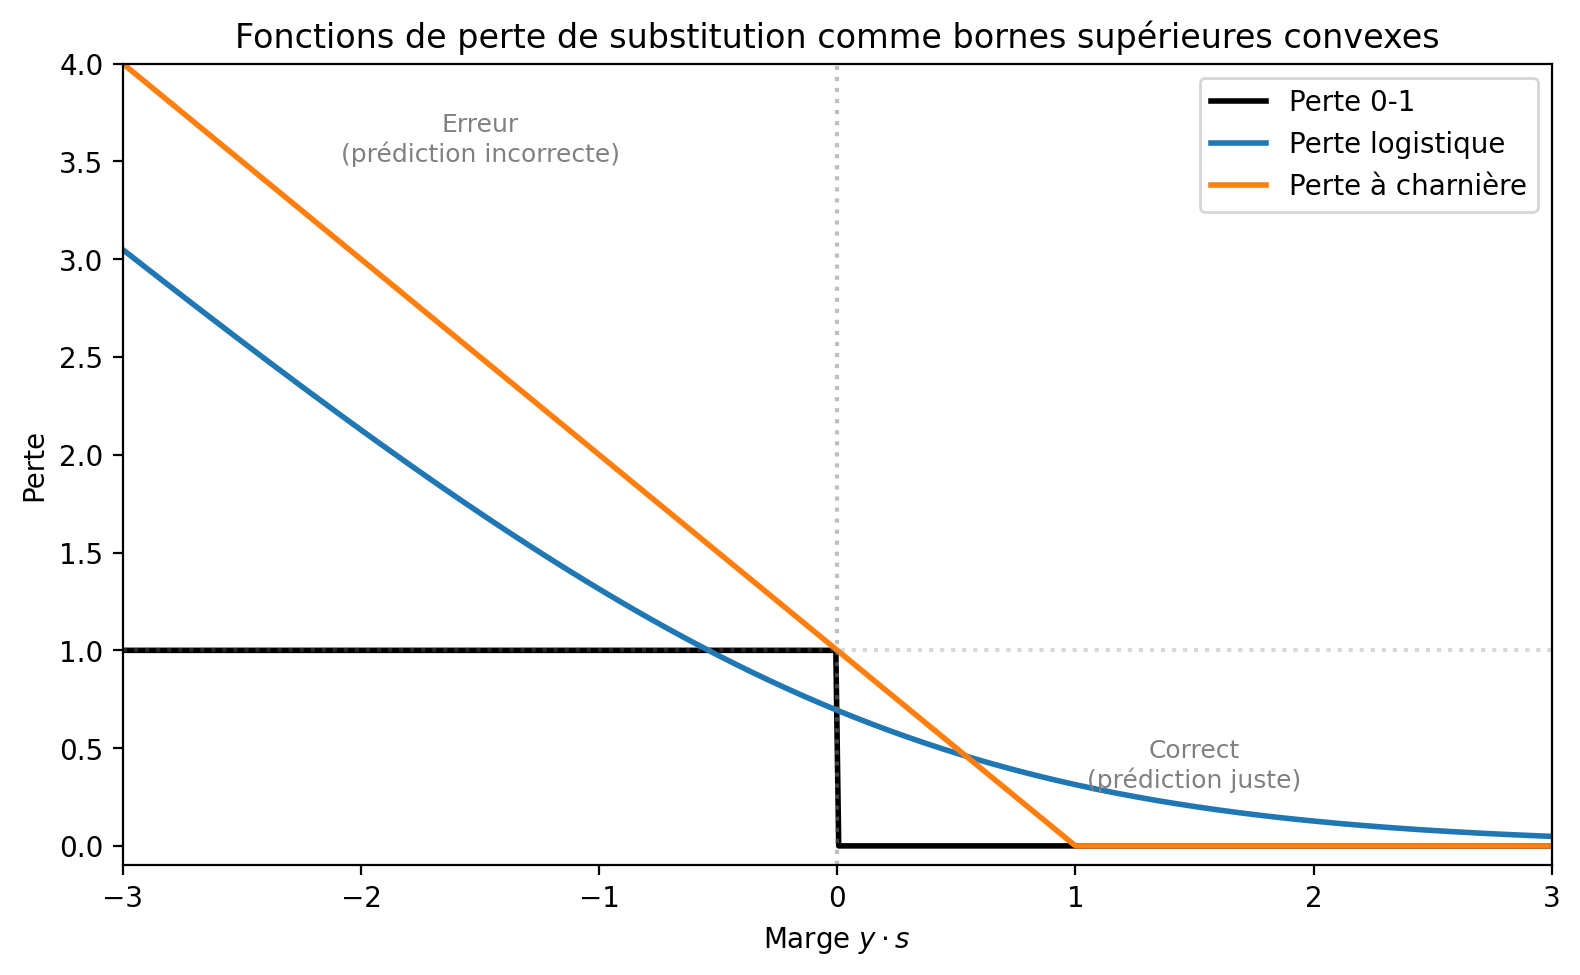
Résumé
Ce chapitre a exploré les fondements théoriques et pratiques de la généralisation:
L’expansion de caractéristiques transforme un problème non linéaire en problème linéaire dans un espace de dimension supérieure, au prix d’une capacité accrue.
La décomposition biais-variance formalise le compromis: modèles simples = biais élevé, variance faible; modèles complexes = biais faible, variance élevée. L’erreur totale est minimale au point où la somme est minimale.
La validation croisée permet de choisir les hyperparamètres (comme ou le degré polynomial) en estimant l’erreur de généralisation sans toucher à l’ensemble de test.
Les fonctions de perte de substitution (logistique, hinge) remplacent la perte 0-1 non différentiable par des approximations convexes optimisables par descente de gradient.
Les biais inductifs (hypothèses sur la structure des données) sont inévitables et nécessaires à l’apprentissage.
Mais d’où viennent ces choix de fonctions de perte? Pourquoi la perte quadratique pour la régression et l’entropie croisée pour la classification? Le chapitre suivant répond à ces questions en présentant le cadre probabiliste, qui unifie ces approches via le maximum de vraisemblance et le maximum a posteriori.
Exercices
Exercice 1: Expansion de caractéristiques ★
Considérez un problème de régression où la relation entre et est quadratique:
Générez points selon ce modèle pour .
Ajustez un modèle linéaire aux données. Visualisez le résultat et calculez l’EQM.
Définissez la transformation . Montrez que le problème devient linéaire en dans cet espace étendu.
Ajustez un modèle linéaire dans l’espace étendu: . Comparez l’EQM avec le modèle précédent.
Que se passe-t-il si vous utilisez ? Discutez du risque de surapprentissage.
Solution Exercice 1
Génération des données:
import numpy as np
np.random.seed(42)
x = np.random.uniform(-2, 4, 50)
y = 3 - 2*x + 0.5*x**2 + np.random.normal(0, 0.5, 50)
Modèle linéaire simple:
coeffs_lin = np.polyfit(x, y, 1)
y_pred_lin = np.polyval(coeffs_lin, x)
mse_lin = np.mean((y - y_pred_lin)**2)
L’EQM est élevé car le modèle linéaire ne peut pas capturer la courbure. Visuellement, la droite ne suit pas la tendance parabolique des données.
Transformation en problème linéaire:
En définissant , le modèle s’écrit:
C’est linéaire en , même si c’est non-linéaire en . On peut appliquer les équations normales dans cet espace.
Modèle quadratique:
coeffs_quad = np.polyfit(x, y, 2)
y_pred_quad = np.polyval(coeffs_quad, x)
mse_quad = np.mean((y - y_pred_quad)**2)
L’EQM est beaucoup plus faible (proche de ). Les coefficients récupérés sont proches des vrais: , , .
Expansion de degré 5:
Avec plus de termes, le modèle peut s’ajuster encore mieux aux données d’entraînement (EQM très faible), mais il risque de capturer le bruit plutôt que le signal. Sur de nouvelles données, les performances se dégradent. C’est le surapprentissage: le modèle a trop de capacité par rapport à la complexité réelle de la relation.
Exercice 2: Validation croisée pour le choix de λ ★★
La validation croisée permet de choisir l’hyperparamètre de Ridge sans utiliser de données de test.
Générez un jeu de données de régression polynomiale ():
np.random.seed(42)
x = np.random.uniform(-3, 3, 50)
y = 0.5*x**3 - x**2 + 2*x + np.random.normal(0, 2, 50)
Créez une matrice de caractéristiques polynomiales de degré 10: .
Implémentez la validation croisée à 5 plis (5-fold CV):
Divisez les données en 5 groupes
Pour chaque :
Entraînez sur 4 plis, évaluez sur le 5ème
Calculez l’EQM moyen sur les 5 plis
Tracez l’EQM de validation en fonction de . Quel choisiriez-vous?
Comparez les performances (sur un ensemble de test séparé) de MCO () et de Ridge avec le optimal.
Solution Exercice 2
1-2. Génération et matrice de caractéristiques:
from sklearn.preprocessing import PolynomialFeatures

np.random.seed(42)
x = np.random.uniform(-3, 3, 50)
y = 0.5*x**3 - x**2 + 2*x + np.random.normal(0, 2, 50)

poly = PolynomialFeatures(degree=10, include_bias=True)
X = poly.fit_transform(x.reshape(-1, 1))
Validation croisée:
from sklearn.model_selection import KFold
from sklearn.linear_model import Ridge

lambdas = np.logspace(-4, 2, 20)
kf = KFold(n_splits=5, shuffle=True, random_state=42)

cv_scores = []
for lam in lambdas:
    fold_scores = []
    for train_idx, val_idx in kf.split(X):
        model = Ridge(alpha=lam, fit_intercept=False)
        model.fit(X[train_idx], y[train_idx])
        y_pred = model.predict(X[val_idx])
        mse = np.mean((y[val_idx] - y_pred)**2)
        fold_scores.append(mse)
    cv_scores.append(np.mean(fold_scores))
Visualisation et choix de λ:
plt.plot(np.log10(lambdas), cv_scores)
plt.xlabel('log10(λ)')
plt.ylabel('EQM de validation')
best_idx = np.argmin(cv_scores)
best_lambda = lambdas[best_idx]
La courbe montre typiquement:
EQM élevé pour très petit (surapprentissage)
EQM minimal pour intermédiaire
EQM qui remonte pour grand (sous-apprentissage)
Le optimal se situe au minimum de la courbe (souvent autour de 10-1 à 100).
Comparaison finale:
MCO avec degré 10 surapprend fortement et a un EQM de test élevé. Ridge avec optimal a un EQM de test beaucoup plus faible car la régularisation empêche les coefficients d’exploser.
Exercice 3: Décomposition biais-variance empirique ★★
Objectif: Visualiser le compromis biais-variance expérimentalement.
Générez 100 jeux de données indépendants à partir du modèle où et avec points par jeu.
Pour chaque degré polynomial :
Ajustez un polynôme sur chacun des 100 jeux de données
Pour un point test fixé , collectez les 100 prédictions
Calculez pour chaque degré :
Le biais² : où
La variance :
L’erreur totale : biais² + variance
Tracez biais², variance, et erreur totale en fonction du degré .
Vérifiez que le degré minimisant l’erreur totale correspond à celui qui généralise le mieux.
Solution Exercice 3
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
n_datasets = 100
n_points = 20
sigma = 0.3
x_test = np.pi  # point test fixé
true_value = np.sin(x_test)

degrees = [1, 3, 5, 10, 15]
bias_sq = []
variance = []

for deg in degrees:
    predictions = []
    for _ in range(n_datasets):
        # Générer un jeu de données
        x = np.random.uniform(0, 2*np.pi, n_points)
        y = np.sin(x) + np.random.normal(0, sigma, n_points)

        # Ajuster le polynôme
        coeffs = np.polyfit(x, y, deg)
        y_pred = np.polyval(coeffs, x_test)
        predictions.append(y_pred)

    predictions = np.array(predictions)
    mean_pred = np.mean(predictions)

    # Biais²
    bias_sq.append((mean_pred - true_value)**2)

    # Variance
    variance.append(np.var(predictions))

bias_sq = np.array(bias_sq)
variance = np.array(variance)
total_error = bias_sq + variance

plt.figure(figsize=(8, 5))
plt.plot(degrees, bias_sq, 'o-', label='Biais²')
plt.plot(degrees, variance, 's-', label='Variance')
plt.plot(degrees, total_error, '^-', label='Erreur totale')
plt.axhline(sigma**2, color='gray', linestyle='--', label=f'Bruit σ²={sigma**2:.2f}')
plt.xlabel('Degré du polynôme')
plt.ylabel('Erreur')
plt.legend()
plt.title('Décomposition biais-variance')
Observations:
Le biais diminue avec le degré: les modèles complexes approchent mieux
La variance augmente avec le degré: plus de paramètres → plus sensible aux fluctuations
L’erreur totale a une forme en U: le minimum est autour de degré 3-5
Le degré optimal n’est ni trop simple (biais) ni trop complexe (variance)
Exercice 4: Courbes d’apprentissage ★
Objectif: Observer la convergence du risque empirique vers le risque.
Générez points de régression linéaire: avec et .
Réservez 500 points pour le test (données fraîches, jamais utilisées pour l’entraînement).
Pour des tailles d’entraînement :
Entraînez un modèle linéaire sur les premiers points
Calculez l’EQM sur l’ensemble d’entraînement (erreur train)
Calculez l’EQM sur l’ensemble de test (erreur test)
Tracez les deux courbes d’erreur en fonction de .
À quelle taille les deux courbes se rejoignent-elles approximativement? Que signifie cet écart?
Solution Exercice 4
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
N = 1000

# Générer toutes les données
x_all = np.random.uniform(0, 10, N)
y_all = 2*x_all + 3 + np.random.normal(0, 1, N)

# Séparer train et test
x_test, y_test = x_all[500:], y_all[500:]

train_sizes = [10, 20, 50, 100, 200, 500]
train_errors = []
test_errors = []

for n in train_sizes:
    x_train, y_train = x_all[:n], y_all[:n]

    # Ajuster le modèle linéaire
    X_train = np.column_stack([np.ones(n), x_train])
    theta = np.linalg.lstsq(X_train, y_train, rcond=None)[0]

    # Erreur d'entraînement
    y_pred_train = X_train @ theta
    train_errors.append(np.mean((y_train - y_pred_train)**2))

    # Erreur de test
    X_test = np.column_stack([np.ones(500), x_test])
    y_pred_test = X_test @ theta
    test_errors.append(np.mean((y_test - y_pred_test)**2))

plt.figure(figsize=(8, 5))
plt.plot(train_sizes, train_errors, 'o-', label='Erreur train')
plt.plot(train_sizes, test_errors, 's-', label='Erreur test')
plt.axhline(1.0, color='gray', linestyle='--', label='Bruit σ²=1')
plt.xlabel('Taille d\'entraînement n')
plt.ylabel('EQM')
plt.legend()
plt.title('Courbes d\'apprentissage')
Observations:
L’erreur d’entraînement augmente légèrement avec (moins de surapprentissage)
L’erreur de test diminue avec (meilleure généralisation)
Les courbes convergent vers (le bruit irréductible)
L’écart entre les deux courbes est l’écart de généralisation
Avec , les courbes sont proches: le modèle généralise bien
Exercice 5: Choix du degré polynomial ★★
Objectif: Pratiquer la sélection de modèle avec un ensemble de validation.
Générez points selon avec et .
Divisez les données: 70% entraînement, 30% validation.
Pour chaque degré :
Ajustez un polynôme de degré sur l’ensemble d’entraînement
Calculez l’EQM sur l’ensemble de validation
Tracez l’EQM de validation en fonction du degré. Quel degré minimise l’erreur de validation?
Comparez le degré sélectionné avec le vrai degré (3). Discutez des cas où ils pourraient différer.
Solution Exercice 5
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
N = 50
x = np.random.uniform(-3, 3, N)
y = 0.5*x**3 - x**2 + 2*x + np.random.normal(0, 2, N)

# Split train/validation
n_train = int(0.7 * N)
indices = np.random.permutation(N)
train_idx, val_idx = indices[:n_train], indices[n_train:]
x_train, y_train = x[train_idx], y[train_idx]
x_val, y_val = x[val_idx], y[val_idx]

degrees = range(1, 11)
val_errors = []

for deg in degrees:
    coeffs = np.polyfit(x_train, y_train, deg)
    y_pred_val = np.polyval(coeffs, x_val)
    val_errors.append(np.mean((y_val - y_pred_val)**2))

best_degree = degrees[np.argmin(val_errors)]

plt.figure(figsize=(8, 5))
plt.plot(degrees, val_errors, 'o-')
plt.axvline(best_degree, color='r', linestyle='--', label=f'Meilleur: {best_degree}')
plt.axvline(3, color='g', linestyle=':', label='Vrai degré: 3')
plt.xlabel('Degré du polynôme')
plt.ylabel('EQM de validation')
plt.legend()
plt.title('Sélection du degré par validation')
Discussion:
Le degré sélectionné est souvent proche de 3, mais pas toujours exactement 3
Avec peu de données (N=50), la variance de l’estimation est élevée
Un degré légèrement supérieur (4 ou 5) peut être sélectionné si le bruit crée des patterns
Un degré inférieur peut être sélectionné si les données ne montrent pas clairement la cubique
La validation croisée (au lieu d’un simple split) réduirait cette variabilité
Exercice 6: Double descente (optionnel) ★★★
Objectif: Explorer le régime d’interpolation moderne.
Le phénomène de double descente contredit l’intuition classique: au-delà d’un certain seuil de complexité, l’erreur de test peut diminuer à nouveau.
Générez points selon avec et uniformément espacé sur .
Pour chaque degré :
Ajustez un polynôme de degré (utilisez
np.polyfitavecfull=False)Calculez l’EQM sur un ensemble de test de 100 points
Tracez l’EQM de test en fonction du degré.
Identifiez le point d’interpolation: le degré à partir duquel le modèle peut passer exactement par tous les points d’entraînement.
Observez la forme de la courbe: y a-t-il une remontée puis une redescente de l’erreur?
Discutez des implications pour le deep learning, où les réseaux ont souvent plus de paramètres que de données.
Solution Exercice 6
import numpy as np
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings('ignore')

np.random.seed(42)
N = 20
x_train = np.linspace(0, 2*np.pi, N)
y_train = np.sin(x_train) + np.random.normal(0, 0.2, N)

# Ensemble de test
x_test = np.linspace(0, 2*np.pi, 100)
y_test = np.sin(x_test)

degrees = range(1, 31)
test_errors = []
train_errors = []

for deg in degrees:
    try:
        coeffs = np.polyfit(x_train, y_train, deg)
        y_pred_train = np.polyval(coeffs, x_train)
        y_pred_test = np.polyval(coeffs, x_test)
        train_errors.append(np.mean((y_train - y_pred_train)**2))
        test_errors.append(np.mean((y_test - y_pred_test)**2))
    except:
        train_errors.append(np.nan)
        test_errors.append(np.nan)

plt.figure(figsize=(10, 5))
plt.semilogy(degrees, test_errors, 'o-', label='Erreur test')
plt.semilogy(degrees, train_errors, 's-', label='Erreur train', alpha=0.5)
plt.axvline(N-1, color='r', linestyle='--', label=f'Interpolation (d={N-1})')
plt.xlabel('Degré du polynôme')
plt.ylabel('EQM (échelle log)')
plt.legend()
plt.title('Phénomène de double descente')
Observations:
Point d’interpolation: degré . À ce degré, le polynôme a exactement coefficients et peut passer par tous les points.
Forme de la courbe:
Degré 1-5: erreur test diminue (gain d’expressivité)
Degré 5-19: erreur test augmente (surapprentissage classique)
Degré > 19: erreur test peut diminuer! (double descente)
L’erreur d’entraînement atteint 0 au point d’interpolation.
Implications pour le deep learning:
Les réseaux profonds sont souvent dans le régime «sur-paramétrisé» (plus de paramètres que de données)
Contrairement à l’intuition classique, ils peuvent bien généraliser même en interpolant les données
La régularisation implicite (SGD, early stopping) et la structure du réseau jouent un rôle clé
Ce phénomène explique en partie pourquoi les très grands modèles peuvent surpasser les modèles de taille «optimale»