Le chapitre précédent a traité la régression: prédire une valeur continue à partir d’entrées . Ce chapitre aborde le problème de classification: prédire une catégorie parmi un ensemble fini de classes.
La régression logistique est le pendant de la régression linéaire pour la classification. Malgré son nom, c’est bien un modèle de classification, pas de régression. Comme pour les moindres carrés, nous cherchons une combinaison linéaire des entrées, mais nous transformons cette combinaison pour produire des probabilités de classe.
Source
import numpy as np
import matplotlib.pyplot as plt

# Configuration pour des figures haute résolution
%config InlineBackend.figure_format = 'retina'
La régression logistique binaire
Du score à la probabilité
En régression, le modèle produit directement une prédiction . En classification binaire, nous voulons plutôt une probabilité: quelle est la chance que l’exemple appartienne à la classe positive?
Une première idée serait de prendre , mais cela pose problème: une combinaison linéaire peut produire n’importe quelle valeur réelle, pas seulement une probabilité entre 0 et 1.
La solution est d’appliquer une fonction de transformation. La fonction sigmoïde (ou fonction logistique) transforme n’importe quel nombre réel en une valeur dans l’intervalle :
Source
import numpy as np
import matplotlib.pyplot as plt

a = np.linspace(-6, 6, 200)
sigma = 1 / (1 + np.exp(-a))

fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(a, sigma, 'C0-', linewidth=2)
ax.axhline(0.5, color='gray', linestyle='--', alpha=0.5)
ax.axvline(0, color='gray', linestyle='--', alpha=0.5)

ax.set_xlabel('$a = \\boldsymbol{\\theta}^\\top \\mathbf{x}$')
ax.set_ylabel('$\\sigma(a) = P(y=1|\\mathbf{x})$')
ax.set_title('La fonction sigmoïde transforme un score en probabilité')
ax.set_xlim(-6, 6)
ax.set_ylim(-0.05, 1.05)

# Annotations
ax.annotate('$a < 0$: classe 0 plus probable', xy=(-4, 0.1), fontsize=10, color='C1')
ax.annotate('$a > 0$: classe 1 plus probable', xy=(1.5, 0.9), fontsize=10, color='C0')
ax.annotate('$a = 0$: équiprobable', xy=(0.2, 0.55), fontsize=10, color='gray')

plt.tight_layout()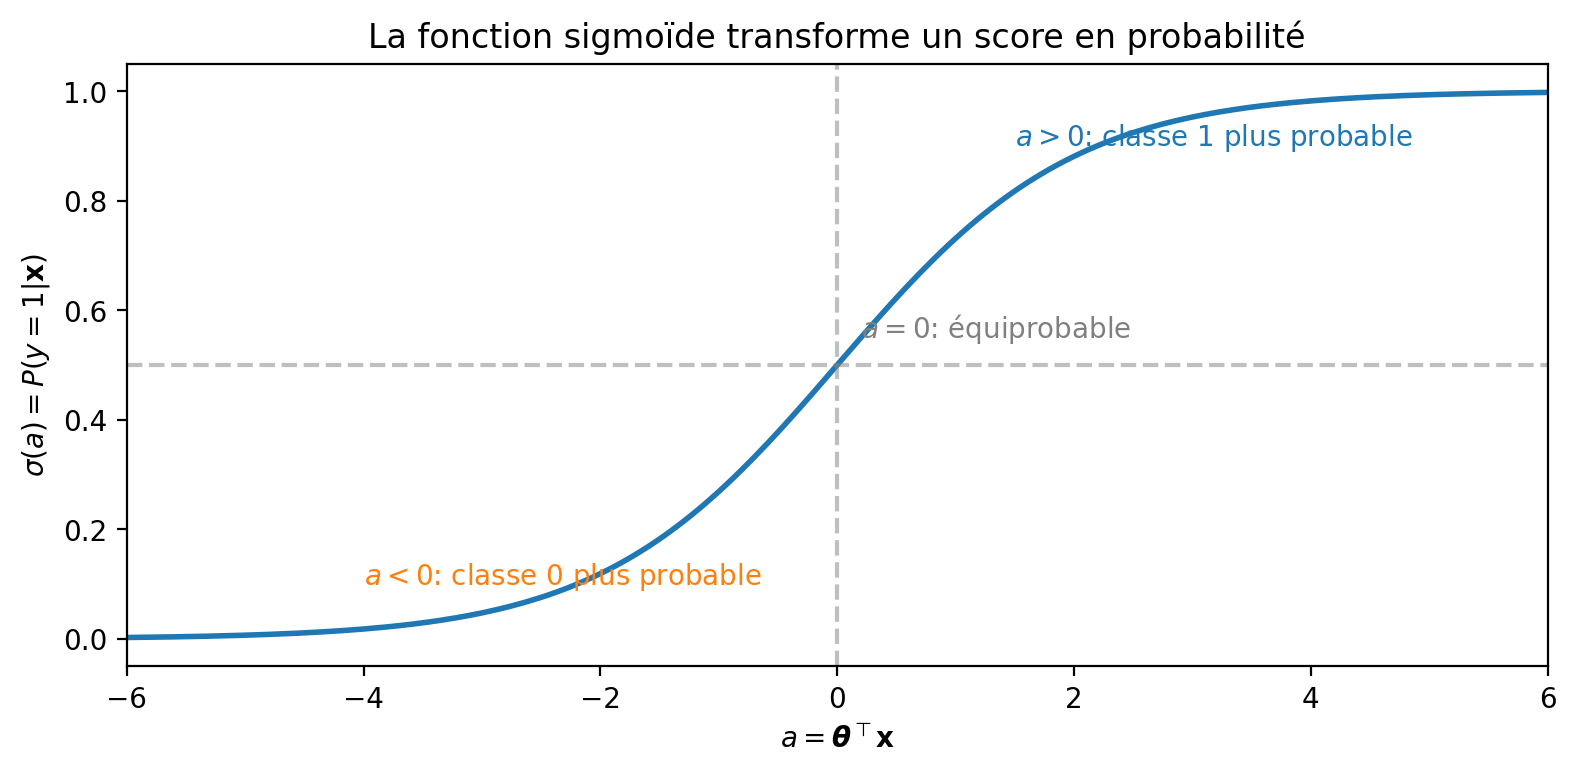
Le modèle probabiliste
La régression logistique binaire modélise la probabilité de la classe positive comme:
où inclut le biais (en ajoutant un 1 aux entrées). La probabilité de la classe négative est simplement le complément:
En notation compacte, la distribution sur est une distribution de Bernoulli:
où est la probabilité prédite pour la classe positive.
Le logit et le rapport de cotes
La quantité avant la transformation sigmoïde s’appelle le logit. Pourquoi ce nom? En inversant la relation , on obtient:
Cette quantité est le logarithme du rapport de cotes (odds ratio en anglais). La cote (odds) est le rapport entre la probabilité de succès et la probabilité d’échec: si , la cote est , ce qui signifie que le succès est trois fois plus probable que l’échec.
Si , les deux classes sont équiprobables (). Si , la classe 1 est plus probable; si , c’est la classe 0. La valeur absolue de mesure la confiance: plus est grand, plus le modèle est certain de sa prédiction.
Interprétation des coefficients
Cette formulation via le logit a une conséquence pratique importante: elle permet d’interpréter directement les coefficients .
Puisque , une augmentation de d’une unité (toutes les autres variables restant constantes) augmente le logit de :
En termes de cotes, si nous notons , alors:
Le coefficient représente donc le changement dans le logarithme de cote pour une augmentation unitaire de , et est le facteur multiplicatif sur la cote.
La frontière de décision
Pour classifier, nous prédisons la classe la plus probable:
La frontière de décision est l’ensemble des points où les deux classes sont équiprobables:
C’est un hyperplan dans l’espace des entrées. En 2D, c’est une droite; en 3D, un plan. Le vecteur est perpendiculaire à cet hyperplan et pointe vers la région de classe 1.
Source
import numpy as np
import matplotlib.pyplot as plt

# Générer des données linéairement séparables
np.random.seed(42)
n_per_class = 50

# Classe 0: centrée en (-1, -1)
X0 = np.random.randn(n_per_class, 2) * 0.8 + np.array([-1, -1])
# Classe 1: centrée en (1, 1)
X1 = np.random.randn(n_per_class, 2) * 0.8 + np.array([1, 1])

X = np.vstack([X0, X1])
y = np.array([0] * n_per_class + [1] * n_per_class)

# Ajustement simple (pour illustration)
# Supposons theta = [0, 1, 1] (avec biais)
theta = np.array([1, 1])  # sans biais pour simplifier

fig, ax = plt.subplots(figsize=(8, 6))

# Points
ax.scatter(X0[:, 0], X0[:, 1], c='C1', label='Classe 0', alpha=0.7, edgecolor='white')
ax.scatter(X1[:, 0], X1[:, 1], c='C0', label='Classe 1', alpha=0.7, edgecolor='white')

# Frontière de décision: theta[0]*x1 + theta[1]*x2 = 0 => x2 = -x1
x_line = np.linspace(-3, 3, 100)
y_line = -x_line  # Pour theta = [1, 1], frontière est x1 + x2 = 0
ax.plot(x_line, y_line, 'k-', linewidth=2, label='Frontière de décision')

# Vecteur normal (theta)
ax.arrow(0, 0, 0.8, 0.8, head_width=0.15, head_length=0.1, fc='green', ec='green')
ax.text(0.9, 0.6, '$\\boldsymbol{\\theta}$', fontsize=14, color='green')

# Régions
ax.fill_between(x_line, y_line, 3, alpha=0.1, color='C0')
ax.fill_between(x_line, y_line, -3, alpha=0.1, color='C1')

ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Frontière de décision linéaire')
ax.set_xlim(-3, 3)
ax.set_ylim(-3, 3)
ax.set_aspect('equal')
ax.legend()

plt.tight_layout()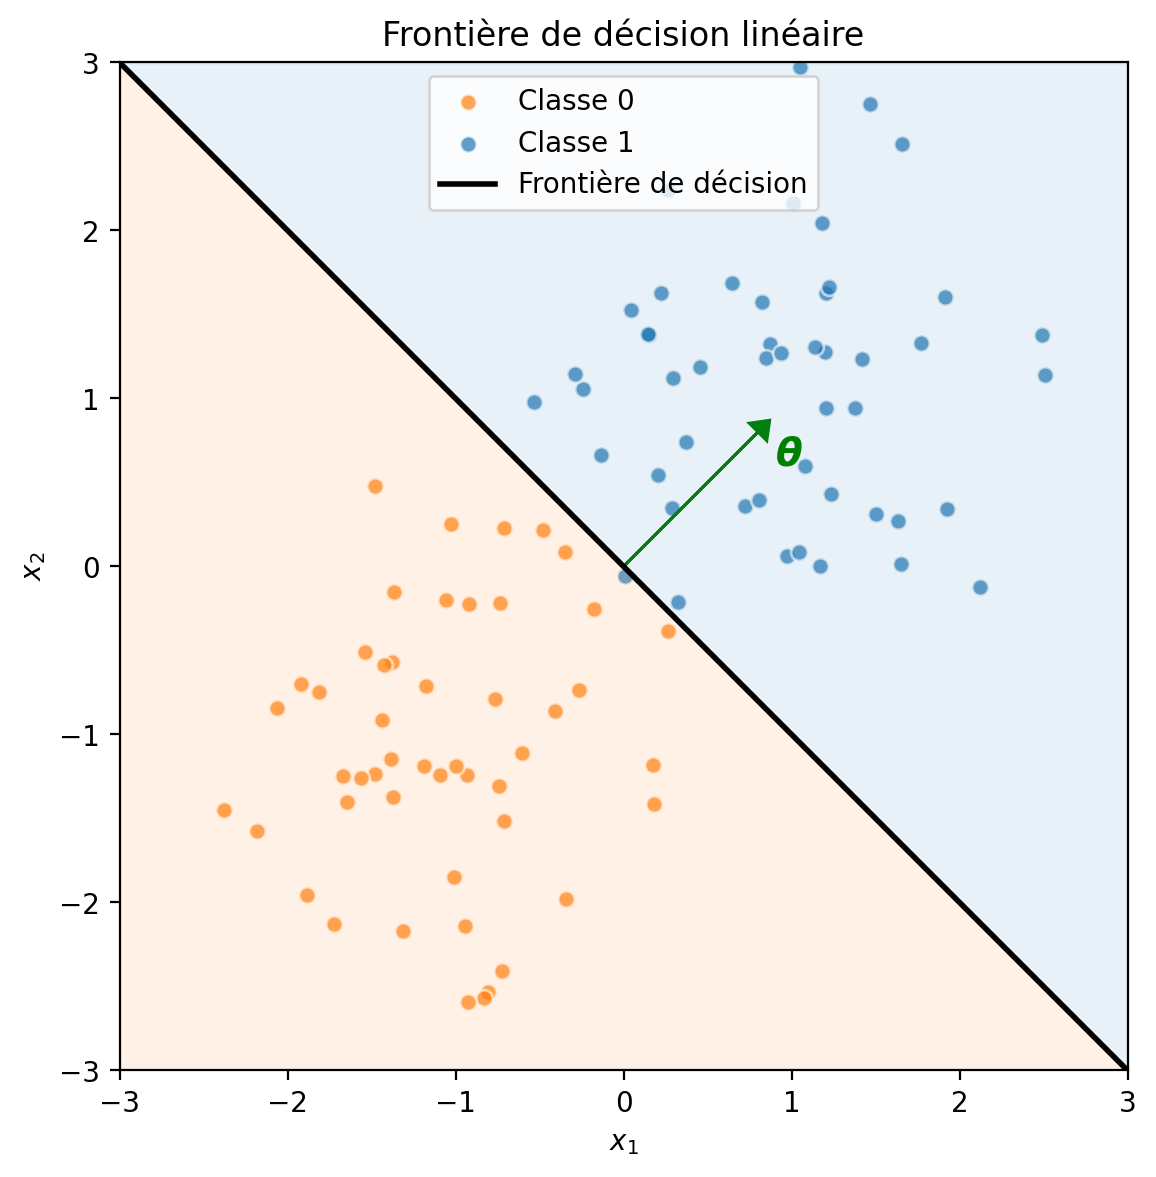
Les données sont dites linéairement séparables si une frontière linéaire peut les séparer parfaitement. Dans ce cas, il existe des paramètres tels que toutes les prédictions sont correctes. En pratique, les données réelles sont rarement parfaitement séparables.
Estimation par maximum de vraisemblance
Construction de la vraisemblance
Comment trouver les paramètres ? Le chapitre 1 a introduit le principe du maximum de vraisemblance: choisir les paramètres qui rendent les données observées les plus probables. Nous avons vu au chapitre 2 que ce principe, appliqué à un modèle gaussien, donne les moindres carrés. Appliquons maintenant ce même principe à la classification.
Sous l’hypothèse i.i.d. (rappel: les exemples sont tirés indépendamment de la même distribution), la vraisemblance est le produit des probabilités pour chaque exemple:
où .
La log-vraisemblance négative est l’entropie croisée
Pour l’optimisation, nous travaillons avec la log-vraisemblance négative (LVN):
Cette expression porte un nom: c’est l’entropie croisée binaire. Pour un seul exemple:
Ainsi, minimiser la LVN revient à minimiser l’entropie croisée moyenne sur les données d’entraînement:
C’est un résultat fondamental: l’entropie croisée n’est pas un choix arbitraire de fonction de perte. Elle découle directement du maximum de vraisemblance appliqué au modèle de Bernoulli. Nous retrouvons le même schéma qu’au chapitre 2: le choix du modèle probabiliste (gaussien ou Bernoulli) détermine la fonction de perte optimale (quadratique ou entropie croisée).
Calcul du gradient
Le gradient de la LVN a une forme remarquablement simple:
Conventions de notation pour les dérivées
Deux conventions coexistent pour les dérivées de fonctions vectorielles: la disposition numérateur et la disposition dénominateur. Pour le gradient d’un scalaire par rapport à un vecteur colonne :
Convention numérateur: est un vecteur ligne ()
Convention dénominateur: est un vecteur colonne ()
Ce livre utilise la convention dénominateur: le gradient a la même forme que . Cette cohérence dimensionnelle simplifie l’écriture des mises à jour .
Conseil pratique: En cas de doute, vérifiez les dimensions. Si et , alors doit être dans pour que la soustraction ait un sens.
Dérivation du gradient
Le gradient est une moyenne pondérée des entrées, où le poids est l’erreur de prédiction :
Si et est proche de 1, l’erreur est faible et la contribution au gradient est petite.
Si et est proche de 0, l’erreur est grande (-1) et le gradient pousse dans la direction de .
Cette forme est analogue au gradient des moindres carrés: .
Convexité de l’objectif
La LVN de la régression logistique est strictement convexe. La matrice hessienne est:
où est une matrice diagonale avec des éléments positifs (car ).
Pour tout vecteur :
La hessienne est donc semi-définie positive (définie positive si est de rang plein). La LVN admet un unique minimum global, ce qui garantit que l’optimisation convergera vers la même solution peu importe l’initialisation.
Régression logistique multiclasse
Le modèle probabiliste catégoriel
Pour la classification binaire, nous avons utilisé la distribution de Bernoulli: la sortie suit , où le paramètre est la probabilité de la classe 1. La contrainte est garantie par la fonction sigmoïde appliquée à la sortie linéaire.
Pour la classification à classes, la généralisation naturelle est la distribution catégorielle (aussi appelée multinoulli). La sortie suit:
où est la probabilité de la classe . Ces probabilités doivent satisfaire deux contraintes:
Positivité: pour tout
Normalisation:
Le parallèle avec les chapitres précédents est complet:
| Problème | Distribution | Paramètre(s) | Contrainte | Fonction |
|---|---|---|---|---|
| Régression | Identité | |||
| Classification binaire | Sigmoïde | |||
| Classification multiclasse | , | Softmax |
La fonction softmax
Nous avons besoin d’une fonction qui transforme scores réels en un vecteur de probabilités valide. La fonction softmax remplit exactement ce rôle:
où est le vecteur de logits (un score par classe), et est la matrice de paramètres.
Pourquoi l’exponentielle? Elle garantit les deux contraintes:
Positivité: pour tout , donc
Normalisation: la division par assure que
C’est la même idée que pour la sigmoïde: nous utilisons une transformation non linéaire pour projeter la sortie linéaire dans l’espace des paramètres valides de la distribution.
Stabilité numérique. L’implémentation naïve pose un problème: si les logits sont grands (par exemple ), l’exponentielle déborde vers l’infini. L’astuce consiste à soustraire le maximum avant d’exponencier:
où . Cette transformation ne change pas le résultat (le facteur s’annule entre numérateur et dénominateur) mais garantit que le plus grand exposant vaut 0, évitant tout débordement. C’est le cœur de l’astuce dite log-sum-exp.
Source
import numpy as np
import matplotlib.pyplot as plt

def softmax(a):
    a_max = np.max(a)  # Soustraire le max pour la stabilité
    exp_a = np.exp(a - a_max)
    return exp_a / np.sum(exp_a)

# Exemple avec 3 classes
logits = np.array([2.0, 1.0, 0.5])
probs = softmax(logits)

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

# Logits
ax = axes[0]
bars = ax.bar(['Classe 0', 'Classe 1', 'Classe 2'], logits, color=['C0', 'C1', 'C2'])
ax.set_ylabel('Logit $a_c$')
ax.set_title('Scores bruts (logits)')
ax.axhline(0, color='gray', linestyle='--', alpha=0.5)

# Probabilities
ax = axes[1]
bars = ax.bar(['Classe 0', 'Classe 1', 'Classe 2'], probs, color=['C0', 'C1', 'C2'])
ax.set_ylabel('Probabilité $p(y=c|\\mathbf{x})$')
ax.set_title('Après softmax: distribution de probabilité')
ax.set_ylim(0, 1)

# Add probability values on bars
for bar, p in zip(bars, probs):
    ax.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.02,
            f'{p:.2f}', ha='center', fontsize=11)

plt.tight_layout()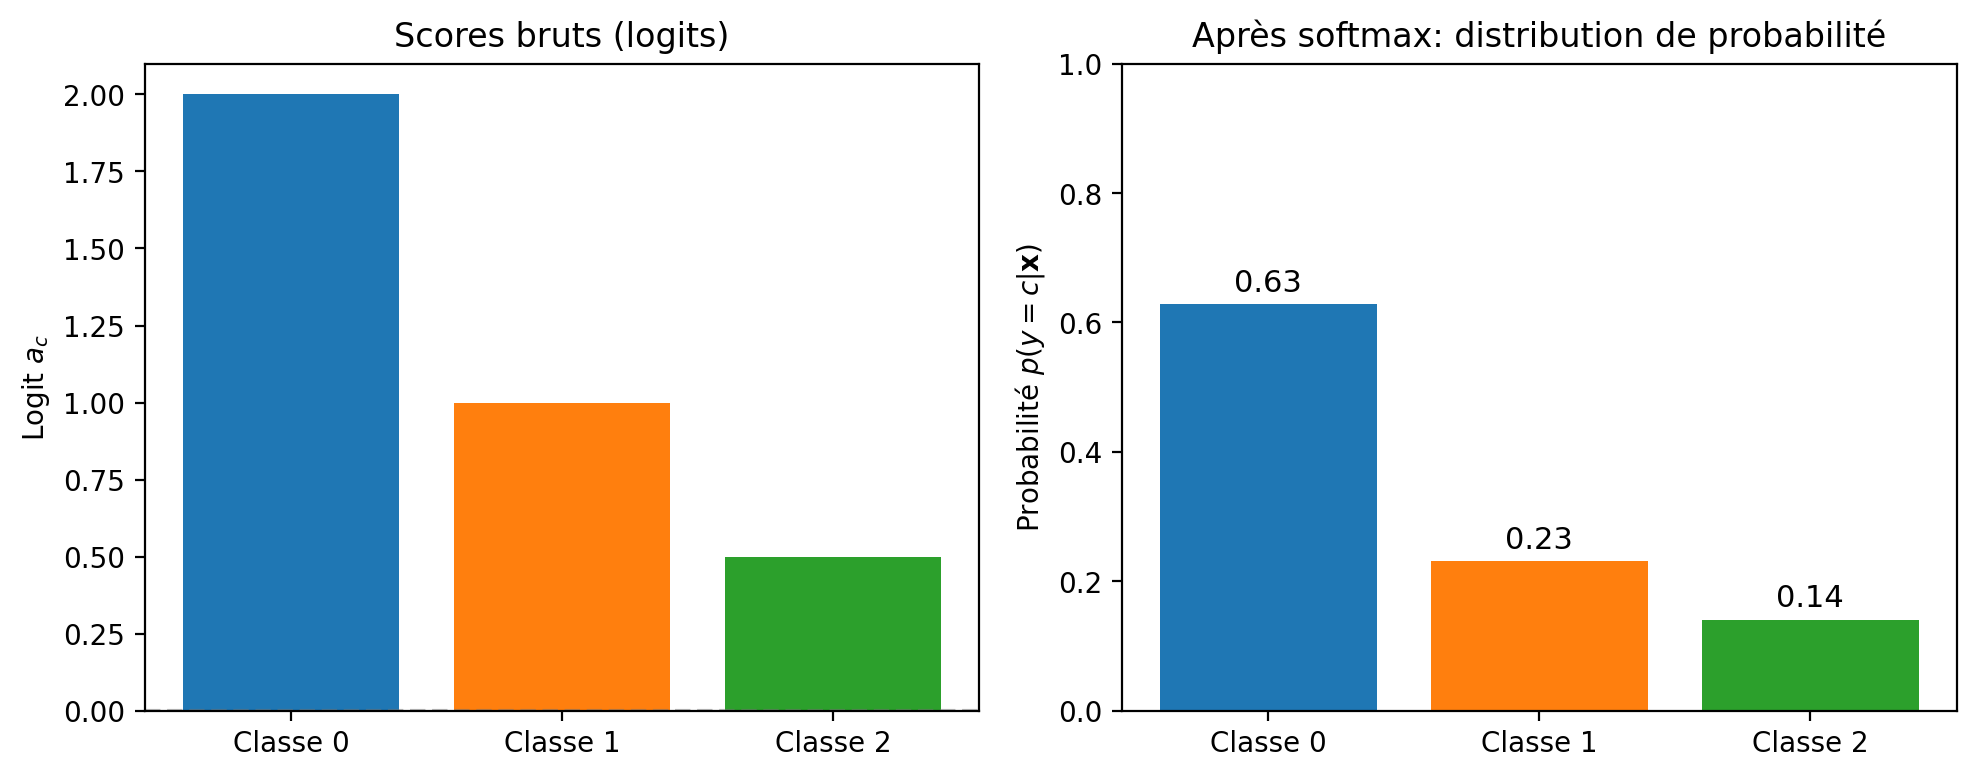
Entropie croisée catégorielle
Appliquons le maximum de vraisemblance à la distribution catégorielle, exactement comme nous l’avons fait pour Bernoulli. La vraisemblance d’une observation est la probabilité assignée à la vraie classe:
Cette forme produit est l’écriture générale de la distribution catégorielle, où vaut 1 si et 0 sinon. En prenant le logarithme:
En notant l’encodage one-hot de l’étiquette, la log-vraisemblance négative sur observations est:
C’est l’entropie croisée catégorielle. Puisque est nul sauf pour la vraie classe, cette expression se simplifie en:
C’est simplement la moyenne du logarithme négatif de la probabilité assignée à la vraie classe. Comme pour le cas binaire, l’entropie croisée n’est pas un choix arbitraire: elle découle directement du maximum de vraisemblance appliqué au modèle catégoriel.
Calcul efficace: logsumexp suffit
Une observation permet de simplifier considérablement l’implémentation. Développons la perte pour un exemple de classe :
Cette expression ne contient que le logit de la vraie classe et le log-sum-exp des logits. Nous n’avons jamais besoin de calculer les probabilités softmax elles-mêmes! La perte s’écrit directement:
où se calcule de manière stable comme expliqué précédemment.
Cette formulation est à la fois plus stable numériquement et plus efficace: pas de division, pas d’intermédiaires à stocker. C’est pourquoi les bibliothèques comme PyTorch combinent softmax et entropie croisée en une seule opération. La fonction torch.nn.CrossEntropyLoss prend en entrée les logits (scores bruts), pas les probabilités, et applique cette simplification en interne.
Source
import numpy as np

def logsumexp(a):
    """Log-sum-exp stable"""
    a_max = np.max(a)
    return a_max + np.log(np.sum(np.exp(a - a_max)))

def cross_entropy_naive(logits, y):
    """Version naïve: softmax puis log"""
    exp_a = np.exp(logits - np.max(logits))
    probs = exp_a / np.sum(exp_a)
    return -np.log(probs[y])

def cross_entropy_direct(logits, y):
    """Version directe: logsumexp seulement"""
    return -logits[y] + logsumexp(logits)

# Test d'équivalence
logits = np.array([2.0, 1.0, 0.5])
y = 0  # vraie classe

print(f"Via softmax:  {cross_entropy_naive(logits, y):.6f}")
print(f"Via logsumexp: {cross_entropy_direct(logits, y):.6f}")
Via softmax: 0.464369
Via logsumexp: 0.464369
Les deux méthodes donnent le même résultat, mais la version directe est préférable en pratique.
Cas binaire comme cas particulier
Pour classes, la fonction softmax se réduit à la sigmoïde. En effet, si :
En posant (la différence de scores), on retrouve exactement le modèle binaire.
Préférences et le modèle de Bradley-Terry
Le succès des grands modèles de langage repose en grande partie sur notre capacité à les aligner sur les préférences humaines. Un modèle pré-entraîné sur des téraoctets de texte sait prédire le mot suivant, mais cela ne suffit pas pour en faire un assistant utile qui répond selon nos attentes et nos valeurs. Pour y arriver, il faut pouvoir exprimer ce que nous préférons, puis transformer ces préférences en un signal d’optimisation.
La notion de préférence est simple: étant donné deux réponses et à une même question, un annotateur humain indique laquelle est meilleure. On collecte ainsi un ensemble de comparaisons par paires qui forme un jeu de données supervisé. Le modèle de Bradley-Terry permet de convertir ces jugements qualitatifs en scores numériques, et donc en une fonction de récompense utilisable pour l’optimisation. Ce qui est remarquable, c’est que ce modèle n’est rien d’autre qu’une régression logistique sur une matrice de conception particulière. Maintenant que nous maîtrisons la régression logistique, nous pouvons comprendre exactement comment cela fonctionne.
L’idée est d’attribuer un score à chaque réponse et de modéliser la probabilité que soit préférée à par
où est la fonction sigmoïde que nous connaissons bien. Pourquoi cette formulation? La sigmoïde transforme la différence de scores en une probabilité. Quand a un score beaucoup plus élevé que , la différence est grande et positive, donc est proche de 1: gagne presque certainement. Quand les scores sont proches, la différence est près de zéro et : le résultat est incertain, presque un pile ou face. Et quand domine, la différence est négative et la probabilité que gagne devient faible. La différence de scores contrôle donc à quel point le résultat est prévisible.
Ces scores sont dits latents car nous ne les observons pas directement: nous ne voyons que les résultats des comparaisons, et nous devons inférer les scores à partir de ces observations.
Cette formulation est exactement une régression logistique. Pour le voir, supposons que nous avons objets à comparer (des réponses, des joueurs d’échecs, des produits). Chaque objet possède un score que nous voulons estimer. Si nous observons le résultat d’une comparaison entre les objets et , nous pouvons construire un vecteur qui vaut +1 à la position , -1 à la position , et 0 partout ailleurs. Le produit scalaire avec le vecteur de scores donne alors , exactement la différence qui entre dans la sigmoïde.
Prenons un exemple concret. Supposons quatre joueurs (ou quatre réponses) et cinq comparaisons observées:
| Comparaison | Gagnant | |
|---|---|---|
| 0 vs 2 | 0 | 1 |
| 1 vs 3 | 1 | 1 |
| 0 vs 1 | 1 | 0 |
| 2 vs 3 | 2 | 1 |
| 1 vs 2 | 1 | 1 |
La matrice de conception et le vecteur cible correspondants sont:
Chaque ligne de encode une comparaison: un +1 pour le premier objet comparé, un -1 pour le second, et des zéros ailleurs. L’étiquette indique que le premier objet a gagné, que le second a gagné.
Une fois la régression logistique ajustée sur cette matrice, nous obtenons un vecteur de paramètres . Mais comment récupérer les scores des objets? La réponse est simple: les paramètres sont exactement les scores . En effet, le modèle prédit . Pour une comparaison entre et , le vecteur a un +1 en position et un -1 en position , donc . En identifiant avec , on voit que pour tout . Les coefficients de la régression logistique nous donnent directement les scores de chaque objet.
Source
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression

np.random.seed(42)
true_strengths = np.array([2.0, 1.0, 0.0, -1.0])
n_players = len(true_strengths)

# Générer des matchs et construire la matrice de conception
n_matches = 200
X = []
y = []
for _ in range(n_matches):
    i, j = np.random.choice(n_players, 2, replace=False)
    row = np.zeros(n_players)
    row[i] = 1
    row[j] = -1
    X.append(row)
    prob_i_wins = 1 / (1 + np.exp(-(true_strengths[i] - true_strengths[j])))
    y.append(int(np.random.random() < prob_i_wins))

X = np.array(X)
y = np.array(y)

# Régression logistique standard de scikit-learn
model = LogisticRegression(fit_intercept=False, C=1e6)
model.fit(X, y)
s_est = model.coef_[0]
s_est -= s_est.mean()  # Centrer (les scores sont définis à une constante près)

# Visualisation
fig, ax = plt.subplots(figsize=(8, 4))
x_pos = np.arange(n_players)
width = 0.35
ax.bar(x_pos - width/2, true_strengths - true_strengths.mean(), width,
       label='Scores vrais', color='steelblue', alpha=0.7)
ax.bar(x_pos + width/2, s_est, width,
       label='Scores estimés', color='coral', alpha=0.7)
ax.set_xlabel('Joueur')
ax.set_ylabel('Score (centré)')
ax.set_title(f'Estimation des scores à partir de {n_matches} matchs')
ax.set_xticks(x_pos)
ax.set_xticklabels([f'Joueur {i}' for i in range(n_players)])
ax.legend()
ax.axhline(0, color='gray', linestyle='--', alpha=0.3)
plt.tight_layout()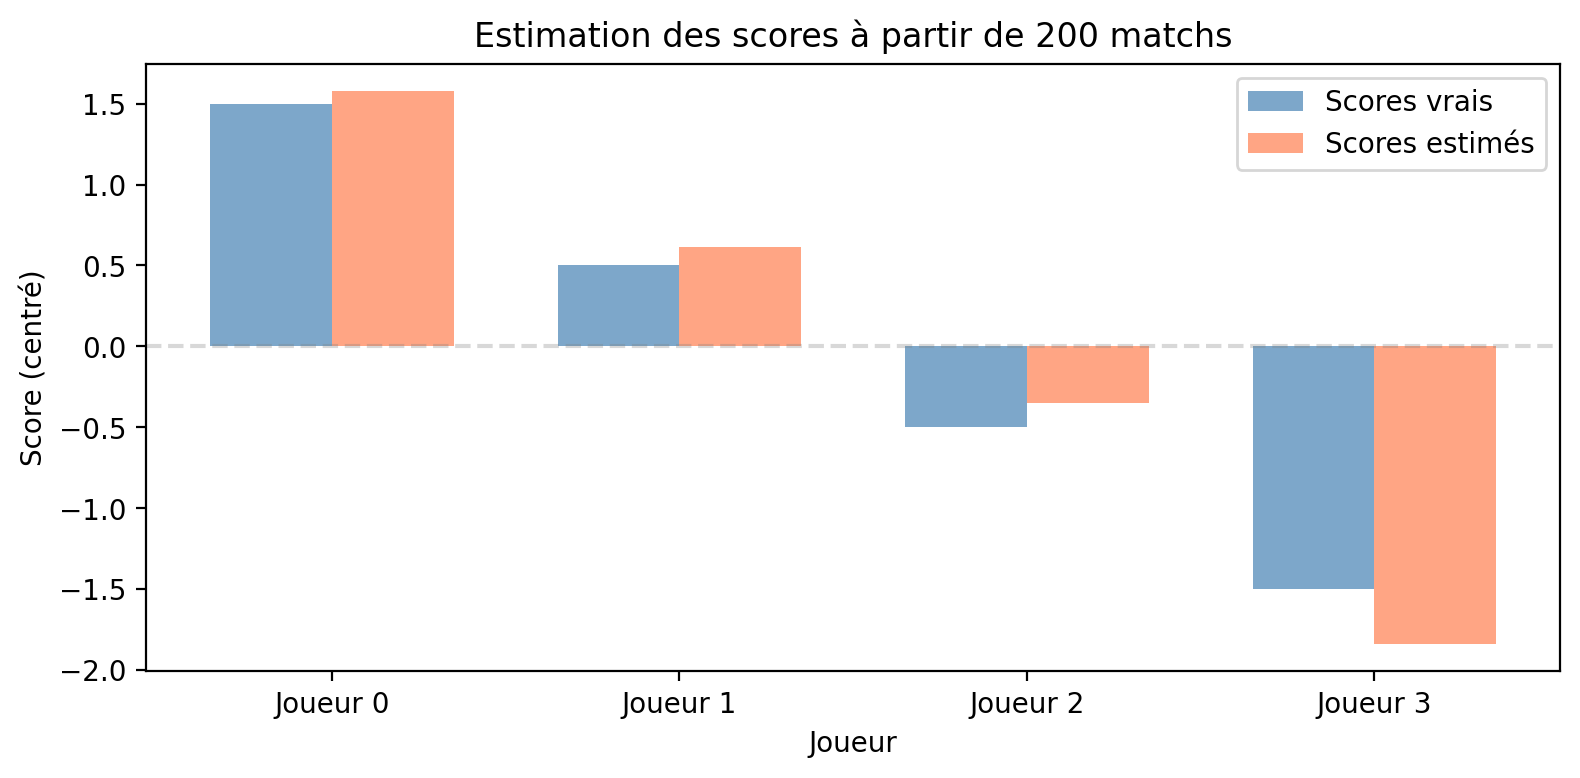
Le code utilise directement LogisticRegression de scikit-learn sur la matrice de conception que nous venons de décrire. Les scores estimés correspondent bien aux scores vrais utilisés pour générer les données. Remarquez que les scores sont définis à une constante additive près: ajouter 10 à tous les scores ne change pas les probabilités de préférence, car seule la différence intervient.
Ce modèle, proposé par Bradley & Terry (1952), trouve des applications bien au-delà des échecs. Les moteurs de recherche l’utilisent pour ordonner les résultats selon les clics des utilisateurs: si un utilisateur clique sur le troisième résultat plutôt que sur le premier, cela révèle une préférence. Les systèmes de recommandation s’en servent pour comparer des produits. Et dans le contexte du RLHF, le score devient une fonction de récompense: étant donné une réponse générée par le modèle de langage, le score prédit sa qualité telle que jugée par des humains. Cette récompense guide ensuite l’optimisation du modèle pour qu’il produise des réponses de meilleure qualité.
Application: préférences acoustiques en salle de concert
Appliquons ce modèle à des données réelles. Le jeu de données provient d’expériences d’acoustique menées à l’Université Technique du Danemark par A.C. Gade et analysées par Kousgaard (1984). Des auditeurs ont comparé des paires de champs sonores dans une salle de concert et indiqué lequel ils préféraient pour écouter de la musique. Chaque champ sonore est caractérisé par trois facteurs physiques: la présence ou non d’un son direct (ligne de vue libre ou obstruée vers la source), le niveau de réflexion (-26 dB ou -20 dB) et le niveau de réverbération (-24 dB ou -20 dB). Ces trois facteurs binaires donnent configurations possibles, nommées par leur code binaire: «000» pour la configuration sans son direct, faible réflexion et faible réverbération, jusqu’à «111» pour la configuration avec tous les facteurs au niveau élevé.
Source
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression

# Charger les données
comparisons = pd.read_csv('data/sound_fields_comparisons.csv')
design = pd.read_csv('data/sound_fields_design.csv', index_col=0)

# Convertir l'index en chaînes avec zéros de tête
design.index = [f'{int(x):03d}' for x in design.index]

# Afficher un aperçu des données
flute_preview = comparisons[comparisons['instrument'] == 'flute'][['field1', 'field2', 'win1', 'tie', 'win2']].head(10).copy()
flute_preview['field1'] = flute_preview['field1'].apply(lambda x: f'{int(x):03d}')
flute_preview['field2'] = flute_preview['field2'].apply(lambda x: f'{int(x):03d}')
# Renommer les colonnes pour clarifier le contexte acoustique
flute_preview.columns = ['Config. A', 'Config. B', 'A préféré', 'Égalité', 'B préféré']
print("Comparaisons par paires de champs sonores (flûte):")
print(flute_preview.to_string(index=False))
Comparaisons par paires de champs sonores (flûte):
Config. A Config. B A préféré Égalité B préféré
111 110 1 1 3
111 101 0 1 4
111 100 0 1 4
111 011 2 2 1
111 010 3 1 1
111 001 5 0 0
111 000 5 0 0
110 101 3 0 2
110 100 1 2 2
110 011 2 1 2
Les données contiennent 84 comparaisons: 28 paires possibles entre les 8 configurations acoustiques, répétées pour trois instruments (violon, violoncelle, flûte). Pour chaque paire, on enregistre combien d’auditeurs ont préféré la configuration A, combien n’ont pas exprimé de préférence (égalité), et combien ont préféré la configuration B. Pour simplifier, nous traitons les égalités en les comptant comme un demi-point pour chaque configuration.
Source
# Utiliser les données de la flûte
flute_data = comparisons[comparisons['instrument'] == 'flute'].copy()

# Convertir les noms de champs en chaînes avec zéros de tête (ex: 1 -> "001")
flute_data['field1'] = flute_data['field1'].apply(lambda x: f'{int(x):03d}')
flute_data['field2'] = flute_data['field2'].apply(lambda x: f'{int(x):03d}')

# Les champs sonores
fields = ['000', '001', '010', '011', '100', '101', '110', '111']
n_fields = len(fields)
field_to_idx = {f: i for i, f in enumerate(fields)}

# Construire la matrice de conception et le vecteur cible
# Chaque comparaison donne une observation binomiale
X_rows = []
y_wins = []
y_total = []

for _, row in flute_data.iterrows():
    i = field_to_idx[row['field1']]
    j = field_to_idx[row['field2']]

    # Vecteur de conception: +1 pour field1, -1 pour field2
    x = np.zeros(n_fields)
    x[i] = 1
    x[j] = -1
    X_rows.append(x)

    # Nombre de victoires pour field1 (avec demi-points pour les égalités)
    y_wins.append(row['win1'] + row['tie'] / 2)
    y_total.append(row['win1'] + row['tie'] + row['win2'])

X = np.array(X_rows)
y_wins = np.array(y_wins)
y_total = np.array(y_total)

# Pour la régression logistique, on répète chaque comparaison selon les comptes
# Approche: créer des observations binaires à partir des comptes
X_expanded = []
y_expanded = []

for idx in range(len(X_rows)):
    n_win = int(round(y_wins[idx]))
    n_loss = int(round(y_total[idx] - y_wins[idx]))
    # Victoires pour field1
    for _ in range(n_win):
        X_expanded.append(X_rows[idx])
        y_expanded.append(1)
    # Victoires pour field2
    for _ in range(n_loss):
        X_expanded.append(X_rows[idx])
        y_expanded.append(0)

X_expanded = np.array(X_expanded)
y_expanded = np.array(y_expanded)

# Ajuster la régression logistique
model = LogisticRegression(fit_intercept=False, C=1e6, max_iter=1000)
model.fit(X_expanded, y_expanded)

# Les coefficients sont les scores des champs sonores
scores = model.coef_[0]
scores = scores - scores.mean()  # Centrer

# Créer un DataFrame pour l'affichage
results = pd.DataFrame({
    'Champ sonore': fields,
    'Score estimé': scores,
    'Son direct (a)': design['a'].values,
    'Réflexion (b)': design['b'].values,
    'Réverbération (c)': design['c'].values
}).sort_values('Score estimé', ascending=False)

print("\nScores estimés par le modèle de Bradley-Terry:")
print(results.to_string(index=False))
Scores estimés par le modèle de Bradley-Terry:
Champ sonore  Score estimé  Son direct (a)  Réflexion (b)  Réverbération (c)
         010      0.593912               0              1                  0
         101      0.542507               1              0                  1
         110      0.517201               1              1                  0
         100      0.464047               1              0                  0
         011      0.381219               0              1                  1
         111      0.228593               1              1                  1
         000     -0.894494               0              0                  0
         001     -1.832984               0              0                  1
Les scores estimés révèlent les préférences des auditeurs. Un score élevé indique un champ sonore apprécié; un score faible indique une configuration moins appréciée. La différence entre deux scores donne le logarithme de cote de préférence: si le champ «100» a un score de 0.8 et le champ «000» un score de -0.5, alors , soit environ 79% de chances que «100» soit préféré à «000».
Source
fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# Graphique 1: Scores par champ sonore
ax1 = axes[0]
colors = ['#2ecc71' if s > 0 else '#e74c3c' for s in scores]
bars = ax1.barh(fields, scores, color=colors, alpha=0.7)
ax1.axvline(0, color='gray', linestyle='--', alpha=0.5)
ax1.set_xlabel('Score estimé')
ax1.set_ylabel('Configuration du champ sonore')
ax1.set_title('Qualité perçue des champs sonores (flûte)')

# Annoter avec les facteurs physiques
for idx, field in enumerate(fields):
    a, b, c = design.loc[field, ['a', 'b', 'c']]
    label = f"  a={a}, b={b}, c={c}"
    ax1.annotate(label, (scores[idx], idx), fontsize=8, va='center')

# Graphique 2: Effet des facteurs physiques
ax2 = axes[1]

# Calculer l'effet moyen de chaque facteur
effect_a = scores[design['a'] == 1].mean() - scores[design['a'] == 0].mean()
effect_b = scores[design['b'] == 1].mean() - scores[design['b'] == 0].mean()
effect_c = scores[design['c'] == 1].mean() - scores[design['c'] == 0].mean()

effects = [effect_a, effect_b, effect_c]
labels = ['Son direct\n(a)', 'Réflexion\n(b)', 'Réverbération\n(c)']
colors_eff = ['#3498db' if e > 0 else '#e67e22' for e in effects]

ax2.bar(labels, effects, color=colors_eff, alpha=0.7)
ax2.axhline(0, color='gray', linestyle='--', alpha=0.5)
ax2.set_ylabel('Effet sur le score')
ax2.set_title('Contribution des facteurs physiques')

plt.tight_layout()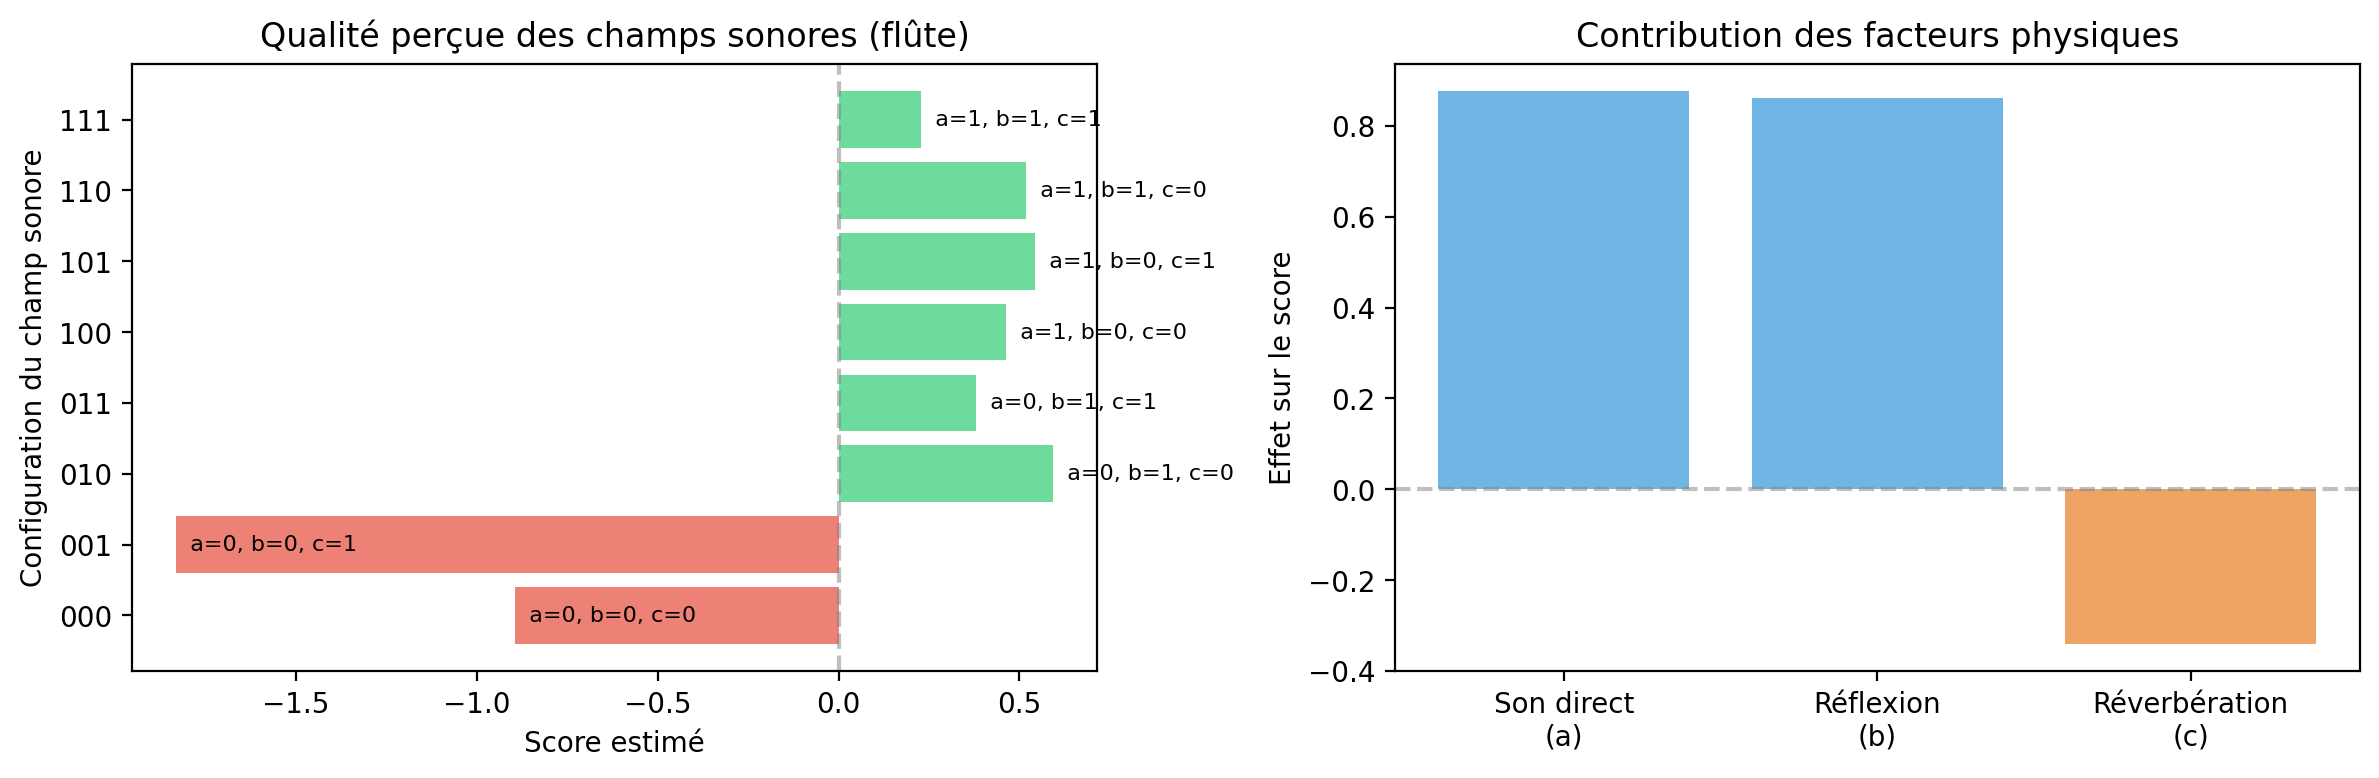
Le graphique de gauche montre le classement des huit configurations. Les configurations avec un son direct (a=1) tendent à être préférées. Le graphique de droite décompose cet effet: le facteur «son direct» a l’impact positif le plus marqué sur la qualité perçue, suivi du niveau de réflexion. Le niveau de réverbération a un effet plus modeste. Ces résultats sont cohérents avec l’intuition acoustique: un son direct clair, sans obstruction, améliore la perception de la qualité sonore dans une salle de concert.
Optimisation par descente de gradient
Au chapitre 2, nous avons résolu la régression linéaire en posant le gradient égal à zéro et en obtenant une formule explicite pour . Cette approche fonctionnait parce que le gradient de la somme des carrés est linéaire en , ce qui donne un système d’équations linéaires.
Pour la régression logistique, le gradient de la LVN contient des termes qui dépendent de de manière non linéaire. Poser le gradient égal à zéro ne donne pas un système que nous pouvons résoudre algébriquement. Nous devons donc trouver le minimum par une autre méthode.
L’idée de la descente de gradient
Imaginons que nous cherchions le point le plus bas d’un terrain vallonné, mais dans le brouillard: nous ne voyons que notre voisinage immédiat. Une stratégie naturelle serait de regarder dans quelle direction le terrain descend le plus rapidement, puis de faire un pas dans cette direction. En répétant ce processus, nous devrions nous rapprocher progressivement du fond de la vallée.
Le gradient indique précisément la direction de plus forte montée de la fonction. Pour descendre, nous allons donc dans la direction opposée. La descente de gradient formalise cette idée: à chaque itération, nous mettons à jour les paramètres selon
où est le taux d’apprentissage, qui contrôle la longueur du pas. Un pas trop petit rend la progression lente; un pas trop grand peut faire osciller autour du minimum ou même diverger.
Pour la régression logistique, nous avons calculé que le gradient est . La mise à jour devient donc:
Chaque itération ajuste dans une direction qui réduit l’erreur moyenne. Les exemples mal classés (où est loin de ) contribuent davantage à la mise à jour.
Passage à l’échelle: la descente de gradient stochastique
Calculer le gradient exact requiert de parcourir tous les exemples à chaque itération. Pour un jeu de données de millions d’exemples, cela devient prohibitif. La descente de gradient stochastique (SGD) contourne ce problème en utilisant une estimation du gradient basée sur un sous-ensemble des données.
À chaque itération, nous échantillonnons un mini-lot de quelques dizaines d’exemples et calculons le gradient sur ce sous-ensemble uniquement:
Cette estimation est non biaisée: en espérance sur le choix du mini-lot, elle égale le vrai gradient. La variance de l’estimation diminue avec la taille du mini-lot, mais même avec quelques dizaines d’exemples, l’estimation est suffisamment précise pour progresser vers le minimum.
La SGD présente plusieurs avantages pratiques. Chaque itération est beaucoup plus rapide puisqu’elle ne traite qu’une fraction des données. De plus, le bruit introduit par l’échantillonnage peut aider l’algorithme à s’échapper de minima locaux peu profonds. Enfin, la SGD permet de traiter des données qui arrivent en flux continu, sans avoir besoin de stocker tout le jeu de données en mémoire.
Source
import numpy as np
import matplotlib.pyplot as plt

# Générer des données
np.random.seed(42)
n = 200
X = np.random.randn(n, 2)
X = np.hstack([np.ones((n, 1)), X])  # Ajouter biais
true_theta = np.array([0, 2, -1])
probs = 1 / (1 + np.exp(-X @ true_theta))
y = (np.random.rand(n) < probs).astype(float)

def sigmoid(a):
    return np.where(a >= 0, 1 / (1 + np.exp(-a)), np.exp(a) / (1 + np.exp(a)))

def compute_loss(theta, X, y):
    mu = sigmoid(X @ theta)
    mu = np.clip(mu, 1e-10, 1 - 1e-10)
    return -np.mean(y * np.log(mu) + (1 - y) * np.log(1 - mu))

def compute_gradient(theta, X, y):
    mu = sigmoid(X @ theta)
    return X.T @ (mu - y) / len(y)

# Descente de gradient complète
theta_gd = np.zeros(3)
losses_gd = [compute_loss(theta_gd, X, y)]
for _ in range(100):
    grad = compute_gradient(theta_gd, X, y)
    theta_gd = theta_gd - 0.5 * grad
    losses_gd.append(compute_loss(theta_gd, X, y))

# SGD avec mini-lots
theta_sgd = np.zeros(3)
losses_sgd = [compute_loss(theta_sgd, X, y)]
batch_size = 32
for epoch in range(100):
    indices = np.random.permutation(n)
    for start in range(0, n, batch_size):
        batch_idx = indices[start:start+batch_size]
        grad = compute_gradient(theta_sgd, X[batch_idx], y[batch_idx])
        theta_sgd = theta_sgd - 0.5 * grad
    losses_sgd.append(compute_loss(theta_sgd, X, y))

fig, ax = plt.subplots(figsize=(8, 5))
ax.plot(losses_gd, 'C0-', linewidth=2, label='Gradient complet')
ax.plot(losses_sgd, 'C1-', linewidth=2, alpha=0.7, label=f'SGD (mini-lots de {batch_size})')
ax.set_xlabel('Époque')
ax.set_ylabel('Entropie croisée')
ax.set_title('Convergence de la descente de gradient')
ax.legend()
ax.set_xlim(0, 100)

plt.tight_layout()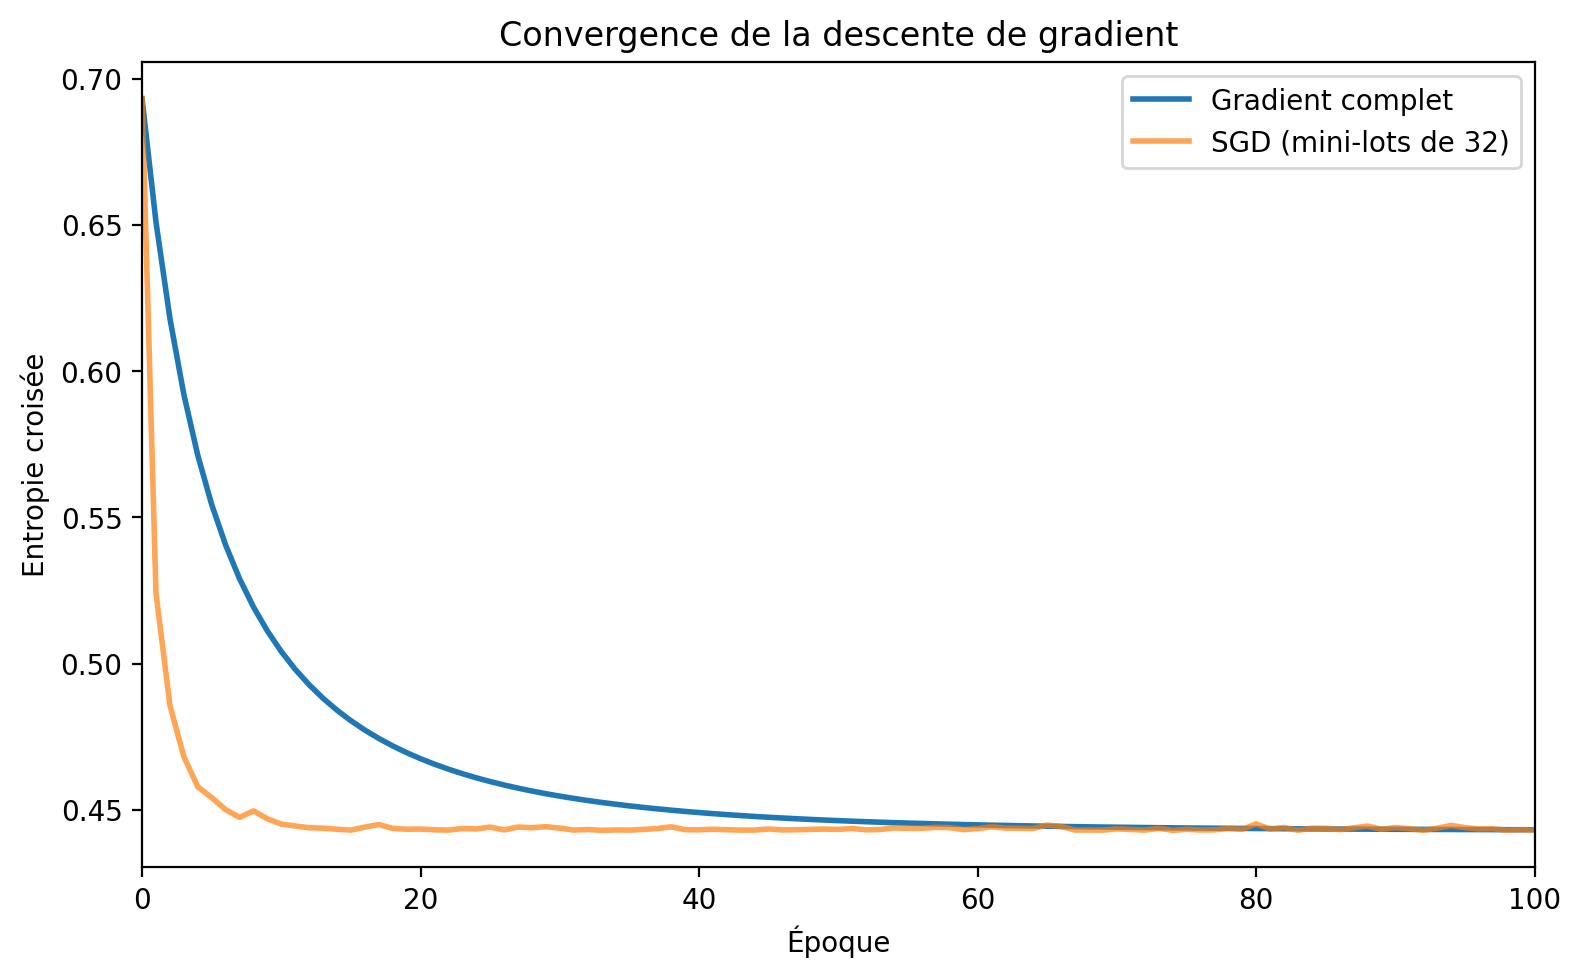
Choix du taux d’apprentissage
Le taux d’apprentissage contrôle la vitesse de convergence et requiert un réglage soigneux. Un taux trop petit rend la progression très lente: l’algorithme fait de minuscules pas et peut nécessiter des milliers d’itérations pour converger. Un taux trop grand cause des oscillations autour du minimum, voire une divergence si les mises à jour dépassent systématiquement le minimum.
Une stratégie pratique consiste à commencer avec un taux modéré puis à le réduire au cours de l’entraînement. Au début, de grands pas permettent de progresser rapidement vers la région du minimum; ensuite, de petits pas permettent de s’en approcher avec précision. La décroissance en racine carrée est un choix classique qui garantit la convergence théorique tout en conservant une vitesse raisonnable.
Méthodes du second ordre (optionnel IFT3395)
La descente de gradient n’utilise que le gradient, c’est-à-dire les dérivées premières de la fonction objectif. Elle est dite méthode du premier ordre. On peut faire mieux en exploitant aussi la courbure locale, encodée dans la matrice hessienne des dérivées secondes.
La méthode de Newton remplace la mise à jour de la descente de gradient par:
où est la hessienne évaluée au point courant. L’idée est d’approximer la fonction objectif par une quadratique locale et de sauter directement à son minimum.
Lien avec la recherche de racines. La condition d’optimalité est . Newton cherche les zéros du gradient: c’est la méthode de Newton-Raphson appliquée à . Quand la fonction est quadratique, Newton converge en une seule itération.
Convergence quadratique. Près du minimum, la descente de gradient a une convergence linéaire: l’erreur est multipliée par une constante à chaque itération. Newton a une convergence quadratique: l’erreur est élevée au carré. Concrètement, si l’erreur est 10-3 à l’itération , elle devient environ 10-6 à l’itération . Cette convergence rapide est séduisante, mais elle a un coût.
Problème de passage à l’échelle. La hessienne est une matrice . Pour un modèle avec paramètres (un grand réseau de neurones), stocker demanderait 1018 nombres, soit environ un exaoctet. L’inverser est encore plus coûteux: opérations. La méthode de Newton pure est donc inapplicable aux modèles modernes de grande taille.
Alternatives pratiques. Des méthodes intermédiaires contournent ce problème:
L-BFGS (Limited-memory BFGS): Approxime l’inverse de la hessienne à partir des derniers gradients, sans jamais former explicitement. C’est le solveur par défaut de
LogisticRegressiondans scikit-learn.Newton-CG (Newton-Conjugate Gradient): Résout le système par gradient conjugué, en utilisant uniquement des produits hessienne-vecteur , qui peuvent être calculés sans former .
Ces méthodes offrent une convergence plus rapide que la descente de gradient simple, tout en restant applicables à des problèmes de taille raisonnable. Pour la régression logistique avec quelques milliers de caractéristiques, L-BFGS converge généralement en quelques dizaines d’itérations là où SGD en nécessiterait des centaines.
Implémentation
Traduisons maintenant ces idées en code. L’implémentation ci-dessous suit fidèlement les équations que nous avons dérivées: la fonction sigmoid calcule , le gradient est , et la mise à jour soustrait ce gradient multiplié par le taux d’apprentissage.
Un détail pratique mérite attention: le calcul de la sigmoïde. Pour de grandes valeurs négatives de , l’exponentielle peut déborder numériquement. La formulation est équivalente mathématiquement mais numériquement stable pour . Notre implémentation utilise l’une ou l’autre forme selon le signe de .
Source
import numpy as np

def sigmoid(a):
    """Fonction sigmoïde numériquement stable."""
    return np.where(a >= 0,
                    1 / (1 + np.exp(-a)),
                    np.exp(a) / (1 + np.exp(a)))

def logistic_regression_sgd(X, y, lr=0.1, n_epochs=100, batch_size=32):
    """Régression logistique par descente de gradient stochastique.

    Args:
        X: Matrice de design (N x d), inclut le biais si nécessaire
        y: Étiquettes binaires (N,)
        lr: Taux d'apprentissage
        n_epochs: Nombre d'époques
        batch_size: Taille des mini-lots

    Returns:
        theta: Vecteur de paramètres (d,)
        losses: Historique des pertes
    """
    N, d = X.shape
    theta = np.zeros(d)
    losses = []

    for epoch in range(n_epochs):
        # Mélanger les données à chaque époque
        indices = np.random.permutation(N)

        for start in range(0, N, batch_size):
            batch_idx = indices[start:start + batch_size]
            X_batch = X[batch_idx]
            y_batch = y[batch_idx]

            # Prédictions
            mu = sigmoid(X_batch @ theta)

            # Gradient
            grad = X_batch.T @ (mu - y_batch) / len(batch_idx)

            # Mise à jour
            theta = theta - lr * grad

        # Calculer la perte après chaque époque
        mu_all = sigmoid(X @ theta)
        mu_all = np.clip(mu_all, 1e-10, 1 - 1e-10)
        loss = -np.mean(y * np.log(mu_all) + (1 - y) * np.log(1 - mu_all))
        losses.append(loss)

    return theta, losses

def predict_proba(X, theta):
    """Probabilités de la classe positive."""
    return sigmoid(X @ theta)

def predict(X, theta, threshold=0.5):
    """Prédictions binaires."""
    return (predict_proba(X, theta) >= threshold).astype(int)
Appliquons cette implémentation à un problème synthétique. Nous générons deux groupes de points en 2D, chacun centré en un point différent, avec un certain chevauchement. Ce type de données permet de visualiser clairement la frontière de décision apprise.
Source
# Générer des données
np.random.seed(123)
n_samples = 300

# Deux classes avec centres différents
X0 = np.random.randn(n_samples // 2, 2) + np.array([-1, -1])
X1 = np.random.randn(n_samples // 2, 2) + np.array([1.5, 1.5])
X_data = np.vstack([X0, X1])
y_data = np.array([0] * (n_samples // 2) + [1] * (n_samples // 2))

# Ajouter colonne de 1 pour le biais
X_with_bias = np.hstack([np.ones((n_samples, 1)), X_data])

# Entraîner
theta_learned, loss_history = logistic_regression_sgd(
    X_with_bias, y_data, lr=0.5, n_epochs=50, batch_size=32
)

print(f"Paramètres appris: biais={theta_learned[0]:.2f}, θ₁={theta_learned[1]:.2f}, θ₂={theta_learned[2]:.2f}")

# Précision
y_pred = predict(X_with_bias, theta_learned)
accuracy = np.mean(y_pred == y_data)
print(f"Précision: {accuracy:.1%}")
Paramètres appris: biais=-1.00, θ₁=1.77, θ₂=2.32
Précision: 94.7%
La figure ci-dessous montre les résultats. À gauche, les points des deux classes et la frontière de décision apprise: c’est la droite où , soit . Les points au-dessus de cette droite sont classés comme positifs, ceux en dessous comme négatifs. À droite, la courbe d’entropie croisée montre que l’algorithme converge rapidement vers le minimum.
Source
# Visualisation
fig, axes = plt.subplots(1, 2, figsize=(12, 5))

# Données et frontière de décision
ax = axes[0]
ax.scatter(X0[:, 0], X0[:, 1], c='C1', label='Classe 0', alpha=0.6, edgecolor='white')
ax.scatter(X1[:, 0], X1[:, 1], c='C0', label='Classe 1', alpha=0.6, edgecolor='white')

# Frontière: theta[0] + theta[1]*x1 + theta[2]*x2 = 0
x1_range = np.linspace(-4, 5, 100)
x2_boundary = -(theta_learned[0] + theta_learned[1] * x1_range) / theta_learned[2]
ax.plot(x1_range, x2_boundary, 'k-', linewidth=2, label='Frontière apprise')

ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Classification par régression logistique')
ax.set_xlim(-4, 5)
ax.set_ylim(-4, 5)
ax.legend()

# Courbe de perte
ax = axes[1]
ax.plot(loss_history, 'C0-', linewidth=2)
ax.set_xlabel('Époque')
ax.set_ylabel('Entropie croisée')
ax.set_title('Convergence de l\'entraînement')

plt.tight_layout()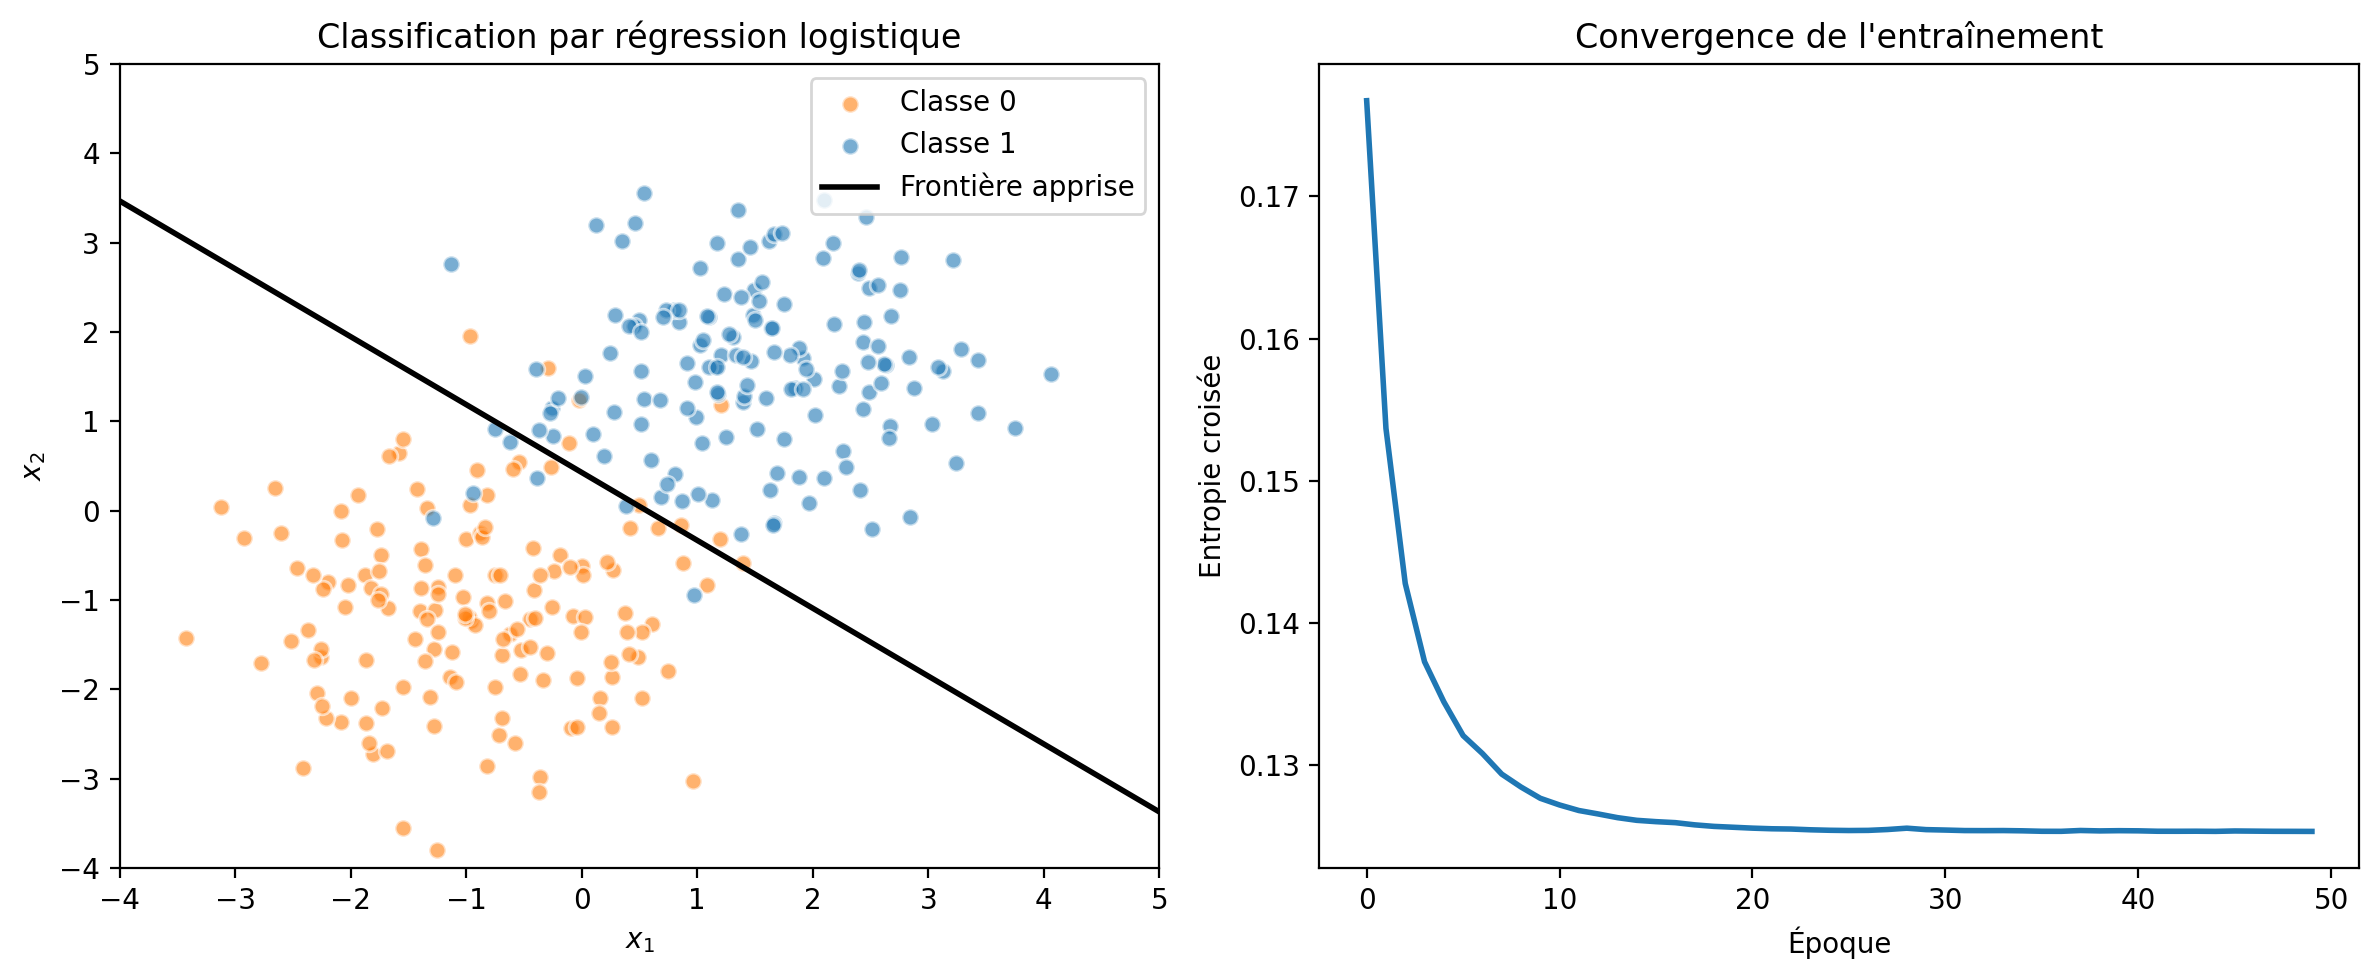
Démos : jeux de données pour la régression logistique
Jusqu’ici nous avons illustré la régression logistique sur un jeu de données synthétique en deux dimensions. Pour voir comment le modèle se comporte en pratique et comment interpréter les coefficients, nous passons à des jeux de données réels, chargés en une ligne avec ucimlrepo. Nous commençons par le béton, déjà rencontré au chapitre 2 en régression ; nous enchaînons avec les défauts sur plaques d’acier (contrôle qualité en fabrication), puis avec les supraconducteurs (haute ou basse température critique). Une ressource pour aller plus loin (défauts CVC) clôt la section.
Du béton en régression au béton en classification
Au chapitre 2 nous avons prédit la résistance du béton en MPa à partir de sa formulation. Ici nous posons une question binaire : la résistance dépasse-t-elle un seuil donné ? On obtient une étiquette « conforme » (résistance suffisante) ou « non conforme » (résistance insuffisante). Les mêmes caractéristiques (ciment, laitier, eau, âge, etc.) servent à prédire cette étiquette ; la régression logistique fournit en plus une probabilité de conformité et des coefficients interprétables.
Source
import numpy as np
import matplotlib.pyplot as plt
from ucimlrepo import fetch_ucirepo
from sklearn.linear_model import LogisticRegression

# Charger le jeu de données (même source qu'au chapitre 2)
beton = fetch_ucirepo(id=165)
X_df = beton.data.features
y_resistance = beton.data.targets.values.ravel()

# Seuil de conformité : par ex. médiane (50 % conformes)
seuil = np.median(y_resistance)
y_bin = (y_resistance >= seuil).astype(int)

# Noms des caractéristiques en français
noms_carac = ['Ciment', 'Laitier', 'Cendres', 'Eau', 'Plastifiant',
              'Granulat gros', 'Granulat fin', 'Âge']
X = X_df.values
X_biais = np.column_stack([np.ones(len(X)), X])

# Régression logistique
modele = LogisticRegression(max_iter=1000, random_state=42)
modele.fit(X_biais, y_bin)
theta = modele.coef_[0]  # biais dans theta[0], poids dans theta[1:]

# Graphique des coefficients (poids seulement)
fig, ax = plt.subplots(figsize=(8, 4))
couleurs = ['C0' if c > 0 else 'C1' for c in theta[1:]]
barres = ax.barh(noms_carac, theta[1:], color=couleurs, alpha=0.8)
ax.axvline(0, color='gray', linewidth=0.8)
ax.set_xlabel('Coefficient (log-cote de conformité)')
ax.set_ylabel('Caractéristique')
ax.set_title('Influence des ingrédients sur la probabilité de conformité du béton')
plt.tight_layout()
plt.show()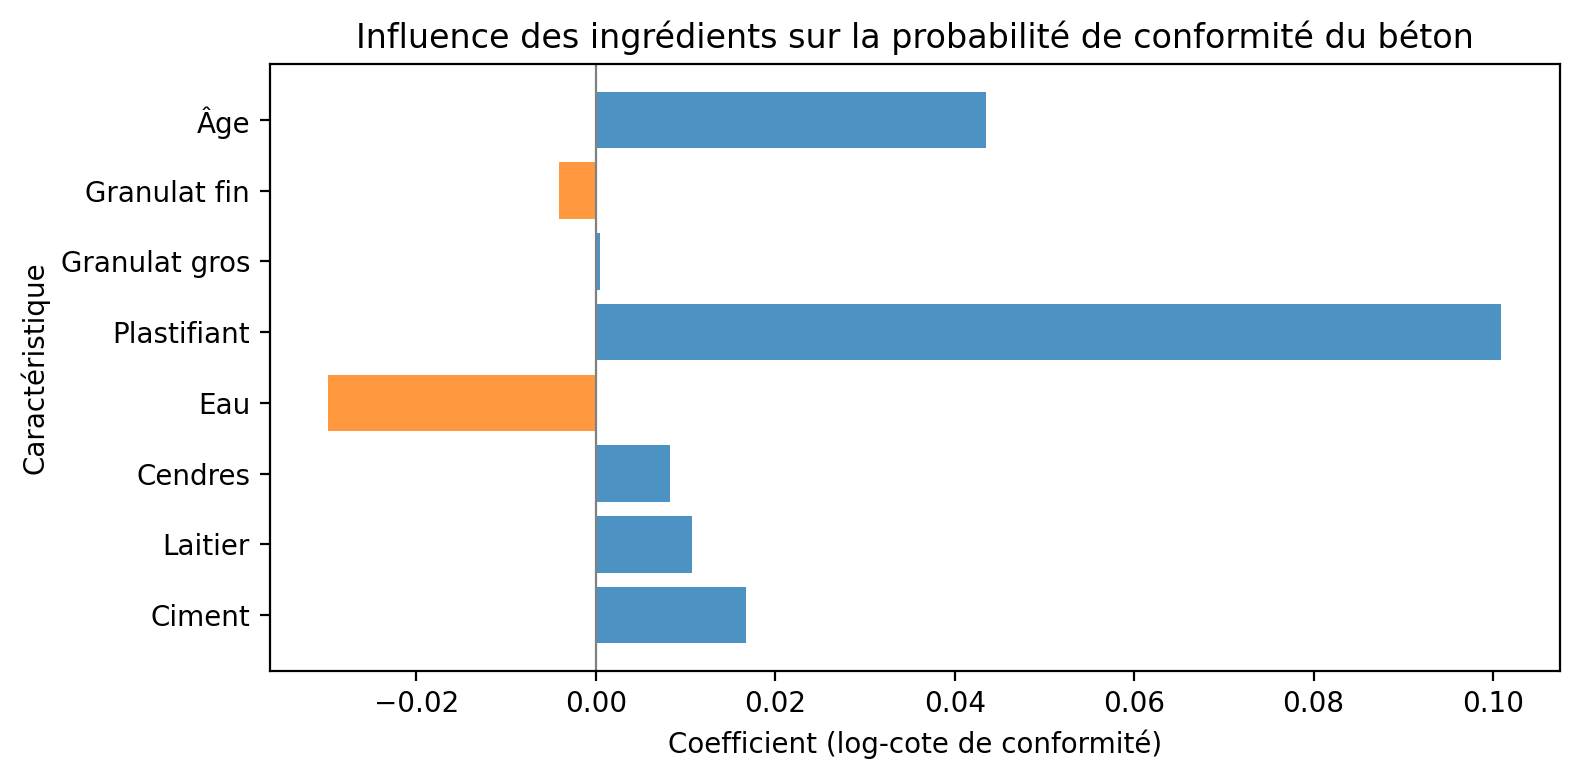
Le ciment et l’âge augmentent la probabilité que la résistance dépasse le seuil ; l’eau la diminue (excès d’eau affaiblit le béton). Les coefficients s’interprètent comme en régression, mais en log-cote : une augmentation d’une unité de la caractéristique multiplie la cote de conformité par .
Défauts sur plaques d’acier
De la même façon, on peut appliquer la régression logistique au contrôle qualité en fabrication, qui consiste souvent à classifier les défauts à partir de mesures (géométrie, luminance, etc.). Le jeu Steel Plates Faults contient des plaques d’acier avec des défauts de plusieurs types (rayure, tache, bosse, etc.). On peut d’abord simplifier en binaire : « défaut de type rayure » (étiquettes Z_Scratch ou K_Scratch) contre « autre défaut ». La régression logistique apprend quelles mesures sont associées à la présence d’une rayure.
Source
import warnings
import numpy as np
from ucimlrepo import fetch_ucirepo
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.exceptions import ConvergenceWarning

warnings.filterwarnings("ignore", category=ConvergenceWarning)

# Charger le jeu de données
acier = fetch_ucirepo(id=198)
X_acier = acier.data.features.values
# Cibles : 7 colonnes binaires (Pastry, Z_Scratch, K_Scratch, Stains, Dirtiness, Bumps, Other_Faults)
cibles = acier.data.targets
# Binaire : rayure = Z_Scratch OU K_Scratch
y_rayure = (cibles['Z_Scratch'].values | cibles['K_Scratch'].values).astype(int)

# Séparation train / test
X_train, X_test, y_train, y_test = train_test_split(
    X_acier, y_rayure, test_size=0.25, random_state=42
)
# Standardiser pour assurer la convergence de l'optimiseur
scaler = StandardScaler()
X_train_std = scaler.fit_transform(X_train)
X_test_std = scaler.transform(X_test)
X_train_b = np.column_stack([np.ones(len(X_train)), X_train_std])
X_test_b = np.column_stack([np.ones(len(X_test)), X_test_std])

modele_acier = LogisticRegression(max_iter=5000, random_state=42)
modele_acier.fit(X_train_b, y_train)
score_train = modele_acier.score(X_train_b, y_train)
score_test = modele_acier.score(X_test_b, y_test)

print(f"Précision entraînement : {score_train:.3f}")
print(f"Précision test : {score_test:.3f}")
Précision entraînement : 0.916
Précision test : 0.912
On peut ensuite passer à la classification multiclasse (quel type de défaut parmi les sept) avec la même API en utilisant la matrice de cibles complète ; le modèle utilise alors la fonction softmax et l’entropie croisée catégorielle vues plus haut.
Supraconducteurs : haute ou basse température critique
Un autre domaine où la régression logistique est utile est la découverte de matériaux. Le jeu Superconductor décrit des matériaux par des descripteurs chimiques (composition, nombre d’électrons, etc.) et donne la température critique . On peut définir une cible binaire : « haute » (par ex. K) contre « basse ». Le modèle apprend quels descripteurs sont associés aux matériaux à haute température critique.
Source
import numpy as np
from ucimlrepo import fetch_ucirepo
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# Charger les données (même source qu'au chapitre 2)
supra = fetch_ucirepo(id=464)
X_supra = supra.data.features.values
y_tc = supra.data.targets.values.ravel()

# Binaire : haute T_c si T_c >= 30 K
seuil_tc = 30
y_haute = (y_tc >= seuil_tc).astype(int)

X_tr, X_te, y_tr, y_te = train_test_split(
    X_supra, y_haute, test_size=0.2, random_state=42
)
scaler = StandardScaler()
X_tr_std = scaler.fit_transform(X_tr)
X_te_std = scaler.transform(X_te)
X_tr_b = np.column_stack([np.ones(len(X_tr_std)), X_tr_std])
X_te_b = np.column_stack([np.ones(len(X_te_std)), X_te_std])

modele_supra = LogisticRegression(max_iter=1000, random_state=42)
modele_supra.fit(X_tr_b, y_tr)
precision_te = modele_supra.score(X_te_b, y_te)
print(f"Précision sur l'ensemble de test : {precision_te:.3f}")
print("Les descripteurs chimiques permettent de séparer partiellement les matériaux à haute et basse T_c.")
Précision sur l'ensemble de test : 0.901
Les descripteurs chimiques permettent de séparer partiellement les matériaux à haute et basse T_c.
Pour aller plus loin : défauts CVC
Pour appliquer la régression logistique à des données de bâtiment (CVC : chauffage, ventilation, climatisation), le jeu LBNL HVAC Fault Detection (OpenEI) fournit des mesures de capteurs (températures, pressions, débits, positions de vannes, puissance) sur des centrales de froid, des centrales de traitement d’air et des unités terminales. La cible peut être binaire (fonctionnement normal vs en défaut) ou multiclasse (type de défaut : biais de capteur, vanne bloquée, encrassement, etc.). Les données sont des séries temporelles ; on peut agréger les variables sur une fenêtre glissante (moyenne, écart-type) pour obtenir un vecteur de caractéristiques par fenêtre, puis réutiliser la même chaîne : chargement, construction des étiquettes, entraînement avec LogisticRegression ou l’implémentation SGD du chapitre.
Résumé
Ce chapitre a introduit la classification linéaire:
La régression logistique modélise où est la fonction sigmoïde.
Le maximum de vraisemblance appliqué au modèle de Bernoulli donne l’entropie croisée comme fonction de perte. Ce n’est pas un choix arbitraire.
Le gradient a une forme simple: , analogue aux moindres carrés.
L’objectif est convexe, garantissant un unique minimum global.
La fonction softmax généralise la sigmoïde au cas multiclasse, avec l’entropie croisée catégorielle comme perte.
Le modèle de Bradley-Terry pour les préférences est une régression logistique sur une matrice de conception où chaque ligne encode une comparaison par paires. C’est le modèle au coeur du RLHF pour l’alignement des grands modèles de langage.
La descente de gradient stochastique (SGD) permet l’optimisation efficace, en utilisant des mini-lots pour estimer le gradient.
La frontière de décision est un hyperplan dans l’espace des entrées.
Nous avons maintenant deux modèles linéaires fondamentaux: la régression (chapitre 2) et la classification (ce chapitre). Le chapitre suivant étudie comment ces modèles généralisent à de nouvelles données, en explorant le compromis biais-variance et les techniques de sélection de modèle.
Exercices
Exercice 1: Dérivation de la sigmoïde ★
Montrez que .
Montrez que .
Utilisez ces propriétés pour simplifier .
Exercice 2: Régularisation de la régression logistique ★★
Comme pour Ridge, nous pouvons régulariser la régression logistique en ajoutant une pénalité :
Calculez le gradient de l’objectif régularisé.
Modifiez l’implémentation
logistic_regression_sgdpour inclure la régularisation.Sur un jeu de données avec peu d’exemples, comparez les frontières de décision avec et sans régularisation.
Solution Exercice 2
Gradient régularisé:
Implémentation:
def logistic_regression_sgd_regularized(X, y, lr=0.1, n_epochs=100,
                                         batch_size=32, lambda_reg=0.01):
    N, d = X.shape
    theta = np.zeros(d)

    for epoch in range(n_epochs):
        indices = np.random.permutation(N)
        for start in range(0, N, batch_size):
            batch_idx = indices[start:start + batch_size]
            X_batch, y_batch = X[batch_idx], y[batch_idx]

            mu = sigmoid(X_batch @ theta)
            grad = X_batch.T @ (mu - y_batch) / len(batch_idx)
            grad += lambda_reg * theta  # Terme de régularisation

            theta = theta - lr * grad

    return theta
Avec peu d’exemples, la régularisation empêche les coefficients de devenir trop grands, produisant une frontière plus lisse et moins sensible au bruit.
Exercice 3: Softmax et température ★★
La fonction softmax avec température est définie par:
Que se passe-t-il quand ? (Indice: quelle classe domine?)
Que se passe-t-il quand ?
Implémentez
softmax_temperature(a, T)et visualisez l’effet de sur un vecteur .
Solution Exercice 3
: La distribution devient de plus en plus concentrée sur la classe avec le logit maximal. À la limite, c’est un vecteur one-hot: avec 1 à la position .
: Les logits divisés par tendent tous vers 0. La distribution devient uniforme: .
Implémentation:
def softmax_temperature(a, T):
    a_scaled = a / T
    a_max = np.max(a_scaled)
    exp_a = np.exp(a_scaled - a_max)
    return exp_a / np.sum(exp_a)

a = np.array([2, 1, 0.5])
for T in [0.1, 0.5, 1.0, 2.0, 10.0]:
    probs = softmax_temperature(a, T)
    print(f"T={T}: {probs}")
Résultat: avec , presque [1, 0, 0]; avec , proche de [0.37, 0.33, 0.30].
Exercice 4: Comparaison avec scikit-learn ★
Utilisez sklearn.linear_model.LogisticRegression pour entraîner un modèle sur les mêmes données que l’exemple du chapitre.
Comparez les coefficients appris avec votre implémentation.
Comparez les temps d’exécution pour différentes tailles de données.
Explorez les options de régularisation de scikit-learn (
penalty,C).
- Bradley, R. A., & Terry, M. E. (1952). Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons. Biometrika, 39(3–4), 324–345. 10.1093/biomet/39.3-4.324
- Kousgaard, N. (1984). Analysis of a Sound Field Experiment by a Model for Paired Comparisons with Explanatory Variables. Scandinavian Journal of Statistics, 11(1), 51–57.