Aux chapitres 2 et 3, nous avons construit des modèles linéaires pour la régression et la classification. Au chapitre 4, nous avons vu comment enrichir ces modèles en transformant les entrées par une fonction fixée à l’avance. Ce chapitre franchit une étape supplémentaire: au lieu de choisir manuellement, nous allons l’apprendre à partir des données. Cette idée conduit aux réseaux de neurones.
Dans ce chapitre, nous rappelons d’abord le cadre probabiliste qui unifie régression et classification, puis nous montrons comment le perceptron simple atteint une limite structurelle (illustrée par le problème XOR). Nous présentons ensuite l’anatomie d’un réseau multicouche (couches, activations, architecture). La section sur la dérivation automatique est plus technique: elle développe la règle de la chaîne, les produits jacobien-vecteur, et l’algorithme de rétropropagation, puis montre comment les bibliothèques modernes implémentent ces idées. Vous pouvez survoler les détails en première lecture et retenir le mécanisme général. La section d’implémentation propose un MLP complet en NumPy, et le chapitre se termine par une mise en perspective montrant comment les MLP sont utilisés en pratique pour la régression et la classification. Les algorithmes d’optimisation, la stabilisation de l’entraînement et la régularisation sont couverts au chapitre suivant.
Le cadre unifié: prédire les paramètres d’une distribution
Régression et classification comme maximum de vraisemblance
Revenons au cadre probabiliste des chapitres 2 et 5. Dans tous les modèles que nous avons vus, le problème d’apprentissage supervisé prend la même forme: étant donné une entrée , nous voulons prédire les paramètres d’une distribution conditionnelle , puis trouver par maximum de vraisemblance.
En régression, nous avons supposé un bruit gaussien:
Le modèle prédit la moyenne de la distribution. La log-vraisemblance négative donne, à une constante près, la perte des moindres carrés:
En classification binaire, nous avons supposé une distribution de Bernoulli:
Le modèle prédit la probabilité . La log-vraisemblance négative donne l’entropie croisée binaire. Pour la classification multiclasse, la distribution catégorielle et la fonction softmax jouent le même rôle, avec l’entropie croisée catégorielle comme perte.
Dans chaque cas, une fonction prend une entrée et produit les paramètres de la distribution de sortie. Toute la question est: quelle forme donner à cette fonction?
Des modèles linéaires aux caractéristiques apprises
Jusqu’ici, nos modèles ont été linéaires dans les entrées. Pour la régression:
Pour la classification binaire, la probabilité passe par une sigmoïde, mais la pré-activation reste linéaire:
Au chapitre 4, nous avons étendu cette approche avec l’expansion de caractéristiques. Au lieu d’utiliser directement, nous le transformons par une fonction choisie à l’avance (polynômes, fonctions trigonométriques, bases radiales, etc.):
Le modèle reste linéaire dans les paramètres , ce qui facilite l’optimisation, mais il capture des relations non linéaires en grâce au choix de .
Cette approche a une limite importante: le choix de repose entièrement sur l’expertise du praticien. Pour des données tabulaires simples, cela peut fonctionner. Mais pour des images, du texte ou de l’audio, concevoir manuellement les bonnes caractéristiques est très difficile, et souvent le facteur limitant de la performance.
Les réseaux de neurones paramètrent et l’apprennent à partir des données. Au lieu d’écrire avec fixé, nous écrivons:
où est elle-même une fonction paramétrique. Les paramètres contrôlent la transformation des entrées (les “caractéristiques apprises”), tandis que sont les poids de la couche de sortie. On optimise les deux simultanément: le modèle apprend la représentation et le prédicteur en même temps.
Cela soulève deux questions: quelle forme donner à , et comment optimiser l’ensemble des paramètres? Le reste de ce chapitre répond à ces deux questions.
Le perceptron: aux origines des réseaux de neurones
La régression logistique et les réseaux de neurones partagent un ancêtre commun: le perceptron, proposé par Rosenblatt en 1958 Rosenblatt (1958). Comprendre ce modèle et sa limitation éclaire pourquoi les réseaux multicouches ont été inventés, et pourquoi leur développement a pris plusieurs décennies.
Un modèle inspiré du neurone biologique
En 1943, McCulloch et Pitts McCulloch & Pitts (1943) ont formalisé le comportement du neurone biologique: une unité qui reçoit des signaux pondérés et s’active si leur somme dépasse un seuil. Le modèle se résume à:
Ce neurone calcule une combinaison linéaire des entrées, puis prend une décision binaire: actif () ou inactif (). Rosenblatt y a ajouté un algorithme pour ajuster les poids à partir d’exemples étiquetés. L’enthousiasme de l’époque était considérable: des démonstrateurs matériels ont été construits, et la presse grand public annonçait une machine capable «d’apprendre à reconnaître».
Le point de départ est la neuroscience computationnelle, pas l’optimisation. McCulloch et Pitts voulaient formaliser le comportement des neurones corticaux; Rosenblatt s’inspirait de la vision artificielle et des réseaux nerveux. C’est cette origine qui distingue la trajectoire intellectuelle du perceptron de celle de la régression logistique, même si les deux modèles aboutissent à une structure mathématique très proche.
Lien avec la régression logistique
Les deux modèles calculent la même pré-activation linéaire , mais diffèrent dans la façon dont ils l’interprètent:
| Régression logistique | Perceptron | |
|---|---|---|
| Activation | (sigmoïde, continue) | (échelon, discontinue) |
| Sortie | probabilité | décision |
| Frontière de décision |
La frontière de décision est dans les deux cas le même hyperplan . La sigmoïde peut être vue comme une version lisse et probabiliste de la fonction échelon: au lieu de trancher brusquement, elle exprime l’incertitude via une probabilité.
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

# --- Panneau gauche: activations ---
z = np.linspace(-5, 5, 500)
sigmoid = 1 / (1 + np.exp(-z))

ax = axes[0]
ax.plot(z, sigmoid, '#1f77b4', lw=2.5, label=r'Sigmoïde $\sigma(z)$')
ax.plot(z[z < 0],  np.zeros(np.sum(z < 0)),  '#d62728', lw=2.5)
ax.plot(z[z >= 0], np.ones(np.sum(z >= 0)),  '#d62728', lw=2.5,
        label=r'Échelon $\mathbf{1}[z \geq 0]$')
ax.scatter([0], [1], color='#d62728', s=55, zorder=5)
ax.scatter([0], [0], color='white', edgecolors='#d62728', linewidths=2, s=55, zorder=5)
ax.axvline(0, color='gray', lw=1, linestyle=':', alpha=0.6)
ax.set_xlabel(r'Pré-activation $z = \boldsymbol{\theta}^\top \mathbf{x}$')
ax.set_ylabel('Sortie')
ax.set_title('Activations comparées')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)
ax.set_xlim(-5, 5); ax.set_ylim(-0.1, 1.2)
ax.annotate(r'Frontière: $z=0$', xy=(0, 0.5), xytext=(1.8, 0.25),
            fontsize=9, color='#555555',
            arrowprops=dict(arrowstyle='->', color='gray', lw=1.2))

# --- Panneau droit: frontière de décision 2D ---
rng = np.random.default_rng(0)
n = 40
X_pos = rng.multivariate_normal([ 1.5,  0.8], [[0.4, 0], [0, 0.4]], n)
X_neg = rng.multivariate_normal([-1.5, -0.8], [[0.4, 0], [0, 0.4]], n)

ax = axes[1]
xx, yy = np.meshgrid(np.linspace(-3.5, 3.5, 200), np.linspace(-2.5, 2.5, 200))
Z = xx + yy   # theta = [1, 1], frontière: x1 + x2 = 0
ax.contourf(xx, yy, Z, levels=[-100, 0, 100],
            colors=['#fdd8d8', '#d8e8fd'], alpha=0.45)
ax.contour(xx, yy, Z, levels=[0], colors='k', linewidths=2)
ax.scatter(X_pos[:, 0], X_pos[:, 1], color='#1f77b4', marker='o', s=35,
           alpha=0.85, label='Classe 1', edgecolors='white', linewidths=0.5)
ax.scatter(X_neg[:, 0], X_neg[:, 1], color='#d62728', marker='s', s=35,
           alpha=0.85, label='Classe 0', edgecolors='white', linewidths=0.5)
ax.text( 1.8, -2.0, 'Rég. log.: prob. $\\to 1$\nPerceptron: classe 1',
         fontsize=7.5, color='#1f77b4', ha='center',
         bbox=dict(boxstyle='round,pad=0.3', fc='white', ec='#1f77b4', alpha=0.8))
ax.text(-1.8,  1.8, 'Rég. log.: prob. $\\to 0$\nPerceptron: classe 0',
         fontsize=7.5, color='#d62728', ha='center',
         bbox=dict(boxstyle='round,pad=0.3', fc='white', ec='#d62728', alpha=0.8))
ax.set_xlabel(r'$x_1$'); ax.set_ylabel(r'$x_2$')
ax.set_title(r'Même frontière: $\boldsymbol{\theta}^\top \mathbf{x} = 0$')
ax.legend(fontsize=9, loc='upper left')
ax.grid(True, alpha=0.3)

plt.suptitle('Régression logistique et perceptron: deux lectures du même hyperplan', fontsize=10)
plt.tight_layout()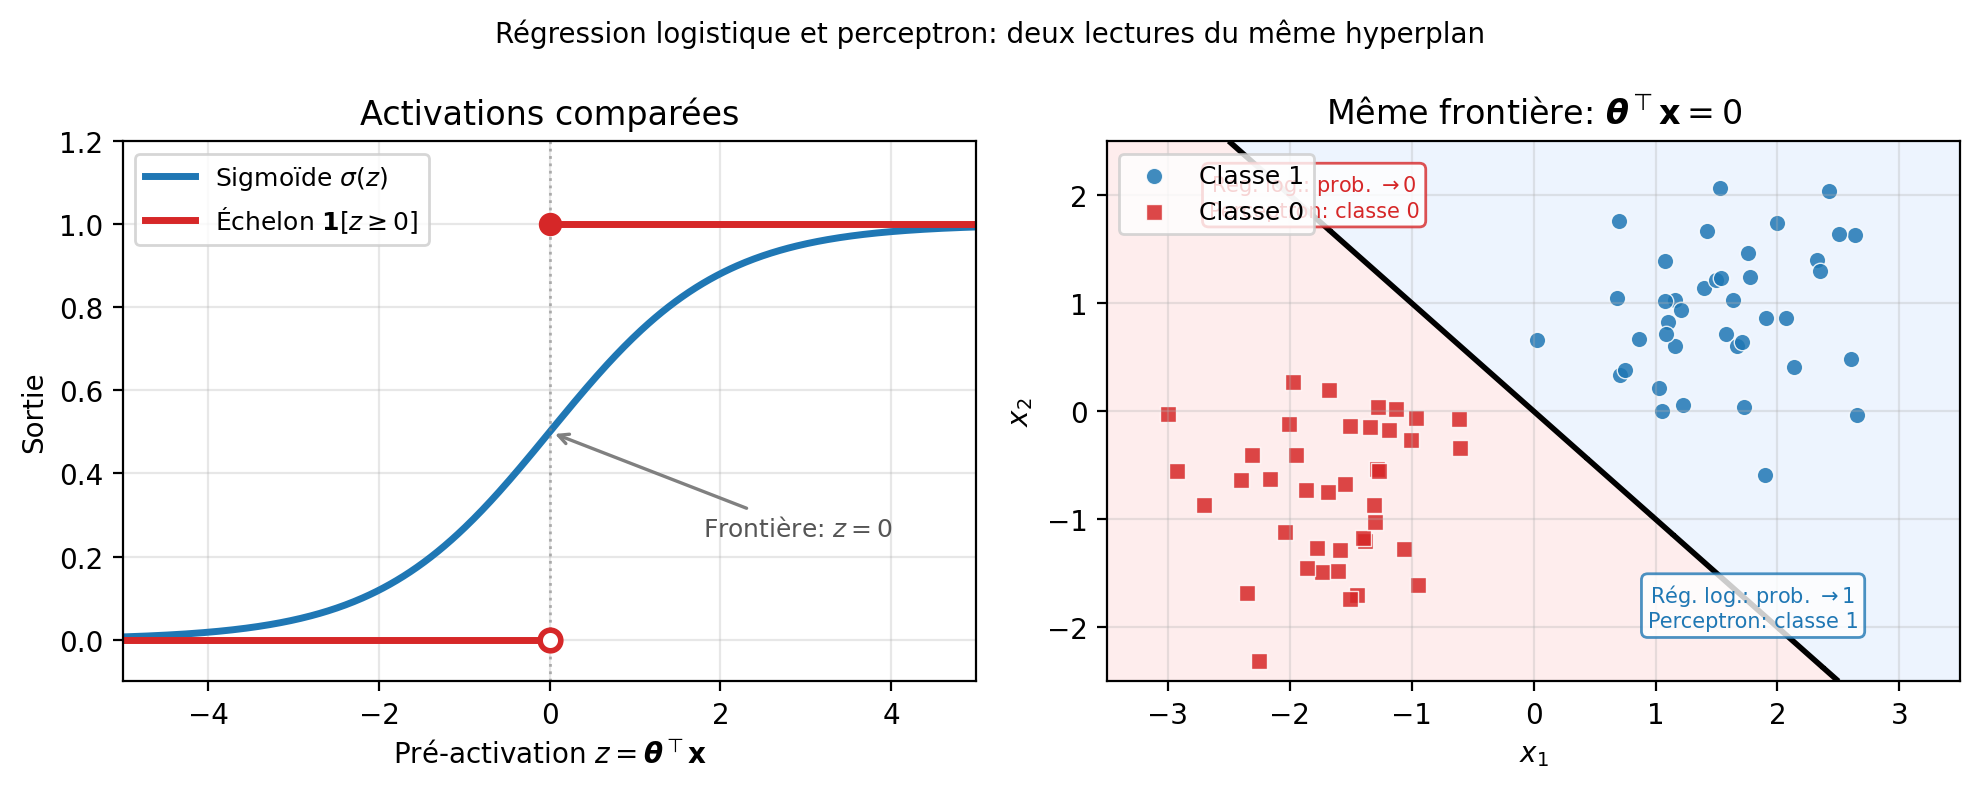
La règle d’apprentissage et la difficulté de l’optimisation
La régression logistique minimise l’entropie croisée, une fonction différentiable, ce qui autorise la descente de gradient. Le perceptron minimise la perte perceptron (avec des étiquettes ):
Cette perte est nulle pour les exemples bien classés et pénalise les erreurs proportionnellement à leur amplitude. Elle n’est toutefois pas différentiable au point exact où . On utilise alors le sous-gradient, qui généralise le gradient aux fonctions non différentiables:
Cela donne la règle de mise à jour classique: pour chaque exemple mal classé, corriger les poids dans la direction de cet exemple,
La convergence est plus délicate qu’avec la descente de gradient sur une fonction convexe et différentiable. Si les données sont linéairement séparables, le théorème de convergence du perceptron Novikoff (1962) garantit que l’algorithme s’arrête en un nombre fini de mises à jour, borné par où est le rayon des données et la marge de séparation. Si les données ne sont pas linéairement séparables, l’algorithme peut cycler sans jamais converger.
Une limite structurelle
Toutes ces variantes (perceptron, régression logistique, moindres carrés) partagent la même contrainte: leur frontière de décision est un hyperplan. Quelle que soit la façon dont on choisit ou entraîne les poids , on ne peut séparer que des classes linéairement séparables.
C’est précisément ce que Minsky et Papert ont formalisé en 1969 Minsky & Papert (1969), en montrant que certaines fonctions booléennes sont impossibles à apprendre pour un perceptron simple. L’exemple canonique est la fonction XOR (ou exclusif):
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
Les points de classe 0 sont disposés en diagonale, et , et ceux de classe 1 sur l’autre, et . Aucune droite ne peut séparer ces deux groupes. Mais Minsky et Papert montraient aussi la solution: empiler deux couches de perceptrons suffit, car la première couche peut transformer l’espace de sorte que les classes deviennent linéairement séparables. Nous verrons dans la section d’implémentation qu’un petit MLP résout XOR sans difficulté.
Leur analyse a contribué à un ralentissement de la recherche sur les réseaux de neurones pendant plusieurs années, jusqu’à ce que les avancées en optimisation et en calcul redonnent vie au domaine. La section suivante formalise l’architecture multicouche qui résout cette limitation.
Anatomie d’un réseau de neurones
Un neurone: transformation affine et non-linéarité
Un réseau de neurones est construit à partir d’une opération élémentaire: une transformation affine suivie d’une fonction non linéaire. Pour une entrée :
où est un vecteur de poids, est un biais, et est une fonction d’activation non linéaire. La quantité est la pré-activation et est l’activation du neurone.
Une couche de neurones applique cette opération en parallèle, ce qui s’écrit sous forme matricielle:
où est la matrice de poids, le vecteur de biais, et est appliquée élément par élément.
On peut représenter cette couche comme un graphe de calcul: les entrées et paramètres sont les nœuds sources, les opérations (, , ) sont des transformations, et l’activation est le nœud de sortie. Cette perspective sera centrale dans la section sur la dérivation automatique.
Les nœuds en jaune (, ) sont les paramètres (feuilles du graphe); le nœud bleu () est l’entrée; le nœud vert () est la sortie de la couche.
Rôle de la non-linéarité
Sans la fonction d’activation , une couche se réduit à une transformation affine . Empiler plusieurs couches linéaires ne fait qu’en produire une autre:
La composition de fonctions linéaires est encore linéaire. Les non-linéarités sont ce qui donne aux réseaux de neurones leur pouvoir expressif.
Fonctions d’activation
Nous avons déjà rencontré la sigmoïde en régression logistique au chapitre 3:
Elle transforme un score réel en une valeur dans . Sa dérivée est , ce qui sera utile pour la rétropropagation. Cependant, la sigmoïde sature pour les grandes valeurs de : dans ces régions, la dérivée est proche de zéro.
La tangente hyperbolique est similaire mais centrée autour de zéro:
Ses sorties sont dans . On peut montrer que est une version recentrée de la sigmoïde. Elle souffre du même problème de saturation.
L’unité linéaire rectifiée (ReLU, de l’anglais rectified linear unit) est aujourd’hui la fonction d’activation la plus utilisée:
Ses avantages sont sa simplicité de calcul et l’absence de saturation pour les valeurs positives. Sa dérivée vaut 1 pour et 0 pour . Un inconvénient est que les neurones dont la pré-activation est toujours négative ont un gradient nul et cessent d’apprendre: c’est le problème des « neurones morts ».
Plusieurs variantes de ReLU existent pour atténuer ce problème. La Leaky ReLU utilise une petite pente pour les valeurs négatives: . La GELU (Gaussian Error Linear Unit), définie par où est la fonction de répartition normale, est utilisée dans les architectures modernes comme les transformeurs.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.special import erf
%config InlineBackend.figure_format = 'retina'

a = np.linspace(-4, 4, 400)

sigmoid = lambda x: 1 / (1 + np.exp(-x))
gelu    = lambda x: x * 0.5 * (1 + erf(x / np.sqrt(2)))

d_sigmoid = lambda x: sigmoid(x) * (1 - sigmoid(x))
d_tanh    = lambda x: 1 - np.tanh(x)**2
d_relu    = lambda x: (x > 0).astype(float)
eps = 1e-5
d_gelu    = lambda x: (gelu(x + eps) - gelu(x - eps)) / (2 * eps)

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

ax = axes[0]
ax.plot(a, sigmoid(a),       'C0', linewidth=2, label='Sigmoïde')
ax.plot(a, np.tanh(a),       'C1', linewidth=2, label='Tanh')
ax.plot(a, np.maximum(0, a), 'C2', linewidth=2, label='ReLU')
ax.plot(a, gelu(a),          'C3', linewidth=2, label='GELU', linestyle='--')
ax.axhline(0, color='k', linewidth=0.5, linestyle=':')
ax.axvline(0, color='k', linewidth=0.5, linestyle=':')
ax.set_xlabel('$a$ (pré-activation)')
ax.set_ylabel('$\\varphi(a)$')
ax.set_title("Fonctions d'activation")
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)
ax.set_xlim(-4, 4)

ax = axes[1]
ax.plot(a, d_sigmoid(a), 'C0', linewidth=2, label="$\\sigma'(a)$")
ax.plot(a, d_tanh(a),    'C1', linewidth=2, label="$\\tanh'(a)$")
ax.plot(a, d_relu(a),    'C2', linewidth=2, label="ReLU$'(a)$")
ax.plot(a, d_gelu(a),    'C3', linewidth=2, label="GELU$'(a)$", linestyle='--')
ax.axhline(0, color='k', linewidth=0.5, linestyle=':')
ax.axvline(0, color='k', linewidth=0.5, linestyle=':')
ax.annotate(
    "$\\sigma'(0) = 0{,}25$",
    xy=(0, 0.25), xytext=(1.3, 0.42),
    arrowprops=dict(arrowstyle='->', color='C0', lw=1.5),
    fontsize=9, color='C0'
)
ax.set_xlabel('$a$ (pré-activation)')
ax.set_ylabel("$\\varphi'(a)$")
ax.set_title('Dérivées des fonctions d\'activation')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)
ax.set_xlim(-4, 4)
ax.set_ylim(-0.1, 1.1)

plt.tight_layout()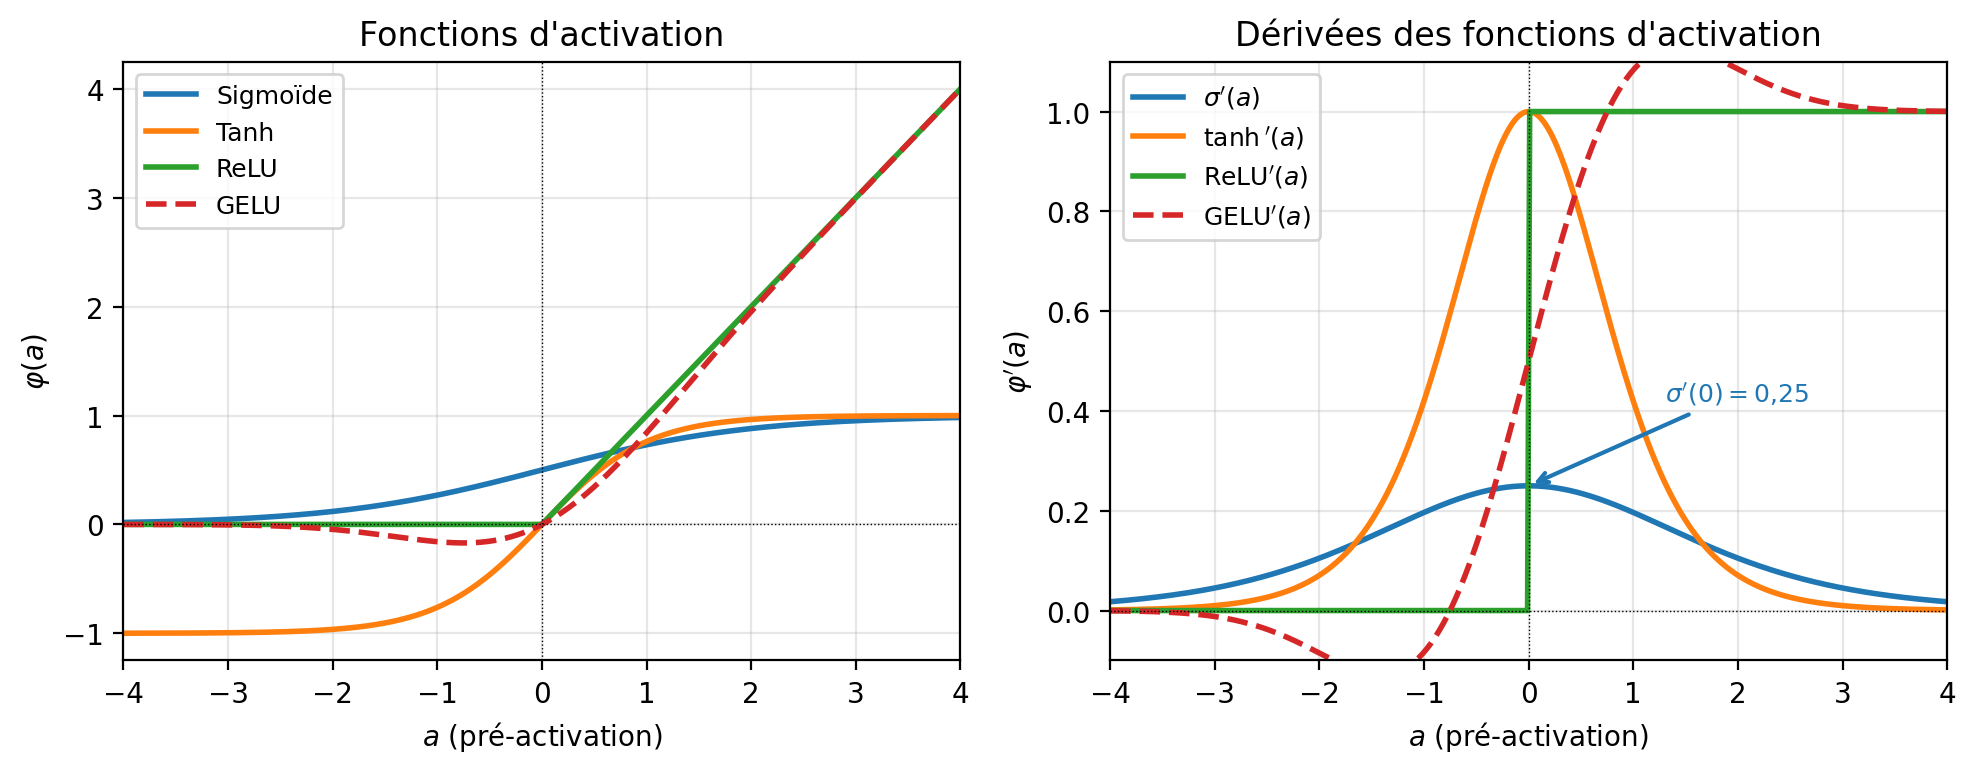
La dérivée de la sigmoïde est bornée par 0,25: à chaque couche, le gradient est multiplié par un facteur d’au plus 0,25. Ce phénomène de saturation est la cause principale de la dissolution du gradient dans les réseaux profonds. Nous y reviendrons en détail au chapitre suivant.
Le perceptron multicouche
Un perceptron multicouche (MLP, de l’anglais multilayer perceptron) compose plusieurs couches de la forme décrite ci-dessus. Pour un réseau à couches:
L’entrée traverse couches cachées, chacune produisant des activations . Ces activations sont les caractéristiques apprises, c’est-à-dire la fonction de l’équation (7). La dernière couche produit la sortie du réseau.
Le graphe de calcul d’un MLP à deux couches cachées est une chaîne d’opérations: chaque couche correspond à une transformation affine suivie d’une non-linéarité.
Ce graphe est une structure de données: il encode toutes les dépendances entre variables. La rétropropagation consiste à le parcourir en sens inverse pour calculer les gradients par rapport à chaque paramètre.
Couche de sortie: le lien avec le maximum de vraisemblance
Le traitement de la dernière couche dépend du problème et de notre choix de distribution conditionnelle:
Pour la régression (vraisemblance gaussienne), la couche de sortie est linéaire, sans activation:
La perte est la somme des carrés, , cohérente avec l’hypothèse de bruit gaussien.
Pour la classification binaire (vraisemblance de Bernoulli), la couche de sortie applique une sigmoïde:
La perte est l’entropie croisée binaire, exactement comme en régression logistique.
Pour la classification multiclasse (vraisemblance catégorielle), la couche de sortie applique un softmax:
La perte est l’entropie croisée catégorielle.
Un réseau de neurones pour la classification est donc une régression logistique dont les entrées sont des caractéristiques apprises. Les couches cachées construisent une représentation dans laquelle le problème devient (idéalement) linéairement séparable, et la dernière couche effectue la classification linéaire.
Expressivité
Un réseau avec une seule couche cachée suffisamment large peut approximer toute fonction continue sur un ensemble compact. Ce résultat, connu sous le nom de théorème d’approximation universelle Hornik et al. (1989), garantit l’expressivité théorique des MLP. Cependant, la largeur requise peut croître exponentiellement avec la complexité de la fonction cible. Les réseaux profonds (avec plusieurs couches) peuvent représenter certaines fonctions de manière beaucoup plus compacte que les réseaux larges mais peu profonds.
La figure ci-dessous illustre cette propriété: un réseau peu profond mais large et un réseau profond mais étroit approximent tous deux la même fonction, mais avec des complexités très différentes.
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

np.random.seed(0)

def relu(x):
    return np.maximum(0, x)

def forward_shallow(x, W1, b1, W2, b2):
    """Réseau large: 1 couche cachée, beaucoup de neurones."""
    h = relu(x[:, None] * W1[None, :] + b1[None, :])
    return h @ W2 + b2

def forward_deep(x, params):
    """Réseau profond: plusieurs couches, peu de neurones."""
    h = x[:, None]
    for W, b in params[:-1]:
        h = relu(h @ W + b)
    W, b = params[-1]
    return (h @ W + b).ravel()

# Cible: fonction non triviale
x_grid = np.linspace(0, 1, 200)
f_target = np.sin(2 * np.pi * x_grid) + 0.5 * np.sin(6 * np.pi * x_grid)

# Réseau peu profond, large (1 couche cachée, 40 neurones)
n_wide = 40
W1_s = np.random.randn(n_wide) * 3
b1_s = np.random.randn(n_wide)
# Ajuster W2 par pseudoinverse pour approximer la cible
H_s = relu(x_grid[:, None] * W1_s[None, :] + b1_s[None, :])
W2_s, _, _, _ = np.linalg.lstsq(
    np.column_stack([H_s, np.ones(len(x_grid))]),
    f_target, rcond=None
)
b2_s = W2_s[-1]
W2_s = W2_s[:-1]
pred_shallow = H_s @ W2_s + b2_s

# Réseau profond, étroit (4 couches cachées, 8 neurones)
n_deep = 8
params_deep = []
d_in = 1
for layer in range(4):
    W = np.random.randn(d_in, n_deep) * np.sqrt(2 / d_in)
    b = np.zeros(n_deep)
    params_deep.append((W, b))
    d_in = n_deep
W_out = np.random.randn(d_in, 1) * np.sqrt(2 / d_in)
b_out = np.zeros(1)
params_deep.append((W_out, b_out))

# Ajuster la dernière couche par pseudoinverse
h = x_grid[:, None]
for W, b in params_deep[:-1]:
    h = relu(h @ W + b)
W_out_fit, _, _, _ = np.linalg.lstsq(
    np.column_stack([h, np.ones(len(x_grid))]),
    f_target, rcond=None
)
b_out_fit = W_out_fit[-1]
W_out_fit = W_out_fit[:-1, None]
params_deep[-1] = (W_out_fit, np.array([b_out_fit]))

h = x_grid[:, None]
for W, b in params_deep[:-1]:
    h = relu(h @ W + b)
W_f, b_f = params_deep[-1]
pred_deep = (h @ W_f + b_f).ravel()

# Figure
fig, axes = plt.subplots(1, 2, figsize=(10, 4), sharey=True)

for ax, pred, title, n_params in zip(
    axes,
    [pred_shallow, pred_deep],
    [f'Peu profond, large\n(1 couche cachée, {n_wide} neurones)',
     f'Profond, étroit\n(4 couches cachées, {n_deep} neurones)'],
    [n_wide * 2 + n_wide + 1, 1 * n_deep + n_deep + 3 * n_deep * n_deep + n_deep + n_deep + 1]
):
    ax.plot(x_grid, f_target, 'k--', linewidth=2, label='Cible $f(x)$', alpha=0.7)
    ax.plot(x_grid, pred, 'C0', linewidth=2, label='Approximation')
    ax.set_xlabel('$x$')
    ax.set_title(title, fontsize=10)
    ax.legend(fontsize=9)
    ax.grid(True, alpha=0.3)

axes[0].set_ylabel('$f(x)$')
plt.suptitle("Théorème d'approximation universelle: deux architectures, une même fonction", fontsize=11)
plt.tight_layout()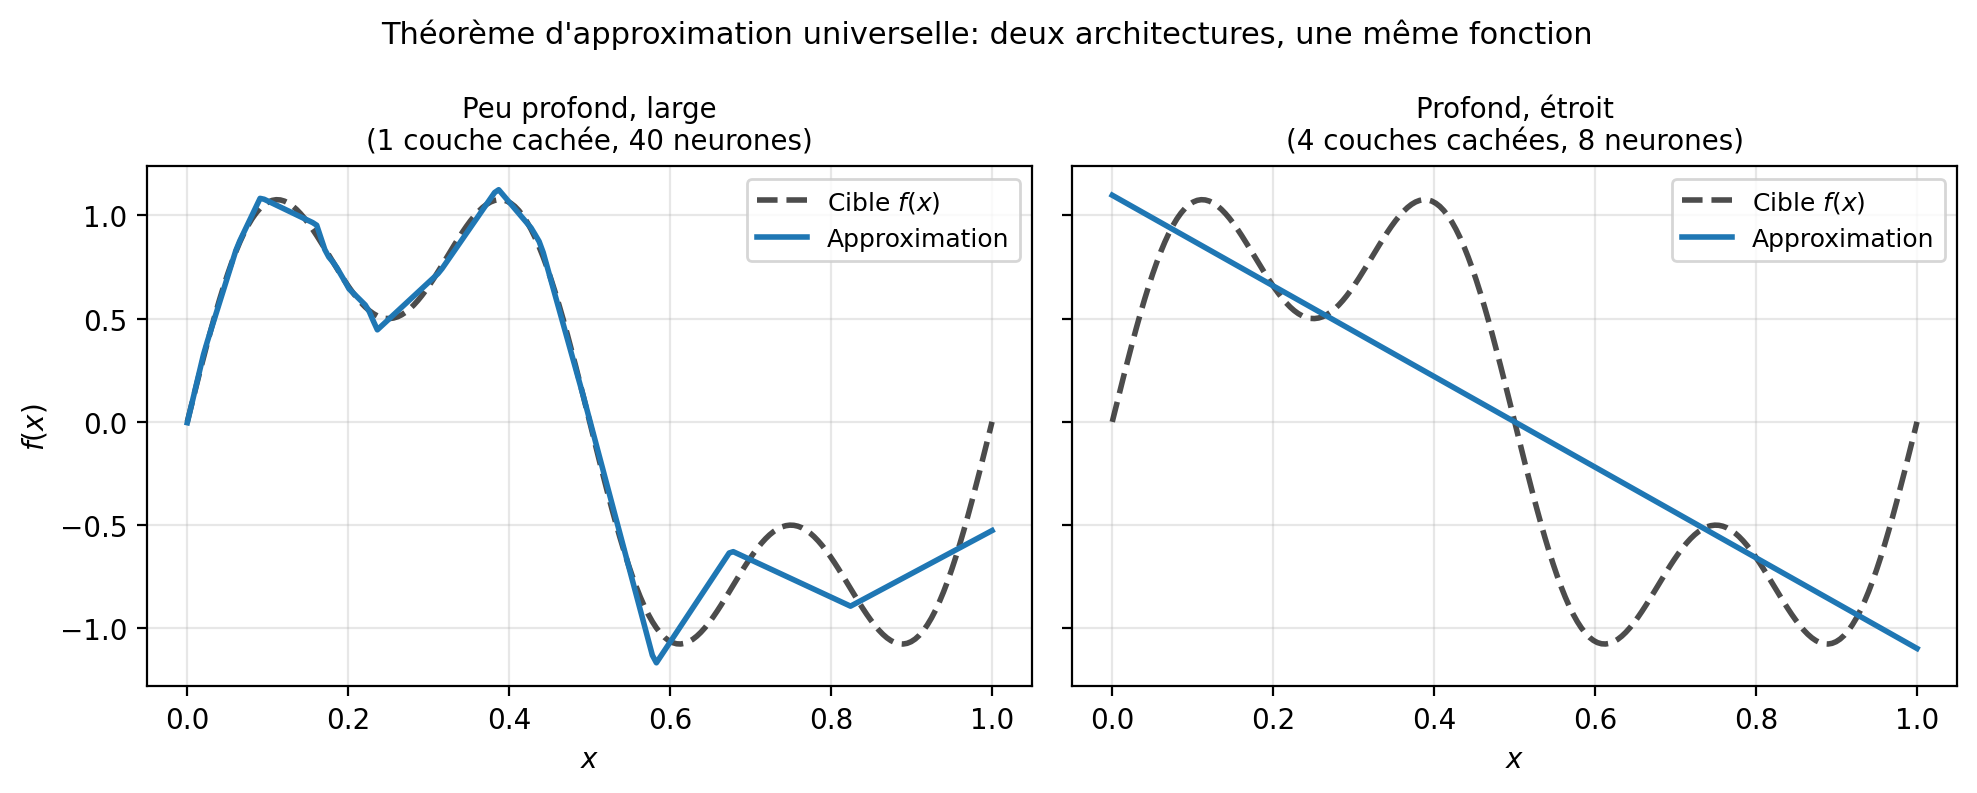
Les deux architectures approximent raisonnablement bien la même fonction cible. La différence réside dans l’organisation des paramètres: le réseau profond compose des représentations intermédiaires hiérarchiques, ce qui lui permet d’être plus compact pour des fonctions structurées.
À ce stade, vous avez vu la structure d’un réseau de neurones: des couches qui alternent transformations linéaires et non-linéarités, avec une couche de sortie adaptée au problème (régression ou classification). La question suivante est: comment apprendre les paramètres?
Dérivation automatique
Pour optimiser les paramètres d’un réseau, nous avons besoin du gradient de la perte par rapport à chaque paramètre. Dans un réseau à couches, la perte dépend des paramètres de la couche à travers toutes les couches suivantes : le calcul du gradient exige d’appliquer la règle de la chaîne à travers tout le graphe de calcul.
Cette section présente la dérivation automatique (DA), également appelée dérivation algorithmique ou, dans la littérature anglophone, automatic differentiation (AD). C’est le cadre général qui formalise ce calcul. Nous commençons par situer la DA parmi les approches de calcul de dérivées, puis nous développons la règle de la chaîne sous forme de produits jacobien-vecteur (JVP et VJP). Nous introduisons ensuite les graphes de calcul (DAG) et formulons les algorithmes du mode avant et du mode arrière sur un graphe arbitraire. La rétropropagation (backpropagation) apparaît alors comme un cas particulier du mode arrière, appliqué au graphe en chaîne d’un réseau de neurones. Enfin, nous montrons comment les bibliothèques modernes (JAX, PyTorch) implémentent ces principes via le traçage d’opérations.
Rappel: jacobiennes, hessiennes et conventions d’agencement
Jacobienne. Pour une fonction , la jacobienne est la matrice de toutes les dérivées partielles du premier ordre:
La ligne de est le gradient de la -ième composante de sortie; la colonne encode la sensibilité de toutes les sorties à l’entrée .
Cas particulier: le gradient. Quand est scalaire, la jacobienne se réduit à un vecteur ligne . Le gradient est sa transposée (vecteur colonne): .
Hessienne. Pour , la hessienne contient les dérivées partielles du second ordre:
Quand est deux fois continûment différentiable, est symétrique (théorème de Schwarz). La hessienne intervient dans les méthodes du second ordre (Newton, BFGS), mais pas dans la rétropropagation standard qui n’utilise que des dérivées du premier ordre.
Conventions d’agencement. Deux conventions coexistent dans la littérature et sont source de confusion:
Convention du numérateur (utilisée dans ce livre): avec les sorties en lignes et les entrées en colonnes.
Convention du dénominateur: la transposée de la convention précédente, .
Ces deux conventions sont cohérentes en interne, mais les formules de la règle de la chaîne et des VJP s’écrivent différemment selon celle qu’on adopte. La conséquence pratique: avec la convention du numérateur, pour , le gradient est un vecteur colonne, et le VJP est le produit d’un vecteur ligne par une matrice .
Dimensions dans un MLP. Les trois types de jacobiennes locales qui apparaissent en rétropropagation:
| Opération | Fonction | Jacobienne |
|---|---|---|
| Couche affine | , | |
| Activation élémentaire | , appliquée composante par composante | |
| Perte scalaire |
Ces dimensions se composent cohéremment: le produit donne bien un vecteur ligne, dont la transposée est le gradient par rapport à l’entrée .
Dérivation numérique, symbolique et automatique
Pour calculer la dérivée d’un programme, trois approches existent:
La dérivation numérique approxime la dérivée par différences finies:
Cette méthode est simple à implémenter mais souffre de deux problèmes: elle requiert évaluations de pour un gradient en dimension , et elle est sujette aux erreurs d’arrondi (le choix de est délicat). Elle reste utile pour vérifier des implémentations de gradient.
La dérivation symbolique applique les règles de dérivation formellement, comme on le ferait à la main. Le résultat est une expression mathématique, pas un nombre. La bibliothèque SymPy permet de s’en convaincre:
import sympy as sp

x = sp.Symbol('x')
f = sp.sin(x**2) * sp.exp(-x)

df = sp.diff(f, x)
print(df)L’appel sp.diff(f, x) retourne une nouvelle expression symbolique: . Le système manipule des formules, pas des valeurs numériques. Pour obtenir un nombre, il faut ensuite évaluer cette expression en un point:
df.subs(x, 1.0).evalf() # évalue la dérivée en x = 1Cette distinction entre construire une expression et évaluer un nombre est au cœur de la différence entre dérivation symbolique et automatique.
L’approche symbolique produit des résultats exacts, mais les expressions intermédiaires peuvent croître de façon exponentielle. Considérons une composition itérée sur niveaux. Chaque application de la règle de la chaîne multiplie l’expression par un facteur , et l’expression de la dérivée accumule un produit de cosinus imbriqués dont la taille croît avec . Pour des programmes réels avec des centaines d’opérations, cette croissance rend l’approche impraticable. De plus, la dérivation symbolique requiert que le programme soit représenté sous forme d’expression mathématique, ce qui exclut les structures de contrôle comme les boucles et les conditions.
La dérivation automatique (DA) est une troisième voie. Au lieu de construire l’expression symbolique de la dérivée puis de l’évaluer, elle évalue directement la dérivée en un point donné, en propageant des valeurs numériques à travers le programme. Chaque opération élémentaire (addition, multiplication, , , ...) est accompagnée de sa règle de dérivation locale, et la règle de la chaîne assemble ces dérivées locales au fur et à mesure de l’exécution. Le résultat est un nombre, la valeur exacte de la dérivée au point considéré, obtenu sans jamais former une expression intermédiaire. Contrairement à la dérivation numérique, ce résultat est exact (aux erreurs de virgule flottante près). Contrairement à la dérivation symbolique, il gère naturellement les boucles et les conditions, puisqu’il opère sur l’exécution concrète du programme.
La rétropropagation n’est rien d’autre que la dérivation automatique en mode arrière, appliquée au programme qui calcule la perte d’un réseau de neurones.
La règle de la chaîne pour les compositions
Considérons un réseau comme une composition de fonctions . La jacobienne de cette composition est le produit des jacobiennes individuelles:
où sont les valeurs intermédiaires calculées lors de la passe avant. Ce produit de matrices peut être évalué de deux façons, et le choix fait toute la différence.
Produits jacobien-vecteur
Le produit d’une jacobienne par un vecteur peut être calculé sans jamais former la jacobienne complète. Selon la direction de multiplication, on obtient deux opérations distinctes.
Le JVP (Jacobian-Vector Product) propage un vecteur tangent de gauche à droite:
Chaque étape multiplie une jacobienne locale par un vecteur, ce qui coûte au lieu de pour le produit par une matrice. Le calcul se fait dans le même sens que la passe avant: c’est le mode avant de la dérivation automatique.
Le VJP (Vector-Jacobian Product) propage un vecteur adjoint de droite à gauche:
Le calcul se fait dans le sens inverse de la passe avant: c’est le mode arrière.
Pour une perte scalaire , le gradient est exactement un VJP avec . Le mode arrière calcule donc le gradient par rapport à tous les paramètres en une seule passe arrière, quel que soit le nombre de paramètres. C’est pourquoi la rétropropagation utilise le mode arrière.
La figure ci-dessous contraste les deux modes sur une chaîne de trois fonctions . Le mode avant (JVP) propage un vecteur tangent de gauche à droite, ce qui coûte une passe par paramètre. Le mode arrière (VJP) propage l’adjoint de droite à gauche en une seule passe.
Mode avant (JVP): le vecteur tangent se propage de gauche à droite.
Mode arrière (VJP): l’adjoint se propage de droite à gauche.
Pour une perte scalaire avec paramètres, le mode avant nécessite passes (une par direction de base ), tandis que le mode arrière calcule tout le gradient en une seule passe. C’est l’argument central qui justifie la rétropropagation dans les réseaux avec des millions de paramètres.
Le carnet Produits jacobien-vecteur en mode inverse (VJP) illustre ce mécanisme pas à pas sur un réseau à trois couches, en vérifiant à chaque étape que les VJP produisent le même résultat que les produits matriciels explicites.
Graphes de calcul
Les deux modes ont été présentés pour une composition en chaîne. Mais les programmes réels ont des structures plus riches: une variable peut intervenir dans plusieurs opérations, créant des embranchements dans le graphe de calcul.
Toute expression arithmétique peut se décomposer en une séquence d’opérations élémentaires. Pour , cette décomposition introduit deux variables intermédiaires:
On représente ces dépendances par un graphe orienté acyclique (DAG): chaque noeud est une valeur (entrée, intermédiaire ou sortie) et chaque arête indique qu’une valeur est utilisée pour calculer une autre.
Règle de la chaîne sur un DAG
Remarquez que a deux arêtes sortantes: il alimente et . Cela signifie que contribue à par deux chemins distincts dans le graphe. Notons , et les opérations locales de chaque noeud. La fonction composée est . En appliquant la règle de la chaîne multivariée, la dérivée totale de par rapport à est:
La somme comporte deux termes, un par chemin de à dans le graphe:
Chemin : le produit des jacobiennes locales le long des arêtes,
Chemin : le produit
C’est la structure générale: la dérivée totale par rapport à une variable est la somme sur tous les chemins de cette variable à la sortie, où chaque chemin contribue le produit des jacobiennes locales le long de ses arêtes. Un noeud avec arêtes sortantes génère termes dans cette somme.
De manière générale, notons l’ensemble des prédécesseurs d’un noeud (les noeuds dont dépend directement) et l’ensemble de ses successeurs (les noeuds qui dépendent directement de ). La règle de la chaîne s’écrit dans les deux sens:
Direction avant (tangentes). Étant donné un vecteur tangent pour chaque entrée, la tangente d’un noeud intermédiaire se propage vers l’avant. Le noeud reçoit les tangentes de tous ses prédécesseurs et les combine:
Chaque arête entrante contribue un JVP (jacobienne locale tangente du prédécesseur). Le noeud somme ces contributions.
Direction arrière (adjoints). Étant donné un adjoint pour la sortie, l’adjoint de chaque noeud se propage vers l’arrière. Le noeud reçoit les adjoints de tous ses successeurs:
Chaque arête sortante (parcourue à rebours) contribue un VJP (adjoint du successeur jacobienne locale). Le noeud somme ces contributions.
Les deux formules sont symétriques: la première applique à droite d’un vecteur tangent (JVP), la seconde applique à gauche d’un vecteur adjoint (VJP). C’est la règle de la chaîne multivariée.
Tri topologique
Les deux formules ci-dessus posent un problème d’ordre. Pour calculer (direction avant), il faut d’abord connaître pour tous les prédécesseurs de . Pour calculer (direction arrière), il faut d’abord connaître pour tous les successeurs de .
Un tri topologique fournit un ordre de traitement qui respecte ces contraintes: chaque noeud apparaît après tous ses prédécesseurs. La passe avant suit cet ordre; la passe arrière le parcourt à rebours.
Le diagramme ci-dessous montre un tri topologique valide pour notre exemple. Les numéros indiquent l’ordre de traitement de la passe arrière (qui parcourt la liste à rebours):
Remarquez que est traité en dernier (⑥) par la passe arrière: comme contribue à deux branches ( et ), il faut avoir accumulé les deux contributions avant de pouvoir calculer .
L’algorithme classique de tri topologique repose sur un parcours en profondeur (DFS):
Mode avant (forward-mode AD)
Le mode avant propage les tangentes dans le même sens que l’exécution du programme, de l’entrée vers la sortie. On calcule simultanément la valeur de chaque noeud et sa tangente.
Une passe avant calcule un seul produit jacobien-vecteur , c’est-à-dire la dérivée directionnelle de dans la direction . Pour obtenir le gradient complet d’une fonction scalaire , il faudrait effectuer passes (une par vecteur de base ). Le mode avant est donc efficace quand le nombre d’entrées est petit par rapport au nombre de sorties.
Mode arrière (reverse-mode AD)
Le mode arrière procède en deux temps: d’abord une passe avant qui calcule et stocke les valeurs de chaque noeud, puis une passe arrière qui propage les adjoints de la sortie vers les entrées.
Une seule passe arrière calcule le gradient par rapport à toutes les entrées. Pour une perte scalaire avec paramètres, le mode arrière calcule le gradient complet en une passe, là où le mode avant en nécessiterait . C’est l’argument central qui justifie l’usage du mode arrière pour l’entraînement des réseaux de neurones.
Le mode arrière a été décrit pour la première fois par Seppo Linnainmaa Linnainmaa (1970) dans sa thèse de maîtrise à l’Université d’Helsinki. Dans le contexte de l’apprentissage profond, cet algorithme porte le nom de rétropropagation (backpropagation), popularisé par Rumelhart, Hinton et Williams en 1986 Rumelhart et al. (1986). Un réseau à couches définit un DAG en chaîne , où chaque noeud n’a qu’un seul prédécesseur et un seul successeur. La passe arrière se simplifie alors en une boucle sur les couches . Mais le mode arrière est plus général: il s’applique à tout programme différentiable, y compris ceux qui contiennent des embranchements, des variables réutilisées, des boucles ou des conditions. C’est ce qui permet à des bibliothèques comme JAX ou PyTorch de différentier n’importe quelle fonction Python.
L’animation interactive ci-dessous illustre les deux algorithmes sur le DAG de avec les valeurs . En mode avant, les tangentes se propagent de gauche à droite; en mode arrière, les adjoints se propagent de droite à gauche. Observez en particulier comment accumule les contributions de ses deux successeurs et lors de la passe arrière.
/Users/pierre-luc.bacon/Documents/mlbook/.venv/lib/python3.12/site-packages/IPython/core/display.py:447: UserWarning: Consider using IPython.display.IFrame instead
  warnings.warn("Consider using IPython.display.IFrame instead")
Règles VJP: une bibliothèque d’opérateurs adjoints
L’algorithme du mode arrière fait intervenir les jacobiennes locales à chaque étape. Une question reste ouverte: comment calcule-t-on efficacement, sans construire la jacobienne complète?
La réponse repose sur une distinction fondamentale. La jacobienne est une représentation matricielle d’un objet plus abstrait: la différentielle , qui est un opérateur linéaire . Ce qui importe dans le mode arrière n’est pas lui-même, mais son opérateur adjoint , qui envoie les vecteurs du co-domaine vers le domaine (c’est-à-dire qui propage le signal en sens inverse). En coordonnées, le VJP est : le produit d’un vecteur adjoint (ligne) par la jacobienne.
Pour définir un opérateur linéaire, il n’est pas nécessaire d’en donner la matrice: on peut spécifier son action sur des vecteurs. Une bibliothèque de DA (JAX, PyTorch) maintient pour chaque opération primitive une règle VJP: une fonction qui calcule directement à partir de , , et éventuellement , en n’utilisant que des opérations arithmétiques simples.
Lorsque deux opérations se composent, , la règle VJP de est le produit des règles VJP de et :
La passe arrière n’est rien d’autre que l’exécution récursive de ces règles, de la sortie vers l’entrée. Le système est entièrement sans matrice jacobienne explicite: aucune matrice n’est jamais construite ni stockée.
Le tableau ci-dessous liste les règles VJP pour les opérations clés d’un MLP. À chaque fois, la règle VJP évite de former la jacobienne correspondante:
| Opération | Jacobienne (non formée) | Règle VJP: | |
|---|---|---|---|
| Couche affine (entrée ) | |||
| Couche affine (poids ) | (produit externe) | ||
| Couche affine (biais ) | |||
| Activation élémentaire | |||
| Somme | scalaire | (diffusion) |
L’exemple de l’activation élémentaire illustre parfaitement le bénéfice: la jacobienne serait une matrice coûtant en mémoire, alors que la règle VJP, , est un produit élément par élément en .
En JAX, jax.custom_vjp permet d’enregistrer exactement ce type de règle pour une opération personnalisée. Écrire une règle VJP correcte pour un nouvel opérateur est une compétence essentielle en apprentissage profond avancé; les exercices 9 à 11 vous entraînent à cette dérivation.
Exemple: MLP avec une couche cachée
Prenons un réseau à une couche cachée avec la perte des moindres carrés:
Le graphe de calcul de ce réseau rend explicites toutes les dépendances. Les nœuds en jaune sont les paramètres (feuilles du graphe); la passe avant suit les flèches de gauche à droite, et la passe arrière les remonte de droite à gauche.
La passe arrière calcule les adjoints en remontant ce graphe nœud par nœud, en appliquant les règles VJP de chaque opération.
La passe avant calcule les valeurs intermédiaires:
La passe arrière propage les adjoints en sens inverse, couche par couche. La notation désigne l’adjoint du noeud , c’est-à-dire la sensibilité de à :
où désigne le produit élément par élément. Chaque ligne utilise uniquement des quantités déjà calculées, soit lors de la passe avant (, , ), soit lors des étapes précédentes de la passe arrière. La structure est toujours la même: l’adjoint des pré-activations d’une couche est propagé vers l’arrière pour obtenir l’adjoint de la couche précédente.
Point de contrôle: Si vous pouvez suivre cet exemple du début à la fin, vous avez compris le mécanisme de la rétropropagation. C’est une instance de l’algorithme du mode arrière de la section précédente, spécialisée à un réseau en chaîne. Si certaines étapes restent floues, l’exercice 3 vous permettra de refaire ce calcul vous-même avec des valeurs numériques.
L’animation interactive ci-dessous déroule la passe avant et la rétropropagation sur un réseau à deux couches avec des valeurs numériques concrètes. Observez comment chaque couche produit les gradients de ses paramètres (, ) tout en propageant le signal vers l’arrière, et comment la dérivée de l’activation () joue le rôle de «porte» qui laisse passer ou bloque le gradient.
La liste de Wengert
En 1964, Wengert Wengert (1964) a proposé de représenter toute fonction calculable comme une séquence ordonnée d’opérations élémentaires, chacune ayant une dérivée connue. Cette séquence, appelée liste de Wengert (ou tape, bande), est le graphe de calcul sérialisé en ordre topologique. La contribution de Wengert était de rendre la dérivation algorithmique: en décomposant un programme en étapes atomiques et en les écrivant dans l’ordre, une machine peut appliquer la règle de la chaîne mécaniquement, sans intervention humaine.
En mode avant, cette liste guide la propagation des tangentes: chaque étape calcule simultanément sa valeur et sa dérivée, sans rien retenir. Mais en mode arrière, la bande devient indispensable comme structure de stockage: il faut rejouer les opérations à rebours, ce qui exige de conserver les valeurs intermédiaires de la passe avant. C’est ce rôle de stockage qui domine dans les bibliothèques modernes de DA (JAX, PyTorch), puisque l’entraînement des réseaux utilise le mode arrière.
Concrètement, pendant la passe avant, chaque opération enregistre sur la bande ses entrées, sa sortie, et une fonction VJP locale. Cette fonction est construite au moment de l’opération, et elle capture les valeurs intermédiaires dont elle aura besoin plus tard pour calculer le gradient. En programmation, on appelle cela une fermeture (closure). Prenons l’opération comme exemple. Au moment du calcul, la passe avant connaît les valeurs de et . La règle VJP de la multiplication est : elle a besoin des valeurs et de la passe avant. La fermeture les capture:
# Pendant la passe avant, au moment de v3 = v1 * v2 :
v1_val, v2_val = v1, v2           # valeurs connues maintenant

def mul_vjp(v3_bar):              # sera appelée pendant la passe arrière
    return (v2_val * v3_bar,      # gradient pour v1
            v1_val * v3_bar)      # gradient pour v2

tape.append(mul_vjp)              # on stocke la fermeture, pas les valeurs brutes
La fonction mul_vjp ne sera appelée que plus tard, pendant la passe arrière, avec l’adjoint comme argument. Mais elle a déjà accès à v1_val et v2_val, capturés au moment de sa création. C’est ce mécanisme de capture qui rend la bande autonome: chaque entrée contient tout ce qu’il faut pour calculer sa contribution au gradient, sans consulter à nouveau le programme original.
La passe arrière rejoue la liste à rebours, en appelant chaque VJP locale dans l’ordre inverse. Contrairement au DAG, la bande est une liste ordonnée (un tableau linéaire), ce qui la rend simple à parcourir dans les deux sens. Les flèches pleines montrent l’enregistrement (passe avant); les flèches pointillées montrent le rejeu (passe arrière).
La bande démarre vide et grandit à chaque opération (flèches pleines, gauche à droite). Une fois calculée, la passe arrière initialise puis remonte la liste à rebours (flèches pointillées, droite à gauche).
Le tableau ci-dessous détaille le contenu de chaque entrée et les formules de VJP associées. La barre désigne l’adjoint ; la passe arrière parcourt les étapes 3 → 2 → 1.
| Étape | Opération | Entrées | Sortie | VJP locale |
|---|---|---|---|---|
| 1 | sin | |||
| 2 | add | , | ||
| 3 | mul | , |
Chaque ligne de la bande correspond à une opération élémentaire. La passe arrière part de l’adjoint (gradient de par rapport à lui-même) et remonte: l’étape 3 envoie des gradients à et , puis les étapes 2 et 1 envoient leurs gradients à et .
Le traceur
Comment une bibliothèque comme JAX construit-elle cette bande automatiquement, sans modifier le programme utilisateur? La réponse est le traceur (tracer).
Lorsque JAX différentie une fonction, il ne l’appelle pas avec des nombres ordinaires. Il l’appelle avec des objets spéciaux, des traceurs, qui se font passer pour des nombres mais enregistrent discrètement toutes les opérations qu’on leur applique.
Concrètement, un traceur est un objet qui:
Stocke une valeur concrète (le résultat numérique de l’opération),
Enregistre l’opération sur la bande, avec ses entrées et une fermeture (closure) qui sait calculer les gradients locaux,
Retourne un nouveau traceur comme résultat, de sorte que les opérations suivantes soient également interceptées.
Le diagramme ci-dessous montre comment les objets traceurs se construisent et se connectent lors de l’évaluation de . Chaque noeud porte sa valeur concrète et son adjoint (initialement nul); les arêtes représentent les dépendances enregistrées par chaque fermeture.
La passe arrière initialise , puis parcourt les arêtes à rebours: chaque fermeture accumule les adjoints dans les noeuds parents. Quand les deux fermetures de et ont été appelées, x.grad contient la somme des deux contributions.
Le tableau ci-dessous montre la correspondance entre l’exécution Python et la bande construite automatiquement. Chaque ligne de code qui effectue une opération tracée ajoute une entrée sur la bande, avec la règle VJP correspondante.
| Ligne Python | Bande: opération enregistrée | VJP locale |
|---|---|---|
x = Var(0.5) | (entrée, pas d’opération) | — |
y = Var(1.2) | (entrée, pas d’opération) | — |
v1 = sin(x) | (sin, x → v₁) | |
v2 = x + y | (add, x, y → v₂) | , |
v3 = v1 * v2 | (mul, v₁, v₂ → v₃) | , |
La passe arrière parcourt la bande de bas en haut (étapes 3 → 2 → 1), en appelant chaque règle VJP.
L’exécution Python se déroule normalement, ligne par ligne. Python ne sait pas qu’il trace un graphe: il appelle simplement les méthodes __add__, __mul__, sin sur les objets traceurs, et ces méthodes enregistrent discrètement les opérations. Quand l’exécution est terminée, la bande est complète, et la passe arrière peut s’exécuter.
Ce mécanisme explique pourquoi la dérivation automatique gère naturellement les boucles et les conditions: Python les exécute normalement, et les traceurs enregistrent les opérations qui sont effectivement effectuées lors de cette exécution particulière.
L’astuce d’importation
Le mécanisme du traceur explique une convention qui surprend souvent les débutants. Dans tout code JAX, on écrit:
import jax.numpy as jnp # et non: import numpy as npPourquoi? Lorsque JAX différentie une fonction, il lui passe des traceurs à la place des tableaux NumPy ordinaires. Si vous appelez np.sin(tracer), NumPy ne connaît pas les traceurs: il va tenter de convertir l’objet en tableau numérique, ce qui casse la trace et donne un résultat incorrect (ou lève une erreur).
En revanche, jnp.sin(tracer) est une opération que JAX connaît. JAX intercepte l’appel, enregistre l’opération sur la bande, calcule la valeur concrète, et retourne un nouveau traceur. La trace reste intacte.
import jax
import jax.numpy as jnp
import numpy as np

def f_jnp(x):
    return jnp.sin(x) * x  # correct: jnp intercepte le traceur

def f_np(x):
    return np.sin(x) * x   # incorrect: np ne comprend pas les traceurs

grad_jnp = jax.grad(f_jnp)(1.0)   # fonctionne: retourne cos(1)*1 + sin(1) ≈ 1.382
# grad_np = jax.grad(f_np)(1.0)   # lèverait une erreur ou donnerait un résultat faux
jax.numpy est un espace de noms qui réimplémente toutes les fonctions NumPy de manière à intercepter les traceurs. Pour les tableaux NumPy ordinaires (sans traceur), jnp et np produisent les mêmes résultats numériques. La différence n’apparaît que pendant la trace.
Implémentation minimale
Cette sous-section est optionnelle pour IFT3395. Elle montre comment implémenter un moteur de dérivation automatique en mode arrière en une soixantaine de lignes de Python pur.
La section précédente a identifié trois mécanismes: les règles VJP locales, la bande d’enregistrement, et la passe arrière. Nous allons maintenant les assembler en une implémentation fonctionnelle, structurée comme le seraient JAX ou autograd en version simplifiée Maclaurin et al. (2015). L’architecture se décompose en trois parties:
Une bibliothèque de règles VJP. Pour chaque opération primitive, une fonction qui prend les résidus (valeurs de la passe avant nécessaires au calcul du gradient) et le cotangent amont , et retourne les cotangents pour chaque entrée. Ces fonctions sont les mêmes que celles du tableau de la section précédente.
Un traceur avec bande. Un objet
Varqui encapsule un flottant et enregistre chaque opération sur une bande globale. C’est l’analogue simplifié des traceurs de JAX.Une fonction
grad. Un opérateur d’ordre supérieur, analogue àjax.grad, qui trace la fonction puis parcourt la bande à rebours en appelant les règles VJP.
import math

# ---- 1. Bibliothèque de règles VJP ----
# Signature commune: vjp(résidus, cotangent_sortie) → cotangents_entrées

def add_vjp(res, g):
    return (g, g)                        # ∂(a+b)/∂a = 1, ∂(a+b)/∂b = 1

def mul_vjp(res, g):
    a, b = res
    return (b * g, a * g)                # ∂(a·b)/∂a = b, ∂(a·b)/∂b = a

def sin_vjp(res, g):
    (a,) = res
    return (math.cos(a) * g,)            # ∂sin(a)/∂a = cos(a)

def relu_vjp(res, g):
    (a,) = res
    return (float(a > 0) * g,)           # ∂relu(a)/∂a = 𝟙(a > 0)


# ---- 2. Traceur et bande ----

_tape = []      # bande globale: [(vjp_fn, résidus, ids_entrées, id_sortie)]
_n_vars = 0     # compteur d'identifiants

class Var:
    """Traceur scalaire: encapsule un flottant et un identifiant unique."""

    def __init__(self, data):
        global _n_vars
        self.data = float(data)
        self.id = _n_vars
        _n_vars += 1

    def _record(self, vjp_fn, res, inputs, out_data):
        """Enregistre une opération sur la bande et retourne un nouveau Var."""
        out = Var(out_data)
        _tape.append((vjp_fn, res, [v.id for v in inputs], out.id))
        return out

    def __add__(self, other):
        other = other if isinstance(other, Var) else Var(other)
        return self._record(add_vjp, (self.data, other.data),
                            [self, other], self.data + other.data)

    def __radd__(self, other): return self.__add__(other)

    def __mul__(self, other):
        other = other if isinstance(other, Var) else Var(other)
        return self._record(mul_vjp, (self.data, other.data),
                            [self, other], self.data * other.data)

    def __rmul__(self, other): return self.__mul__(other)

    def sin(self):
        return self._record(sin_vjp, (self.data,),
                            [self], math.sin(self.data))

    def relu(self):
        return self._record(relu_vjp, (self.data,),
                            [self], max(0.0, self.data))


# ---- 3. Fonction grad (analogue à jax.grad) ----

def grad(f):
    """Retourne une fonction qui calcule le gradient de f."""
    def grad_fn(*args):
        global _tape, _n_vars
        _tape, _n_vars = [], 0               # réinitialiser la bande

        # Passe avant: tracer l'exécution
        traced = [Var(a) for a in args]
        result = f(*traced)

        # Passe arrière: propager les cotangents
        adjoints = [0.0] * _n_vars
        adjoints[result.id] = 1.0            # ∂f/∂f = 1

        for vjp_fn, res, in_ids, out_id in reversed(_tape):
            cotangents = vjp_fn(res, adjoints[out_id])
            for idx, ct in zip(in_ids, cotangents):
                adjoints[idx] += ct          # accumulation (embranchement)

        return tuple(adjoints[v.id] for v in traced)
    return grad_fn
La séparation en trois parties n’est pas un choix esthétique: c’est la structure réelle des bibliothèques de DA. Dans JAX, les règles VJP sont enregistrées via jax.custom_vjp, la bande est construite par le traceur interne, et jax.grad orchestre la passe arrière. Notre implémentation reproduit cette architecture en miniature.
Vérifions sur :
import math

# --- Valeurs de test ---
x0, y0 = 0.5, 1.2

# --- Avec notre moteur de DA ---
def f(x, y):
    return x.sin() * (x + y)

df_dx, df_dy = grad(f)(x0, y0)

print(f'f({x0}, {y0})          = {math.sin(x0) * (x0 + y0):.6f}')
print(f'∂f/∂x (AD)           = {df_dx:.6f}')
print(f'∂f/∂y (AD)           = {df_dy:.6f}')

# --- Vérification analytique ---
df_dx_exact = math.cos(x0) * (x0 + y0) + math.sin(x0)
df_dy_exact = math.sin(x0)
print(f'∂f/∂x (exact)        = {df_dx_exact:.6f}')
print(f'∂f/∂y (exact)        = {df_dy_exact:.6f}')

# --- Vérification par différences finies ---
eps = 1e-5
df_dx_num = (math.sin(x0+eps)*(x0+eps+y0) - math.sin(x0-eps)*(x0-eps+y0)) / (2*eps)
df_dy_num = (math.sin(x0)*(x0+y0+eps)     - math.sin(x0)*(x0+y0-eps))     / (2*eps)
print(f'∂f/∂x (diff. fin.)  = {df_dx_num:.6f}')
print(f'∂f/∂y (diff. fin.)  = {df_dy_num:.6f}')
f(0.5, 1.2) = 0.815023
∂f/∂x (AD) = 1.971316
∂f/∂y (AD) = 0.479426
∂f/∂x (exact) = 1.971316
∂f/∂y (exact) = 0.479426
∂f/∂x (diff. fin.) = 1.971316
∂f/∂y (diff. fin.) = 0.479426
Les trois méthodes sont en accord. Remarquez que grad est une fonction d’ordre supérieur qui retourne une nouvelle fonction, exactement comme jax.grad. L’accumulation des adjoints (ligne adjoints[idx] += ct) gère automatiquement le cas où une variable contribue à plusieurs branches du calcul: c’est la somme des deux chemins pour .
La programmation différentiable
Les bibliothèques modernes comme JAX, PyTorch et TensorFlow implémentent la dérivation automatique de manière générale: toute fonction composée d’opérations dont on connaît les dérivées locales peut être différentiée automatiquement. C’est le paradigme de la programmation différentiable (differentiable programming).
Au lieu de dériver manuellement les gradients pour chaque architecture, nous écrivons la passe avant comme un programme ordinaire, et la bibliothèque se charge de calculer les gradients.
Voici un exemple avec JAX. Nous définissons la passe avant d’un MLP à une couche cachée, puis utilisons jax.grad pour obtenir automatiquement la fonction qui calcule les gradients:
import jax
import jax.numpy as jnp

def predict(params, x):
    """Passe avant d'un MLP à une couche cachée."""
    W1, b1, W2, b2 = params
    h = jnp.tanh(W1 @ x + b1)  # couche cachée
    return W2 @ h + b2           # couche de sortie

def loss_fn(params, x, y):
    """Perte des moindres carrés."""
    y_pred = predict(params, x)
    return 0.5 * jnp.sum((y_pred - y) ** 2)

# jax.grad retourne une FONCTION qui calcule le gradient
grad_fn = jax.grad(loss_fn)

# Un seul appel donne les gradients par rapport à tous les paramètres
grads = grad_fn(params, x, y)
La fonction loss_fn est un programme Python ordinaire. L’appel jax.grad(loss_fn) produit une nouvelle fonction qui calcule le gradient par rapport au premier argument (params). Aucune dérivation manuelle n’est nécessaire: JAX applique la règle de la chaîne automatiquement, en mode arrière, sur la trace d’exécution du programme.
Ce paradigme change la façon de penser les modèles. Au lieu de concevoir une architecture puis de dériver ses gradients, on conçoit un programme de calcul quelconque, avec des boucles, des conditions, des appels de fonctions, et on le différentie automatiquement. La seule contrainte est que les opérations soient différentiables (ou différentiables presque partout, comme ReLU).
Implémentation
Cette section réunit les concepts du chapitre dans une implémentation complète d’un MLP en NumPy. L’optimiseur Adam utilisé ici est décrit en détail au chapitre suivant. Le code est volontairement auto-contenu et commenté pas à pas: l’objectif est de rendre le lien entre les équations et le code aussi direct que possible.
Classe MLP avec Adam
import numpy as np

class MLP:
    """
    Perceptron multicouche à une couche cachée.
    Activation cachée: ReLU. Activation de sortie: sigmoïde (classification binaire).
    Optimiseur: Adam.
    """

    def __init__(self, n_input, n_hidden, n_output,
                 eta=1e-3, beta1=0.9, beta2=0.999, eps=1e-8,
                 lam=0.0, p_drop=0.0, seed=0):
        rng = np.random.default_rng(seed)
        # Initialisation He pour ReLU
        self.W1 = rng.standard_normal((n_input,  n_hidden)) * np.sqrt(2 / n_input)
        self.b1 = np.zeros(n_hidden)
        # Initialisation Glorot pour la couche de sortie (sigmoïde)
        self.W2 = rng.standard_normal((n_hidden, n_output)) * np.sqrt(2 / (n_hidden + n_output))
        self.b2 = np.zeros(n_output)

        self.eta   = eta
        self.beta1 = beta1;  self.beta2 = beta2;  self.eps = eps
        self.lam   = lam     # décroissance des poids
        self.p_drop = p_drop # taux de dropout

        # État interne Adam (moments)
        self._t = 0
        self._m = {k: np.zeros_like(v)
                   for k, v in [('W1',self.W1),('b1',self.b1),
                                 ('W2',self.W2),('b2',self.b2)]}
        self._s = {k: np.zeros_like(v) for k, v in self._m.items()}

    # ------------------------------------------------------------------
    def _relu(self, x):     return np.maximum(0, x)
    def _sigmoid(self, x):  return 1 / (1 + np.exp(-np.clip(x, -50, 50)))

    # ------------------------------------------------------------------
    def forward(self, X, training=False):
        """Passe avant. Retourne les sorties et les caches."""
        a1 = X @ self.W1 + self.b1          # pré-activations couche cachée
        z1 = self._relu(a1)                  # activations ReLU

        # Dropout (entraînement uniquement)
        if training and self.p_drop > 0:
            mask = (np.random.rand(*z1.shape) > self.p_drop) / (1 - self.p_drop)
            z1 = z1 * mask
        else:
            mask = np.ones_like(z1)

        a2   = z1 @ self.W2 + self.b2       # pré-activations couche de sortie
        pred = self._sigmoid(a2)             # probabilités
        cache = {'X': X, 'a1': a1, 'z1': z1, 'mask': mask}
        return pred, cache

    # ------------------------------------------------------------------
    def backward(self, pred, y, cache):
        """
        Passe arrière. Retourne les gradients par rapport à tous les paramètres.
        y: vecteur colonne de cibles binaires.
        """
        B = len(y)
        X, a1, z1, mask = cache['X'], cache['a1'], cache['z1'], cache['mask']

        # Gradient de l'entropie croisée + sigmoïde: dp = pred - y
        dp  = (pred - y) / B

        # Couche de sortie
        dW2 = z1.T @ dp + self.lam * self.W2 / B
        db2 = dp.sum(axis=0)

        # Propagation vers la couche cachée
        dz1 = dp @ self.W2.T
        dz1 = dz1 * mask            # rétropropagation à travers le dropout
        da1 = dz1 * (a1 > 0)        # dérivée de ReLU

        # Couche cachée
        dW1 = X.T @ da1 + self.lam * self.W1 / B
        db1 = da1.sum(axis=0)

        return {'W1': dW1, 'b1': db1, 'W2': dW2, 'b2': db2}

    # ------------------------------------------------------------------
    def _adam_update(self, grads):
        """Applique une étape Adam à tous les paramètres."""
        self._t += 1
        for name, param in [('W1',self.W1),('b1',self.b1),
                              ('W2',self.W2),('b2',self.b2)]:
            g = grads[name]
            self._m[name] = self.beta1 * self._m[name] + (1 - self.beta1) * g
            self._s[name] = self.beta2 * self._s[name] + (1 - self.beta2) * g**2
            mhat = self._m[name] / (1 - self.beta1**self._t)
            shat = self._s[name] / (1 - self.beta2**self._t)
            param -= self.eta * mhat / (np.sqrt(shat) + self.eps)

    # ------------------------------------------------------------------
    def train_step(self, X, y):
        """Une étape d'entraînement sur un mini-lot (X, y)."""
        pred, cache = self.forward(X, training=True)
        grads = self.backward(pred, y.reshape(-1,1).astype(float), cache)
        self._adam_update(grads)
        y_col = y.reshape(-1,1).astype(float)
        p = np.clip(pred, 1e-7, 1-1e-7)
        loss = -np.mean(y_col*np.log(p) + (1-y_col)*np.log(1-p))
        return loss

    def predict_proba(self, X):
        pred, _ = self.forward(X, training=False)
        return pred

    def predict(self, X):
        return (self.predict_proba(X) >= 0.5).astype(int).ravel()
Le MLP en pratique
Les sections précédentes ont présenté le MLP comme un objet mathématique: une composition de transformations affines et de non-linéarités. Mais à quoi ressemble cette composition pour un problème concret de régression ou de classification? La réponse nous ramène directement aux modèles linéaires des chapitres 2 et 3.
Régression avec un MLP
Au chapitre 2, la régression linéaire prédit la moyenne d’une gaussienne conditionnelle par une transformation affine:
Passer à un MLP revient à composer des transformations affines et des non-linéarités avant cette sortie linéaire. Pour un réseau à deux couches cachées avec :
où , , , et est une activation (typiquement ReLU). La dernière couche est linéaire (pas d’activation), et la perte reste la somme des carrés, exactement comme au chapitre 2.
Si l’on veut prédire un vecteur (par exemple des coordonnées, ou plusieurs cibles simultanément), la dernière couche devient une transformation affine :
La perte est la somme des carrés sur les sorties: .
Classification avec un MLP
Au chapitre 3, la régression logistique modélise la probabilité de la classe positive par:
Un MLP pour la classification binaire compose des couches cachées avant cette sigmoïde:
La perte est l’entropie croisée binaire, comme en régression logistique. Pour la classification multiclasse avec classes, la sigmoïde est remplacée par un softmax et la dernière couche produit sorties:
La perte est l’entropie croisée catégorielle.
Extracteur de caractéristiques et tête linéaire
Dans tous les cas, on peut écrire le réseau comme la composition de deux parties. Posons , la représentation apprise par les couches cachées. Les prédictions s’écrivent alors:
C’est exactement l’équation (7) du début du chapitre. La dernière couche est un modèle linéaire (chapitre 2) ou une régression logistique (chapitre 3) appliqué aux caractéristiques apprises . Les modèles des chapitres 2 et 3 sont le cas particulier (aucune couche cachée).
Limites du MLP
Le MLP traite son entrée comme un vecteur plat : chaque multiplication opère sur toutes les composantes de sans distinction. La matrice est pleine (dense), ce qui signifie que chaque composante de la sortie dépend de toutes les composantes de l’entrée. Il n’y a aucune notion de structure spatiale ou temporelle. Pour des données tabulaires (âge, revenu, nombre de pièces), c’est approprié: il n’y a pas d’ordre naturel entre les variables.
Mais pour une image de pixels, le MLP la transforme en un vecteur de 784 entrées. La matrice mélange toutes les positions spatiales: elle ne sait pas que le pixel est voisin du pixel mais éloigné du pixel . Pour une phrase de 10 mots, le MLP a besoin d’une entrée de taille fixe. Que fait-on avec une phrase de 20 mots?
Ces limitations motivent des architectures qui exploitent la structure des données. Les réseaux convolutifs remplacent la matrice dense par une opération de convolution qui respecte la structure spatiale des images. Les réseaux récurrents traitent les séquences élément par élément en maintenant un état interne. Le mécanisme d’attention et les transformeurs permettent à chaque position d’une séquence de consulter directement toutes les autres, sans contrainte de longueur fixe.
Résumé
Ce chapitre a montré comment les réseaux de neurones s’inscrivent dans la progression des modèles vus dans les chapitres précédents. Le point de départ est toujours le cadre de maximum de vraisemblance: un modèle prédit les paramètres d’une distribution conditionnelle. La nouveauté est que la transformation des entrées (la fonction ) est désormais apprise plutôt que fixée à l’avance. Le problème XOR a illustré pourquoi cette flexibilité est nécessaire: certaines fonctions simples sont inaccessibles aux modèles linéaires, et une couche cachée suffit à les résoudre en transformant l’espace des entrées.
La dérivation automatique calcule les gradients en décomposant un programme en opérations élémentaires et en appliquant la règle de la chaîne. Le mode arrière (VJP) produit le gradient par rapport à tous les paramètres en une seule passe, ce qui en fait la base de l’entraînement des réseaux. Les bibliothèques modernes (JAX, PyTorch) implémentent ce mécanisme automatiquement via le traçage d’opérations.
En pratique, un MLP se décompose en un extracteur de caractéristiques (les couches cachées) et une tête linéaire (la couche de sortie), ce qui généralise directement les modèles des chapitres 2 et 3. Cependant, le MLP traite ses entrées comme des vecteurs plats, sans exploiter la structure spatiale ou temporelle des données. Le chapitre suivant couvre les algorithmes d’optimisation, la stabilisation de l’entraînement et la régularisation. Les chapitres sur les réseaux récurrents, l’attention et les transformeurs présentent ensuite des architectures qui remédient aux limitations du MLP.
Exercices
Les exercices ★ vérifient la compréhension de base. Les exercices ★★ demandent d’appliquer les concepts à des calculs concrets. Les exercices ★★★ approfondissent le sujet et sont optionnels pour IFT3395.
Exercice 1: Composition linéaire ★
Montrez que la composition de deux transformations affines et est une transformation affine. Trouvez la matrice et le vecteur tels que .
Que conclure sur l’utilité d’un réseau à plusieurs couches sans fonctions d’activation?
Solution Exercice 1
En substituant:
Donc et . Un réseau à plusieurs couches linéaires sans activation n’est pas plus expressif qu’un modèle linéaire à une seule couche.
Exercice 2: Dérivée de la sigmoïde ★
Montrez que la dérivée de la fonction sigmoïde s’écrit .
Calculez la valeur maximale de et identifiez en quel point elle est atteinte.
Solution Exercice 2
En posant :
Le maximum de est atteint quand , soit . La valeur maximale est .
Ce maximum de 0,25 explique la dissolution du gradient: à chaque couche utilisant la sigmoïde, le gradient est multiplié par un facteur d’au plus 0,25.
Exercice 3: Rétropropagation manuelle ★★
Considérez un réseau à une couche cachée avec 2 neurones ReLU, une entrée scalaire , une cible , et la perte des moindres carrés.
Les paramètres sont: , , , .
Calculez la passe avant: pré-activations, activations, prédiction, perte.
Calculez la passe arrière: tous les gradients.
Effectuez une mise à jour des paramètres avec un taux d’apprentissage .
Solution Exercice 3
Exercice 4: Vérification numérique du gradient ★★
Implémentez un MLP à une couche cachée avec ReLU en NumPy. Calculez les gradients par rétropropagation, puis vérifiez-les par différences finies centrées (). L’erreur relative entre les deux devrait être inférieure à 10-5.
import numpy as np

def numerical_gradient(f, params, eps=1e-5):
    """Calcule le gradient par différences finies centrées."""
    grads = []
    for p in params:
        grad_p = np.zeros_like(p)
        it = np.nditer(p, flags=['multi_index'])
        while not it.finished:
            idx = it.multi_index
            old_val = p[idx]
            p[idx] = old_val + eps
            loss_plus = f()
            p[idx] = old_val - eps
            loss_minus = f()
            grad_p[idx] = (loss_plus - loss_minus) / (2 * eps)
            p[idx] = old_val
            it.iternext()
        grads.append(grad_p)
    return grads
Conseil: calculez l’erreur relative comme .
Solution Exercice 4
import numpy as np

def relu(x):
    return np.maximum(0, x)

# Paramètres
np.random.seed(42)
W1 = np.random.randn(4, 3) * 0.1
b1 = np.zeros(4)
W2 = np.random.randn(1, 4) * 0.1
b2 = np.zeros(1)
params = [W1, b1, W2, b2]

x = np.random.randn(3)
y = np.array([1.0])

# Passe avant et arrière
def forward_and_loss():
    a1 = W1 @ x + b1
    z1 = relu(a1)
    y_pred = W2 @ z1 + b2
    return 0.5 * np.sum((y_pred - y) ** 2)

def backprop():
    a1 = W1 @ x + b1
    z1 = relu(a1)
    y_pred = W2 @ z1 + b2

    dL_dy = y_pred - y
    dL_dW2 = np.outer(dL_dy, z1)
    dL_db2 = dL_dy
    dL_dz1 = W2.T @ dL_dy
    dL_da1 = dL_dz1 * (a1 > 0).astype(float)
    dL_dW1 = np.outer(dL_da1, x)
    dL_db1 = dL_da1

    return [dL_dW1, dL_db1, dL_dW2, dL_db2]

grads_bp = backprop()
grads_num = numerical_gradient(forward_and_loss, params)

for name, g_bp, g_num in zip(['W1', 'b1', 'W2', 'b2'], grads_bp, grads_num):
    err = np.linalg.norm(g_bp - g_num) / (np.linalg.norm(g_bp) + np.linalg.norm(g_num) + 1e-8)
    print(f"{name}: erreur relative = {err:.2e}")
Toutes les erreurs relatives devraient être inférieures à 10-5.
Exercice 5: Gradient de l’entropie croisée avec softmax ★★★ (optionnel IFT3395)
Cet exercice dérive un résultat très utilisé en pratique: le gradient de l’entropie croisée par rapport aux pré-activations de la couche softmax est une soustraction simple.
Soit le vecteur de pré-activations de la dernière couche, les probabilités prédites, et la vraie classe. La perte est .
Montrez que , où est le delta de Kronecker.
En utilisant la règle de la chaîne, montrez que:
Écrivez ce résultat sous forme vectorielle: , où est le vecteur unité avec 1 en position .
Pourquoi ce résultat est-il remarquable du point de vue de l’implémentation?
Solution Exercice 5
1. Jacobienne du softmax:
Par définition, . Notons .
Pour :
Pour :
Les deux cas se résument à .
2. Gradient de la perte:
La seule composante non nulle de est pour , où elle vaut .
3. Forme vectorielle: .
4. Remarque d’implémentation:
Le gradient par rapport aux pré-activations de la couche softmax se réduit à soustraire 1 à la probabilité prédite pour la vraie classe. On n’a pas besoin de calculer explicitement la jacobienne du softmax (qui serait coûteuse pour de grandes sorties). En pratique:
def softmax_cross_entropy_grad(logits, c):
    """Gradient de l'entropie croisée par rapport aux logits."""
    exp_a = np.exp(logits - logits.max())  # stabilité numérique
    p = exp_a / exp_a.sum()
    p[c] -= 1  # soustraction de e_c
    return p
Exercice 6: VJP de la couche affine ★★
Soit avec , , et un vecteur adjoint .
Écrivez la jacobienne par rapport à . Quelle est sa taille?
Calculez (la règle VJP par rapport à ). Montrez que le résultat est . Interprétez: la multiplication à gauche par (JVP) se transpose en multiplication à droite par (VJP).
Traitez maintenant comme variable. Soit avec fixé. Écrivez composante par composante: . En déduire , puis la règle VJP par rapport à .
Montrez que la règle VJP par rapport à est (produit externe), et par rapport à est .
Retrouvez ces formules dans les équations de rétropropagation de la section “Exemple: MLP avec une couche cachée”. Comment s’appellent-elles dans ce contexte?
Solution Exercice 6
1. Jacobienne par rapport à :
, donc .
La jacobienne est .
2. VJP par rapport à :
Le JVP multiplie à gauche (); le VJP multiplie à droite (). Le même opérateur, appliqué dans l’autre sens. Aucune matrice supplémentaire n’est formée: est déjà disponible depuis la passe avant.
3. Jacobienne par rapport à :
Vectorisons en (concaténation des colonnes). La jacobienne a pour blocs .
4. VJP par rapport à :
Sans vectoriser: le résultat du VJP doit avoir la même forme que , soit . On a:
Ce qui donne la matrice , un produit externe , exactement le coût minimal pour produire une matrice de cette taille.
Par rapport à : , donc .
5. Correspondance avec la rétropropagation:
Dans la section “Exemple: MLP avec une couche cachée”, avec :
Ce sont exactement les règles VJP dérivées ci-dessus, appliquées avec .
Exercice 7: VJP de l’activation élémentaire ★★
Soit définie par , où est une activation scalaire différentiable.
Calculez la jacobienne . Quelle est sa structure particulière? Quel coût en mémoire si ?
Calculez la règle VJP: . Montrez qu’elle se réduit à . Quel est le coût en mémoire?
Spécialisez à (sigmoïde). En utilisant la formule de l’exercice 2, écrivez la règle VJP uniquement en termes de et (sans recalculer la passe avant).
Pour , la dérivée n’est pas définie en . Comment les bibliothèques de DA gèrent-elles conventionnellement ce cas?
Solution Exercice 7
1. Jacobienne de l’activation élémentaire:
, donc:
C’est une matrice diagonale. Malgré cela, si on la stockait naïvement, le coût serait . Pour : 108 flottants 800 Mo, ce qui est prohibitif.
2. Règle VJP:
Coût: en temps et en mémoire. La matrice diagonale n’est jamais formée.
3. VJP de la sigmoïde avec réutilisation:
Puisque et est disponible depuis la passe avant:
Pas besoin de recalculer : la passe avant l’a déjà produit et stocké. C’est la raison pour laquelle les implémentations de rétropropagation cachent les activations intermédiaires.
4. ReLU en :
Par convention, la quasi-totalité des bibliothèques (JAX, PyTorch, TensorFlow) définissent . Cette convention est cohérente avec le sous-différentiel de la fonction convexe , et le point forme un ensemble de mesure nulle qui n’affecte pas l’entraînement en pratique.
Exercice 8: JVP de la couche affine ★★
Soit avec , et un vecteur tangent .
Calculez la règle JVP: . Quel est son coût?
Comparez: calculer le gradient complet via JVPs (un par composante ) versus un seul VJP. Combien d’opérations arithmétiques chaque approche nécessite-t-elle?
Supposez . Donnez les coûts numériques des deux approches pour calculer le gradient complet par rapport à tous les paramètres du réseau.
Dans quel cas le mode avant (JVP) est-il préférable au mode arrière (VJP)?
Solution Exercice 8
1. Règle JVP:
Coût: , un produit matrice-vecteur.
2. Comparaison JVP vs VJP pour le gradient complet:
JVPs: calculer reconstruit la jacobienne colonne par colonne. Coût total: .
1 VJP: calculer pour un seul . Coût: .
Pour une perte scalaire, le VJP en mode arrière est donc fois plus efficace que le JVP en mode avant.
3. Avec :
Mode avant ( JVPs): opérations
Mode arrière (1 VJP): 106 opérations
Le mode arrière est fois moins coûteux, et c’est par couche. Sur un réseau de 100 couches, l’avantage s’accumule.
4. Cas favorables au mode avant:
Le JVP (mode avant) est préférable quand le nombre de sorties est grand mais le nombre d’entrées est petit. En pratique:
Calcul de produits pour des directions spécifiques (e.g., directions de courbure en optimisation du second ordre)
Dérivation par rapport à un petit nombre de paramètres scalaires (e.g., hyperparamètres)
Sensibilités directionnelles en analyse d’incertitude
Lire un graphe de calcul
Les exercices suivants portent sur les graphes de calcul (DAGs) et la règle de la chaîne. Pour chaque fonction, on décompose le calcul en opérations élémentaires et on représente les dépendances par un DAG.
Exercice 9: du graphe à l’expression (chaîne linéaire) ★
Considérez le graphe de calcul suivant:
(a) Écrivez l’expression mathématique que ce graphe calcule.
(b) Évaluez .
(c) Cette fonction porte un nom courant en apprentissage profond. Lequel?
Solution exercice 9
(a) En remplaçant les variables intermédiaires:
Donc .
(b) .
(c) C’est la fonction softplus, une approximation lisse de ReLU.
Exercice 10: du graphe à l’expression (embranchement) ★
Considérez le graphe de calcul suivant:
(a) Écrivez l’expression mathématique .
(b) Combien d’arêtes sortantes a le noeud ? Qu’est-ce que cela signifie pour la règle de la chaîne?
(c) Évaluez .
Solution exercice 10
(a) .
(b) Le noeud a deux arêtes sortantes: il alimente et . Cela signifie que contribue à par deux chemins distincts, et la règle de la chaîne devra sommer les deux contributions.
(c) .
Exercice 11: du graphe à l’expression (trois entrées) ★
Considérez le graphe de calcul suivant:
(a) Écrivez l’expression mathématique .
(b) Évaluez .
(c) Quelles variables d’entrée ont un embranchement (fan-out) dans ce graphe?
Solution exercice 11
(a) .
(b) .
(c) Aucune variable d’entrée n’a d’embranchement: alimente uniquement , alimente uniquement , et alimente uniquement . Le graphe a deux branches indépendantes qui se rejoignent à l’addition.
Décomposer une fonction en graphe de calcul
Exercice 12: de l’expression au graphe (embranchement simple) ★
Soit .
(a) Identifiez les variables intermédiaires en décomposant en opérations élémentaires.
(b) Dessinez le DAG correspondant. Combien d’arêtes sortantes a le noeud ?
(c) Évaluez .
Solution exercice 12
(a) Deux opérations élémentaires:
(b) Le DAG est:
Le noeud a deux arêtes sortantes: une vers et une vers la multiplication. C’est un embranchement.
(c) .
Exercice 13: de l’expression au graphe (diamant) ★
Soit .
(a) Décomposez en opérations élémentaires et identifiez les variables intermédiaires.
(b) Dessinez le DAG. Quel noeud intermédiaire a un embranchement?
(c) Évaluez .
Solution exercice 13
(a) Quatre opérations élémentaires:
(b) Le DAG est:
Le noeud a un embranchement: il alimente à la fois et . La passe arrière devra accumuler les contributions des deux branches pour obtenir .
(c) .
Exercice 14: de l’expression au graphe (triple embranchement) ★★
Soit .
(a) Décomposez en opérations élémentaires.
(b) Dessinez le DAG. Combien d’arêtes sortantes a le noeud ?
(c) Évaluez .
Solution exercice 14
(a) Quatre opérations élémentaires:
(b) Le DAG est:
Le noeud a trois arêtes sortantes: vers , vers la multiplication, et vers le carré. La règle de la chaîne devra sommer trois contributions pour obtenir .
(c) .
Règle de la chaîne dans un DAG
Les exercices suivants partent de la règle de la chaîne sous forme de jacobiennes, puis montrent comment la réécrire comme une composition de fonctions VJP.
Exercice 15: des jacobiennes aux VJPs (chaîne linéaire) ★★
Considérez le graphe de calcul suivant, où chaque noeud est une fonction scalaire:
(a) Écrivez la jacobienne (ici, la dérivée) de chaque opération élémentaire: et .
(b) En appliquant la règle de la chaîne, écrivez comme un produit de jacobiennes.
(c) Pour calculer le gradient, on peut multiplier de droite à gauche. Définissons la fonction , c’est-à-dire le produit de l’adjoint entrant par la jacobienne locale de évaluée en . En partant de , écrivez le calcul du gradient comme une composition d’appels à :
Complétez les arguments.
(d) Développez chaque appel en utilisant les jacobiennes de (a). Vérifiez que vous retrouvez le résultat de (b).
(e) Évaluez numériquement en .
(f) Vérifiez vos résultats en JAX. Complétez le code ci-dessous qui compare trois méthodes: le produit des jacobiennes, la composition manuelle des VJPs avec jax.vjp, et jax.grad.
import jax
import jax.numpy as jnp

x = jnp.array(0.0)

# Méthode 1: produit des jacobiennes
v1 = jnp.sin(x)
J_sin = ???   # jacobienne de sin évaluée en x
J_exp = ???   # jacobienne de exp évaluée en v1
grad_jacobians = ???  # produit J_exp * J_sin

# Méthode 2: composition manuelle des VJPs
v1, vjp_sin = jax.vjp(jnp.sin, x)
v2, vjp_exp = jax.vjp(jnp.exp, v1)
(v1_bar,) = vjp_exp(jnp.array(1.0))  # ū = 1
(x_bar,)  = vjp_sin(v1_bar)

# Méthode 3: jax.grad
grad_auto = jax.grad(lambda x: jnp.exp(jnp.sin(x)))(x)

print(f'Jacobiennes:  {grad_jacobians}')
print(f'VJPs manuels: {x_bar}')
print(f'jax.grad:     {grad_auto}')
Solution exercice 15
La fonction est .
(a) Jacobiennes locales (dérivées scalaires):
(b) Par la règle de la chaîne:
(c) La passe arrière compose les VJPs de droite à gauche, en partant de la sortie:
(d) Développons:
On retrouve bien .
(e) En :
Passe avant: , , .
Passe arrière: , puis .
Donc .
(f) Code JAX complété:
import jax
import jax.numpy as jnp

x = jnp.array(0.0)

# Méthode 1: produit des jacobiennes
v1 = jnp.sin(x)
J_sin = jnp.cos(x)       # cos(0) = 1
J_exp = jnp.exp(v1)      # exp(0) = 1
grad_jacobians = J_exp * J_sin  # 1.0

# Méthode 2: composition manuelle des VJPs
v1, vjp_sin = jax.vjp(jnp.sin, x)
v2, vjp_exp = jax.vjp(jnp.exp, v1)
(v1_bar,) = vjp_exp(jnp.array(1.0))
(x_bar,)  = vjp_sin(v1_bar)

# Méthode 3: jax.grad
grad_auto = jax.grad(lambda x: jnp.exp(jnp.sin(x)))(x)

print(f'Jacobiennes:  {grad_jacobians}')  # 1.0
print(f'VJPs manuels: {x_bar}')           # 1.0
print(f'jax.grad:     {grad_auto}')       # 1.0
Les trois méthodes donnent 1,0. La composition manuelle des VJPs avec jax.vjp fait exactement ce que jax.grad fait en interne: elle parcourt la bande à rebours en appelant chaque VJP locale.
Exercice 16: jacobiennes et accumulation (embranchement) ★★
Reprenons le graphe de de l’exercice 7:
(a) Écrivez la jacobienne de chaque opération élémentaire: , , , .
(b) Le noeud a deux successeurs ( et ). En utilisant la règle de la chaîne multivariée, écrivez comme une somme de deux termes (un par chemin).
(c) Écrivez la passe arrière comme une suite d’appels à . Le noeud reçoit deux contributions: montrez comment elles s’accumulent.
Continuez jusqu’à et .
(d) Évaluez numériquement en . Vérifiez par dérivation directe.
(e) Vérifiez en JAX. Complétez le code ci-dessous. La partie importante est l’accumulation sur : le noeud reçoit les contributions de deux VJPs distincts qu’il faut additionner.
import jax
import jax.numpy as jnp

x, y = jnp.array(1.0), jnp.array(0.0)

# Passe avant: enregistrer les VJPs
v1, vjp_sub = jax.vjp(lambda x, y: x - y, x, y)
v2, vjp_exp = jax.vjp(jnp.exp, v1)
v3, vjp_sq  = jax.vjp(lambda v: v**2, v1)
v4, vjp_add = jax.vjp(lambda a, b: a + b, v2, v3)

# Passe arrière: composer les VJPs
v4_bar = jnp.array(1.0)
(v2_bar, v3_bar) = vjp_add(v4_bar)
(v1_bar_exp,) = vjp_exp(v2_bar)
(v1_bar_sq,)  = vjp_sq(v3_bar)
v1_bar = ???                          # accumulation
(x_bar, y_bar) = vjp_sub(v1_bar)

# Comparaison avec jax.grad
f = lambda x, y: jnp.exp(x - y) + (x - y)**2
print(f'VJPs manuels: dx={x_bar}, dy={y_bar}')
print(f'jax.grad:     dx={jax.grad(f, 0)(x, y)}, '
      f'dy={jax.grad(f, 1)(x, y)}')
Solution exercice 16
(a) Jacobiennes locales:
(b) Le noeud contribue à par deux chemins (via et via le carré). La règle de la chaîne multivariée donne:
(c) Passe arrière complète:
Initialiser .
. Comme , on obtient , .
Accumulation sur :
. Comme :
(d) En :
Passe avant: , , , .
Passe arrière: , , , .
Vérification directe: . Correct. On note que , ce qui est attendu puisque dépend de et uniquement à travers .
(e) Code JAX complété:
import jax
import jax.numpy as jnp

x, y = jnp.array(1.0), jnp.array(0.0)

# Passe avant: enregistrer les VJPs
v1, vjp_sub = jax.vjp(lambda x, y: x - y, x, y)
v2, vjp_exp = jax.vjp(jnp.exp, v1)
v3, vjp_sq  = jax.vjp(lambda v: v**2, v1)
v4, vjp_add = jax.vjp(lambda a, b: a + b, v2, v3)

# Passe arrière: composer les VJPs
v4_bar = jnp.array(1.0)
(v2_bar, v3_bar) = vjp_add(v4_bar)
(v1_bar_exp,) = vjp_exp(v2_bar)
(v1_bar_sq,)  = vjp_sq(v3_bar)
v1_bar = v1_bar_exp + v1_bar_sq       # accumulation!
(x_bar, y_bar) = vjp_sub(v1_bar)

# Comparaison avec jax.grad
f = lambda x, y: jnp.exp(x - y) + (x - y)**2
print(f'VJPs manuels: dx={x_bar}, dy={y_bar}')
# dx=4.718..., dy=-4.718...
print(f'jax.grad:     dx={jax.grad(f, 0)(x, y)}, '
      f'dy={jax.grad(f, 1)(x, y)}')
# dx=4.718..., dy=-4.718...
La ligne v1_bar = v1_bar_exp + v1_bar_sq est l’accumulation: le noeud reçoit un adjoint de chaque branche. C’est exactement ce que fait le système de DA en interne quand une variable a un fan-out.
Exercice 17: ReLU et gradient nul ★★★
Considérez le graphe de calcul suivant, qui correspond à :
On rappelle que et que .
(a) Écrivez la jacobienne de chaque opération élémentaire. Quelles variables d’entrée ont un embranchement?
(b) Écrivez la passe arrière comme une suite d’appels à , en montrant comment et accumulent chacun deux contributions (une par branche).
(c) Évaluez en (ReLU actif). Vérifiez en simplifiant quand .
(d) Évaluez en (ReLU inactif). Que se passe-t-il pour les gradients?
(e) Vérifiez en JAX pour les deux cas. Complétez le code ci-dessous. Notez que et alimentent chacun deux opérations: il faut accumuler les contributions des deux branches.
import jax
import jax.numpy as jnp

def backward_manual(x, y):
    # Passe avant
    v1, vjp_add = jax.vjp(lambda x, y: x + y, x, y)
    v2, vjp_relu = jax.vjp(jax.nn.relu, v1)
    v3, vjp_sub = jax.vjp(lambda x, y: x - y, x, y)
    v4, vjp_mul = jax.vjp(lambda a, b: a * b, v2, v3)

    # Passe arrière
    (v2_bar, v3_bar) = vjp_mul(jnp.array(1.0))
    (v1_bar,) = vjp_relu(v2_bar)
    (x_bar_add, y_bar_add) = vjp_add(v1_bar)
    (x_bar_sub, y_bar_sub) = vjp_sub(v3_bar)
    x_bar = ???  # accumulation des deux branches
    y_bar = ???
    return x_bar, y_bar

# Cas 1: ReLU actif
print('ReLU actif (3, 1):', backward_manual(
    jnp.array(3.0), jnp.array(1.0)))
# Cas 2: ReLU inactif
print('ReLU inactif (-3, 1):', backward_manual(
    jnp.array(-3.0), jnp.array(1.0)))

# Comparaison avec jax.grad
f = lambda x, y: jax.nn.relu(x + y) * (x - y)
print('jax.grad (3, 1):',
      jax.grad(f, 0)(jnp.array(3.0), jnp.array(1.0)),
      jax.grad(f, 1)(jnp.array(3.0), jnp.array(1.0)))
print('jax.grad (-3, 1):',
      jax.grad(f, 0)(jnp.array(-3.0), jnp.array(1.0)),
      jax.grad(f, 1)(jnp.array(-3.0), jnp.array(1.0)))
Solution exercice 17
(a) Jacobiennes locales:
Les deux variables et ont un embranchement: chacune alimente (addition) et (soustraction).
(b) Passe arrière:
Initialiser .
Accumulation sur et (deux contributions chacun):
(c) En (ReLU actif):
Passe avant: , , , .
Passe arrière: . , . .
Vérification: quand , , donc et . Correct.
(d) En (ReLU inactif):
Passe avant: , , , .
Passe arrière: . , . .
Les deux gradients sont nuls. Le ReLU inactif bloque le gradient à travers la branche gauche (), et la multiplication par bloque le gradient à travers la branche droite (). Quand la sortie du ReLU est nulle, aucun gradient ne peut remonter, quelle que soit la branche.
(e) Code JAX complété:
import jax
import jax.numpy as jnp

def backward_manual(x, y):
    v1, vjp_add = jax.vjp(lambda x, y: x + y, x, y)
    v2, vjp_relu = jax.vjp(jax.nn.relu, v1)
    v3, vjp_sub = jax.vjp(lambda x, y: x - y, x, y)
    v4, vjp_mul = jax.vjp(lambda a, b: a * b, v2, v3)

    (v2_bar, v3_bar) = vjp_mul(jnp.array(1.0))
    (v1_bar,) = vjp_relu(v2_bar)
    (x_bar_add, y_bar_add) = vjp_add(v1_bar)
    (x_bar_sub, y_bar_sub) = vjp_sub(v3_bar)
    x_bar = x_bar_add + x_bar_sub  # accumulation
    y_bar = y_bar_add + y_bar_sub
    return x_bar, y_bar

# ReLU actif:  (6.0, -2.0)
print(backward_manual(jnp.array(3.0), jnp.array(1.0)))
# ReLU inactif: (0.0, 0.0)
print(backward_manual(jnp.array(-3.0), jnp.array(1.0)))
Les résultats confirment les calculs manuels. Le cas illustre le phénomène du neurone mort: les deux gradients sont exactement zéro, ce que jax.grad confirme aussi.
- Rosenblatt, F. (1958). The perceptron: a probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386–408.
- McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5(4), 115–133.
- Novikoff, A. B. J. (1962). On convergence proofs for perceptrons [Techreport]. Stanford Research Institute.
- Minsky, M., & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press.
- Hornik, K., Stinchcombe, M., & White, H. (1989). Multilayer Feedforward Networks are Universal Approximators. Neural Networks, 2(5), 359–366. 10.1016/0893-6080(89)90020-8
- Linnainmaa, S. (1970). The Representation of the Cumulative Rounding Error of an Algorithm as a Taylor Expansion of the Local Rounding Errors [Mathesis]. University of Helsinki.
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning Representations by Back-propagating Errors. Nature, 323(6088), 533–536.
- Wengert, R. E. (1964). A Simple Automatic Derivative Evaluation Program. Communications of the ACM, 7(8), 463–464.
- Maclaurin, D., Duvenaud, D., & Adams, R. P. (2015). Autograd: Effortless Gradients in NumPy. ICML Workshop on Automatic Machine Learning.