IFT3395/IFT6390 - Fondements de l’apprentissage machine
Ce notebook accompagne le Chapitre 6: Modèles probabilistes génératifs.
Objectifs
À la fin de ce TP, vous serez en mesure de:
Estimer les paramètres (a priori, moyennes, covariances) d’un modèle GDA par maximum de vraisemblance
Implémenter la fonction discriminante pour LDA (covariance partagée)
Implémenter la fonction discriminante pour QDA (covariances par classe)
Visualiser les frontières de décision et les ellipsoïdes de densité
Comparer LDA et QDA selon la structure des données
Relier GDA à la régression logistique (frontières linéaires)
Ce TP implémente GDA et LDA à la main. Scikit-learn n’est utilisé que pour une comparaison finale.
Partie 0: Configuration
Exécutez cette cellule pour importer les bibliothèques nécessaires.
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse

plt.rcParams['figure.figsize'] = (8, 5)
plt.rcParams['font.size'] = 12

print("Configuration terminée!")
Configuration terminée!
Partie 1: Données synthétiques 2D
L’analyse discriminante suppose que les données de chaque classe suivent une distribution gaussienne. Nous générons deux jeux de données:
Données adaptées à LDA: les deux classes ont la même covariance (formes similaires)
Données adaptées à QDA: chaque classe a sa propre covariance (formes elliptiques différentes)
Travailer en 2D permet de visualiser les frontières de décision et les ellipsoïdes.
np.random.seed(42)
n_per_class = 80

# Jeu 1: covariances identiques (LDA adapté)
mu0_lda = np.array([0, 0])
mu1_lda = np.array([3, 2])
Sigma_shared = np.array([[1.5, 0.4], [0.4, 1.0]])  # même covariance pour les deux classes

X0_lda = np.random.multivariate_normal(mu0_lda, Sigma_shared, n_per_class)
X1_lda = np.random.multivariate_normal(mu1_lda, Sigma_shared, n_per_class)
X_lda = np.vstack([X0_lda, X1_lda])
y_lda = np.array([0] * n_per_class + [1] * n_per_class)

# Jeu 2: covariances différentes (QDA adapté)
mu0_qda = np.array([0, 0])
mu1_qda = np.array([4, 2])
Sigma0_qda = np.array([[2.0, 0.6], [0.6, 0.5]])   # ellipse horizontale
Sigma1_qda = np.array([[0.4, -0.2], [-0.2, 1.8]])  # ellipse verticale, autre orientation

X0_qda = np.random.multivariate_normal(mu0_qda, Sigma0_qda, n_per_class)
X1_qda = np.random.multivariate_normal(mu1_qda, Sigma1_qda, n_per_class)
X_qda = np.vstack([X0_qda, X1_qda])
y_qda = np.array([0] * n_per_class + [1] * n_per_class)

print("Jeu LDA (covariances identiques):", X_lda.shape)
print("Jeu QDA (covariances différentes):", X_qda.shape)
Jeu LDA (covariances identiques): (160, 2)
Jeu QDA (covariances différentes): (160, 2)
fig, axes = plt.subplots(1, 2, figsize=(12, 5))

ax = axes[0]
ax.scatter(X0_lda[:, 0], X0_lda[:, 1], c='steelblue', alpha=0.6, s=25, label='Classe 0')
ax.scatter(X1_lda[:, 0], X1_lda[:, 1], c='coral', alpha=0.6, s=25, label='Classe 1')
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Données adaptées à LDA (même covariance)')
ax.legend()
ax.set_aspect('equal')
ax.grid(True, alpha=0.3)

ax = axes[1]
ax.scatter(X0_qda[:, 0], X0_qda[:, 1], c='steelblue', alpha=0.6, s=25, label='Classe 0')
ax.scatter(X1_qda[:, 0], X1_qda[:, 1], c='coral', alpha=0.6, s=25, label='Classe 1')
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Données adaptées à QDA (covariances différentes)')
ax.legend()
ax.set_aspect('equal')
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()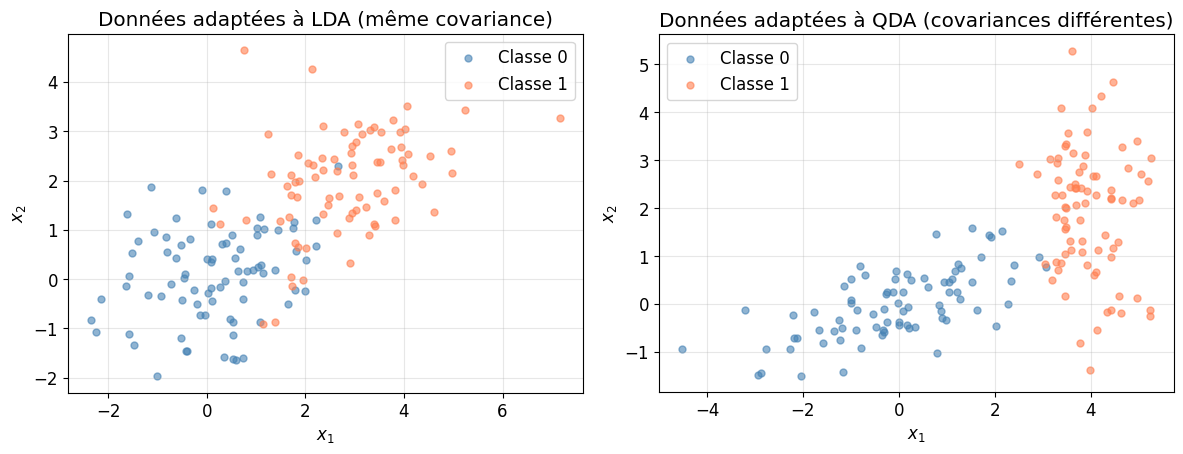
Partie 2: Estimation des paramètres GDA
L’analyse discriminante gaussienne (GDA) suppose . L’estimateur du maximum de vraisemblance donne des formules fermées:
QDA (covariances par classe):
LDA (covariance partagée):
Exercice 1: Estimer les paramètres GDA ★
Complétez les fonctions pour estimer les a priori , les moyennes et les covariances.
def fit_gda_params(X, y):
    """
    Estime les paramètres GDA (QDA: covariances par classe).

    Args:
        X: données (N, D)
        y: étiquettes (N,), valeurs dans {0, 1, ...}

    Returns:
        pi: probabilités a priori (C,)
        means: liste de C vecteurs moyenne
        covariances: liste de C matrices de covariance (D×D)
    """
    classes = np.unique(y)
    N, D = X.shape

    # ============================================
    # TODO: Estimez pi_c = N_c / N pour chaque classe
    # ============================================
    pi = None  # (C,)

    # ============================================
    # TODO: Estimez mu_c = moyenne des x pour chaque classe
    # ============================================
    means = []  # liste de vecteurs (D,)

    # ============================================
    # TODO: Estimez Sigma_c pour chaque classe (QDA)
    # Sigma_c = (1/N_c) * sum over n in class c of (x_n - mu_c)(x_n - mu_c)^T
    # Ajoutez 1e-6 * np.eye(D) pour la stabilité numérique
    # ============================================
    covariances = []  # liste de matrices (D, D)

    return pi, means, covariances
def fit_lda_params(X, y):
"""
Estime les paramètres LDA (covariance partagée).
Returns:
pi, means: comme fit_gda_params
Sigma: matrice de covariance partagée (D×D)
"""
pi, means, covariances = fit_gda_params(X, y)
N, D = X.shape
classes = np.unique(y)
# ============================================
# TODO: Calculez la covariance partagée
# Sigma = (1/N) * sum over c,n of (x_n - mu_c)(x_n - mu_c)^T
# Indice: parcourez les classes et utilisez les moyens déjà calculés
# ============================================
Sigma = None # (D, D)
return pi, means, Sigma# Test sur le jeu LDA
pi_lda, means_lda, covs_lda = fit_gda_params(X_lda, y_lda)
pi_lda_fit, means_lda_fit, Sigma_lda = fit_lda_params(X_lda, y_lda)
if pi_lda is not None and means_lda:
print("Paramètres QDA (jeu LDA):")
for c in range(2):
print(f" Classe {c}: pi={pi_lda[c]:.3f}, mu=[{means_lda[c][0]:.2f}, {means_lda[c][1]:.2f}]")
print(f"\nParamètres LDA - covariance partagée:")
print(Sigma_lda)
if np.isclose(pi_lda.sum(), 1.0):
print("\nCorrect! Les pi somment à 1.")
else:
print("Complétez les fonctions fit_gda_params et fit_lda_params!")Complétez les fonctions fit_gda_params et fit_lda_params!
Solution Exercice 1 (cliquez pour afficher)
def fit_gda_params(X, y):
    classes = np.unique(y)
    N, D = X.shape

    pi = np.array([np.mean(y == c) for c in classes])
    means = []
    covariances = []

    for c in classes:
        X_c = X[y == c]
        mu_c = X_c.mean(axis=0)
        means.append(mu_c)
        diff = X_c - mu_c
        Sigma_c = (diff.T @ diff) / len(X_c) + 1e-6 * np.eye(D)
        covariances.append(Sigma_c)

    return pi, means, covariances

def fit_lda_params(X, y):
    pi, means, covariances = fit_gda_params(X, y)
    N, D = X.shape
    classes = np.unique(y)

    Sigma = np.zeros((D, D))
    for c in classes:
        X_c = X[y == c]
        diff = X_c - means[c]
        Sigma += diff.T @ diff
    Sigma = Sigma / N + 1e-6 * np.eye(D)

    return pi, means, Sigma
Partie 3: Fonction discriminante et prédiction LDA
Pour LDA (covariance partagée ), la fonction discriminante est linéaire en :
Nous classifions en choisissant la classe avec le score le plus élevé: .
Exercice 2: Implémenter la prédiction LDA ★★
Complétez la fonction qui calcule les scores discriminants et prédit la classe.
def lda_discriminant_scores(X, pi, means, Sigma):
    """
    Calcule les scores discriminants LDA pour chaque point et chaque classe.

    Args:
        X: données (N, D)
        pi: a priori (C,)
        means: liste de C vecteurs (D,)
        Sigma: covariance partagée (D, D)

    Returns:
        scores: matrice (N, C) des scores delta_c(x_n)
    """
    N, D = X.shape
    C = len(pi)
    Sigma_inv = np.linalg.inv(Sigma)

    # ============================================
    # TODO: Pour chaque classe c, calculez delta_c(x) pour tous les points
    # delta_c(x) = log(pi_c) - 0.5 * mu_c^T Sigma^{-1} mu_c + x^T Sigma^{-1} mu_c
    # Utilisez une boucle sur les classes ou des opérations matricielles
    # ============================================
    scores = np.zeros((N, C))
    for c in range(C):
        # Terme constant: log(pi_c) - 0.5 * mu_c^T Sigma^{-1} mu_c
        # Terme linéaire: x^T Sigma^{-1} mu_c = (X @ Sigma_inv @ means[c])
        pass  # <- Complétez

    return scores


def predict_lda(X, pi, means, Sigma):
    """Prédit les classes avec LDA."""
    scores = lda_discriminant_scores(X, pi, means, Sigma)
    return np.argmax(scores, axis=1)
# Test LDA sur le jeu adapté
if Sigma_lda is not None:
y_pred_lda = predict_lda(X_lda, pi_lda_fit, means_lda_fit, Sigma_lda)
accuracy = np.mean(y_pred_lda == y_lda)
print(f"Précision LDA (jeu covariances identiques): {accuracy:.1%}")
else:
print("Complétez d'abord fit_lda_params!")Complétez d'abord fit_lda_params!
Solution Exercice 2 (cliquez pour afficher)
def lda_discriminant_scores(X, pi, means, Sigma):
    N, D = X.shape
    C = len(pi)
    Sigma_inv = np.linalg.inv(Sigma)
    scores = np.zeros((N, C))

    for c in range(C):
        mu_c = means[c]
        const = np.log(pi[c]) - 0.5 * mu_c @ Sigma_inv @ mu_c
        linear = X @ Sigma_inv @ mu_c
        scores[:, c] = const + linear

    return scores
Partie 4: Analyse discriminante quadratique (QDA)
Pour QDA, chaque classe a sa propre covariance . La fonction discriminante devient:
Le terme quadratique en produit des frontières de décision courbes (ellipses, hyperboles).
Exercice 3: Implémenter la prédiction QDA ★★
Complétez la fonction des scores discriminants QDA. Le terme est la distance de Mahalanobis au carré.
def qda_discriminant_scores(X, pi, means, covariances):
    """
    Calcule les scores discriminants QDA.

    Args:
        X: données (N, D)
        pi, means, covariances: sortie de fit_gda_params

    Returns:
        scores: matrice (N, C)
    """
    N, D = X.shape
    C = len(pi)
    scores = np.zeros((N, C))

    for c in range(C):
        mu_c = means[c]
        Sigma_c = covariances[c]
        Sigma_inv = np.linalg.inv(Sigma_c)

        # ============================================
        # TODO: delta_c(x) = log(pi_c) - 0.5*log(det(Sigma_c))
        #                   - 0.5 * (x - mu_c)^T Sigma_c^{-1} (x - mu_c)
        # Pour la distance de Mahalanobis au carré:
        # diff = X - mu_c  (N, D)
        # mahal_sq = np.sum(diff @ Sigma_inv * diff, axis=1)  (N,)
        # ============================================
        pass  # <- Complétez

    return scores


def predict_qda(X, pi, means, covariances):
    """Prédit les classes avec QDA."""
    scores = qda_discriminant_scores(X, pi, means, covariances)
    return np.argmax(scores, axis=1)
# Test QDA sur le jeu adapté
pi_qda, means_qda, covs_qda = fit_gda_params(X_qda, y_qda)
if covs_qda:
y_pred_qda = predict_qda(X_qda, pi_qda, means_qda, covs_qda)
accuracy_qda = np.mean(y_pred_qda == y_qda)
accuracy_lda_on_qda = np.mean(predict_lda(X_qda, *fit_lda_params(X_qda, y_qda)) == y_qda)
print(f"Précision QDA (jeu covariances différentes): {accuracy_qda:.1%}")
print(f"Précision LDA sur ces données: {accuracy_lda_on_qda:.1%}")
else:
print("Complétez fit_gda_params et predict_qda!")Complétez fit_gda_params et predict_qda!
Solution Exercice 3 (cliquez pour afficher)
def qda_discriminant_scores(X, pi, means, covariances):
    N, D = X.shape
    C = len(pi)
    scores = np.zeros((N, C))

    for c in range(C):
        mu_c = means[c]
        Sigma_c = covariances[c]
        Sigma_inv = np.linalg.inv(Sigma_c)
        diff = X - mu_c
        mahal_sq = np.sum(diff @ Sigma_inv * diff, axis=1)
        log_det = np.linalg.slogdet(Sigma_c)[1]
        scores[:, c] = np.log(pi[c]) - 0.5 * log_det - 0.5 * mahal_sq

    return scores
Partie 5: Visualisation des frontières de décision
Visualisons les frontières de décision de LDA et QDA sur les deux jeux de données. Pour QDA, nous pouvons aussi tracer les ellipsoïdes de niveau (iso-densité) de chaque classe.
Exercice 4: Visualiser LDA et QDA ★★
Exécutez la cellule ci-dessous. Une fonction pour tracer les frontières de décision est fournie; assurez-vous d’avoir implémenté predict_lda et predict_qda.
def plot_decision_boundary(ax, X, y, predict_fn, predict_args, title, cmap_alpha=0.3):
    """Trace la frontière de décision sur une grille 2D."""
    x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
    y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
    xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
    grid = np.c_[xx.ravel(), yy.ravel()]

    Z = predict_fn(grid, *predict_args)
    Z = Z.reshape(xx.shape)

    ax.contourf(xx, yy, Z, alpha=cmap_alpha, cmap='coolwarm')
    ax.contour(xx, yy, Z, colors='black', linewidths=1, levels=[0.5])
    ax.scatter(X[y == 0, 0], X[y == 0, 1], c='steelblue', alpha=0.7, s=25, label='Classe 0')
    ax.scatter(X[y == 1, 0], X[y == 1, 1], c='coral', alpha=0.7, s=25, label='Classe 1')
    ax.set_xlabel('$x_1$')
    ax.set_ylabel('$x_2$')
    ax.set_title(title)
    ax.legend()
    ax.set_aspect('equal')
    ax.grid(True, alpha=0.3)


def add_ellipsoid(ax, mu, Sigma, n_std=2, color='gray'):
    """Trace une ellipse de niveau (iso-densité) pour une gaussienne 2D."""
    vals, vecs = np.linalg.eigh(Sigma)
    angle = np.degrees(np.arctan2(vecs[1, 0], vecs[0, 0]))
    w, h = 2 * n_std * np.sqrt(np.maximum(vals, 1e-8))
    ell = Ellipse(mu, w, h, angle=angle, fill=False, color=color, linewidth=2, linestyle='--')
    ax.add_patch(ell)
fig, axes = plt.subplots(2, 2, figsize=(12, 10))
# Ligne 1: jeu adapté à LDA
pi_l, means_l, Sigma_l = fit_lda_params(X_lda, y_lda)
plot_decision_boundary(axes[0, 0], X_lda, y_lda, predict_lda,
(pi_l, means_l, Sigma_l), 'LDA (données cov. identiques)')
pi_q, means_q, covs_q = fit_gda_params(X_lda, y_lda)
plot_decision_boundary(axes[0, 1], X_lda, y_lda, predict_qda,
(pi_q, means_q, covs_q), 'QDA (données cov. identiques)')
# Ligne 2: jeu adapté à QDA
plot_decision_boundary(axes[1, 0], X_qda, y_qda, predict_lda,
fit_lda_params(X_qda, y_qda), 'LDA (données cov. différentes)')
plot_decision_boundary(axes[1, 1], X_qda, y_qda, predict_qda,
fit_gda_params(X_qda, y_qda), 'QDA (données cov. différentes)')
for ax in axes[1, :]:
m0, m1 = means_qda[0], means_qda[1]
add_ellipsoid(ax, m0, covs_qda[0], n_std=2, color='steelblue')
add_ellipsoid(ax, m1, covs_qda[1], n_std=2, color='coral')
plt.tight_layout()
plt.show()---------------------------------------------------------------------------
TypeError Traceback (most recent call last)
Cell In[12], line 5
3 # Ligne 1: jeu adapté à LDA
4 pi_l, means_l, Sigma_l = fit_lda_params(X_lda, y_lda)
----> 5 plot_decision_boundary(axes[0, 0], X_lda, y_lda, predict_lda,
6 (pi_l, means_l, Sigma_l), 'LDA (données cov. identiques)')
8 pi_q, means_q, covs_q = fit_gda_params(X_lda, y_lda)
9 plot_decision_boundary(axes[0, 1], X_lda, y_lda, predict_qda,
10 (pi_q, means_q, covs_q), 'QDA (données cov. identiques)')
Cell In[11], line 8, in plot_decision_boundary(ax, X, y, predict_fn, predict_args, title, cmap_alpha)
5 xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
6 grid = np.c_[xx.ravel(), yy.ravel()]
----> 8 Z = predict_fn(grid, *predict_args)
9 Z = Z.reshape(xx.shape)
11 ax.contourf(xx, yy, Z, alpha=cmap_alpha, cmap='coolwarm')
Cell In[7], line 34, in predict_lda(X, pi, means, Sigma)
32 def predict_lda(X, pi, means, Sigma):
33 """Prédit les classes avec LDA."""
---> 34 scores = lda_discriminant_scores(X, pi, means, Sigma)
35 return np.argmax(scores, axis=1)
Cell In[7], line 15, in lda_discriminant_scores(X, pi, means, Sigma)
2 """
3 Calcule les scores discriminants LDA pour chaque point et chaque classe.
4
(...) 12 scores: matrice (N, C) des scores delta_c(x_n)
13 """
14 N, D = X.shape
---> 15 C = len(pi)
16 Sigma_inv = np.linalg.inv(Sigma)
18 # ============================================
19 # TODO: Pour chaque classe c, calculez delta_c(x) pour tous les points
20 # delta_c(x) = log(pi_c) - 0.5 * mu_c^T Sigma^{-1} mu_c + x^T Sigma^{-1} mu_c
21 # Utilisez une boucle sur les classes ou des opérations matricielles
22 # ============================================
TypeError: object of type 'NoneType' has no len()
Questions de réflexion:
Sur les données avec covariances identiques, LDA et QDA donnent des résultats similaires. Pourquoi?
Sur les données avec covariances différentes, QDA trace une frontière courbe. En quoi cela aide-t-il?
LDA impose une frontière linéaire même quand les ellipsoïdes ont des orientations différentes. Quel compromis fait-on?
Partie 6: Comparaison avec scikit-learn ★
Vérifions que notre implémentation coïncide avec celle de scikit-learn.
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis, QuadraticDiscriminantAnalysis

if 'predict_lda' in dir() and 'predict_qda' in dir():
    # LDA
    sklearn_lda = LinearDiscriminantAnalysis()
    sklearn_lda.fit(X_lda, y_lda)
    y_pred_sk_lda = sklearn_lda.predict(X_lda)
    y_pred_ours_lda = predict_lda(X_lda, pi_lda_fit, means_lda_fit, Sigma_lda)

    # QDA
    sklearn_qda = QuadraticDiscriminantAnalysis()
    sklearn_qda.fit(X_qda, y_qda)
    y_pred_sk_qda = sklearn_qda.predict(X_qda)
    y_pred_ours_qda = predict_qda(X_qda, pi_qda, means_qda, covs_qda)

    print("Comparaison LDA (jeu cov. identiques):")
    print(f"  Notre implémentation: {np.mean(y_pred_ours_lda == y_lda):.1%}")
    print(f"  Scikit-learn:         {np.mean(y_pred_sk_lda == y_lda):.1%}")
    print(f"  Accord des prédictions: {np.mean(y_pred_ours_lda == y_pred_sk_lda):.1%}")

    print("\nComparaison QDA (jeu cov. différentes):")
    print(f"  Notre implémentation: {np.mean(y_pred_ours_qda == y_qda):.1%}")
    print(f"  Scikit-learn:         {np.mean(y_pred_sk_qda == y_qda):.1%}")
    print(f"  Accord des prédictions: {np.mean(y_pred_ours_qda == y_pred_sk_qda):.1%}")
else:
    print("Complétez predict_lda et predict_qda!")
Partie 7: LDA et régression logistique ★★★
LDA et la régression logistique produisent tous deux des frontières de décision linéaires. La différence est dans la modélisation:
LDA est un modèle génératif: il modélise et , puis dérive par Bayes.
Régression logistique est un modèle discriminatif: il modélise directement .
Sous l’hypothèse gaussienne avec covariance partagée, LDA et régression logistique produisent des frontières de même forme (linéaires), mais les paramètres peuvent différer. En pratique, la régression logistique est souvent plus robuste quand les hypothèses gaussiennes ne tiennent pas.
from sklearn.linear_model import LogisticRegression

if 'predict_lda' in dir():
    fig, axes = plt.subplots(1, 2, figsize=(12, 5))

    for ax, (X, y, name) in [(axes[0], (X_lda, y_lda, 'Covariances identiques')),
                             (axes[1], (X_qda, y_qda, 'Covariances différentes'))]:
        pi, means, Sigma = fit_lda_params(X, y)
        lr = LogisticRegression(penalty=None, max_iter=1000)
        lr.fit(X, y)

        x_min, x_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
        y_min, y_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
        xx, yy = np.meshgrid(np.linspace(x_min, x_max, 200), np.linspace(y_min, y_max, 200))
        grid = np.c_[xx.ravel(), yy.ravel()]

        Z_lda = predict_lda(grid, pi, means, Sigma).reshape(xx.shape)
        Z_lr = lr.predict(grid).reshape(xx.shape)

        ax.contour(xx, yy, Z_lda, colors='blue', linewidths=2, levels=[0.5], linestyles='-')
        ax.contour(xx, yy, Z_lr, colors='red', linewidths=2, levels=[0.5], linestyles='--')
        ax.scatter(X[y == 0, 0], X[y == 0, 1], c='steelblue', alpha=0.6, s=25)
        ax.scatter(X[y == 1, 0], X[y == 1, 1], c='coral', alpha=0.6, s=25)
        ax.set_xlabel('$x_1$')
        ax.set_ylabel('$x_2$')
        ax.set_title(f'{name}: LDA (trait plein) vs Rég. log. (tirets)')
        ax.set_aspect('equal')
        ax.grid(True, alpha=0.3)

    plt.tight_layout()
    plt.show()

    print("Les frontières sont linéaires pour les deux. Sur des données gaussiennes")
    print("avec covariance partagée, LDA et régression logistique sont proches.")
else:
print("Complétez predict_lda!")Récapitulatif
Dans ce TP, vous avez implémenté l’analyse discriminante gaussienne:
Estimation des paramètres: , , (QDA) ou partagée (LDA) par maximum de vraisemblance
Fonction discriminante LDA (linéaire):
Fonction discriminante QDA (quadratique): inclut et la distance de Mahalanobis au carré
LDA vs QDA: LDA impose une frontière linéaire (moins de paramètres, plus robuste). QDA permet des frontières courbes quand les covariances diffèrent.
Lien avec la régression logistique: Les deux donnent des frontières linéaires; LDA est génératif (modélise ), la régression logistique est discriminative (modélise ).
Pour aller plus loin: Chapitre 6: Modèles probabilistes génératifs