IFT6390 - Fondements de l’apprentissage machine
Ce notebook accompagne le Chapitre 6: Modèles probabilistes génératifs.
Objectifs
À la fin de ce TP, vous serez en mesure de:
Estimer les paramètres d’un classifieur naïf bayésien par maximum de vraisemblance
Appliquer le lissage de Laplace pour éviter les probabilités nulles
Implémenter la prédiction en espace logarithmique pour la stabilité numérique
Calculer la densité gaussienne multivariée
Implémenter l’algorithme EM pour un modèle de mélange gaussien
Comparer le partitionnement souple (GMM) et dur (k-moyennes)
Ce TP implémente tout à la main, sans utiliser scikit-learn pour l’entraînement. Scikit-learn n’est utilisé que pour charger les données et pour une comparaison finale.
Partie 0: Configuration
Exécutez cette cellule pour importer les bibliothèques nécessaires.
import numpy as np
import matplotlib.pyplot as plt

# Pour de jolis graphiques
plt.rcParams['figure.figsize'] = (8, 5)
plt.rcParams['font.size'] = 12

print("Configuration terminée!")
Configuration terminée!
Partie 1: Données de classification de texte
Le classifieur naïf bayésien est particulièrement populaire pour la classification de texte. Nous utilisons un sous-ensemble du jeu de données 20 Newsgroups, qui contient des messages de forums de discussion regroupés par sujet.
Notre tâche: distinguer les messages portant sur la médecine de ceux portant sur l’électronique, à partir des mots qu’ils contiennent.
from sklearn.datasets import fetch_20newsgroups
from sklearn.feature_extraction.text import CountVectorizer

# Charger deux catégories
categories = ['sci.electronics', 'sci.med']
newsgroups = fetch_20newsgroups(subset='all', categories=categories,
                                shuffle=True, random_state=42)

# Noms des classes (en français)
noms_classes = ['Électronique', 'Médecine']

# Convertir les textes en matrice de comptage de mots
vectorizer = CountVectorizer(max_features=2000, stop_words='english')
X_counts = vectorizer.fit_transform(newsgroups.data).toarray()
y = newsgroups.target
vocabulaire = vectorizer.get_feature_names_out()

print(f"Nombre de documents: {len(y)}")
print(f"Classes: {newsgroups.target_names}")
print(f"Matrice de comptage: {X_counts.shape} ({X_counts.shape[0]} documents × {X_counts.shape[1]} mots)")
print(f"\nExemple — premiers 10 mots du vocabulaire: {list(vocabulaire[:10])}")
print(f"Comptages correspondants (document 0): {X_counts[0, :10]}")
Nombre de documents: 1974
Classes: ['sci.electronics', 'sci.med']
Matrice de comptage: (1974, 2000) (1974 documents × 2000 mots)
Exemple — premiers 10 mots du vocabulaire: ['00', '000', '02', '03', '04', '09', '10', '100', '1000', '11']
Comptages correspondants (document 0): [0 0 0 0 0 0 0 0 0 0]
# Séparation entraînement / test (80% / 20%)
np.random.seed(42)
n = len(y)
indices = np.random.permutation(n)
n_train = int(0.8 * n)

train_idx = indices[:n_train]
test_idx = indices[n_train:]

X_train, y_train = X_counts[train_idx], y[train_idx]
X_test, y_test = X_counts[test_idx], y[test_idx]

print(f"Entraînement: {len(X_train)} documents")
print(f"Test: {len(X_test)} documents")
print(f"\nRépartition (entraînement):")
for c in [0, 1]:
    print(f"  {noms_classes[c]}: {np.sum(y_train == c)} documents ({np.mean(y_train == c):.1%})")
Entraînement: 1579 documents
Test: 395 documents
Répartition (entraînement):
Électronique: 773 documents (49.0%)
Médecine: 806 documents (51.0%)
# Mots les plus fréquents par classe
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

for c, ax in enumerate(axes):
    mask = y_train == c
    word_counts = X_train[mask].sum(axis=0)
    top_indices = np.argsort(word_counts)[-15:]

    ax.barh(range(15), word_counts[top_indices], color=f'C{c}', alpha=0.7)
    ax.set_yticks(range(15))
    ax.set_yticklabels([vocabulaire[i] for i in top_indices])
    ax.set_xlabel("Nombre total d'occurrences")
    ax.set_title(f'{noms_classes[c]}')

plt.suptitle('Mots les plus fréquents par classe', fontsize=14)
plt.tight_layout()
plt.show()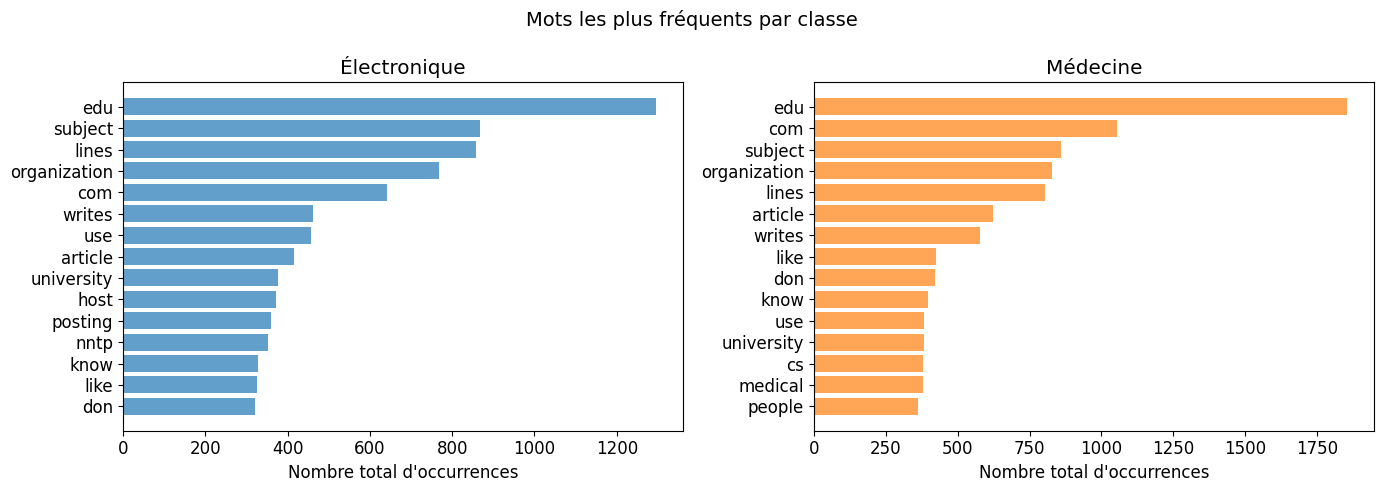
Partie 2: Le classifieur naïf bayésien
Le classifieur naïf bayésien suppose que les mots apparaissent indépendamment les uns des autres, conditionnellement à la classe. Pour la classification de texte avec des comptages de mots, nous utilisons le modèle multinomial:
où:
est la probabilité a priori de la classe
est la probabilité du mot dans la classe
est le nombre d’occurrences du mot dans le document
Exercice 1: Estimer les a priori de classe ★
La première étape est d’estimer les probabilités a priori . L’estimateur du maximum de vraisemblance est la fréquence de chaque classe:
Nous travaillons en espace logarithmique pour la stabilité numérique. Complétez la fonction ci-dessous.
def estimate_log_priors(y_train):
    """
    Estime les log-probabilités a priori de chaque classe.

    Args:
        y_train: étiquettes d'entraînement (N,)

    Returns:
        log_priors: array de taille (C,) contenant log(pi_c) pour chaque classe
    """
    classes = np.unique(y_train)
    N = len(y_train)

    # ============================================
    # TODO: Calculez les log-probabilités a priori
    # Indice: log(N_c / N) pour chaque classe c
    # ============================================

    log_priors = None  # <- Remplacez par votre code

    return log_priors
# Test de votre fonction
log_priors = estimate_log_priors(y_train)
if log_priors is not None:
for c in range(len(log_priors)):
print(f"log pi({noms_classes[c]}) = {log_priors[c]:.4f} -> pi = {np.exp(log_priors[c]):.4f}")
# Vérification: les probabilités doivent sommer à 1
if np.isclose(np.sum(np.exp(log_priors)), 1.0):
print("\nCorrect! Les probabilités somment à 1.")
else:
print("\nVérifiez votre implémentation.")
else:
print("Complétez la fonction estimate_log_priors!")Complétez la fonction estimate_log_priors!
Solution (cliquez pour afficher)
def estimate_log_priors(y_train):
    classes = np.unique(y_train)
    N = len(y_train)
    log_priors = np.array([np.log(np.sum(y_train == c) / N) for c in classes])
    return log_priors
Exercice 2: Estimer les probabilités conditionnelles ★
Pour le modèle multinomial, la probabilité du mot dans la classe est estimée par:
où:
= nombre total d’occurrences du mot dans les documents de classe
= nombre total de mots dans la classe
= taille du vocabulaire
= paramètre de lissage de Laplace ( par défaut)
Le lissage de Laplace évite les probabilités nulles: sans lui, un seul mot absent suffirait à éliminer une classe.
def estimate_log_likelihoods(X_train, y_train, alpha=1.0):
    """
    Estime les log-probabilités conditionnelles de chaque mot par classe.

    Args:
        X_train: matrice de comptage (N, D)
        y_train: étiquettes (N,)
        alpha: paramètre de lissage de Laplace

    Returns:
        log_likelihoods: matrice (C, D) où l'entrée [c, d] = log(theta_dc)
    """
    classes = np.unique(y_train)
    C = len(classes)
    D = X_train.shape[1]
    V = D  # taille du vocabulaire

    log_likelihoods = np.zeros((C, D))

    for c in classes:
        # Documents de la classe c
        X_c = X_train[y_train == c]

        # ============================================
        # TODO: Calculez les log-probabilités conditionnelles
        # 1. N_dc = X_c.sum(axis=0)  (occurrences de chaque mot)
        # 2. N_c_mots = N_dc.sum()  (total de mots dans la classe)
        # 3. theta_dc = (N_dc + alpha) / (N_c_mots + alpha * V)
        # 4. log_likelihoods[c] = np.log(theta_dc)
        # ============================================

        log_likelihoods[c] = None  # <- Remplacez par votre code

    return log_likelihoods
# Test de votre fonction
log_lk = estimate_log_likelihoods(X_train, y_train, alpha=1.0)
if log_lk is not None and not np.any(log_lk == 0):
print(f"Forme de la matrice: {log_lk.shape} (classes × mots)")
for c in range(2):
prob_sum = np.exp(log_lk[c]).sum()
print(f"\nClasse {noms_classes[c]}:")
print(f" Somme des probabilités: {prob_sum:.4f} (attendu: ≈ 1.0)")
top5 = np.argsort(log_lk[c])[-5:][::-1]
print(f" Top 5 mots: {[vocabulaire[i] for i in top5]}")
if all(np.isclose(np.exp(log_lk[c]).sum(), 1.0, atol=1e-5) for c in range(2)):
print("\nCorrect!")
else:
print("Complétez la fonction estimate_log_likelihoods!")Forme de la matrice: (2, 2000) (classes × mots)
Classe Électronique:
Somme des probabilités: nan (attendu: ≈ 1.0)
Top 5 mots: ['zoo', 'factor', 'experiments', 'explain', 'explanation']
Classe Médecine:
Somme des probabilités: nan (attendu: ≈ 1.0)
Top 5 mots: ['zoo', 'factor', 'experiments', 'explain', 'explanation']
Solution (cliquez pour afficher)
def estimate_log_likelihoods(X_train, y_train, alpha=1.0):
    classes = np.unique(y_train)
    C = len(classes)
    D = X_train.shape[1]
    V = D

    log_likelihoods = np.zeros((C, D))

    for c in classes:
        X_c = X_train[y_train == c]
        N_dc = X_c.sum(axis=0)
        N_c_mots = N_dc.sum()
        theta_dc = (N_dc + alpha) / (N_c_mots + alpha * V)
        log_likelihoods[c] = np.log(theta_dc)

    return log_likelihoods
Exercice 3: Prédire avec le naïf bayésien ★★
Pour classifier un document, nous calculons le score de chaque classe et choisissons la plus probable:
En forme matricielle:
Le calcul en espace logarithmique évite les problèmes de sous-dépassement numérique: le produit de milliers de probabilités proches de zéro donnerait un résultat indistinguable de zéro en arithmétique flottante.
def predict_naive_bayes(X, log_priors, log_likelihoods):
    """
    Prédit les classes avec le classifieur naïf bayésien.

    Args:
        X: matrice de comptage (N, D)
        log_priors: log-probabilités a priori (C,)
        log_likelihoods: log-probabilités conditionnelles (C, D)

    Returns:
        predictions: classes prédites (N,)
        log_scores: matrice de scores (N, C)
    """
    # ============================================
    # TODO: Calculez les scores log pour chaque classe
    # scores = X @ log_likelihoods.T + log_priors
    # predictions = argmax des scores par ligne
    # ============================================

    log_scores = None  # <- Remplacez par votre code
    predictions = None  # <- Remplacez par votre code

    return predictions, log_scores
# Test de votre fonction
if log_priors is not None and log_lk is not None and not np.any(log_lk == 0):
y_pred, scores = predict_naive_bayes(X_test, log_priors, log_lk)
if y_pred is not None:
accuracy = np.mean(y_pred == y_test)
print(f"Précision sur le test: {accuracy:.1%}")
print(f"\nMatrice de confusion:")
for c_true in [0, 1]:
for c_pred in [0, 1]:
count = np.sum((y_test == c_true) & (y_pred == c_pred))
print(f" Vrai={noms_classes[c_true]:15s} Prédit={noms_classes[c_pred]:15s} : {count}")
if accuracy > 0.85:
print(f"\nCorrect! Le classifieur atteint {accuracy:.1%} de précision.")
else:
print("Complétez la fonction predict_naive_bayes!")
else:
print("Complétez d'abord les fonctions précédentes!")Complétez d'abord les fonctions précédentes!
Solution (cliquez pour afficher)
def predict_naive_bayes(X, log_priors, log_likelihoods):
    log_scores = X @ log_likelihoods.T + log_priors
    predictions = np.argmax(log_scores, axis=1)
    return predictions, log_scores
Exercice 4: Interpréter le classifieur ★
Un avantage du naïf bayésien: nous pouvons identifier les mots les plus discriminants pour chaque classe. Le rapport des log-probabilités indique à quel point un mot est associé à une classe plutôt qu’à l’autre.
Complétez la fonction ci-dessous.
def most_discriminative_words(log_likelihoods, vocabulaire, noms_classes, n_top=10):
    """
    Trouve les mots les plus discriminants pour chaque classe.

    Args:
        log_likelihoods: log-probabilités conditionnelles (C, D)
        vocabulaire: array de mots (D,)
        noms_classes: liste de noms de classes
        n_top: nombre de mots à afficher par classe
    """
    # ============================================
    # TODO: Calculez le ratio log(theta_d,c=1) - log(theta_d,c=0)
    # Les mots avec les plus grands ratios favorisent la classe 1
    # Les mots avec les plus petits ratios favorisent la classe 0
    # ============================================

    log_ratio = None  # <- Remplacez par votre code

    if log_ratio is not None:
        top_class1 = np.argsort(log_ratio)[-n_top:][::-1]
        top_class0 = np.argsort(log_ratio)[:n_top]

        print(f"Mots les plus associés à '{noms_classes[1]}':")
        for i in top_class1:
            print(f"  {vocabulaire[i]:20s}  ratio = {log_ratio[i]:+.2f}")

        print(f"\nMots les plus associés à '{noms_classes[0]}':")
        for i in top_class0:
            print(f"  {vocabulaire[i]:20s}  ratio = {log_ratio[i]:+.2f}")
# Exécuter l'interprétation
if log_lk is not None and not np.any(log_lk == 0):
most_discriminative_words(log_lk, vocabulaire, noms_classes)
else:
print("Complétez d'abord les fonctions précédentes!")Solution (cliquez pour afficher)
def most_discriminative_words(log_likelihoods, vocabulaire, noms_classes, n_top=10):
    log_ratio = log_likelihoods[1] - log_likelihoods[0]

    top_class1 = np.argsort(log_ratio)[-n_top:][::-1]
    top_class0 = np.argsort(log_ratio)[:n_top]

    print(f"Mots les plus associés à '{noms_classes[1]}':")
    for i in top_class1:
        print(f"  {vocabulaire[i]:20s}  ratio = {log_ratio[i]:+.2f}")

    print(f"\nMots les plus associés à '{noms_classes[0]}':")
    for i in top_class0:
        print(f"  {vocabulaire[i]:20s}  ratio = {log_ratio[i]:+.2f}")
Comparaison avec scikit-learn
Vérifions que notre implémentation donne des résultats similaires à scikit-learn.
from sklearn.naive_bayes import MultinomialNB

if 'y_pred' in dir() and y_pred is not None:
    clf = MultinomialNB(alpha=1.0)
    clf.fit(X_train, y_train)

    accuracy_sklearn = clf.score(X_test, y_test)
    y_pred_sklearn = clf.predict(X_test)

    print("Comparaison des précisions:")
    print(f"  Notre implémentation: {np.mean(y_pred == y_test):.1%}")
    print(f"  Scikit-learn:         {accuracy_sklearn:.1%}")

    accord = np.mean(y_pred == y_pred_sklearn)
    print(f"\nAccord des prédictions: {accord:.1%}")
else:
    print("Complétez d'abord les fonctions précédentes!")
Complétez d'abord les fonctions précédentes!
Partie 3: Variables latentes et modèles de mélange gaussien
Passons de la classification supervisée au partitionnement non supervisé. Un modèle de mélange gaussien (GMM) suppose que les données sont générées par distributions gaussiennes:
Une variable latente indique de quel composant provient chaque observation. L’algorithme EM estime les paramètres en alternant entre le calcul des responsabilités (probabilités d’appartenance souples) et la mise à jour des paramètres.
Nous travaillons avec des données 2D synthétiques pour pouvoir visualiser chaque étape.
# Générer des données de 3 composants gaussiens
np.random.seed(42)

# Vrais paramètres (inconnus de l'algorithme)
true_means = [np.array([0, 0]), np.array([5, 0]), np.array([2.5, 4])]
true_covs = [
    np.array([[1.0, 0.3], [0.3, 1.0]]),
    np.array([[1.5, -0.5], [-0.5, 0.5]]),
    np.array([[0.5, 0.0], [0.0, 2.0]])
]
true_weights = [0.3, 0.4, 0.3]
n_total = 450

# Générer les données
X_gmm = []
z_true = []
for k in range(3):
    n_k = int(true_weights[k] * n_total)
    X_gmm.append(np.random.multivariate_normal(true_means[k], true_covs[k], n_k))
    z_true.extend([k] * n_k)

X_gmm = np.vstack(X_gmm)
z_true = np.array(z_true)

# Mélanger les données
shuffle_idx = np.random.permutation(len(X_gmm))
X_gmm = X_gmm[shuffle_idx]
z_true = z_true[shuffle_idx]

print(f"Nombre de points: {len(X_gmm)}")
print(f"Dimensions: {X_gmm.shape[1]}")
Nombre de points: 450
Dimensions: 2
# Visualisation
fig, axes = plt.subplots(1, 2, figsize=(12, 5))

ax = axes[0]
ax.scatter(X_gmm[:, 0], X_gmm[:, 1], c='gray', alpha=0.4, s=15)
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title('Données observées (sans étiquettes)')

ax = axes[1]
colors_true = ['steelblue', 'coral', 'seagreen']
for k in range(3):
    mask = z_true == k
    ax.scatter(X_gmm[mask, 0], X_gmm[mask, 1], c=colors_true[k], alpha=0.5,
               s=15, label=f'Composant {k+1}')
ax.set_xlabel('$x_1$')
ax.set_ylabel('$x_2$')
ax.set_title("Vérité (inconnue de l'algorithme)")
ax.legend()

plt.tight_layout()
plt.show()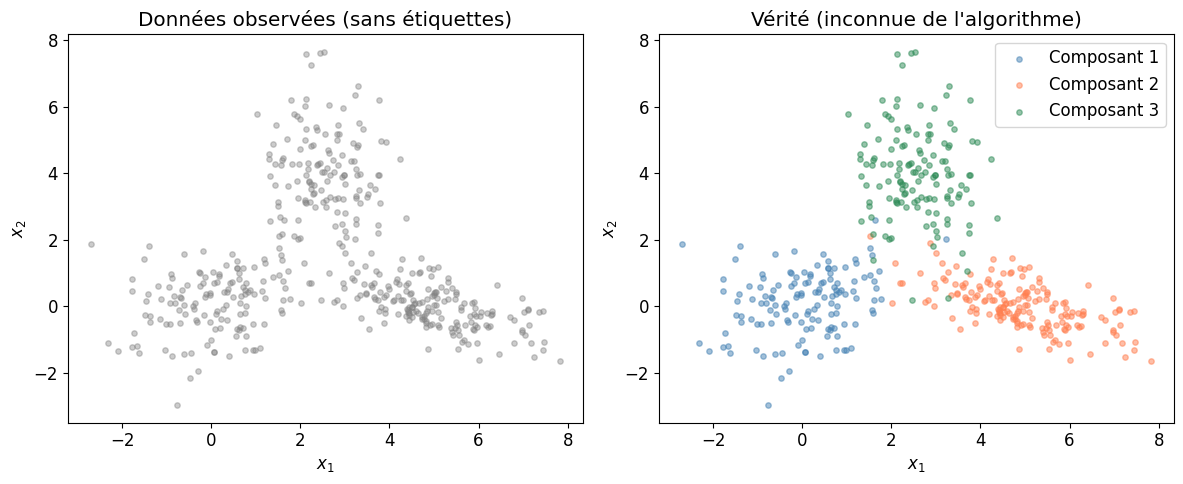
Exercice 5: Calculer la densité gaussienne multivariée ★
La densité d’une gaussienne multivariée est:
Le terme est la distance de Mahalanobis au carré.
def gaussian_pdf(X, mu, Sigma):
    """
    Calcule la densité gaussienne multivariée pour chaque point.

    Args:
        X: données (N, D)
        mu: moyenne (D,)
        Sigma: matrice de covariance (D, D)

    Returns:
        densities: densités (N,)
    """
    N, D = X.shape

    # ============================================
    # TODO: Calculez la densité gaussienne
    # 1. diff = X - mu                        (N, D)
    # 2. Sigma_inv = np.linalg.inv(Sigma)      (D, D)
    # 3. mahal = np.sum(diff @ Sigma_inv * diff, axis=1)  (N,)
    # 4. norm = 1 / sqrt((2*pi)^D * det(Sigma))
    # 5. densities = norm * exp(-0.5 * mahal)
    # ============================================

    densities = None  # <- Remplacez par votre code

    return densities
# Test: comparer avec scipy
from scipy.stats import multivariate_normal
test_pdf = gaussian_pdf(X_gmm[:2], np.array([0, 0]), np.eye(2))
if test_pdf is not None:
mu_test = np.array([1.0, 2.0])
Sigma_test = np.array([[1.0, 0.3], [0.3, 0.5]])
our_result = gaussian_pdf(X_gmm[:5], mu_test, Sigma_test)
scipy_result = multivariate_normal.pdf(X_gmm[:5], mean=mu_test, cov=Sigma_test)
print("Comparaison avec scipy.stats:")
for i in range(5):
print(f" Point {i}: nôtre = {our_result[i]:.6f}, scipy = {scipy_result[i]:.6f}")
if np.allclose(our_result, scipy_result, atol=1e-10):
print("\nCorrect!")
else:
print("\nVérifiez votre implémentation.")
else:
print("Complétez la fonction gaussian_pdf!")Complétez la fonction gaussian_pdf!
Solution (cliquez pour afficher)
def gaussian_pdf(X, mu, Sigma):
    N, D = X.shape
    diff = X - mu
    Sigma_inv = np.linalg.inv(Sigma)
    mahal = np.sum(diff @ Sigma_inv * diff, axis=1)
    norm = 1.0 / np.sqrt((2 * np.pi) ** D * np.linalg.det(Sigma))
    densities = norm * np.exp(-0.5 * mahal)
    return densities
Exercice 6: Calculer les responsabilités (étape E) ★★
L’étape E calcule les responsabilités — la probabilité a posteriori que chaque point provienne de chaque composant:
Les responsabilités sont des valeurs dans qui somment à 1 pour chaque point. C’est un partitionnement souple.
def e_step(X, weights, means, covariances):
    """
    Étape E: calcule les responsabilités.

    Args:
        X: données (N, D)
        weights: poids du mélange (K,)
        means: liste de K moyennes (chacune de dimension D)
        covariances: liste de K matrices de covariance (chacune D×D)

    Returns:
        responsibilities: matrice (N, K) des responsabilités
    """
    N = X.shape[0]
    K = len(weights)

    # ============================================
    # TODO: Calculez les responsabilités
    # 1. Pour chaque composant k:
    #    weighted_pdf[:, k] = weights[k] * gaussian_pdf(X, means[k], covariances[k])
    # 2. Normalisez chaque ligne:
    #    responsibilities = weighted_pdf / weighted_pdf.sum(axis=1, keepdims=True)
    # ============================================

    responsibilities = None  # <- Remplacez par votre code

    return responsibilities
# Test avec les vrais paramètres
test_pdf = gaussian_pdf(X_gmm[:2], np.array([0, 0]), np.eye(2))
if test_pdf is not None:
r_test = e_step(X_gmm, np.array(true_weights), true_means, true_covs)
if r_test is not None:
print(f"Forme des responsabilités: {r_test.shape}")
print(f"Somme par ligne (5 premiers, attendu: 1.0): {r_test[:5].sum(axis=1).round(4)}")
print(f"\nResponsabilités (5 premiers points):")
print(r_test[:5].round(3))
if np.allclose(r_test.sum(axis=1), 1.0):
print("\nCorrect! Les responsabilités somment à 1 pour chaque point.")
else:
print("Complétez la fonction e_step!")
else:
print("Complétez d'abord gaussian_pdf!")Complétez d'abord gaussian_pdf!
Solution (cliquez pour afficher)
def e_step(X, weights, means, covariances):
    N = X.shape[0]
    K = len(weights)

    weighted_pdf = np.zeros((N, K))
    for k in range(K):
        weighted_pdf[:, k] = weights[k] * gaussian_pdf(X, means[k], covariances[k])

    responsibilities = weighted_pdf / weighted_pdf.sum(axis=1, keepdims=True)
    return responsibilities
Exercice 7: Mettre à jour les paramètres (étape M) ★★
L’étape M met à jour les paramètres en utilisant les responsabilités comme pondérations. Soit le nombre effectif de points dans le composant :
Ces formules sont des versions pondérées des estimateurs classiques.
def m_step(X, responsibilities):
    """
    Étape M: met à jour les paramètres du GMM.

    Args:
        X: données (N, D)
        responsibilities: matrice (N, K) des responsabilités

    Returns:
        weights: nouveaux poids (K,)
        means: nouvelles moyennes (liste de K arrays)
        covariances: nouvelles covariances (liste de K matrices)
    """
    N, D = X.shape
    K = responsibilities.shape[1]

    # ============================================
    # TODO: Mettez à jour les paramètres
    # 1. N_k = responsibilities.sum(axis=0)             (K,)
    # 2. weights = N_k / N
    # 3. Pour chaque k:
    #    mu_k = (responsibilities[:, k:k+1] * X).sum(axis=0) / N_k[k]
    #    diff = X - mu_k
    #    Sigma_k = (responsibilities[:, k:k+1] * diff).T @ diff / N_k[k]
    #    Sigma_k += 1e-6 * np.eye(D)  (régularisation)
    # ============================================

    N_k = None  # <- Nombre effectif de points par composant
    weights = None  # <- Poids du mélange
    means = []
    covariances = []

    for k in range(K):
        mu_k = None  # <- Moyenne du composant k
        means.append(mu_k)

        Sigma_k = None  # <- Covariance du composant k
        covariances.append(Sigma_k)

    return weights, means, covariances
# Test de l'étape M
if 'r_test' in dir() and r_test is not None:
w_new, m_new, c_new = m_step(X_gmm, r_test)
if w_new is not None and m_new[0] is not None:
print("Paramètres mis à jour (avec les vraies responsabilités):")
for k in range(3):
print(f"\n Composant {k+1}:")
print(f" Poids: {w_new[k]:.3f} (vrai: {true_weights[k]:.3f})")
print(f" Moyenne: [{m_new[k][0]:.2f}, {m_new[k][1]:.2f}] "
f"(vrai: [{true_means[k][0]:.1f}, {true_means[k][1]:.1f}])")
if np.isclose(sum(w_new), 1.0):
print("\nCorrect! Les poids somment à 1.")
else:
print("Complétez la fonction m_step!")
else:
print("Complétez d'abord e_step!")Complétez d'abord e_step!
Solution (cliquez pour afficher)
def m_step(X, responsibilities):
    N, D = X.shape
    K = responsibilities.shape[1]

    N_k = responsibilities.sum(axis=0)
    weights = N_k / N
    means = []
    covariances = []

    for k in range(K):
        mu_k = (responsibilities[:, k:k+1] * X).sum(axis=0) / N_k[k]
        means.append(mu_k)

        diff = X - mu_k
        Sigma_k = (responsibilities[:, k:k+1] * diff).T @ diff / N_k[k]
        Sigma_k += 1e-6 * np.eye(D)
        covariances.append(Sigma_k)

    return weights, means, covariances
Exercice 8: Implémenter l’algorithme EM complet ★★
L’algorithme EM alterne les étapes E et M jusqu’à convergence. Nous mesurons la convergence par la log-vraisemblance:
La fonction compute_log_likelihood est fournie. Complétez la boucle EM.
def compute_log_likelihood(X, weights, means, covariances):
    """Calcule la log-vraisemblance du modèle."""
    N = X.shape[0]
    K = len(weights)

    weighted_pdfs = np.zeros((N, K))
    for k in range(K):
        weighted_pdfs[:, k] = weights[k] * gaussian_pdf(X, means[k], covariances[k])

    return np.sum(np.log(weighted_pdfs.sum(axis=1)))


def em_algorithm(X, K, n_iterations=50, seed=0):
    """
    Algorithme EM pour un modèle de mélange gaussien.

    Args:
        X: données (N, D)
        K: nombre de composants
        n_iterations: nombre maximal d'itérations
        seed: graine aléatoire pour l'initialisation

    Returns:
        weights, means, covariances: paramètres appris
        responsibilities: responsabilités finales (N, K)
        log_likelihoods: historique de la log-vraisemblance
    """
    N, D = X.shape
    np.random.seed(seed)

    # Initialisation: K points aléatoires comme moyennes
    indices = np.random.choice(N, K, replace=False)
    means = [X[idx].copy() for idx in indices]
    covariances = [np.eye(D) for _ in range(K)]
    weights = np.ones(K) / K

    log_likelihoods = []

    # ============================================
    # TODO: Implémentez la boucle EM
    # Pour chaque itération:
    # 1. responsibilities = e_step(X, weights, means, covariances)
    # 2. weights, means, covariances = m_step(X, responsibilities)
    # 3. ll = compute_log_likelihood(X, weights, means, covariances)
    # 4. log_likelihoods.append(ll)
    # ============================================

    for t in range(n_iterations):
        # Étape E
        responsibilities = None  # <- Complétez

        # Étape M
        # <- Complétez (mettez à jour weights, means, covariances)
        pass

        # Log-vraisemblance
        ll = None  # <- Complétez
        log_likelihoods.append(ll)

    return weights, means, covariances, responsibilities, log_likelihoods
# Exécuter l'algorithme EM
test_pdf = gaussian_pdf(X_gmm[:2], np.array([0, 0]), np.eye(2))
if test_pdf is not None:
weights_em, means_em, covs_em, resp_em, ll_history = em_algorithm(
X_gmm, K=3, n_iterations=50, seed=42
)
if ll_history[0] is not None:
print("Paramètres appris par EM:")
for k in range(3):
print(f"\n Composant {k+1}:")
print(f" Poids: {weights_em[k]:.3f}")
print(f" Moyenne: [{means_em[k][0]:.2f}, {means_em[k][1]:.2f}]")
print(f"\nLog-vraisemblance initiale: {ll_history[0]:.1f}")
print(f"Log-vraisemblance finale: {ll_history[-1]:.1f}")
else:
print("Complétez la fonction em_algorithm!")
else:
print("Complétez d'abord gaussian_pdf!")Complétez d'abord gaussian_pdf!
Solution (cliquez pour afficher)
def em_algorithm(X, K, n_iterations=50, seed=0):
    N, D = X.shape
    np.random.seed(seed)

    indices = np.random.choice(N, K, replace=False)
    means = [X[idx].copy() for idx in indices]
    covariances = [np.eye(D) for _ in range(K)]
    weights = np.ones(K) / K

    log_likelihoods = []

    for t in range(n_iterations):
        responsibilities = e_step(X, weights, means, covariances)
        weights, means, covariances = m_step(X, responsibilities)
        ll = compute_log_likelihood(X, weights, means, covariances)
        log_likelihoods.append(ll)

    return weights, means, covariances, responsibilities, log_likelihoods
Visualiser la convergence
if 'll_history' in dir() and len(ll_history) > 0 and ll_history[0] is not None:
    from matplotlib.patches import Ellipse

    fig, axes = plt.subplots(1, 2, figsize=(14, 5))

    # Log-vraisemblance
    ax = axes[0]
    ax.plot(ll_history, 'C0-', linewidth=2)
    ax.set_xlabel('Itération')
    ax.set_ylabel('Log-vraisemblance')
    ax.set_title("Convergence de l'algorithme EM")
    ax.grid(True, alpha=0.3)

    # Résultat du partitionnement
    ax = axes[1]
    z_em = np.argmax(resp_em, axis=1)
    colors_em = ['steelblue', 'coral', 'seagreen']

    for k in range(3):
        mask = z_em == k
        ax.scatter(X_gmm[mask, 0], X_gmm[mask, 1], c=colors_em[k], alpha=0.4,
                   s=15, label=f'Composant {k+1} ($\pi$={weights_em[k]:.2f})')

        # Dessiner les ellipses
        eigenvalues, eigenvectors = np.linalg.eigh(covs_em[k])
        angle = np.degrees(np.arctan2(eigenvectors[1, 0], eigenvectors[0, 0]))
        for n_std in [1, 2]:
            width = 2 * n_std * np.sqrt(eigenvalues[0])
            height = 2 * n_std * np.sqrt(eigenvalues[1])
            ellipse = Ellipse(means_em[k], width, height, angle=angle, fill=False,
                             color=colors_em[k], linewidth=2, linestyle='--')
            ax.add_patch(ellipse)

    ax.set_xlabel('$x_1$')
    ax.set_ylabel('$x_2$')
    ax.set_title("Résultat de l'algorithme EM")
    ax.legend()

    plt.tight_layout()
    plt.show()
else:
    print("Complétez d'abord l'algorithme EM!")
Complétez d'abord l'algorithme EM!
<>:22: SyntaxWarning: invalid escape sequence '\p'
<>:22: SyntaxWarning: invalid escape sequence '\p'
/var/folders/kz/gmggxk812sg1jvysfbnx_y7h0000gq/T/ipykernel_47364/832672827.py:22: SyntaxWarning: invalid escape sequence '\p'
  s=15, label=f'Composant {k+1} ($\pi$={weights_em[k]:.2f})')
Partie 4: Comparaison GMM et k-moyennes
L’algorithme k-moyennes est un cas limite de GMM où les covariances sont sphériques et identiques, et les responsabilités deviennent binaires. Comparons les deux approches sur des données avec des groupes de formes elliptiques différentes.
Exercice 9: GMM vs k-moyennes ★★★
Exécutez la cellule ci-dessous, puis répondez aux questions de réflexion.
from sklearn.cluster import KMeans
from matplotlib.patches import Ellipse

if 'll_history' in dir() and len(ll_history) > 0 and ll_history[0] is not None:
    # Données avec des ellipses allongées
    np.random.seed(123)
    X_ellipse = np.vstack([
        np.random.multivariate_normal([0, 0], [[4, 0], [0, 0.2]], 150),
        np.random.multivariate_normal([0, 3], [[0.2, 0], [0, 4]], 150),
    ])

    # K-moyennes
    kmeans = KMeans(n_clusters=2, random_state=42, n_init=10)
    z_kmeans = kmeans.fit_predict(X_ellipse)

    # GMM (notre implémentation)
    w_cmp, m_cmp, c_cmp, r_cmp, _ = em_algorithm(X_ellipse, K=2, n_iterations=50, seed=42)
    z_gmm = np.argmax(r_cmp, axis=1)

    fig, axes = plt.subplots(1, 2, figsize=(12, 5))

    # K-moyennes
    ax = axes[0]
    for k in range(2):
        mask = z_kmeans == k
        ax.scatter(X_ellipse[mask, 0], X_ellipse[mask, 1], c=f'C{k}', alpha=0.5, s=15)
    ax.scatter(kmeans.cluster_centers_[:, 0], kmeans.cluster_centers_[:, 1],
               c='black', marker='X', s=200, zorder=5, label='Centroïdes')
    ax.set_xlabel('$x_1$')
    ax.set_ylabel('$x_2$')
    ax.set_title('K-moyennes')
    ax.legend()

    # GMM
    ax = axes[1]
    for k in range(2):
        mask = z_gmm == k
        ax.scatter(X_ellipse[mask, 0], X_ellipse[mask, 1], c=f'C{k}', alpha=0.5, s=15)

    for k in range(2):
        eigenvalues, eigenvectors = np.linalg.eigh(c_cmp[k])
        angle = np.degrees(np.arctan2(eigenvectors[1, 0], eigenvectors[0, 0]))
        for n_std in [1, 2]:
            width = 2 * n_std * np.sqrt(np.maximum(eigenvalues[0], 1e-6))
            height = 2 * n_std * np.sqrt(np.maximum(eigenvalues[1], 1e-6))
            ellipse = Ellipse(m_cmp[k], width, height, angle=angle, fill=False,
                             color=f'C{k}', linewidth=2, linestyle='--')
            ax.add_patch(ellipse)

    ax.set_xlabel('$x_1$')
    ax.set_ylabel('$x_2$')
    ax.set_title('GMM (algorithme EM)')

    plt.tight_layout()
    plt.show()
else:
    print("Complétez d'abord l'algorithme EM!")
Complétez d'abord l'algorithme EM!
Questions de réflexion:
K-moyennes découpe l’espace en régions délimitées par des frontières linéaires (diagramme de Voronoï). Pourquoi cela pose-t-il problème pour des groupes allongés?
GMM modélise chaque composant avec sa propre matrice de covariance. Quel avantage cela donne-t-il sur des données à formes variées?
Les responsabilités souples du GMM indiquent l’incertitude d’assignation. Dans quelles applications pratiques cette information serait-elle utile?
Récapitulatif
Dans ce TP, vous avez implémenté deux modèles génératifs:
Naïf bayésien pour la classification de texte:
Estimation des a priori et des probabilités conditionnelles par maximum de vraisemblance
Lissage de Laplace pour éviter les probabilités nulles
Prédiction en espace logarithmique:
Modèle de mélange gaussien pour le partitionnement non supervisé:
Densité gaussienne multivariée et distance de Mahalanobis
Responsabilités: probabilités d’appartenance souples
Algorithme EM: alternance étape E (responsabilités) et étape M (paramètres pondérés)
Le naïf bayésien illustre l’approche générative en classification supervisée: modéliser pour chaque classe plutôt que directement. Le GMM étend cette idée au cas non supervisé, où les «classes» (composants) sont inconnues et doivent être inférées par l’algorithme EM.
Pour aller plus loin: Chapitre 6: Modèles probabilistes génératifs