IFT6390 - Fondements de l’apprentissage machine
Ce notebook accompagne le Chapitre 3: Classification linéaire.
Objectifs
À la fin de ce TP, vous serez en mesure de:
Implémenter la fonction sigmoïde et comprendre son rôle
Calculer l’entropie croisée binaire
Dériver et implémenter le gradient de la perte logistique
Entraîner un classifieur par descente de gradient
Interpréter les coefficients appris
Ce TP implémente tout à la main, sans utiliser scikit-learn pour l’entraînement. Nous utilisons le jeu de données du béton, déjà rencontré au chapitre 2, mais cette fois pour un problème de classification: le béton est-il conforme (résistance suffisante) ou non?
Partie 0: Configuration
Exécutez cette cellule pour importer les bibliothèques nécessaires.
import numpy as np
import matplotlib.pyplot as plt

# Pour de jolis graphiques
plt.rcParams['figure.figsize'] = (8, 5)
plt.rcParams['font.size'] = 12

# Installation de ucimlrepo si nécessaire
try:
    from ucimlrepo import fetch_ucirepo
except ImportError:
    !pip install ucimlrepo
    from ucimlrepo import fetch_ucirepo

print("Configuration terminée!")
Configuration terminée!
Partie 1: Les données du béton
Au chapitre 2, nous avons prédit la résistance du béton (en MPa) à partir de sa formulation. Ici, nous posons une question binaire: la résistance dépasse-t-elle un seuil donné?
Classe 1 (conforme): résistance seuil
Classe 0 (non conforme): résistance seuil
Les mêmes caractéristiques (ciment, eau, âge, etc.) servent à prédire cette étiquette.
# Charger le jeu de données
beton = fetch_ucirepo(id=165)
X_df = beton.data.features
y_resistance = beton.data.targets.values.ravel()

# Noms des caractéristiques
noms_caracteristiques = ['Ciment', 'Laitier', 'Cendres', 'Eau', 'Plastifiant',
                         'Granulat gros', 'Granulat fin', 'Âge']

print(f"Nombre d'échantillons: {len(y_resistance)}")
print(f"Nombre de caractéristiques: {X_df.shape[1]}")
print(f"\nCaractéristiques: {noms_caracteristiques}")
print(f"\nRésistance: min={y_resistance.min():.1f} MPa, max={y_resistance.max():.1f} MPa")
Nombre d'échantillons: 1030
Nombre de caractéristiques: 8
Caractéristiques: ['Ciment', 'Laitier', 'Cendres', 'Eau', 'Plastifiant', 'Granulat gros', 'Granulat fin', 'Âge']
Résistance: min=2.3 MPa, max=82.6 MPa
# Créer la cible binaire: conforme si résistance >= médiane
seuil = np.median(y_resistance)
y = (y_resistance >= seuil).astype(int)

print(f"Seuil de conformité: {seuil:.1f} MPa (médiane)")
print(f"\nClasse 0 (non conforme): {np.sum(y == 0)} échantillons ({np.mean(y == 0):.1%})")
print(f"Classe 1 (conforme): {np.sum(y == 1)} échantillons ({np.mean(y == 1):.1%})")
Seuil de conformité: 34.4 MPa (médiane)
Classe 0 (non conforme): 515 échantillons (50.0%)
Classe 1 (conforme): 515 échantillons (50.0%)
# Visualisation de la distribution
fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# Histogramme de la résistance
ax = axes[0]
ax.hist(y_resistance, bins=30, edgecolor='white', alpha=0.7)
ax.axvline(seuil, color='red', linestyle='--', linewidth=2, label=f'Seuil = {seuil:.1f} MPa')
ax.set_xlabel('Résistance (MPa)')
ax.set_ylabel('Fréquence')
ax.set_title('Distribution de la résistance du béton')
ax.legend()

# Répartition des classes
ax = axes[1]
classes, counts = np.unique(y, return_counts=True)
bars = ax.bar(['Non conforme\n(classe 0)', 'Conforme\n(classe 1)'], counts,
              color=['C1', 'C0'], alpha=0.7)
ax.set_ylabel('Nombre d\'échantillons')
ax.set_title('Répartition des classes')
for bar, count in zip(bars, counts):
    ax.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 10,
            str(count), ha='center', fontsize=12)

plt.tight_layout()
plt.show()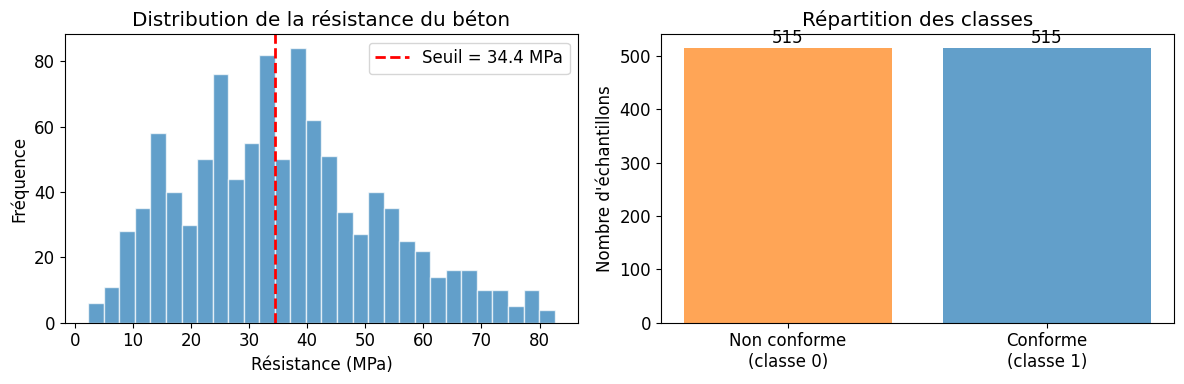
Normalisation des données
Les caractéristiques ont des échelles très différentes (l’âge en jours vs le ciment en kg/m³). Pour que la descente de gradient converge bien, nous normalisons les données: chaque caractéristique est centrée (moyenne 0) et réduite (écart-type 1).
# Récupérer les données brutes
X_raw = X_df.values

# Normalisation: centrer et réduire
X_mean = X_raw.mean(axis=0)
X_std = X_raw.std(axis=0)
X_normalized = (X_raw - X_mean) / X_std

# Ajouter la colonne de biais (colonne de 1)
X = np.column_stack([np.ones(len(X_normalized)), X_normalized])

print(f"Forme de X (avec biais): {X.shape}")
print(f"\nMoyennes avant normalisation: {X_raw.mean(axis=0).round(1)}")
print(f"Moyennes après normalisation: {X_normalized.mean(axis=0).round(6)}")
Forme de X (avec biais): (1030, 9)
Moyennes avant normalisation: [281.2 73.9 54.2 181.6 6.2 972.9 773.6 45.7]
Moyennes après normalisation: [-0. -0. -0. -0. -0. 0. -0. 0.]
Séparation entraînement / test
# Séparation train/test (80% / 20%)
np.random.seed(42)
n = len(y)
indices = np.random.permutation(n)
n_train = int(0.8 * n)

train_idx = indices[:n_train]
test_idx = indices[n_train:]

X_train, y_train = X[train_idx], y[train_idx]
X_test, y_test = X[test_idx], y[test_idx]

print(f"Entraînement: {len(X_train)} échantillons")
print(f"Test: {len(X_test)} échantillons")
Entraînement: 824 échantillons
Test: 206 échantillons
Partie 2: La fonction sigmoïde
La fonction sigmoïde transforme n’importe quel nombre réel en une valeur entre 0 et 1:
C’est la clé de la régression logistique: elle permet d’interpréter la sortie comme une probabilité.
Exercice 1: Implémenter la sigmoïde ★
Complétez la fonction ci-dessous.
def sigmoid(a):
    """
    Calcule la fonction sigmoïde.

    Args:
        a: scalaire ou array numpy

    Returns:
        sigma(a) = 1 / (1 + exp(-a))
    """
    # ============================================
    # TODO: Implémentez la sigmoïde
    # Indice: utilisez np.exp()
    # ============================================

    result = None  # <- Remplacez par votre code

    return result
# Test de votre fonction
if sigmoid(0) is not None:
print(f"sigma(0) = {sigmoid(0):.4f} (attendu: 0.5)")
print(f"sigma(2) = {sigmoid(2):.4f} (attendu: 0.8808)")
print(f"sigma(-2) = {sigmoid(-2):.4f} (attendu: 0.1192)")
# Vérification
if np.isclose(sigmoid(0), 0.5) and np.isclose(sigmoid(2), 0.8808, atol=1e-3):
print("\nCorrect!")
else:
print("\nVérifiez votre implémentation.")
else:
print("Complétez la fonction sigmoid!")Complétez la fonction sigmoid!
Solution (cliquez pour afficher)
def sigmoid(a):
    return 1 / (1 + np.exp(-a))
Visualiser la sigmoïde
if sigmoid(0) is not None:
    a_values = np.linspace(-6, 6, 200)

    plt.figure(figsize=(8, 5))
    plt.plot(a_values, sigmoid(a_values), 'C0-', linewidth=2)
    plt.axhline(0.5, color='gray', linestyle='--', alpha=0.5)
    plt.axvline(0, color='gray', linestyle='--', alpha=0.5)

    plt.xlabel('$a = \\boldsymbol{\\theta}^\\top \\mathbf{x}$')
    plt.ylabel('$\\sigma(a) = P(\\text{conforme}|\\mathbf{x})$')
    plt.title('La fonction sigmoïde')

    plt.annotate('$a < 0$: non conforme plus probable', xy=(-4.5, 0.15), fontsize=10, color='C1')
    plt.annotate('$a > 0$: conforme plus probable', xy=(1.5, 0.85), fontsize=10, color='C0')

    plt.xlim(-6, 6)
    plt.ylim(-0.05, 1.05)
    plt.grid(True, alpha=0.3)
    plt.show()
else:
    print("Complétez d'abord la fonction sigmoid!")
Complétez d'abord la fonction sigmoid!
Partie 3: L’entropie croisée
La perte mesure à quel point nos prédictions sont mauvaises. Pour la régression logistique, nous utilisons l’entropie croisée binaire:
où est la probabilité prédite pour la classe 1 (conforme).
Exercice 2: Implémenter l’entropie croisée ★
Complétez la fonction ci-dessous.
Conseil: Utilisez np.clip() pour éviter les problèmes numériques avec .
def cross_entropy_loss(y_true, y_pred):
    """
    Calcule l'entropie croisée binaire moyenne.

    Args:
        y_true: étiquettes vraies (0 ou 1), array de taille (N,)
        y_pred: probabilités prédites (entre 0 et 1), array de taille (N,)

    Returns:
        Entropie croisée moyenne (scalaire)
    """
    # Éviter log(0) en "clipant" les probabilités
    eps = 1e-10
    y_pred = np.clip(y_pred, eps, 1 - eps)

    # ============================================
    # TODO: Calculez l'entropie croisée
    # Formule: -mean(y * log(pred) + (1-y) * log(1-pred))
    # ============================================

    loss = None  # <- Remplacez par votre code

    return loss
# Test de votre fonction
y_test_ex = np.array([1, 0, 1, 0])
pred_parfait = np.array([0.99, 0.01, 0.99, 0.01])
pred_mauvais = np.array([0.01, 0.99, 0.01, 0.99])
pred_neutre = np.array([0.5, 0.5, 0.5, 0.5])
if cross_entropy_loss(y_test_ex, pred_parfait) is not None:
print(f"Perte (prédictions parfaites): {cross_entropy_loss(y_test_ex, pred_parfait):.4f} (proche de 0)")
print(f"Perte (prédictions neutres): {cross_entropy_loss(y_test_ex, pred_neutre):.4f} (environ 0.69)")
print(f"Perte (prédictions inversées): {cross_entropy_loss(y_test_ex, pred_mauvais):.4f} (très élevée)")
if cross_entropy_loss(y_test_ex, pred_parfait) < 0.1:
print("\nCorrect!")
else:
print("Complétez la fonction cross_entropy_loss!")Complétez la fonction cross_entropy_loss!
Solution (cliquez pour afficher)
def cross_entropy_loss(y_true, y_pred):
    eps = 1e-10
    y_pred = np.clip(y_pred, eps, 1 - eps)

    loss = -np.mean(y_true * np.log(y_pred) + (1 - y_true) * np.log(1 - y_pred))
    return loss
Partie 4: Le gradient
Pour minimiser la perte par descente de gradient, nous avons besoin du gradient. La dérivation (voir le chapitre 3) donne une formule simple:
Le gradient est une moyenne pondérée des entrées, où le poids est l’erreur de prédiction .
Exercice 3: Implémenter le gradient ★★
Complétez la fonction ci-dessous.
def compute_gradient(X, y, theta):
    """
    Calcule le gradient de l'entropie croisée.

    Args:
        X: matrice de données avec biais (N, d)
        y: étiquettes (N,)
        theta: paramètres actuels (d,)

    Returns:
        Gradient de la perte (d,)
    """
    N = len(y)

    # ============================================
    # TODO:
    # 1. Calculer les probabilités mu = sigmoid(X @ theta)
    # 2. Calculer le gradient = X.T @ (mu - y) / N
    # ============================================

    mu = None  # <- Prédictions
    gradient = None  # <- Gradient

    return gradient
# Test de votre fonction
theta_test = np.zeros(X_train.shape[1]) # 9 paramètres (biais + 8 caractéristiques)
if sigmoid(0) is not None:
grad = compute_gradient(X_train, y_train, theta_test)
if grad is not None:
print(f"Gradient avec theta = 0:")
print(f" Biais: {grad[0]:.4f}")
for i, nom in enumerate(noms_caracteristiques):
print(f" {nom}: {grad[i+1]:.4f}")
print(f"\nNorme du gradient: {np.linalg.norm(grad):.4f}")
else:
print("Complétez la fonction compute_gradient!")
else:
print("Complétez d'abord la fonction sigmoid!")Complétez d'abord la fonction sigmoid!
Solution (cliquez pour afficher)
def compute_gradient(X, y, theta):
    N = len(y)
    mu = sigmoid(X @ theta)
    gradient = X.T @ (mu - y) / N
    return gradient
Partie 5: Descente de gradient
Nous avons tous les ingrédients! La descente de gradient met à jour les paramètres de façon itérative:
où est le taux d’apprentissage.
Exercice 4: Implémenter la descente de gradient ★★
Complétez la boucle d’entraînement.
def train_logistic_regression(X, y, lr=0.1, n_iterations=100):
    """
    Entraîne un classifieur logistique par descente de gradient.

    Args:
        X: matrice de données avec biais (N, d)
        y: étiquettes (N,)
        lr: taux d'apprentissage
        n_iterations: nombre d'itérations

    Returns:
        theta: paramètres appris (d,)
        losses: historique de la perte
    """
    d = X.shape[1]
    theta = np.zeros(d)  # Initialisation
    losses = []

    for t in range(n_iterations):
        # ============================================
        # TODO:
        # 1. Calculer les probabilités prédites
        # 2. Calculer la perte (pour l'historique)
        # 3. Calculer le gradient
        # 4. Mettre à jour theta
        # ============================================

        # Probabilités prédites
        mu = None  # <- Complétez

        # Perte actuelle
        loss = None  # <- Complétez
        losses.append(loss)

        # Gradient
        grad = None  # <- Complétez

        # Mise à jour: theta = theta - lr * grad
        # <- Complétez
        pass

    return theta, losses
# Entraînement!
if sigmoid(0) is not None and cross_entropy_loss(y_test_ex, pred_parfait) is not None:
theta_learned, loss_history = train_logistic_regression(
X_train, y_train, lr=0.5, n_iterations=200
)
if loss_history[0] is not None:
print("Paramètres appris:")
print(f" Biais: {theta_learned[0]:.4f}")
for i, nom in enumerate(noms_caracteristiques):
print(f" {nom}: {theta_learned[i+1]:.4f}")
print(f"\nPerte initiale: {loss_history[0]:.4f}")
print(f"Perte finale: {loss_history[-1]:.4f}")
else:
print("Complétez la fonction train_logistic_regression!")
else:
print("Complétez d'abord les fonctions précédentes!")Complétez d'abord les fonctions précédentes!
Solution (cliquez pour afficher)
def train_logistic_regression(X, y, lr=0.1, n_iterations=100):
    d = X.shape[1]
    theta = np.zeros(d)
    losses = []

    for t in range(n_iterations):
        # Probabilités prédites
        mu = sigmoid(X @ theta)

        # Perte actuelle
        loss = cross_entropy_loss(y, mu)
        losses.append(loss)

        # Gradient
        grad = compute_gradient(X, y, theta)

        # Mise à jour
        theta = theta - lr * grad

    return theta, losses
Visualiser la convergence
if 'loss_history' in dir() and loss_history[0] is not None:
    plt.figure(figsize=(8, 5))
    plt.plot(loss_history, 'C0-', linewidth=2)
    plt.xlabel('Itération')
    plt.ylabel('Entropie croisée')
    plt.title('Convergence de la descente de gradient')
    plt.grid(True, alpha=0.3)
    plt.show()
else:
    print("Complétez d'abord la fonction d'entraînement!")
Complétez d'abord la fonction d'entraînement!
Partie 6: Prédiction et évaluation
Pour prédire, nous classifions comme “conforme” si , c’est-à-dire si .
Exercice 5: Implémenter la prédiction ★
def predict_proba(X, theta):
    """Retourne les probabilités de la classe 1 (conforme)."""
    # ============================================
    # TODO: Calculez sigmoid(X @ theta)
    # ============================================
    return None  # <- Remplacez


def predict(X, theta, threshold=0.5):
    """Retourne les prédictions binaires (0 ou 1)."""
    # ============================================
    # TODO: Retournez 1 si proba >= threshold, 0 sinon
    # Indice: (predict_proba(X, theta) >= threshold).astype(int)
    # ============================================
    return None  # <- Remplacez
# Évaluation
if 'theta_learned' in dir() and predict(X_train, theta_learned) is not None:
# Précision sur l'ensemble d'entraînement
y_pred_train = predict(X_train, theta_learned)
accuracy_train = np.mean(y_pred_train == y_train)
# Précision sur l'ensemble de test
y_pred_test = predict(X_test, theta_learned)
accuracy_test = np.mean(y_pred_test == y_test)
print(f"Précision sur l'entraînement: {accuracy_train:.1%}")
print(f"Précision sur le test: {accuracy_test:.1%}")
else:
print("Complétez les fonctions de prédiction!")Complétez les fonctions de prédiction!
Solution (cliquez pour afficher)
def predict_proba(X, theta):
    return sigmoid(X @ theta)

def predict(X, theta, threshold=0.5):
    return (predict_proba(X, theta) >= threshold).astype(int)
Partie 7: Interprétation des coefficients
Un avantage de la régression logistique: les coefficients sont interprétables. Chaque représente le changement dans le log-odds (logarithme du rapport de cotes) pour une augmentation d’un écart-type de la caractéristique .
: la caractéristique augmente la probabilité de conformité
: la caractéristique diminue la probabilité de conformité
grand: effet fort
if 'theta_learned' in dir() and loss_history[0] is not None:
    # Coefficients (sans le biais)
    coefficients = theta_learned[1:]

    # Graphique
    fig, ax = plt.subplots(figsize=(10, 5))

    couleurs = ['C0' if c > 0 else 'C1' for c in coefficients]
    bars = ax.barh(noms_caracteristiques, coefficients, color=couleurs, alpha=0.8)
    ax.axvline(0, color='gray', linewidth=1)

    ax.set_xlabel('Coefficient (effet sur le log-odds de conformité)')
    ax.set_title('Influence des caractéristiques sur la probabilité de conformité')
    ax.grid(True, alpha=0.3, axis='x')

    plt.tight_layout()
    plt.show()

    print("Interprétation:")
    print("- Coefficients positifs (bleu): augmentent la probabilité de conformité")
    print("- Coefficients négatifs (orange): diminuent la probabilité de conformité")
else:
    print("Complétez d'abord les fonctions précédentes!")
Complétez d'abord les fonctions précédentes!
Questions de réflexion:
Quelles caractéristiques augmentent le plus la probabilité de conformité?
Est-ce cohérent avec la physique du béton? (Plus de ciment = plus résistant? Plus d’eau = moins résistant?)
Pourquoi l’âge a-t-il un effet positif?
if sigmoid(0) is not None and cross_entropy_loss(y_test_ex, pred_parfait) is not None:
    learning_rates = [0.01, 0.1, 0.5, 1.0, 2.0]

    plt.figure(figsize=(10, 5))

    for lr in learning_rates:
        _, losses = train_logistic_regression(X_train, y_train, lr=lr, n_iterations=200)
        if losses[0] is not None:
            plt.plot(losses, label=f'η = {lr}', linewidth=2)

    plt.xlabel('Itération')
    plt.ylabel('Entropie croisée')
    plt.title('Effet du taux d\'apprentissage')
    plt.legend()
    plt.grid(True, alpha=0.3)
    plt.show()

    print("Observations:")
    print("- η trop petit (0.01): convergence très lente")
    print("- η trop grand (2.0): peut osciller ou diverger")
    print("- η = 0.5 ou 1.0: bon compromis pour ce jeu de données")
else:
    print("Complétez d'abord les fonctions!")
Complétez d'abord les fonctions!
Partie 9: Comparaison avec scikit-learn ★
Vérifions que notre implémentation donne des résultats similaires à scikit-learn.
from sklearn.linear_model import LogisticRegression as SklearnLogReg

if 'theta_learned' in dir() and loss_history[0] is not None:
    # Entraîner avec scikit-learn (sur données normalisées, sans la colonne de biais)
    X_train_sklearn = X_train[:, 1:]  # Enlever la colonne de 1
    X_test_sklearn = X_test[:, 1:]

    model_sklearn = SklearnLogReg(penalty=None, max_iter=1000)
    model_sklearn.fit(X_train_sklearn, y_train)

    # Comparer les précisions
    accuracy_sklearn_train = model_sklearn.score(X_train_sklearn, y_train)
    accuracy_sklearn_test = model_sklearn.score(X_test_sklearn, y_test)

    print("Comparaison des précisions:")
    print(f"\nNotre implémentation:")
    print(f"  Train: {accuracy_train:.1%}")
    print(f"  Test: {accuracy_test:.1%}")

    print(f"\nScikit-learn:")
    print(f"  Train: {accuracy_sklearn_train:.1%}")
    print(f"  Test: {accuracy_sklearn_test:.1%}")

    # Accord des prédictions
    y_pred_sklearn = model_sklearn.predict(X_test_sklearn)
    accord = np.mean(y_pred_test == y_pred_sklearn)
    print(f"\nAccord des prédictions sur le test: {accord:.1%}")
else:
    print("Complétez d'abord les fonctions précédentes!")
Complétez d'abord les fonctions précédentes!
Récapitulatif
Dans ce TP, vous avez implémenté la régression logistique de A à Z sur le jeu de données du béton:
Sigmoïde: transforme un score en probabilité
Entropie croisée: La perte qui pénalise les mauvaises prédictions
Gradient: Direction pour réduire la perte
Descente de gradient: Mise à jour itérative
Interprétation: Les coefficients indiquent l’effet de chaque caractéristique sur la probabilité de conformité
Ces mêmes idées se généralisent aux réseaux de neurones, où la régression logistique devient la couche de sortie pour la classification.
Pour aller plus loin: Chapitre 3: Classification linéaire