Session : Hiver 2026 Date de remise : 7 avril 2026 Travail en équipe : groupes de 2-3 étudiants Évaluation : cahier Colab (75%), dérivations manuscrites (25%)
1. Objectif
Dans ce devoir, vous prédirez la température critique d’une molécule à partir de sa représentation SMILES. Le but est de comparer quatre approches dans un régime de données limitées :
caractéristiques fixes + MLP,
modèle séquentiel (LSTM) entraîné à partir de zéro,
transformeur entraîné à partir de zéro,
représentations pré-entraînées avec SMI-TED.
La question centrale est la suivante : sur un jeu de données modeste, est-ce que des modèles plus expressifs suffisent, ou est-ce que des représentations pré-entraînées sont plus utiles ?
2. Jeu de données
Vous utiliserez le fichier chedl_thermo_properties.csv disponible dans le dépôt refgen. Le fichier contient environ 24 600 molécules avec leur chaîne SMILES et plusieurs propriétés thermodynamiques. La propriété cible pour toutes les équipes est la température critique (en kelvins), disponible pour environ 13 100 molécules. Après filtrage des valeurs non manquantes pour , vous effectuerez une séparation entraînement/validation 80/20 avec la graine aléatoire fournie dans le cahier de départ.
3. Livrables et consignes générales
Vous remettez sur Studium :
un cahier Colab,
un PDF scanné contenant les dérivations manuscrites.
Il n’y a pas de rapport écrit.
Le cahier doit s’exécuter du début à la fin sans erreur. Pour chaque modèle entraîné, vous devez fournir : les courbes de perte d’entraînement et de validation, la MSE de validation, le de validation, et l’écart entraînement-validation. À trois endroits du devoir, marqués , vous devez écrire une prédiction dans une cellule Markdown avant d’exécuter le code correspondant. L’utilisation d’outils d’IA est permise. Vous pouvez utiliser PyTorch et ses modules intégrés (nn.Linear, nn.LSTM, nn.TransformerEncoder, etc.). Il n’est pas demandé de réimplémenter ces composants.
!pip install -q rdkit-pypi torch numpy pandas matplotlib scikit-learnzsh:1: command not found: pip
# === CONFIGURATION ===
PROPRIETE = "Tc"  # Température critique (K) — même propriété pour toutes les équipes
SEED = 42
MEMBRES = ["Prénom Nom 1", "Prénom Nom 2"]
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
URL = "https://raw.githubusercontent.com/ddidacus/refgen/main/data/chedl_thermo_properties.csv"
df_raw = pd.read_csv(URL)
df = df_raw[df_raw[PROPRIETE].notna() & df_raw["SMILES"].notna()].copy()
df = df[["SMILES", PROPRIETE]].reset_index(drop=True)
df.columns = ["smiles", "target"]
train_df, val_df = train_test_split(df, test_size=0.2, random_state=SEED)
print(f"Propriété : {PROPRIETE}")
print(f"Entraînement : {len(train_df)}, Validation : {len(val_df)}")
print(f"\nStatistiques :")
print(df["target"].describe())Propriété : Tc
Entraînement : 10504, Validation : 2627
Statistiques :
count 13131.000000
mean 701.367624
std 728.866756
min 0.000000
25% 564.495000
50% 636.040000
75% 718.860000
max 21482.800000
Name: target, dtype: float64
/var/folders/kz/gmggxk812sg1jvysfbnx_y7h0000gq/T/ipykernel_50812/2704555841.py:7: DtypeWarning: Columns (0,6,11,12) have mixed types. Specify dtype option on import or set low_memory=False.
  df_raw = pd.read_csv(URL)
smiles_lengths = [len(s) for s in df["smiles"]]
unique_chars = sorted(set("".join(df["smiles"])))

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
axes[0].hist(smiles_lengths, bins=50, edgecolor="black", alpha=0.7)
axes[0].set_xlabel("Longueur du SMILES")
axes[0].set_ylabel("Nb. molécules")
axes[1].hist(df["target"], bins=50, edgecolor="black", alpha=0.7)
axes[1].set_xlabel(PROPRIETE)
axes[1].set_ylabel("Nb. molécules")
plt.tight_layout()
plt.show()

print(f"Vocabulaire ({len(unique_chars)} caractères) : {''.join(unique_chars)}")
print(f"Longueur : min={min(smiles_lengths)}, max={max(smiles_lengths)}, moy={np.mean(smiles_lengths):.0f}")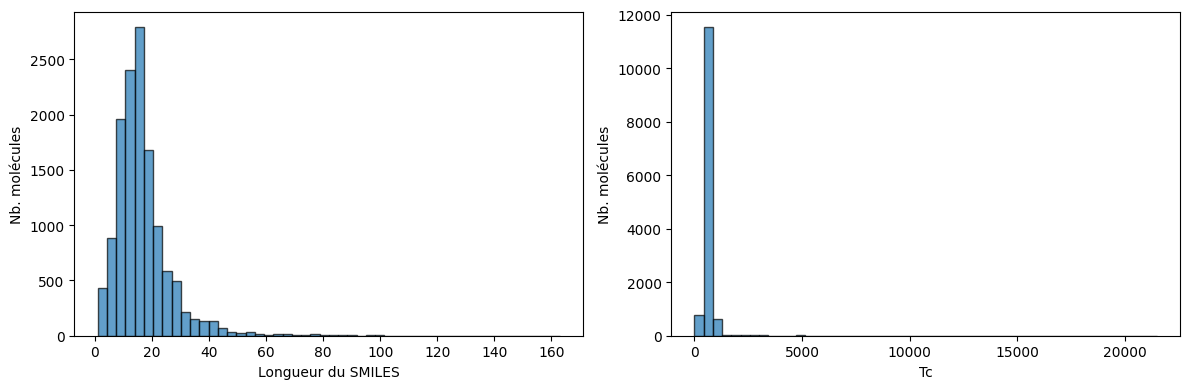
Vocabulaire (60 caractères) : #()+-./123457=@ABCDEFGHIKLMNOPRSTUVWXYZ[\]abcdefghilmnorstuy
Longueur : min=1, max=163, moy=17
def plot_learning_curves(train_losses, val_losses, title=""):
    plt.figure(figsize=(7, 4))
    plt.plot(train_losses, label="Entraînement")
    plt.plot(val_losses, label="Validation")
    plt.xlabel("Époque")
    plt.ylabel("MSE")
    if title:
        plt.title(title)
    plt.legend()
    plt.grid(True, alpha=0.3)
    plt.show()
    print(f"Écart train-val : {val_losses[-1] - train_losses[-1]:.4f}")
Partie 1 — MLP et entraînement (Ch. 7-8)
1.1 Caractéristiques fixes et MLP
Chaque chaîne SMILES encode la structure d’une molécule sous forme de texte. Par exemple, CCO représente l’éthanol et c1ccccc1 le benzène. Vous n’avez pas besoin de connaissances en chimie pour ce devoir : il suffit de traiter les SMILES comme des chaînes de caractères. La fonction smiles_to_features ci-dessous convertit une chaîne SMILES en un vecteur numérique de longueur fixe. Cette représentation compte la fréquence de chaque caractère du vocabulaire SMILES (par exemple combien de fois C, O, (, ), = apparaissent), ajoute la longueur totale de la chaîne, et inclut quelques indicatrices binaires. Entraînez un MLP à 2 couches cachées sur ces caractéristiques pour prédire .
Prédiction 1 : Avant l’entraînement, écrivez si vous pensez que ce modèle va surapprendre, et justifiez brièvement.
1.2 Comparaison d’optimiseurs
Entraînez le même MLP avec trois optimiseurs : SGD, SGD avec momentum, et Adam. Gardez la même architecture et les mêmes hyperparamètres, à l’exception de l’optimiseur. Tracez les trois courbes de perte de validation sur un même graphique.
Prédiction 2 : Avant l’expérience, écrivez quel optimiseur convergera le plus vite, et pourquoi.
1.3 Régularisation et stabilisation du gradient
Partez d’un MLP profond à 5 couches cachées et comparez les quatre configurations suivantes :
| # | Configuration |
|---|---|
| 1 | Sigmoid + initialisation par défaut |
| 2 | ReLU + initialisation He |
| 3 | Configuration 2 + BatchNorm |
| 4 | Configuration 3 + Dropout () |
Pour chaque configuration, rapportez la MSE de validation finale, la norme moyenne du gradient à la première couche cachée (moyennée sur les mini-lots du dernier epoch), et l’écart entraînement-validation.
Dérivations manuscrites (Partie 1)
Sur papier :
Dérivez les règles VJP pour l’opération , c’est-à-dire et .
Dessinez le graphe de calcul complet du MLP à 2 couches, de l’entrée jusqu’à la perte, et annotez les VJP.
# Vocabulaire : tous les caractères uniques présents dans les SMILES du jeu de données
vocab = sorted(set("".join(df["smiles"])))
char_to_idx = {c: i for i, c in enumerate(vocab)}


def smiles_to_features(smiles: str) -> np.ndarray:
    """Convertit une chaîne SMILES en vecteur de caractéristiques de longueur fixe.

    Le vecteur contient :
      - la fréquence de chaque caractère du vocabulaire (taille = len(vocab)),
      - la longueur de la chaîne SMILES.
    """
    counts = np.zeros(len(vocab), dtype=np.float32)
    for c in smiles:
        if c in char_to_idx:
            counts[char_to_idx[c]] += 1
    length = np.array([len(smiles)], dtype=np.float32)
    return np.concatenate([counts, length])


# Construire les matrices de caractéristiques
X_train = np.stack([smiles_to_features(s) for s in train_df["smiles"]])
X_val = np.stack([smiles_to_features(s) for s in val_df["smiles"]])
y_train = train_df["target"].values.astype(np.float32)
y_val = val_df["target"].values.astype(np.float32)

print(f"X_train : {X_train.shape}  (nb. molécules × nb. caractéristiques)")
print(f"X_val   : {X_val.shape}")
print(f"Caractéristiques par molécule : {X_train.shape[1]} ({len(vocab)} fréquences de caractères + 1 longueur)")
X_train : (10504, 61) (nb. molécules × nb. caractéristiques)
X_val : (2627, 61)
Caractéristiques par molécule : 61 (60 fréquences de caractères + 1 longueur)
Partie 2 — Modèles séquentiels et attention (Ch. 9-10)
2.1 LSTM
Implémentez en PyTorch le pipeline suivant :
SMILES → plongement de caractères → LSTM → état final → couche linéaire → prédictionUtilisez une gestion correcte des séquences de longueurs variables. Si vous utilisez du remplissage (padding), vos agrégations et vos masques doivent ignorer les positions de remplissage.
Prédiction 3 : Avant l’entraînement, écrivez si vous pensez que le LSTM fera mieux que le MLP en validation, et justifiez brièvement.
2.2 Calcul d’attention à la main (dérivation manuscrite)
Considérez le SMILES CCO avec et . Les matrices de projection sont :
Les plongements sont des vecteurs colonnes, et la convention est , , . De manière équivalente, si l’on empile les plongements comme lignes d’une matrice , alors , , . Les trois plongements sont :
Calculez à la main : (1) les matrices , et , (2) les scores d’attention , (3) les poids après softmax, (4) la sortie finale de la couche d’attention.
2.3 Transformeur encodeur
Implémentez un transformeur encodeur pour la prédiction de avec : un plongement caractère par caractère, un encodage positionnel sinusoïdal, 2 couches de transformeur, une agrégation par moyenne sur les positions non remplies, et une couche linéaire finale.
2.4 Tableau comparatif
| Modèle | MSE val | val | Nb. paramètres | Écart train-val |
|---|---|---|---|---|
| MLP | ||||
| LSTM | ||||
| Transformeur |
Partie 3 — Apprentissage par transfert (Ch. 10 + synthèse)
3.1 Plongements SMI-TED
Chargez le modèle pré-entraîné SMI-TED à partir du code fourni ci-dessous, puis extrayez un plongement de dimension 768 pour chaque molécule. Visualisez ces plongements en 2D en utilisant sklearn.decomposition.PCA ou sklearn.manifold.TSNE, colorés par la valeur de .
3.2 Sonde linéaire
Gelez SMI-TED et entraînez uniquement une couche linéaire sur les plongements extraits pour prédire .
3.3 Courbe d’efficacité en échantillons
Tracez sur un même graphique la MSE de validation en fonction de la taille d’entraînement (10%, 25%, 50%, 100%) pour les quatre modèles : MLP, LSTM, transformeur, SMI-TED + sonde linéaire. Pour cette section, réutilisez la meilleure configuration choisie à 100% des données, gardez un même budget d’époques pour tous les sous-ensembles, et ne faites pas de nouvel ajustement d’hyperparamètres. Cette figure est la figure centrale du devoir.
Complétez aussi le tableau final, à 100% des données :
| Modèle | MSE val | val | Nb. paramètres | Écart train-val |
|---|---|---|---|---|
| MLP | ||||
| LSTM | ||||
| Transformeur | ||||
| SMI-TED + sonde linéaire |
4. Évaluation
Cahier Colab (75%)
| Élément | Points |
|---|---|
| Le cahier s’exécute sans erreur | 5 |
| 1.1 : MLP fonctionnel + courbes d’apprentissage | 10 |
| 1.2 : comparaison des optimiseurs | 5 |
| 1.3 : 4 configurations + tableau de résultats | 10 |
| 2.1 : LSTM fonctionnel + courbes | 10 |
| 2.3 : transformeur fonctionnel + courbes | 10 |
| 2.4 : tableau comparatif rempli | 5 |
| 3.1 : plongements SMI-TED + visualisation 2D | 5 |
| 3.2 : sonde linéaire fonctionnelle + courbes | 5 |
| 3.3 : courbe d’efficacité en échantillons | 5 |
| 3 prédictions présentes en cellules Markdown | 5 |
| Total | 75 |
Dérivations manuscrites (25%)
| Élément | Points |
|---|---|
| VJP de | 8 |
| Graphe de calcul du MLP annoté avec les VJP | 5 |
| Calcul d’attention à la main | 12 |
| Total | 25 |
Chargement de SMI-TED
SMI-TED est un modèle de fondation pré-entraîné sur 91 millions de molécules.
import os, sys, torch

# Cloner le dépôt et installer les dépendances
!git clone --depth 1 https://github.com/IBM/materials.git /tmp/materials 2>/dev/null || true
!pip install -q pytorch-fast-transformers torch-optimizer huggingface_hub

# Télécharger les poids
SMI_TED_DIR = "/tmp/materials/models/smi_ted/inference/smi_ted_light"
if not os.path.exists(os.path.join(SMI_TED_DIR, "smi_ted_light.pt")):
    from huggingface_hub import hf_hub_download
    hf_hub_download(repo_id="ibm-research/materials.smi-ted",
                    filename="smi_ted_light.pt", local_dir=SMI_TED_DIR)

# Charger le modèle
sys.path.insert(0, "/tmp/materials/models/smi_ted/inference")
from load import load_smi_ted

smi_ted = load_smi_ted(folder=SMI_TED_DIR, ckpt_filename="smi_ted_light.pt")
smi_ted.eval()

# Test rapide
with torch.no_grad():
    test_emb = smi_ted.encode(["CCO", "c1ccccc1"], return_torch=True)
print(f"Plongements : {test_emb.shape}")  # (2, 768)
zsh:1: command not found: pip
/Users/pierre-luc.bacon/Documents/mlbook/.venv/lib/python3.12/site-packages/tqdm/auto.py:21: TqdmWarning: IProgress not found. Please update jupyter and ipywidgets. See https://ipywidgets.readthedocs.io/en/stable/user_install.html
  from .autonotebook import tqdm as notebook_tqdm
---------------------------------------------------------------------------
HTTPStatusError                           Traceback (most recent call last)
File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/utils/_http.py:761, in hf_raise_for_status(response, endpoint_name)
    760 try:
--> 761     response.raise_for_status()
    762 except httpx.HTTPStatusError as e:

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/httpx/_models.py:829, in Response.raise_for_status(self)
    828 message = message.format(self, error_type=error_type)
--> 829 raise HTTPStatusError(message, request=request, response=self)

HTTPStatusError: Client error '404 Not Found' for url 'https://huggingface.co/ibm-research/materials.smi-ted/resolve/main/smi_ted_light.pt'
For more information check: https://developer.mozilla.org/en-US/docs/Web/HTTP/Status/404

The above exception was the direct cause of the following exception:

RemoteEntryNotFoundError                  Traceback (most recent call last)
Cell In[7], line 11
      9 if not os.path.exists(os.path.join(SMI_TED_DIR, "smi_ted_light.pt")):
     10     from huggingface_hub import hf_hub_download
---> 11     hf_hub_download(repo_id="ibm-research/materials.smi-ted",
     12                     filename="smi_ted_light.pt", local_dir=SMI_TED_DIR)
     14 # Charger le modèle
     15 sys.path.insert(0, "/tmp/materials/models/smi_ted/inference")

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/utils/_validators.py:89, in validate_hf_hub_args.<locals>._inner_fn(*args, **kwargs)
     85         validate_repo_id(arg_value)
     87 kwargs = smoothly_deprecate_legacy_arguments(fn_name=fn.__name__, kwargs=kwargs)
---> 89 return fn(*args, **kwargs)

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/file_download.py:965, in hf_hub_download(repo_id, filename, subfolder, repo_type, revision, library_name, library_version, cache_dir, local_dir, user_agent, force_download, etag_timeout, token, local_files_only, headers, endpoint, tqdm_class, dry_run)
    956 hf_headers = build_hf_headers(
    957     token=token,
    958     library_name=library_name,
   (...)    961     headers=headers,
    962 )
    964 if local_dir is not None:
--> 965     return _hf_hub_download_to_local_dir(
    966         # Destination
    967         local_dir=local_dir,
    968         # File info
    969         repo_id=repo_id,
    970         repo_type=repo_type,
    971         filename=filename,
    972         revision=revision,
    973         # HTTP info
    974         endpoint=endpoint,
    975         etag_timeout=etag_timeout,
    976         headers=hf_headers,
    977         token=token,
    978         # Additional options
    979         cache_dir=cache_dir,
    980         force_download=force_download,
    981         local_files_only=local_files_only,
    982         tqdm_class=tqdm_class,
    983         dry_run=dry_run,
    984     )
    985 else:
    986     return _hf_hub_download_to_cache_dir(
    987         # Destination
    988         cache_dir=cache_dir,
   (...)   1003         dry_run=dry_run,
   1004     )

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/file_download.py:1274, in _hf_hub_download_to_local_dir(local_dir, repo_id, repo_type, filename, revision, endpoint, etag_timeout, headers, token, cache_dir, force_download, local_files_only, tqdm_class, dry_run)
   1271         return local_file
   1273 # Local file doesn't exist or commit_hash doesn't match => we need the etag
-> 1274 (url_to_download, etag, commit_hash, expected_size, xet_file_data, head_call_error) = _get_metadata_or_catch_error(
   1275     repo_id=repo_id,
   1276     filename=filename,
   1277     repo_type=repo_type,
   1278     revision=revision,
   1279     endpoint=endpoint,
   1280     etag_timeout=etag_timeout,
   1281     headers=headers,
   1282     token=token,
   1283     local_files_only=local_files_only,
   1284 )
   1286 if head_call_error is not None:
   1287     # No HEAD call but local file exists => default to local file
   1288     if paths.file_path.is_file():

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/file_download.py:1653, in _get_metadata_or_catch_error(repo_id, filename, repo_type, revision, endpoint, etag_timeout, headers, token, local_files_only, relative_filename, storage_folder, retry_on_errors)
   1651 try:
   1652     try:
-> 1653         metadata = get_hf_file_metadata(
   1654             url=url,
   1655             timeout=etag_timeout,
   1656             headers=headers,
   1657             token=token,
   1658             endpoint=endpoint,
   1659             retry_on_errors=retry_on_errors,
   1660         )
   1661     except RemoteEntryNotFoundError as http_error:
   1662         if storage_folder is not None and relative_filename is not None:
   1663             # Cache the non-existence of the file

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/utils/_validators.py:89, in validate_hf_hub_args.<locals>._inner_fn(*args, **kwargs)
     85         validate_repo_id(arg_value)
     87 kwargs = smoothly_deprecate_legacy_arguments(fn_name=fn.__name__, kwargs=kwargs)
---> 89 return fn(*args, **kwargs)

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/file_download.py:1576, in get_hf_file_metadata(url, token, timeout, library_name, library_version, user_agent, headers, endpoint, retry_on_errors)
   1573 hf_headers["Accept-Encoding"] = "identity"  # prevent any compression => we want to know the real size of the file
   1575 # Retrieve metadata
-> 1576 response = _httpx_follow_relative_redirects_with_backoff(
   1577     method="HEAD", url=url, headers=hf_headers, timeout=timeout, retry_on_errors=retry_on_errors
   1578 )
   1579 hf_raise_for_status(response)
   1581 # Return

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/utils/_http.py:692, in _httpx_follow_relative_redirects_with_backoff(method, url, retry_on_errors, **httpx_kwargs)
    684 while True:
    685     response = http_backoff(
    686         method=method,
    687         url=url,
   (...)    690         **no_retry_kwargs,
    691     )
--> 692     hf_raise_for_status(response)
    694     # Check if response is a relative redirect
    695     if 300 <= response.status_code <= 399:

File ~/Documents/mlbook/.venv/lib/python3.12/site-packages/huggingface_hub/utils/_http.py:787, in hf_raise_for_status(response, endpoint_name)
    785     entry_err.repo_type = repo_type
    786     entry_err.repo_id = repo_id
--> 787     raise entry_err from e
    789 elif error_code == "GatedRepo":
    790     message = (
    791         f"{response.status_code} Client Error." + "\n\n" + f"Cannot access gated repo for url {response.url}."
    792     )

RemoteEntryNotFoundError: 404 Client Error. (Request ID: Root=1-69dd27cd-1bea18a87d48ca004452a258;92b48f49-40ca-4057-8425-ec90407f9f8b)

Entry Not Found for url: https://huggingface.co/ibm-research/materials.smi-ted/resolve/main/smi_ted_light.pt.