IFT3395/IFT6390 - Fondements de l’apprentissage machine
Compétition Kaggle: Rejoindre la compétition
Contexte
Hydro-Québec publie des données ouvertes sur la consommation électrique de clients participant à un programme de gestion de la demande. Ces données incluent la consommation horaire, les conditions météorologiques et des indicateurs d’événements de pointe.
L’objectif est de construire un modèle de prédiction de la consommation énergétique en utilisant uniquement les méthodes vues dans les chapitres 1 à 5 du cours.
Objectifs d’apprentissage
À la fin de ce projet, vous serez en mesure de:
Implémenter les moindres carrés ordinaires (OLS) à partir de zéro
Implémenter la régression logistique avec descente de gradient
Appliquer la régularisation Ridge et interpréter ses effets
Construire un modèle à deux étages: classification → régression
Utiliser les probabilités prédites comme caractéristiques
Évaluation
| Composante | Pondération | Description |
|---|---|---|
| Entrevue orale | 60% | Vérification de la compréhension |
| Code soumis | 20% | Complétion des parties 1-7 |
| Kaggle | 10% | Position au classement |
| Rapport écrit | 10% | Analyse et réflexion |
Utilisation d’outils d’assistance
Les outils comme ChatGPT, Cursor ou Copilot peuvent servir de support à l’apprentissage. Vous devez toutefois comprendre chaque ligne de code que vous soumettez. L’entrevue orale, qui représente 60% de la note, porte sur votre capacité à expliquer et à justifier votre travail. Utilisez ces outils pour approfondir votre compréhension, pas pour contourner l’apprentissage.
Partie 0: Configuration et chargement des données
Exécutez cette cellule pour importer les bibliothèques et charger les données.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression, Ridge, RidgeCV, LogisticRegression
from sklearn.metrics import mean_squared_error, r2_score, accuracy_score, classification_report
from sklearn.preprocessing import StandardScaler
import warnings
warnings.filterwarnings('ignore')

# Configuration des graphiques
plt.rcParams['figure.figsize'] = (10, 6)
plt.rcParams['font.size'] = 12
%config InlineBackend.figure_format = 'retina'

print("Configuration terminée!")
Configuration terminée!
Chargement des données
Les données proviennent du jeu de données ouvert consommation
# URLs des données sur GitHub
BASE_URL = "https://raw.githubusercontent.com/pierrelux/mlbook/main/data/"

# Charger les données
print("Chargement des données depuis GitHub...")
train = pd.read_csv(BASE_URL + "energy_train.csv", parse_dates=['horodatage_local'])

# Pour l'évaluation locale: test avec la cible (energie_kwh)
test = pd.read_csv(BASE_URL + "energy_test_avec_cible.csv", parse_dates=['horodatage_local'])

# Pour Kaggle: test sans la cible (pour générer les prédictions)
test_kaggle = pd.read_csv(BASE_URL + "energy_test.csv", parse_dates=['horodatage_local'])

print(f"Ensemble d'entraînement: {len(train)} observations")
print(f"Ensemble de test: {len(test)} observations")
print(f"\nPériode d'entraînement: {train['horodatage_local'].min()} à {train['horodatage_local'].max()}")
print(f"Période de test: {test['horodatage_local'].min()} à {test['horodatage_local'].max()}")
Chargement des données depuis GitHub...
Ensemble d'entraînement: 8246 observations
Ensemble de test: 1754 observations

Période d'entraînement: 2022-01-01 05:00:00+00:00 à 2024-01-31 21:00:00+00:00
Période de test: 2024-02-01 01:00:00+00:00 à 2024-07-01 03:00:00+00:00
# Aperçu des données
print("Colonnes disponibles:")
print(train.columns.tolist())
print(f"\nProportion événements de pointe (train): {train['evenement_pointe'].mean():.1%}")
train.head()
Colonnes disponibles:
['horodatage_local', 'poste', 'heure', 'jour', 'mois', 'jour_semaine', 'temperature_ext', 'humidite', 'vitesse_vent', 'neige', 'irradiance_solaire', 'heure_sin', 'heure_cos', 'mois_sin', 'mois_cos', 'jour_semaine_sin', 'jour_semaine_cos', 'est_weekend', 'est_ferie', 'clients_connectes', 'tstats_intelligents_connectes', 'evenement_pointe', 'energie_kwh']
Proportion événements de pointe (train): 0.9%
Description des variables
Les données contiennent des mesures météorologiques et temporelles pour prédire la consommation énergétique.
# Description des variables
print("Variables météorologiques:")
print("  - temperature_ext: Température extérieure moyenne (°C)")
print("  - humidite: Humidité relative moyenne (%)")
print("  - vitesse_vent: Vitesse du vent moyenne (km/h)")
print("  - neige: Précipitations de neige moyennes")
print("  - irradiance_solaire: Irradiance solaire moyenne")

print("\nVariables temporelles:")
print("  - heure, mois, jour, jour_semaine: Composantes temporelles")
print("  - heure_sin, heure_cos, mois_sin, mois_cos: Encodage cyclique")
print("  - est_weekend, est_ferie: Indicateurs binaires")

print("\nAutres:")
print("  - evenement_pointe: Indicateur d'événement de pointe (classification)")
print("  - energie_kwh: Variable cible (consommation en kWh)")

print(f"\nStatistiques de base:")
train[['temperature_ext', 'humidite', 'energie_kwh']].describe()
Variables météorologiques:
- temperature_ext: Température extérieure moyenne (°C)
- humidite: Humidité relative moyenne (%)
- vitesse_vent: Vitesse du vent moyenne (km/h)
- neige: Précipitations de neige moyennes
- irradiance_solaire: Irradiance solaire moyenne
Variables temporelles:
- heure, mois, jour, jour_semaine: Composantes temporelles
- heure_sin, heure_cos, mois_sin, mois_cos: Encodage cyclique
- est_weekend, est_ferie: Indicateurs binaires
Autres:
- evenement_pointe: Indicateur d'événement de pointe (classification)
- energie_kwh: Variable cible (consommation en kWh)
Statistiques de base:
# Division temporelle déjà effectuée
# Les données de test couvrent la période à partir du 1er février 2024.
# Ne pas mélanger les données: c'est une série temporelle.

print("Division temporelle")
print("Les ensembles train/test sont déjà séparés chronologiquement.")
print("N'utilisez pas de validation croisée aléatoire (fuite d'information).")
print("\nPour la validation, utilisez une division temporelle sur train:")
print("  - Ex: train[:6000] pour entraînement, train[6000:] pour validation")

# Il y a un décalage de distribution entre train (hiver) et test (printemps/été).
# Pensez à utiliser des caractéristiques qui généralisent bien.
print("\nDécalage de distribution:")
print(f"  Train: {train['energie_kwh'].mean():.1f} kWh (hiver)")
print(f"  Test:  {test['energie_kwh'].mean():.1f} kWh (printemps/été)")
print("  Le modèle doit généraliser à travers les saisons.")
Division temporelle
Les ensembles train/test sont déjà séparés chronologiquement.
N'utilisez pas de validation croisée aléatoire (fuite d'information).
Pour la validation, utilisez une division temporelle sur train:
- Ex: train[:6000] pour entraînement, train[6000:] pour validation
Décalage de distribution:
Train: 215.9 kWh (hiver)
Test: 83.7 kWh (printemps/été)
Le modèle doit généraliser à travers les saisons.
Exploration visuelle
fig, axes = plt.subplots(2, 2, figsize=(12, 10))

# Consommation vs température
axes[0, 0].scatter(train['temperature_ext'], train['energie_kwh'], alpha=0.3, s=5)
axes[0, 0].set_xlabel('Température (°C)')
axes[0, 0].set_ylabel('Énergie consommée (kWh)')
axes[0, 0].set_title('Consommation vs Température')

# Distribution de la consommation
axes[0, 1].hist(train['energie_kwh'], bins=50, edgecolor='black', alpha=0.7)
axes[0, 1].set_xlabel('Énergie (kWh)')
axes[0, 1].set_ylabel('Fréquence')
axes[0, 1].set_title('Distribution de la consommation')

# Profil horaire
profil_horaire = train.groupby('heure')['energie_kwh'].mean()
axes[1, 0].bar(profil_horaire.index, profil_horaire.values)
axes[1, 0].set_xlabel('Heure')
axes[1, 0].set_ylabel('Énergie moyenne (kWh)')
axes[1, 0].set_title('Profil de consommation horaire')

# Événements de pointe par heure
pointe_horaire = train.groupby('heure')['evenement_pointe'].mean()
axes[1, 1].bar(pointe_horaire.index, pointe_horaire.values)
axes[1, 1].set_xlabel('Heure')
axes[1, 1].set_ylabel('Proportion événements de pointe')
axes[1, 1].set_title('Fréquence des événements de pointe')

plt.tight_layout()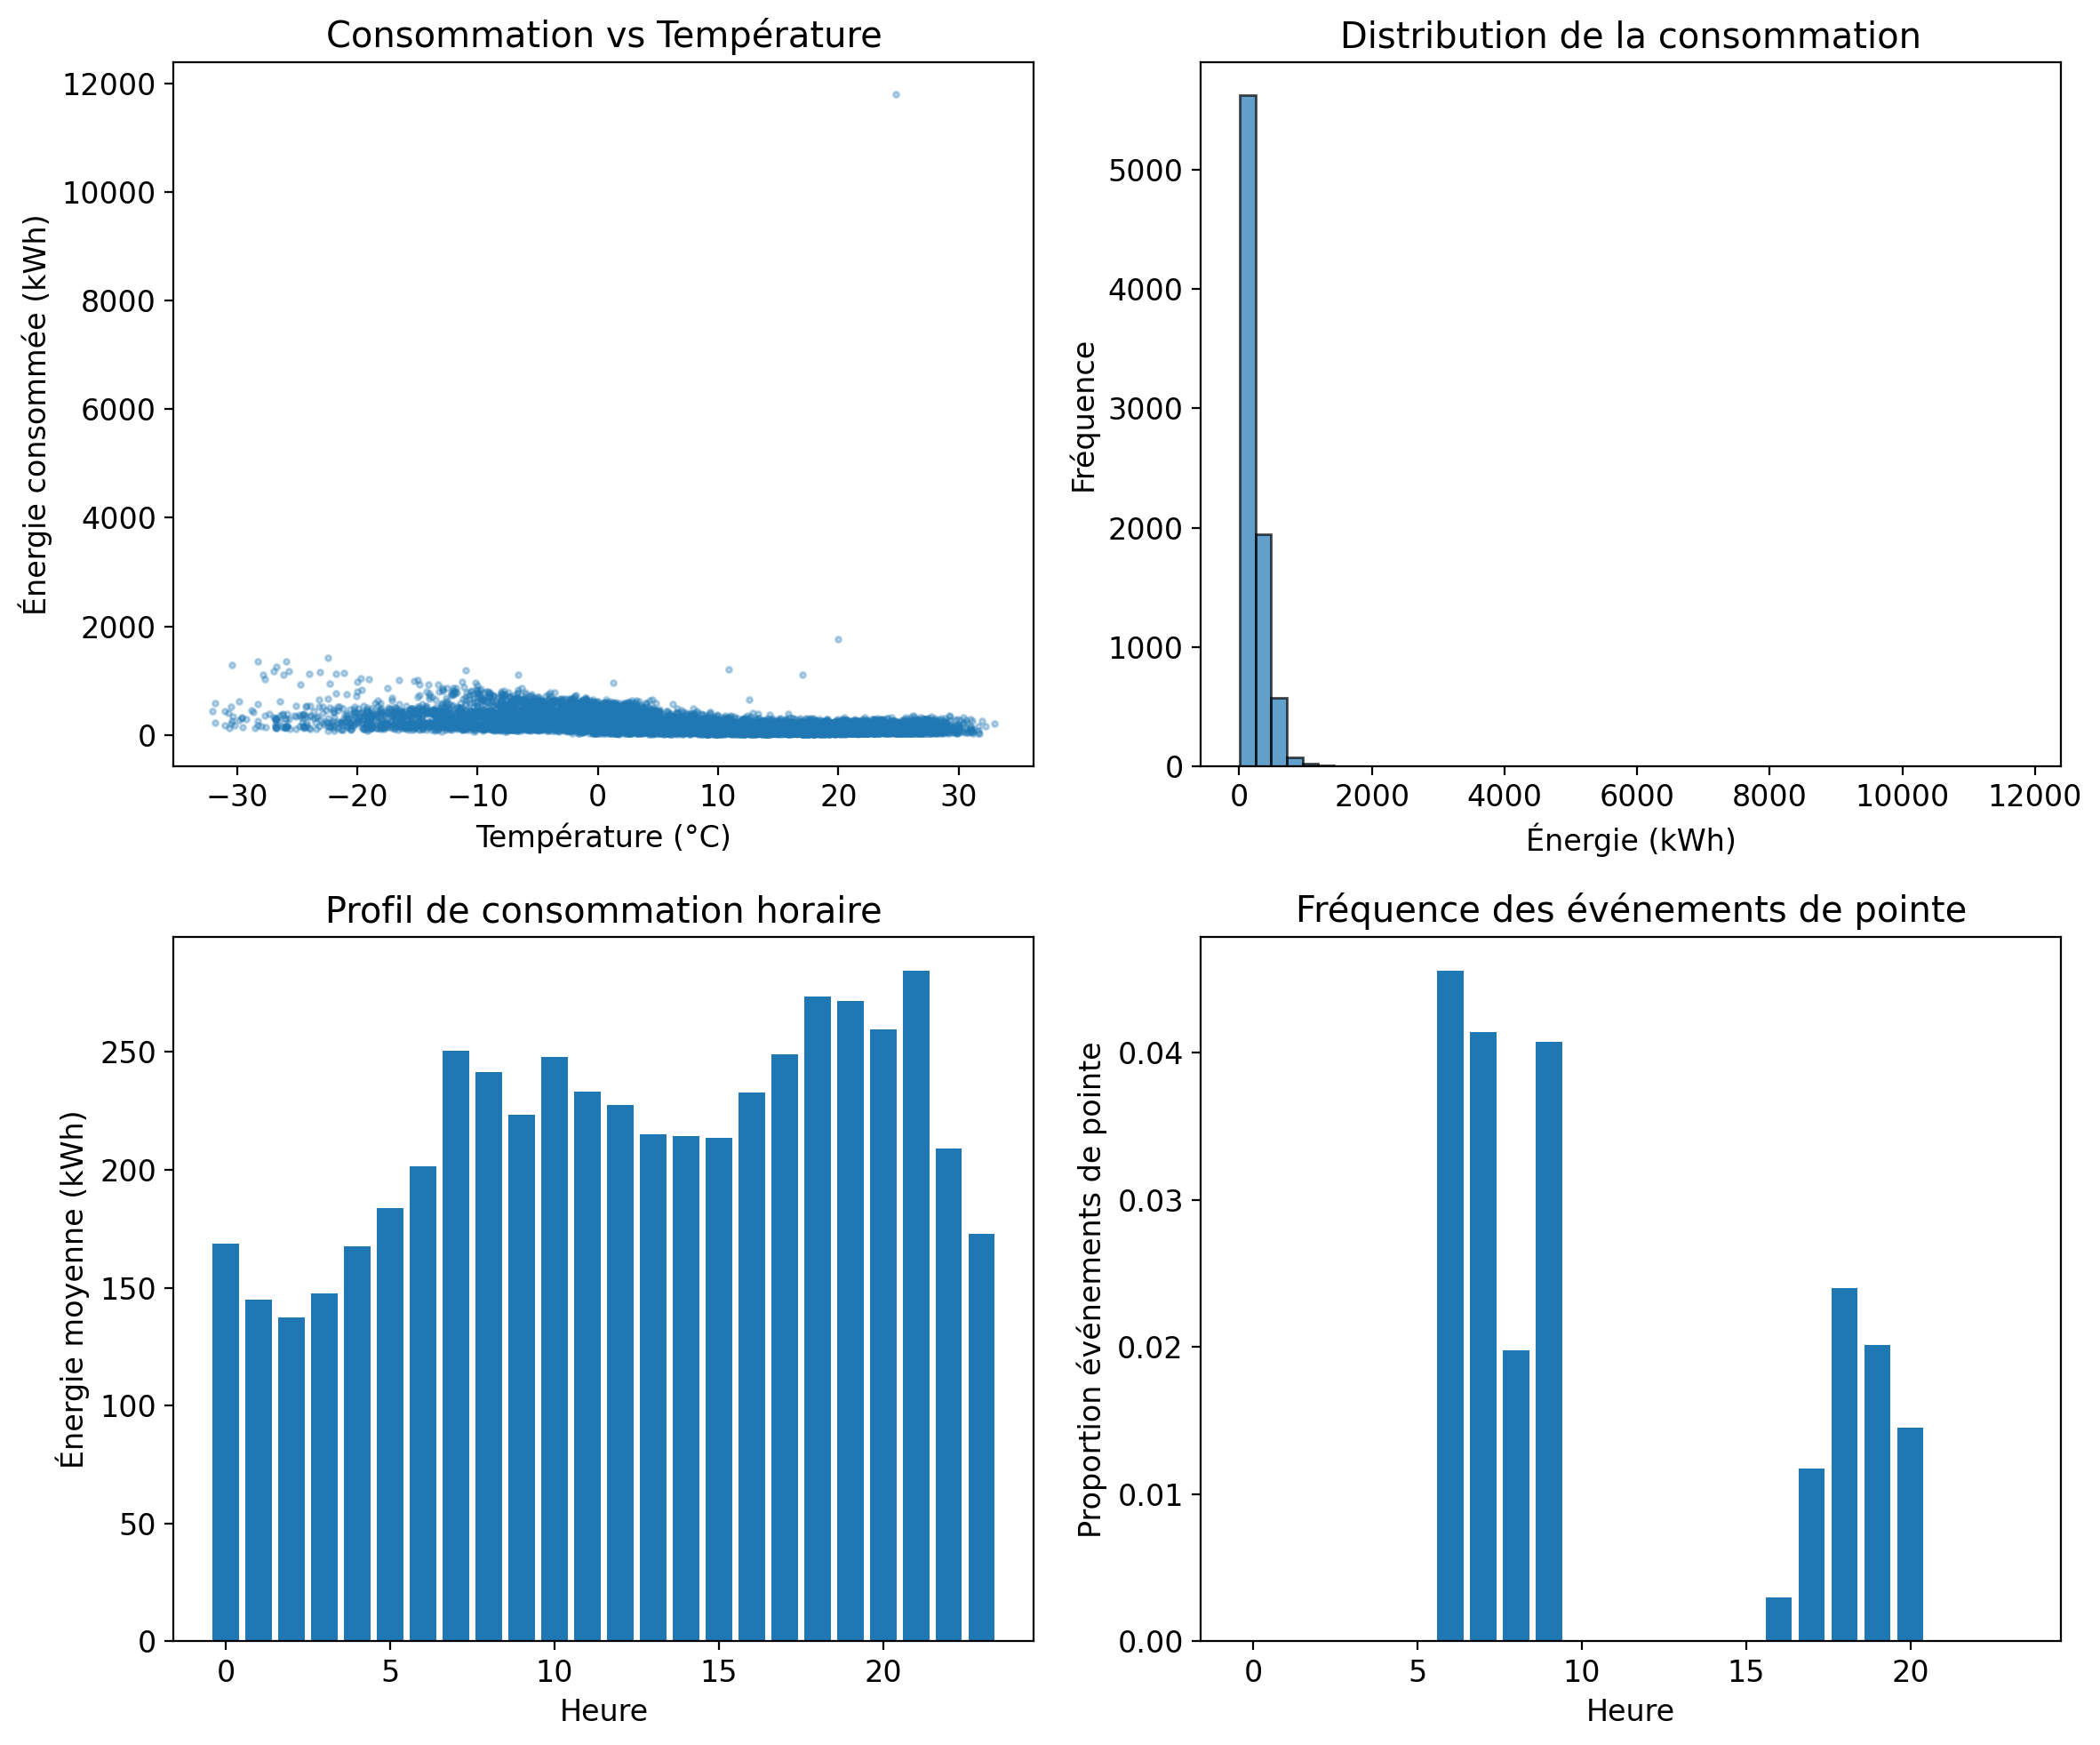
Partie 1: Implémentation OLS (10%)
Avant d’utiliser scikit-learn, implémentez la solution analytique des moindres carrés ordinaires. La solution OLS est donnée par:
Pour des raisons de stabilité numérique, préférez np.linalg.solve à l’inversion directe.
def ols_fit(X, y):
    """
    Calcule les coefficients OLS.

    Paramètres:
        X : ndarray de forme (n, p) - matrice de caractéristiques (SANS colonne de 1)
        y : ndarray de forme (n,) - vecteur cible

    Retourne:
        beta : ndarray de forme (p+1,) - coefficients [intercept, coef1, coef2, ...]

    Indice: Ajoutez une colonne de 1 à X pour l'intercept.
    """
    # VOTRE CODE ICI
    # 1. Ajouter une colonne de 1 pour l'intercept
    # 2. Résoudre le système X^T X beta = X^T y
    # 3. Retourner beta
    pass


def ols_predict(X, beta):
    """
    Prédit avec les coefficients OLS.

    Paramètres:
        X : ndarray de forme (n, p) - caractéristiques (SANS colonne de 1)
        beta : ndarray de forme (p+1,) - coefficients [intercept, coef1, ...]

    Retourne:
        y_pred : ndarray de forme (n,)
    """
    # VOTRE CODE ICI
    pass
# Test de votre implémentation
# Caractéristiques simples pour commencer
features_base = ['temperature_ext', 'humidite', 'vitesse_vent']
X_train_base = train[features_base].values
y_train = train['energie_kwh'].values
X_test_base = test[features_base].values
y_test = test['energie_kwh'].values
# Votre implémentation
beta_ols = ols_fit(X_train_base, y_train)
y_pred_ols = ols_predict(X_test_base, beta_ols) if beta_ols is not None else None
# Validation avec sklearn
model_sklearn = LinearRegression()
model_sklearn.fit(X_train_base, y_train)
y_pred_sklearn = model_sklearn.predict(X_test_base)
# Comparaison (s'affiche une fois ols_fit et ols_predict implémentés)
if beta_ols is not None and y_pred_ols is not None:
print("Comparaison OLS implémenté vs sklearn:")
print(f" Intercept - Vous: {beta_ols[0]:.4f}, sklearn: {model_sklearn.intercept_:.4f}")
print(f" Coefficients proches: {np.allclose(beta_ols[1:], model_sklearn.coef_, atol=1e-4)}")
print(f"\nR² sur test: {r2_score(y_test, y_pred_ols):.4f}")
else:
print("Complétez ols_fit et ols_predict (Partie 1) pour voir la comparaison.")Complétez ols_fit et ols_predict (Partie 1) pour voir la comparaison.
Partie 2: Régression logistique avec descente de gradient (15%)
Implémentez la régression logistique pour la classification binaire. Les expressions suivantes seront utiles:
Fonction sigmoïde:
Perte d’entropie croisée:
Gradient:
def sigmoid(z):
    """
    Fonction sigmoïde.

    Indice: Pour la stabilité numérique, clip z entre -500 et 500.
    """
    # VOTRE CODE ICI
    pass


def cross_entropy_loss(y_true, y_pred_proba):
    """
    Calcule la perte d'entropie croisée binaire.

    Indice: Clip les probabilités pour éviter log(0).
    """
    # VOTRE CODE ICI
    pass


def logistic_gradient(X, y, beta):
    """
    Calcule le gradient de la perte d'entropie croisée.

    Paramètres:
        X : ndarray (n, p+1) - caractéristiques AVEC colonne de 1
        y : ndarray (n,) - étiquettes binaires
        beta : ndarray (p+1,) - coefficients actuels

    Retourne:
        gradient : ndarray (p+1,)
    """
    # VOTRE CODE ICI
    pass


def logistic_fit_gd(X, y, lr=0.1, n_iter=1000, verbose=False):
    """
    Entraîne la régression logistique par descente de gradient.

    Paramètres:
        X : ndarray (n, p) - caractéristiques SANS colonne de 1
        y : ndarray (n,) - étiquettes binaires (0 ou 1)
        lr : float - taux d'apprentissage
        n_iter : int - nombre d'itérations
        verbose : bool - afficher la progression

    Retourne:
        beta : ndarray (p+1,) - coefficients [intercept, coef1, ...]
        losses : list - historique des pertes
    """
    # VOTRE CODE ICI
    # 1. Ajouter colonne de 1 à X
    # 2. Initialiser beta à zéro
    # 3. Boucle de descente de gradient
    # 4. Retourner beta et historique des pertes
    return None, []  # Remplacer par votre implémentation


def logistic_predict_proba(X, beta):
    """
    Retourne les probabilités P(Y=1|X).
    """
    # VOTRE CODE ICI
    return None  # Remplacer par votre implémentation
# Test sur la prédiction des événements de pointe
# Caractéristiques pour classification
features_clf = ['temperature_ext', 'heure_sin', 'heure_cos', 'est_weekend']
X_train_clf = train[features_clf].values
y_train_clf = train['evenement_pointe'].values
X_test_clf = test[features_clf].values
y_test_clf = test['evenement_pointe'].values
# Normaliser (recommandé pour la descente de gradient)
scaler = StandardScaler()
X_train_clf_scaled = scaler.fit_transform(X_train_clf)
X_test_clf_scaled = scaler.transform(X_test_clf)
# Entraîner votre modèle
beta_log, losses = logistic_fit_gd(X_train_clf_scaled, y_train_clf, lr=0.1, n_iter=500, verbose=True)
# Tracer la courbe de convergence (s'affiche une fois logistic_fit_gd implémenté)
if beta_log is not None and losses:
plt.figure(figsize=(8, 5))
plt.plot(losses)
plt.xlabel('Itération')
plt.ylabel('Perte (entropie croisée)')
plt.title('Convergence de la descente de gradient')
plt.grid(True, alpha=0.3)
plt.tight_layout()
else:
print("Complétez logistic_fit_gd (Partie 2) pour voir la courbe de convergence.")Complétez logistic_fit_gd (Partie 2) pour voir la courbe de convergence.
# Évaluation (s'affiche une fois logistic_predict_proba implémenté)
proba_train = logistic_predict_proba(X_train_clf_scaled, beta_log) if beta_log is not None else None
proba_test = logistic_predict_proba(X_test_clf_scaled, beta_log) if beta_log is not None else None

if proba_train is not None and proba_test is not None:
    y_pred_train = (proba_train >= 0.5).astype(int)
    y_pred_test = (proba_test >= 0.5).astype(int)
    print("Évaluation de votre régression logistique:")
    print(f"  Accuracy (train): {accuracy_score(y_train_clf, y_pred_train):.4f}")
    print(f"  Accuracy (test): {accuracy_score(y_test_clf, y_pred_test):.4f}")
    print(f"\nRapport de classification (test):")
    print(classification_report(y_test_clf, y_pred_test, target_names=['Normal', 'Pointe']))
else:
    print("Complétez logistic_fit_gd et logistic_predict_proba (Partie 2) pour voir l'évaluation.")
Complétez logistic_fit_gd et logistic_predict_proba (Partie 2) pour voir l'évaluation.
Partie 3: Ingénierie des caractéristiques (15%)
À partir de maintenant, vous pouvez utiliser scikit-learn.
Créez des caractéristiques temporelles pour améliorer le modèle de régression. Implémentez au moins trois nouvelles caractéristiques parmi les suivantes:
Retards (lags): consommation aux heures précédentes
Statistiques glissantes: moyenne mobile, écart-type mobile
Interactions: température × heure, etc.
def creer_caracteristiques(df):
    """
    Crée des caractéristiques supplémentaires.

    VOUS DEVEZ IMPLÉMENTER AU MOINS 3 NOUVELLES CARACTÉRISTIQUES.

    Idées:
    - Retards: df['energie_kwh'].shift(1), shift(24)
    - Moyennes mobiles: df['energie_kwh'].rolling(6).mean()
    - Interactions: df['temperature_ext'] * df['heure_cos']
    - Degré-jours de chauffage: np.maximum(18 - df['temperature_ext'], 0)
    """
    df = df.copy()

    # VOTRE CODE ICI
    # Exemple:
    # df['energie_lag1'] = df['energie_kwh'].shift(1)
    # df['energie_rolling_6h'] = df['energie_kwh'].rolling(6).mean()
    # df['temp_heure_interaction'] = df['temperature_ext'] * df['heure_cos']

    return df

# Appliquer aux données
train_eng = creer_caracteristiques(train)
test_eng = creer_caracteristiques(test)

# Supprimer les lignes avec NaN (dues aux retards)
train_eng = train_eng.dropna()
test_eng = test_eng.dropna()

print(f"Nouvelles colonnes: {[c for c in train_eng.columns if c not in train.columns]}")
Nouvelles colonnes: []
Partie 4: Régression Ridge (15%)
Avec plusieurs caractéristiques corrélées, la régularisation devient utile.
Entraînez un modèle Ridge avec validation croisée pour choisir λ
Comparez les performances avec OLS
Analysez comment les coefficients changent
# Définissez vos caractéristiques pour la régression
# MODIFIEZ CETTE LISTE selon vos caractéristiques créées en Partie 3
# IMPORTANT: clients_connectes est une variable très importante!
features_reg = [
    'temperature_ext', 'humidite', 'vitesse_vent', 'irradiance_solaire',
    'heure_sin', 'heure_cos', 'mois_sin', 'mois_cos',
    'jour_semaine_sin', 'jour_semaine_cos',
    'est_weekend', 'est_ferie',
    'clients_connectes',  # Ne pas oublier!
    # Ajoutez vos caractéristiques ici
]

# Vérifier que toutes les colonnes existent
features_disponibles = [f for f in features_reg if f in train_eng.columns]
print(f"Caractéristiques utilisées: {len(features_disponibles)}")

X_train_reg = train_eng[features_disponibles].values
y_train_reg = train_eng['energie_kwh'].values
X_test_reg = test_eng[features_disponibles].values
y_test_reg = test_eng['energie_kwh'].values
Caractéristiques utilisées: 13
# Modèle OLS (baseline)
model_ols = LinearRegression()
model_ols.fit(X_train_reg, y_train_reg)
y_pred_ols = model_ols.predict(X_test_reg)

print("OLS (baseline):")
print(f"  R² train: {model_ols.score(X_train_reg, y_train_reg):.4f}")
print(f"  R² test:  {r2_score(y_test_reg, y_pred_ols):.4f}")
print(f"  RMSE test: {np.sqrt(mean_squared_error(y_test_reg, y_pred_ols)):.4f}")
OLS (baseline):
R² train: 0.4161
R² test: -0.1887
RMSE test: 77.1386
# Modèle Ridge avec validation croisée
# ATTENTION: Utilisez TimeSeriesSplit pour les données temporelles!
from sklearn.model_selection import TimeSeriesSplit

alphas = [0.01, 0.1, 1, 10, 100, 1000]
tscv = TimeSeriesSplit(n_splits=5)

model_ridge = RidgeCV(alphas=alphas, cv=tscv)
model_ridge.fit(X_train_reg, y_train_reg)
y_pred_ridge = model_ridge.predict(X_test_reg)

print(f"\nRidge (λ={model_ridge.alpha_}):")
print(f"  R² train: {model_ridge.score(X_train_reg, y_train_reg):.4f}")
print(f"  R² test:  {r2_score(y_test_reg, y_pred_ridge):.4f}")
print(f"  RMSE test: {np.sqrt(mean_squared_error(y_test_reg, y_pred_ridge)):.4f}")
Ridge (λ=10.0):
  R² train: 0.4161
  R² test:  -0.1866
  RMSE test: 77.0723
# Comparaison des coefficients OLS vs Ridge
coef_comparison = pd.DataFrame({
    'Caractéristique': features_disponibles,
    'OLS': model_ols.coef_,
    'Ridge': model_ridge.coef_
})
coef_comparison['Réduction (%)'] = 100 * (1 - np.abs(coef_comparison['Ridge']) / (np.abs(coef_comparison['OLS']) + 1e-8))
coef_comparison = coef_comparison.sort_values('Réduction (%)', ascending=False)

print("\nComparaison des coefficients (triés par réduction):")
print(coef_comparison.to_string(index=False))
Comparaison des coefficients (triés par réduction):
   Caractéristique        OLS      Ridge  Réduction (%)
         est_ferie -10.498781 -10.016488       4.593802
  jour_semaine_cos  -3.136453  -3.082637       1.715824
       est_weekend   8.083972   7.952331       1.628420
      vitesse_vent  -2.924080  -2.897416       0.911872
irradiance_solaire  -0.069055  -0.068608       0.648261
  jour_semaine_sin  -3.280503  -3.261359       0.583578
          mois_sin  22.716187  22.596071       0.528770
         heure_cos -48.703387 -48.476880       0.465075
          mois_cos   7.159748   7.133957       0.360228
         heure_sin -48.613781 -48.467696       0.300502
 clients_connectes   3.438050   3.437915       0.003930
   temperature_ext  -6.846071  -6.851905      -0.085222
          humidite  -0.394986  -0.397192      -0.558544
Questions de réflexion:
Pourquoi Ridge aide-t-il quand les caractéristiques sont corrélées?
Quelle caractéristique a été la plus réduite? Pourquoi?
Comment interpréter Ridge comme estimation MAP?
Partie 5: Sous-tâche de classification (15%)
Entraînez un classifieur pour prédire les événements de pointe, puis utilisez la probabilité prédite comme caractéristique pour la régression.
Étapes:
Entraîner LogisticRegression sur
evenement_pointeExtraire
P(pointe)pour chaque observationAjouter cette probabilité comme caractéristique pour Ridge
# Caractéristiques pour la classification
# Utilisez des caractéristiques qui ne "trichent" pas (pas de consommation passée pour prédire la pointe)
features_pointe = ['temperature_ext', 'humidite', 'vitesse_vent', 'heure_sin', 'heure_cos', 'est_weekend', 'clients_connectes']

X_train_pointe = train_eng[features_pointe].values
y_train_pointe = train_eng['evenement_pointe'].values
X_test_pointe = test_eng[features_pointe].values
y_test_pointe = test_eng['evenement_pointe'].values

# Entraîner le classifieur
clf_pointe = LogisticRegression(max_iter=1000)
clf_pointe.fit(X_train_pointe, y_train_pointe)

# Évaluation
print("Classification des événements de pointe:")
print(f"  Accuracy (train): {clf_pointe.score(X_train_pointe, y_train_pointe):.4f}")
print(f"  Accuracy (test): {clf_pointe.score(X_test_pointe, y_test_pointe):.4f}")
Classification des événements de pointe:
Accuracy (train): 0.9902
Accuracy (test): 0.9840
# Extraire les probabilités
train_eng['P_pointe'] = clf_pointe.predict_proba(X_train_pointe)[:, 1]
test_eng['P_pointe'] = clf_pointe.predict_proba(X_test_pointe)[:, 1]

print(f"Distribution de P(pointe):")
print(f"  Train: moyenne={train_eng['P_pointe'].mean():.3f}, std={train_eng['P_pointe'].std():.3f}")
print(f"  Test:  moyenne={test_eng['P_pointe'].mean():.3f}, std={test_eng['P_pointe'].std():.3f}")
Distribution de P(pointe):
Train: moyenne=0.009, std=0.034
Test: moyenne=0.003, std=0.014
Question de réflexion: Pourquoi utiliser P(pointe) au lieu d’un indicateur 0/1?
Partie 6: Modèle combiné (10%)
Assemblez le modèle final en ajoutant P_pointe comme caractéristique.
# Caractéristiques finales (avec P_pointe)
features_final = features_disponibles + ['P_pointe']

X_train_final = train_eng[features_final].values
y_train_final = train_eng['energie_kwh'].values
X_test_final = test_eng[features_final].values
y_test_final = test_eng['energie_kwh'].values

# Modèle Ridge final
model_final = RidgeCV(alphas=[0.1, 1, 10, 100], cv=TimeSeriesSplit(n_splits=5))
model_final.fit(X_train_final, y_train_final)
y_pred_final = model_final.predict(X_test_final)

print("Modèle final (Ridge + P_pointe):")
print(f"  λ sélectionné: {model_final.alpha_}")
print(f"  R² train: {model_final.score(X_train_final, y_train_final):.4f}")
print(f"  R² test:  {r2_score(y_test_final, y_pred_final):.4f}")
print(f"  RMSE test: {np.sqrt(mean_squared_error(y_test_final, y_pred_final)):.4f}")
Modèle final (Ridge + P_pointe):
λ sélectionné: 10.0
R² train: 0.4246
R² test: -0.1665
RMSE test: 76.4167
# Comparaison: avec vs sans P_pointe
print("\n=== Récapitulatif ===")
print(f"OLS baseline:     R² = {r2_score(y_test_reg, y_pred_ols):.4f}")
print(f"Ridge:            R² = {r2_score(y_test_reg, y_pred_ridge):.4f}")
print(f"Ridge + P_pointe: R² = {r2_score(y_test_final, y_pred_final):.4f}")
print(f"\nAmélioration due à P_pointe: +{100*(r2_score(y_test_final, y_pred_final) - r2_score(y_test_reg, y_pred_ridge)):.2f}%")
=== Récapitulatif ===
OLS baseline:     R² = -0.1887
Ridge:            R² = -0.1866
Ridge + P_pointe: R² = -0.1665

Amélioration due à P_pointe: +2.01%
# Visualisation des résidus
residus = y_test_final - y_pred_final

fig, axes = plt.subplots(1, 2, figsize=(12, 5))

# Histogramme des résidus
axes[0].hist(residus, bins=50, edgecolor='black', alpha=0.7)
axes[0].axvline(0, color='red', linestyle='--', label='Zéro')
axes[0].set_xlabel('Résidu')
axes[0].set_ylabel('Fréquence')
axes[0].set_title('Distribution des résidus')
axes[0].legend()

# Prédictions vs réel
axes[1].scatter(y_test_final, y_pred_final, alpha=0.3, s=5)
axes[1].plot([y_test_final.min(), y_test_final.max()],
             [y_test_final.min(), y_test_final.max()], 'r--', label='Parfait')
axes[1].set_xlabel('Énergie réelle (kWh)')
axes[1].set_ylabel('Énergie prédite (kWh)')
axes[1].set_title('Prédictions vs Réel')
axes[1].legend()

plt.tight_layout()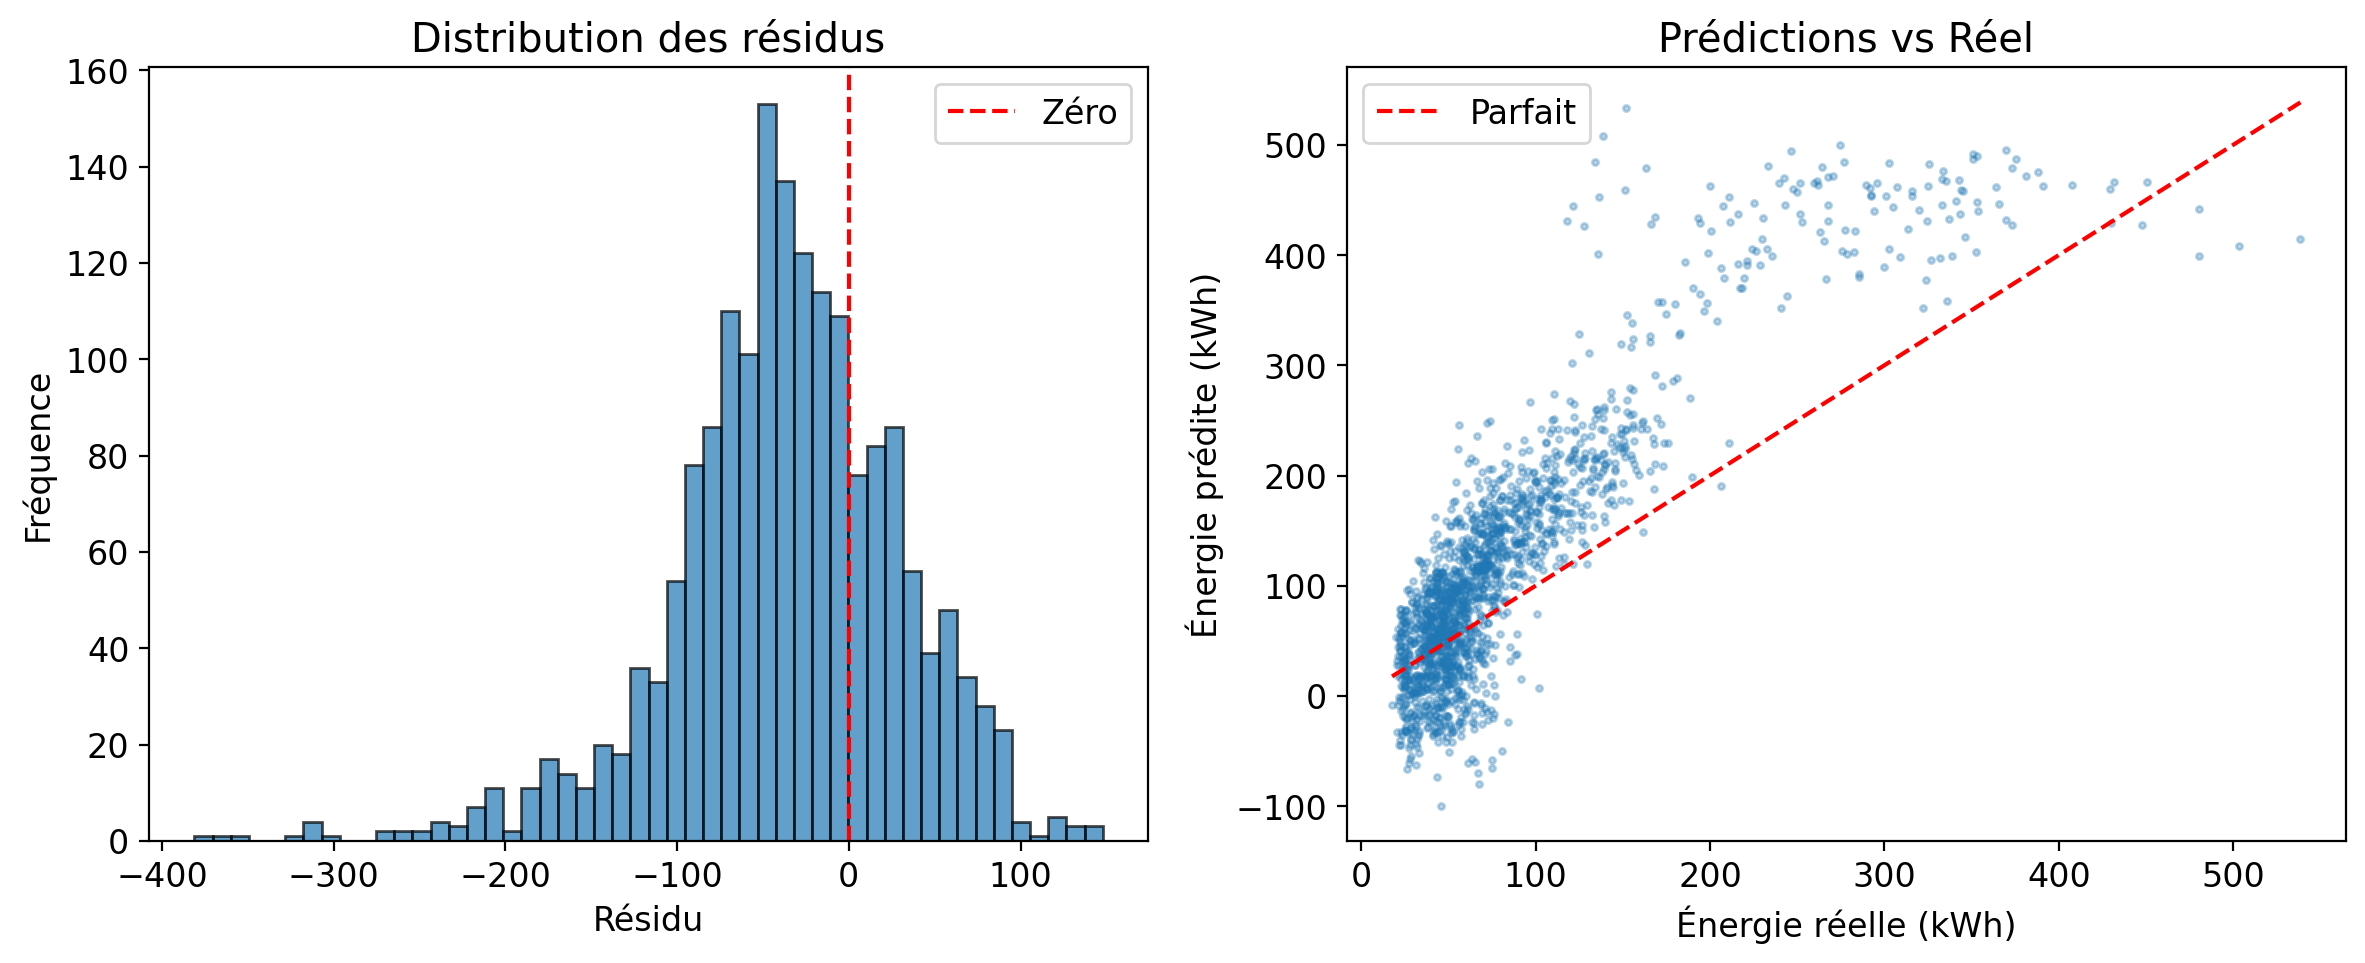
Partie 7: Extension (10%) - Choisir UNE option
Option A: Données météorologiques externes
Utilisez la bibliothèque meteostat pour ajouter des données météo supplémentaires (ex: pression atmosphérique, point de rosée).
Option B: Classification multiclasse
Au lieu de binaire (pointe/normal), créez 3+ classes de consommation (faible/moyenne/élevée) et utilisez softmax.
Option C: Analyse d’erreur approfondie
Identifiez quand le modèle fait le plus d’erreurs et proposez des améliorations.
# VOTRE EXTENSION ICI
# Indiquez quelle option vous avez choisie et pourquoi.

# Option choisie: ___
# Justification: ___# Générer les prédictions pour Kaggle (sur test_kaggle, sans la cible)
# Note: utilisez votre meilleur modèle pour faire ces prédictions
# Exemple avec le modèle final:
# X_kaggle = test_kaggle[features_final].values
# y_pred_kaggle = votre_modele.predict(X_kaggle)
submission = pd.DataFrame({
'id': range(len(test_kaggle)),
'energie_kwh': y_pred_final # Remplacez par vos prédictions sur test_kaggle
})
submission.to_csv('submission.csv', index=False)
print(f"Fichier de soumission créé: submission.csv ({len(submission)} lignes)")
submission.head()Fichier de soumission créé: submission.csv (1754 lignes)
Questions de réflexion
Fondamentaux
Dérivez la solution OLS au tableau.
Pourquoi avez-vous utilisé une division temporelle et non aléatoire?
Que voyez-vous dans vos résidus?
Régularisation
Pourquoi Ridge aide-t-il avec des caractéristiques corrélées?
Comment avez-vous choisi λ?
Quel coefficient a été le plus réduit? Pourquoi?
Classification
Quelle cible binaire avez-vous choisie? Justifiez.
Votre classifieur donne P=0.7. Qu’est-ce que cela signifie?
Pourquoi utiliser P(pointe) plutôt qu’un indicateur 0/1?
Théorie probabiliste
Expliquez Ridge comme estimation MAP.
Pourquoi la régression logistique minimise-t-elle l’entropie croisée?
Synthèse
Parcourez votre modèle complet étape par étape.
Quelle amélioration de R² était la plus importante?
Modifiez ce seuil en direct. Que prédisez-vous?