IFT3395/IFT6390 — Fondements de l’apprentissage machine
Ce notebook accompagne le Chapitre 11: Arbres, ensembles et descente de gradient fonctionnelle. Il illustre le gradient boosting comme descente de gradient dans l’espace des fonctions, en utilisant JAX pour le calcul automatique des pseudo-résidus et n’importe quel modèle compatible avec l’interface scikit-learn comme apprenant de base.
Configuration
import jax
import jax.numpy as jnp
import numpy as np
import matplotlib.pyplot as plt
from sklearn.base import clone, BaseEstimator, RegressorMixin
from sklearn.tree import DecisionTreeRegressor
from sklearn.linear_model import LinearRegression, Ridge
from sklearn.neighbors import KNeighborsRegressor
from sklearn.kernel_ridge import KernelRidge

jax.config.update("jax_enable_x64", True)

plt.rcParams['figure.figsize'] = (10, 4)
plt.rcParams['font.size'] = 11

print(f"JAX version: {jax.__version__}")
print(f"Plateforme: {jax.devices()[0].platform}")
JAX version: 0.9.1
Plateforme: cpu
Données
Prenons un problème de régression en une dimension. La cible est une fonction non linéaire, et nous ajoutons du bruit pour simuler des données réelles.
np.random.seed(42)
N = 100
x_train = np.sort(np.random.uniform(0, 2 * np.pi, N))
y_train = np.sin(x_train) + 0.3 * np.cos(3 * x_train) + 0.2 * np.random.randn(N)

x_plot = np.linspace(0, 2 * np.pi, 500)
y_true = np.sin(x_plot) + 0.3 * np.cos(3 * x_plot)

plt.scatter(x_train, y_train, s=10, alpha=0.5, color='C7', label='Données')
plt.plot(x_plot, y_true, 'k--', alpha=0.5, label='Cible')
plt.xlabel('$x$')
plt.ylabel('$y$')
plt.legend()
plt.grid(True, alpha=0.2)
plt.tight_layout()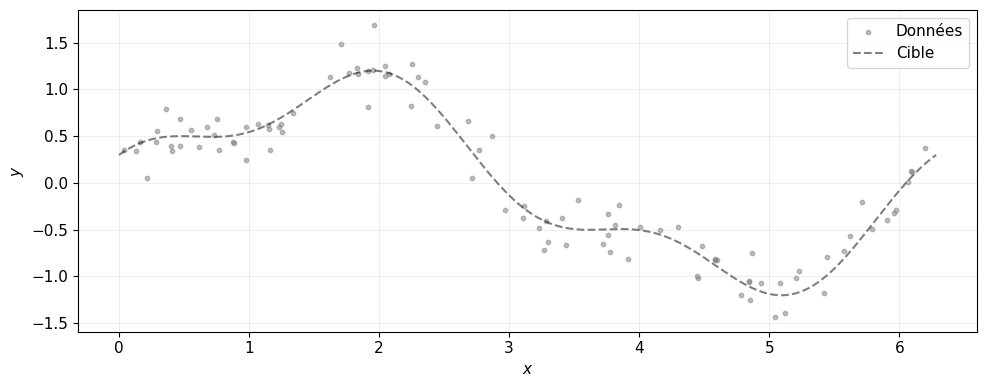
Le gradient boosting comme descente de gradient fonctionnelle
Idée
On cherche une fonction qui minimise le risque empirique:
Au lieu d’optimiser les paramètres d’un modèle, on traite les prédictions comme les variables d’optimisation. Le gradient de par rapport à est:
Ce gradient n’est défini qu’aux points d’entraînement. Pour le généraliser, on ajuste un modèle sur les pseudo-résidus , puis on met à jour:
Implémentation générique avec JAX
L’avantage de JAX est que les pseudo-résidus sont calculés automatiquement par différentiation, quelle que soit la fonction de perte. Le modèle de base peut être n’importe quel régresseur compatible scikit-learn.
class FunctionalGradientBoosting:
    """Gradient boosting generique via descente de gradient fonctionnelle.

    La perte est une fonction JAX differentiable. Le modele de base
    est n'importe quel regresseur compatible scikit-learn.
    """

    def __init__(self, loss_fn, base_learner, n_iterations=50, learning_rate=0.1):
        self.loss_fn = loss_fn
        self.base_learner = base_learner
        self.n_iterations = n_iterations
        self.learning_rate = learning_rate
        self.models = []
        self.f0 = None
        self.train_losses = []

        # Gradient de la perte par rapport a la prediction (2e argument)
        self.grad_loss = jax.grad(loss_fn, argnums=1)

    def fit(self, X, y):
        X = np.asarray(X)
        y = np.asarray(y)
        N = len(y)

        # f_0: constante qui minimise la perte totale
        # Pour la perte quadratique, c'est la moyenne; en general, on optimise
        self.f0 = float(np.mean(y))
        f_current = np.full(N, self.f0)

        self.train_losses = [self._total_loss(y, f_current)]
        self.models = []

        for m in range(self.n_iterations):
            # Pseudo-residus: gradient negatif de la perte par rapport aux predictions
            pseudo_residuals = np.array([
                -float(self.grad_loss(jnp.float64(yi), jnp.float64(fi)))
                for yi, fi in zip(y, f_current)
            ])

            # Ajuster un modele de base sur les pseudo-residus
            model = clone(self.base_learner)
            model.fit(X, pseudo_residuals)

            # Mettre a jour les predictions
            f_current = f_current + self.learning_rate * model.predict(X)

            self.models.append(model)
            self.train_losses.append(self._total_loss(y, f_current))

        return self

    def predict(self, X):
        X = np.asarray(X)
        f = np.full(X.shape[0], self.f0)
        for model in self.models:
            f = f + self.learning_rate * model.predict(X)
        return f

    def predict_at_stage(self, X, stage):
        """Prediction apres les `stage` premieres iterations."""
        X = np.asarray(X)
        f = np.full(X.shape[0], self.f0)
        for model in self.models[:stage]:
            f = f + self.learning_rate * model.predict(X)
        return f

    def _total_loss(self, y, f):
        return float(sum(
            self.loss_fn(jnp.float64(yi), jnp.float64(fi))
            for yi, fi in zip(y, f)
        )) / len(y)
Perte quadratique avec des arbres de décision
Commençons par le cas classique: perte quadratique et arbres peu profonds comme modèle de base. Les pseudo-résidus sont les résidus ordinaires: .
# Perte quadratique
def squared_loss(y, f_hat):
    return 0.5 * (y - f_hat) ** 2

# Gradient boosting avec arbres (profondeur 2)
gb_tree = FunctionalGradientBoosting(
    loss_fn=squared_loss,
    base_learner=DecisionTreeRegressor(max_depth=2),
    n_iterations=100,
    learning_rate=0.1
)
gb_tree.fit(x_train.reshape(-1, 1), y_train)

# Visualiser les iterations
stages = [0, 1, 5, 20, 100]
fig, axes = plt.subplots(1, len(stages), figsize=(16, 3), sharey=True)

for ax, s in zip(axes, stages):
    pred = gb_tree.predict_at_stage(x_plot.reshape(-1, 1), s)
    ax.scatter(x_train, y_train, s=8, alpha=0.3, color='C7')
    ax.plot(x_plot, y_true, 'k--', alpha=0.4, linewidth=1)
    ax.plot(x_plot, pred, 'C0', linewidth=2)
    ax.set_title(f'$m = {s}$', fontsize=10)
    ax.set_xlabel('$x$')
    ax.grid(True, alpha=0.2)
    ax.set_ylim(-2, 2)

axes[0].set_ylabel('$y$')
plt.tight_layout()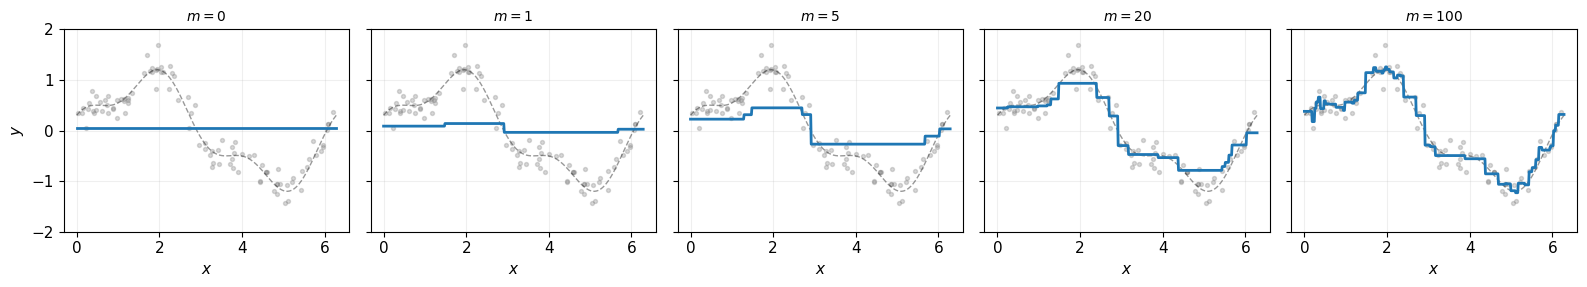
# Courbe de perte
plt.figure(figsize=(6, 3.5))
plt.plot(gb_tree.train_losses, 'C0', linewidth=1.5)
plt.xlabel('It\u00e9ration $m$')
plt.ylabel('Perte moyenne (entra\u00eenement)')
plt.grid(True, alpha=0.2)
plt.tight_layout()
Changer le modèle de base: la descente est la même
Le cadre de la descente de gradient fonctionnelle ne dépend pas du modèle de base. L’algorithme reste le même: calculer les pseudo-résidus, ajuster un modèle dessus, accumuler les corrections. Seule la qualité de l’approximation du gradient change.
Comparons quatre modèles de base différents sur le même problème.
base_learners = {
    'Arbre (prof. 2)': DecisionTreeRegressor(max_depth=2),
    'Arbre (prof. 4)': DecisionTreeRegressor(max_depth=4),
    'Ridge lin\u00e9aire': Ridge(alpha=1.0),
    'KNN ($k=10$)': KNeighborsRegressor(n_neighbors=10),
}

results = {}
for name, learner in base_learners.items():
    gb = FunctionalGradientBoosting(
        loss_fn=squared_loss,
        base_learner=learner,
        n_iterations=80,
        learning_rate=0.1
    )
    gb.fit(x_train.reshape(-1, 1), y_train)
    results[name] = gb

fig, axes = plt.subplots(1, 4, figsize=(16, 3.5), sharey=True)
for ax, (name, gb) in zip(axes, results.items()):
    pred = gb.predict(x_plot.reshape(-1, 1))
    ax.scatter(x_train, y_train, s=8, alpha=0.3, color='C7')
    ax.plot(x_plot, y_true, 'k--', alpha=0.4, linewidth=1)
    ax.plot(x_plot, pred, 'C0', linewidth=2)
    ax.set_title(name, fontsize=10)
    ax.set_xlabel('$x$')
    ax.grid(True, alpha=0.2)
    ax.set_ylim(-2, 2)

axes[0].set_ylabel('$y$')
plt.tight_layout()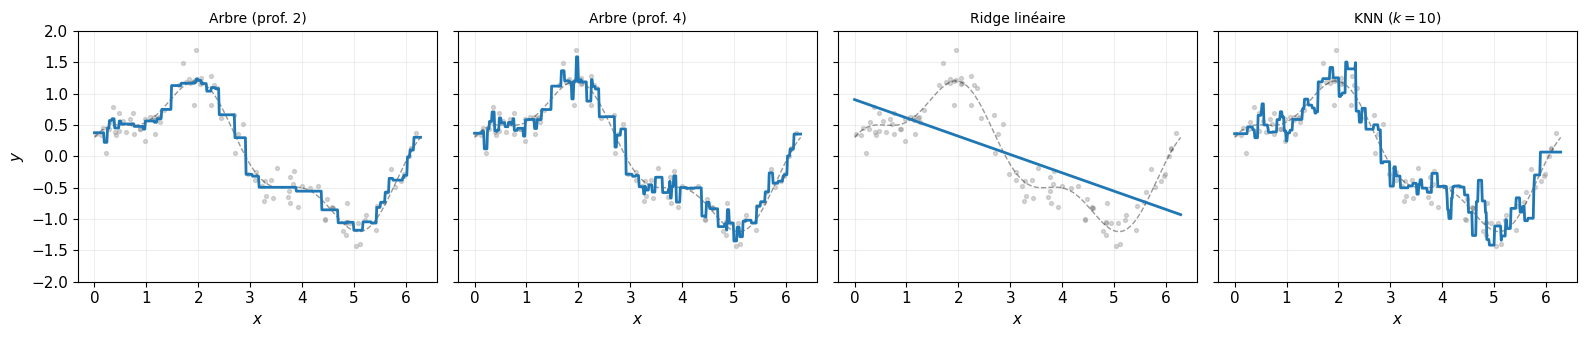
# Comparaison des courbes de perte
plt.figure(figsize=(7, 4))
for i, (name, gb) in enumerate(results.items()):
    plt.plot(gb.train_losses, f'C{i}', linewidth=1.5, label=name)
plt.xlabel('It\u00e9ration $m$')
plt.ylabel('Perte moyenne')
plt.legend(fontsize=9)
plt.grid(True, alpha=0.2)
plt.tight_layout()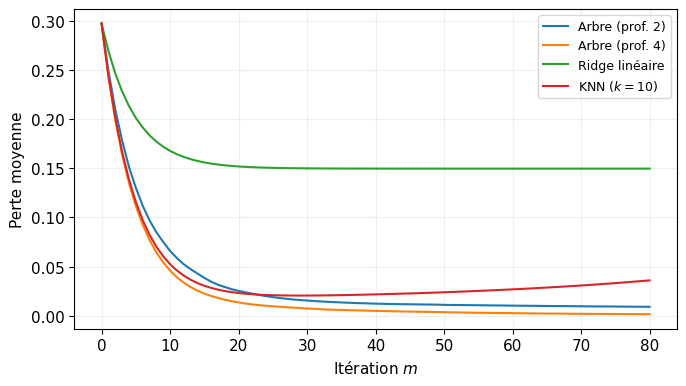
L’arbre de profondeur 4 converge plus vite que l’arbre de profondeur 2 car chaque correction est plus expressive. La régression Ridge, étant un modèle linéaire, ne peut capturer que des corrections linéaires à chaque itération: le boosting converge plus lentement. Le KNN produit des corrections locales, avec un comportement intermédiaire.
Dans tous les cas, l’algorithme est identique: seul le modèle qui approxime le gradient change.
Changer la perte: la perte absolue
Le gradient boosting n’est pas limité à la perte quadratique. Avec JAX, on peut utiliser n’importe quelle perte différentiable. Essayons la perte absolue , qui est plus robuste aux valeurs aberrantes.
Les pseudo-résidus pour cette perte sont : ils valent +1 ou -1 selon que la prédiction est trop basse ou trop haute, sans tenir compte de l’amplitude de l’erreur.
def absolute_loss(y, f_hat):
    return jnp.abs(y - f_hat)

# Ajoutons quelques valeurs aberrantes
y_outliers = y_train.copy()
y_outliers[10] = 5.0
y_outliers[50] = -4.0
y_outliers[70] = 4.5

gb_l2 = FunctionalGradientBoosting(
    loss_fn=squared_loss,
    base_learner=DecisionTreeRegressor(max_depth=3),
    n_iterations=80, learning_rate=0.1
).fit(x_train.reshape(-1, 1), y_outliers)

gb_l1 = FunctionalGradientBoosting(
    loss_fn=absolute_loss,
    base_learner=DecisionTreeRegressor(max_depth=3),
    n_iterations=80, learning_rate=0.1
).fit(x_train.reshape(-1, 1), y_outliers)

fig, axes = plt.subplots(1, 2, figsize=(10, 4), sharey=True)

for ax, gb, title in zip(axes, [gb_l2, gb_l1],
                          ['Perte quadratique', 'Perte absolue']):
    pred = gb.predict(x_plot.reshape(-1, 1))
    ax.scatter(x_train, y_outliers, s=12, alpha=0.4, color='C7')
    ax.plot(x_plot, y_true, 'k--', alpha=0.4, linewidth=1, label='Cible')
    ax.plot(x_plot, pred, 'C0', linewidth=2, label='Pr\u00e9diction')
    # Highlight outliers
    for idx in [10, 50, 70]:
        ax.scatter(x_train[idx], y_outliers[idx], s=50, color='C3',
                   zorder=5, edgecolors='k', linewidth=0.5)
    ax.set_title(title, fontsize=10)
    ax.set_xlabel('$x$')
    ax.grid(True, alpha=0.2)
    ax.set_ylim(-5.5, 6)

axes[0].set_ylabel('$y$')
axes[1].legend(fontsize=9)
plt.tight_layout()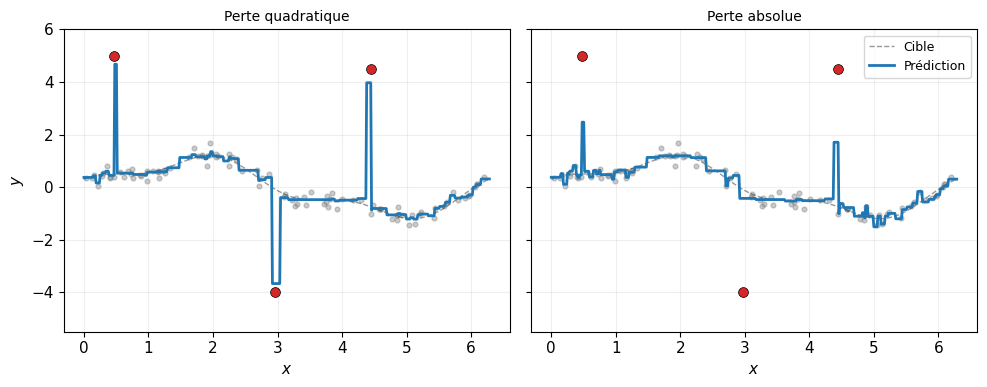
La perte quadratique tire la prédiction vers les valeurs aberrantes (cercles rouges), tandis que la perte absolue y est moins sensible. Les pseudo-résidus de la perte absolue sont bornés (), ce qui limite l’influence de chaque point.
Perte de Huber: un compromis
La perte de Huber combine les deux: quadratique pour les petites erreurs, linéaire pour les grandes. Le seuil contrôle la transition.
def huber_loss(y, f_hat, delta=1.0):
    r = y - f_hat
    return jnp.where(jnp.abs(r) <= delta,
                     0.5 * r ** 2,
                     delta * (jnp.abs(r) - 0.5 * delta))

gb_huber = FunctionalGradientBoosting(
    loss_fn=huber_loss,
    base_learner=DecisionTreeRegressor(max_depth=3),
    n_iterations=80, learning_rate=0.1
).fit(x_train.reshape(-1, 1), y_outliers)

# Visualiser les pseudo-residus pour les trois pertes
r = np.linspace(-4, 4, 300)

fig, axes = plt.subplots(1, 2, figsize=(10, 3.5))

# Losses
ax = axes[0]
ax.plot(r, [float(squared_loss(0.0, jnp.float64(-ri))) for ri in r],
        'C0', linewidth=1.5, label='Quadratique')
ax.plot(r, [float(absolute_loss(0.0, jnp.float64(-ri))) for ri in r],
        'C1', linewidth=1.5, label='Absolue')
ax.plot(r, [float(huber_loss(0.0, jnp.float64(-ri))) for ri in r],
        'C2--', linewidth=1.5, label='Huber ($\\delta=1$)')
ax.set_xlabel('R\u00e9sidu $y - \hat{y}$')
ax.set_ylabel('Perte')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.2)
ax.set_ylim(0, 8)

# Pseudo-residuals (negative gradients)
ax = axes[1]
grad_sq = jax.grad(squared_loss, argnums=1)
grad_abs = jax.grad(absolute_loss, argnums=1)
grad_hub = jax.grad(huber_loss, argnums=1)

ax.plot(r, [-float(grad_sq(jnp.float64(0.0), jnp.float64(-ri))) for ri in r],
        'C0', linewidth=1.5, label='Quadratique')
ax.plot(r, [-float(grad_abs(jnp.float64(0.0), jnp.float64(-ri))) for ri in r],
        'C1', linewidth=1.5, label='Absolue')
ax.plot(r, [-float(grad_hub(jnp.float64(0.0), jnp.float64(-ri))) for ri in r],
        'C2--', linewidth=1.5, label='Huber')
ax.set_xlabel('R\u00e9sidu $y - \hat{y}$')
ax.set_ylabel('Pseudo-r\u00e9sidu $-g_i$')
ax.legend(fontsize=9)
ax.grid(True, alpha=0.2)

plt.tight_layout()
<>:26: SyntaxWarning: invalid escape sequence '\h'
<>:44: SyntaxWarning: invalid escape sequence '\h'
<>:26: SyntaxWarning: invalid escape sequence '\h'
<>:44: SyntaxWarning: invalid escape sequence '\h'
/var/folders/kz/gmggxk812sg1jvysfbnx_y7h0000gq/T/ipykernel_59729/2751189774.py:26: SyntaxWarning: invalid escape sequence '\h'
ax.set_xlabel('R\u00e9sidu $y - \hat{y}$')
/var/folders/kz/gmggxk812sg1jvysfbnx_y7h0000gq/T/ipykernel_59729/2751189774.py:44: SyntaxWarning: invalid escape sequence '\h'
ax.set_xlabel('R\u00e9sidu $y - \hat{y}$')
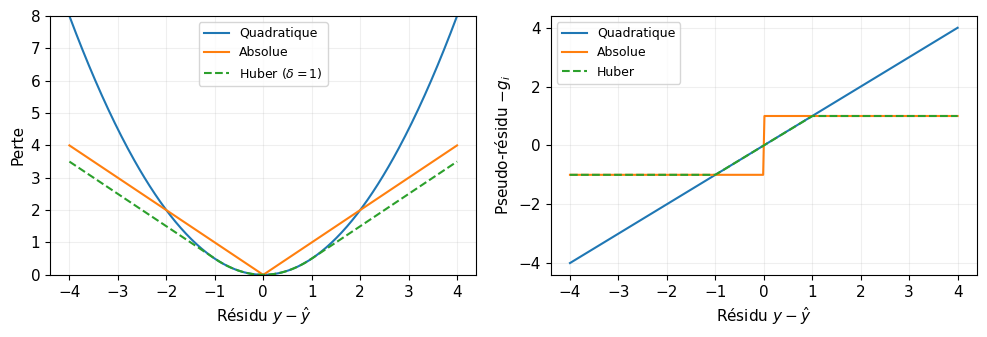
À gauche: les trois fonctions de perte. La perte quadratique croît sans borne, la perte absolue croît linéairement, et la perte de Huber interpole entre les deux.
À droite: les pseudo-résidus correspondants. Pour la perte quadratique, le pseudo-résidu est le résidu lui-même (croissance linéaire). Pour la perte absolue, il est borné à . Pour la perte de Huber, il est linéaire pour les petites erreurs puis borné pour les grandes. Ce sont ces pseudo-résidus que le modèle de base apprend à prédire à chaque itération.
Le taux d’apprentissage et le surapprentissage
Le taux d’apprentissage et le nombre d’itérations sont deux hyperparamètres interdépendants. Un petit nécessite plus d’itérations mais généralise mieux.
# Comparaison de differents taux d'apprentissage
learning_rates = [1.0, 0.3, 0.1, 0.01]

fig, axes = plt.subplots(1, 4, figsize=(16, 3.5), sharey=True)

for ax, lr in zip(axes, learning_rates):
    gb = FunctionalGradientBoosting(
        loss_fn=squared_loss,
        base_learner=DecisionTreeRegressor(max_depth=2),
        n_iterations=100, learning_rate=lr
    ).fit(x_train.reshape(-1, 1), y_train)

    pred = gb.predict(x_plot.reshape(-1, 1))
    ax.scatter(x_train, y_train, s=8, alpha=0.3, color='C7')
    ax.plot(x_plot, y_true, 'k--', alpha=0.4, linewidth=1)
    ax.plot(x_plot, pred, 'C0', linewidth=2)
    ax.set_title(f'$\\nu = {lr}$, $M = 100$', fontsize=10)
    ax.set_xlabel('$x$')
    ax.grid(True, alpha=0.2)
    ax.set_ylim(-2.5, 2.5)

axes[0].set_ylabel('$y$')
plt.tight_layout()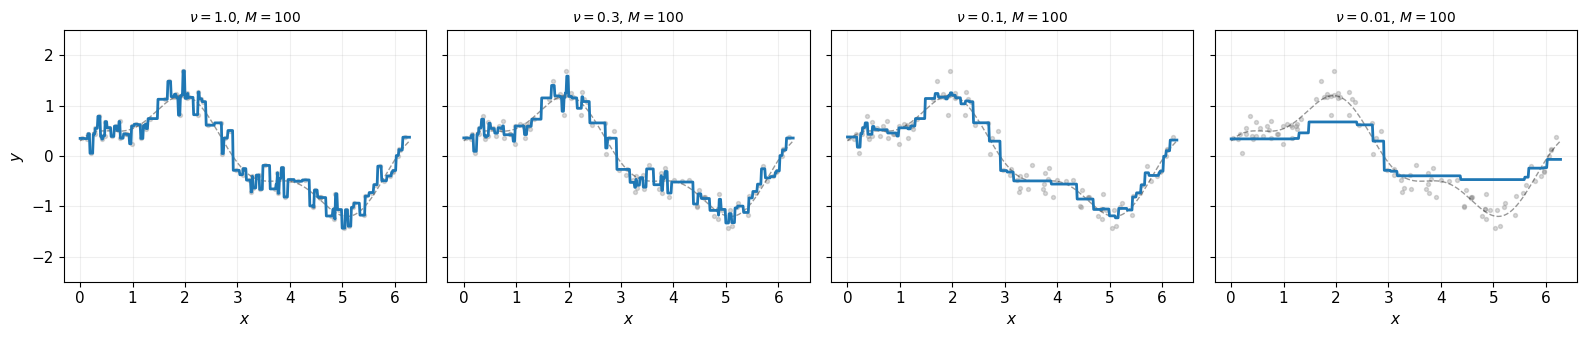
Avec , chaque arbre a trop d’influence et l’ensemble surapprend: la courbe est très irrégulière. Avec , 100 itérations ne suffisent pas: l’ensemble sous-apprend. Les valeurs intermédiaires ( à ) donnent un bon compromis.
Capacité du modèle de base
Que se passe-t-il quand le modèle de base est trop expressif? Le boosting réduit le biais itérativement; si le modèle de base est déjà très expressif, les premières itérations ajustent le bruit.
depths = [1, 2, 4, 8]

fig, axes = plt.subplots(1, 4, figsize=(16, 3.5), sharey=True)

for ax, d in zip(axes, depths):
    gb = FunctionalGradientBoosting(
        loss_fn=squared_loss,
        base_learner=DecisionTreeRegressor(max_depth=d),
        n_iterations=50, learning_rate=0.1
    ).fit(x_train.reshape(-1, 1), y_train)

    pred = gb.predict(x_plot.reshape(-1, 1))
    ax.scatter(x_train, y_train, s=8, alpha=0.3, color='C7')
    ax.plot(x_plot, y_true, 'k--', alpha=0.4, linewidth=1)
    ax.plot(x_plot, pred, 'C0', linewidth=2)
    ax.set_title(f'Profondeur = {d}', fontsize=10)
    ax.set_xlabel('$x$')
    ax.grid(True, alpha=0.2)
    ax.set_ylim(-2.5, 2.5)

axes[0].set_ylabel('$y$')
plt.tight_layout()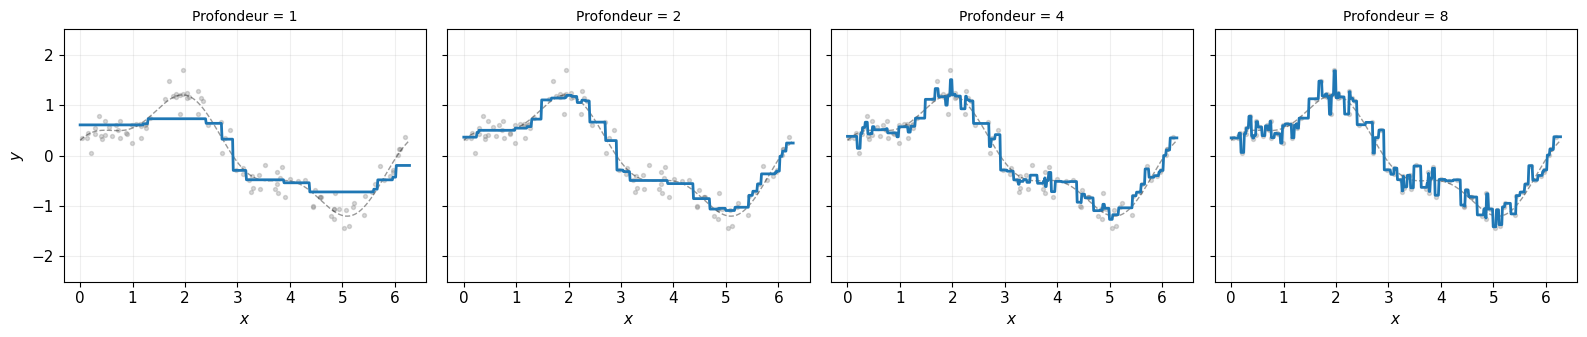
Les arbres de profondeur 1 (souches) sont des apprenants faibles: chaque correction est grossière, mais l’accumulation fonctionne. Les arbres de profondeur 8 sont des apprenants forts: chaque arbre capture trop de détail, et l’ensemble surapprend malgré un petit.
Résumé
Ce notebook a montré que le gradient boosting est un algorithme d’optimisation dans l’espace des fonctions. Les trois composantes sont:
La perte: définit les pseudo-résidus via son gradient (calculé automatiquement par JAX).
Le modèle de base: approxime les pseudo-résidus pour généraliser au-delà des données d’entraînement. N’importe quel régresseur compatible scikit-learn convient.
Le taux d’apprentissage : contrôle l’amplitude de chaque correction.
La profondeur des arbres et le taux d’apprentissage sont les deux leviers de régularisation: l’un contrôle la complexité de chaque pas, l’autre son amplitude.