Le chapitre 7 a montré comment le MLP apprend une représentation à partir de données tabulaires, puis effectue une prédiction linéaire sur cette représentation. Mais le MLP traite son entrée comme un vecteur plat de taille fixe: chaque dimension est indépendante de ses voisines, et la taille de l’entrée est déterminée à l’avance.
Or beaucoup de données ont une structure séquentielle. Un texte est une suite de mots, un signal audio est une suite d’échantillons, une série temporelle de température est une suite de mesures à intervalles réguliers. Ces données ont deux propriétés que le MLP ne sait pas exploiter: elles sont ordonnées (le mot “pas” a un sens différent au début et à la fin d’une phrase), et elles sont de longueur variable (une phrase peut avoir 5 ou 50 mots).
Dans ce chapitre, nous présentons les réseaux récurrents, une famille d’architectures conçues pour traiter les séquences. Nous commençons par montrer pourquoi l’approche naïve (tout mettre dans un vecteur plat) échoue, puis nous introduisons l’idée d’état caché récurrent, le mécanisme de rétropropagation à travers le temps, et les variantes à portes (LSTM, GRU) qui atténuent la dissolution du gradient.
Le problème des séquences
Supposons que nous voulions prédire le mot suivant dans une phrase, ou classifier le sentiment d’un commentaire. L’entrée est une séquence où chaque représente un élément (un mot, une mesure, un échantillon). La longueur varie d’un exemple à l’autre.
L’approche la plus directe serait de concaténer tous les éléments en un seul vecteur et d’utiliser un MLP:
Cette approche a trois problèmes. Le premier est la taille fixe: le MLP attend un vecteur de dimension , mais varie d’un exemple à l’autre. Pour des phrases de longueurs différentes, il faudrait tronquer ou rembourrer, ce qui est inélégant et gaspille de l’information. Le deuxième est l’absence de partage: les paramètres qui traitent sont complètement distincts de ceux qui traitent , même si ces deux positions jouent un rôle analogue. Un motif appris en début de séquence (par exemple, reconnaître une négation) ne se transfère pas aux autres positions. Le troisième est l’absence de notion d’ordre: si l’on permute les éléments de l’entrée, un MLP n’a aucune façon de savoir que l’ordre a changé, à moins de l’encoder explicitement dans l’architecture.
Nous avons besoin d’une architecture qui traite la séquence élément par élément, qui partage ses paramètres entre les positions, et qui maintient une forme de mémoire de ce qu’elle a vu jusqu’ici.
L’état caché récurrent
L’idée des réseaux récurrents est de traiter la séquence un élément à la fois, en maintenant un vecteur d’état qui résume l’historique de la séquence jusqu’au pas . À chaque pas de temps, le réseau lit le nouvel élément , le combine avec l’état précédent , et produit un nouvel état .
La mise à jour prend la forme:
où et sont des matrices de poids, est un biais, et est une fonction d’activation (typiquement ). L’état initial est .
Cette équation est un MLP appliqué à la concaténation de et . On peut réécrire (2) sous la forme:
Pour produire une sortie à chaque pas de temps (par exemple, prédire le mot suivant), on ajoute une couche de sortie:
où projette l’état caché vers l’espace de sortie.
Les trois paramètres et les biais sont les mêmes à chaque pas de temps. C’est le partage de paramètres qui distingue le RNN du MLP: un motif appris à une position fonctionne à toutes les positions.
Déroulement dans le temps
Pour visualiser le calcul, on peut “dérouler” le RNN dans le temps. Le même réseau est copié fois, une copie par pas de temps, avec les mêmes poids partout:
Le réseau déroulé ressemble à un MLP très profond (avec “couches”), mais avec une différence: toutes les couches partagent les mêmes poids. À chaque couche, un nouvel élément d’entrée est injecté.
Selon la tâche, on utilise l’état caché de différentes façons:
Classification de séquence (plusieurs entrées, une sortie): on lit , l’état final, et on le passe à un classifieur. Exemple: classifier le sentiment d’un commentaire.
Étiquetage de séquence (une sortie par entrée): on produit à chaque pas de temps. Exemple: identifier la catégorie grammaticale de chaque mot.
Séquence à séquence: un premier RNN (l’encodeur) lit la séquence d’entrée et produit un état ; un second RNN (le décodeur) génère la séquence de sortie à partir de cet état. Exemple: traduction automatique.
Rétropropagation à travers le temps
Pour entraîner un RNN, nous devons calculer les gradients de la perte par rapport aux paramètres. Le réseau déroulé est un graphe de calcul comme un autre: on peut appliquer la rétropropagation vue au chapitre 7.
Considérons une perte qui accumule un terme à chaque pas de temps. Le gradient par rapport à fait intervenir la chaîne de dépendances . Par la règle de la chaîne:
Le terme dépend de tous les états précédents. En développant:
où désigne la dérivée directe (en traitant comme une constante), et le produit de jacobiennes propage le gradient à travers le temps.
Ce produit de jacobiennes est la source du problème principal des RNN.
Dissolution du gradient
Chaque facteur du produit est la jacobienne de la mise à jour récurrente:
où . Pour , la dérivée est comprise entre 0 et 1. Si les valeurs propres de sont inférieures à 1 en module, le produit de matrices décroît exponentiellement. Le gradient “disparaît” et le réseau ne peut plus apprendre les dépendances entre des éléments éloignés dans la séquence.
À l’inverse, si les valeurs propres sont supérieures à 1, le produit croît exponentiellement: le gradient “explose”. Ce problème est plus facile à traiter (on peut tronquer la norme du gradient, une technique appelée écrêtage du gradient (gradient clipping)), mais la dissolution du gradient est plus insidieuse, car elle ne produit pas d’erreur visible: l’entraînement semble fonctionner, mais le réseau ignore silencieusement les dépendances à long terme.
C’est le même phénomène que dans les MLP profonds (chapitre 8), mais aggravé par le fait que peut être très grand (des centaines ou des milliers de pas de temps).
Source
import numpy as np
import matplotlib.pyplot as plt

%config InlineBackend.figure_format = 'retina'

np.random.seed(42)
m = 50
W = np.random.randn(m, m) * 0.9 / np.sqrt(m)

norms = []
v = np.random.randn(m)
v = v / np.linalg.norm(v)
for t in range(100):
    v = np.tanh(W @ v)  # simplified: tanh(W h)
    scale = np.linalg.norm(np.diag(1 - v**2) @ W, ord=2)
    norms.append(scale)

grad_product = np.cumprod(norms)

fig, ax = plt.subplots(figsize=(7, 3))
ax.semilogy(grad_product, 'C0', lw=1.5)
ax.set_xlabel('Nombre de pas de temps ($t - k$)')
ax.set_ylabel('Norme du produit de jacobiennes')
ax.set_title('Décroissance exponentielle du gradient dans un RNN')
ax.grid(True, alpha=0.3)
plt.tight_layout()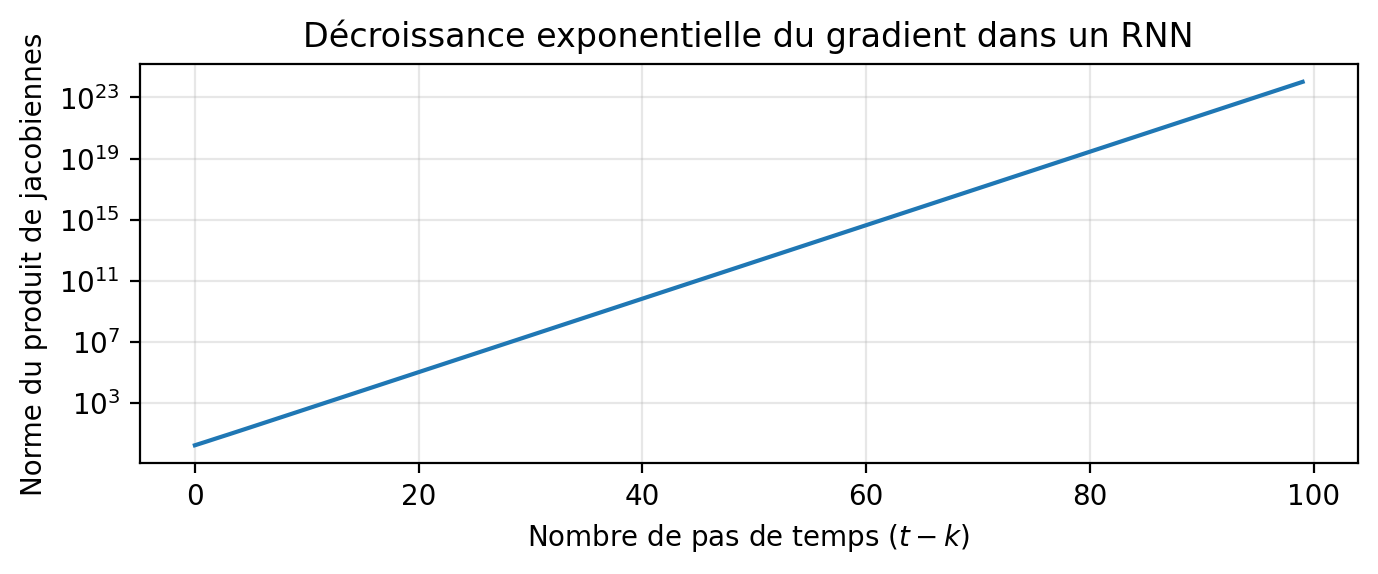
La figure montre la norme du produit de jacobiennes en fonction du nombre de pas de temps. Après quelques dizaines de pas, le gradient est essentiellement nul: le réseau ne reçoit plus de signal d’apprentissage pour les dépendances à long terme.
LSTM et GRU: des mécanismes de portes
Le LSTM (Long Short-Term Memory) Hochreiter & Schmidhuber (1997) résout la dissolution du gradient en introduisant un état de cellule qui circule d’un pas à l’autre de façon (presque) linéaire. Des portes apprises contrôlent le flux d’information:
où est le produit élément par élément et désigne la concaténation.
L’état de cellule agit comme un chemin direct pour le gradient. Quand la porte d’oubli et la porte d’entrée , l’état de cellule est simplement copié: . Le gradient circule sans atténuation à travers cette connexion linéaire, ce qui permet d’apprendre des dépendances sur des centaines de pas de temps.
Le GRU (Gated Recurrent Unit) Cho et al. (2014) simplifie le LSTM en fusionnant l’état de cellule et l’état caché, et en utilisant deux portes au lieu de trois:
La porte de mise à jour joue le rôle combiné des portes d’oubli et d’entrée du LSTM. En pratique, LSTM et GRU ont des performances comparables sur la plupart des tâches. Le GRU a moins de paramètres, ce qui peut être un avantage quand les données sont limitées.
Ce qui compte pour l’intuition, c’est le mécanisme commun: les portes permettent au gradient de circuler sans être multiplié par à chaque pas, ce qui atténue la dissolution du gradient.
Limites des réseaux récurrents
Malgré les mécanismes de portes, les réseaux récurrents ont des limitations qui expliquent pourquoi ils ont été largement remplacés par les transformeurs pour beaucoup de tâches.
Le traitement séquentiel est le premier problème. Le calcul de dépend de , qui dépend de , et ainsi de suite. On ne peut pas paralléliser le traitement des différentes positions: il faut les traiter dans l’ordre. Sur du matériel moderne (GPU, TPU), conçu pour le parallélisme massif, cette contrainte est un goulot d’étranglement.
Le goulot d’information est le second problème. Toute l’information sur la séquence passe par le vecteur de dimension fixe . Pour une longue séquence, il est difficile de compresser tout le contexte pertinent dans ce vecteur. Même avec LSTM ou GRU, les dépendances à très long terme restent difficiles à capturer.
Ces deux limitations motivent le mécanisme d’attention, que nous verrons au chapitre suivant. L’attention permet à chaque position d’une séquence de consulter directement toutes les autres positions, sans passer par une chaîne d’états cachés, et de manière parallélisable.
Résumé
Les réseaux récurrents étendent le MLP aux données séquentielles en introduisant un état caché qui résume l’historique. Les mêmes paramètres sont partagés à chaque pas de temps, ce qui permet de traiter des séquences de longueur variable. Le réseau déroulé dans le temps est un graphe de calcul profond auquel on applique la rétropropagation standard (BPTT).
Le produit de jacobiennes qui apparaît dans BPTT décroît (ou croît) exponentiellement avec le nombre de pas de temps. Cette dissolution du gradient empêche l’apprentissage de dépendances à long terme. Le LSTM et le GRU introduisent des portes qui créent un chemin linéaire pour le gradient, atténuant ce problème.
Malgré ces progrès, les RNN souffrent d’un traitement séquentiel non parallélisable et d’un goulot d’information dû à la compression de toute la séquence dans un vecteur de taille fixe. Le chapitre suivant introduit le mécanisme d’attention, qui résout ces deux problèmes en permettant l’accès direct entre toutes les positions d’une séquence.
Exercices
Les exercices ★ vérifient la compréhension de base. Les exercices ★★ demandent d’appliquer les concepts à des calculs concrets. Les exercices ★★★ approfondissent le sujet et sont optionnels pour IFT3395.
Exercice 1: Nombre de paramètres d’un RNN ★
Considérez un RNN avec une entrée , un état caché , et une sortie .
Combien de paramètres contiennent les matrices , et (sans les biais)?
Combien de paramètres au total (avec les biais)?
Ce nombre dépend-il de la longueur de la séquence? Pourquoi?
Solution Exercice 1
: 6 400 paramètres. : 16 384 paramètres. : 1 280 paramètres. Total sans biais: 24 064.
Biais: (128) et (10). Total avec biais: 24 202.
Le nombre de paramètres ne dépend pas de , car les mêmes poids sont réutilisés à chaque pas de temps. C’est une propriété du partage de paramètres.
Exercice 2: Déroulement d’un RNN à la main ★
Considérez un RNN à une dimension () avec , , , (pas d’activation) et .
Pour la séquence d’entrée :
Calculez , et .
Quelle serait la valeur de si la séquence continuait avec des entrées nulles ( pour )?
Solution Exercice 2
. . .
Pour , . L’état décroît géométriquement vers 0: , , etc. Puisque , le réseau “oublie” progressivement. C’est une manifestation de la dissolution du gradient dans un cas linéaire simplifié.
Exercice 3: Dissolution du gradient ★★
Pour le RNN linéaire de l’exercice 2 (sans activation), montrez que:
Que se passe-t-il quand et est grand? Et quand ?
Solution Exercice 3
Sans activation, . La dérivée par rapport à est . Par la règle de la chaîne:
Si , ce terme décroît exponentiellement vers 0: le gradient se dissout et le réseau ne peut pas apprendre les dépendances entre et la perte au temps . Si , le terme croît exponentiellement: le gradient explose. Le cas multidimensionnel est analogue, avec les valeurs propres de jouant le rôle de .
Exercice 4: Porte d’oubli et gradient ★★
Dans un LSTM simplifié à une dimension, l’état de cellule se met à jour par , où est la porte d’oubli.
Calculez .
Calculez pour , en supposant les portes constantes ( pour tout ).
Comparez avec le RNN simple. Pour quelle valeur de le gradient ne disparaît-il pas?
Solution Exercice 4
(le terme ne dépend pas directement de dans cette version simplifiée).
(avec portes constantes).
Dans le RNN simple, le facteur est multiplié par , ce qui pousse le gradient vers 0. Dans le LSTM, le facteur est , et le réseau peut apprendre , ce qui donne . Le gradient circule sans atténuation le long de l’état de cellule. C’est le mécanisme qui permet au LSTM de capturer les dépendances à long terme.
- Hochreiter, S., & Schmidhuber, J. (1997). Long Short-Term Memory. Neural Computation, 9(8), 1735–1780.
- Cho, K., van Merriënboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H., & Bengio, Y. (2014). Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation. Proceedings of the 2014 Conference on Empirical Methods in Natural Language Processing (EMNLP), 1724–1734.