Tous les modèles que nous avons étudiés jusqu’ici étaient supervisés: ils apprenaient à prédire une sortie à partir d’une entrée , en utilisant des paires étiquetées. Mais les données étiquetées sont souvent rares et coûteuses à obtenir, tandis que les données non étiquetées sont abondantes. Peut-on apprendre des représentations utiles à partir des données seules, sans étiquettes?
L’idée la plus naturelle est de demander à un réseau de neurones de comprimer une entrée en une représentation de dimension inférieure, puis de reconstruire à partir de . Si la reconstruction est fidèle malgré la compression, c’est que a capturé la structure essentielle des données. Ce principe de compression-reconstruction définit l’auto-encodeur.
Dans ce chapitre, nous formalisons cette idée et montrons qu’elle généralise l’analyse en composantes principales au cas non linéaire. Nous présentons ensuite l’auto-encodeur débruiteur, qui apprend des représentations plus robustes en reconstruisant des entrées corrompues. Le chapitre se termine par un aperçu de l’auto-encodeur variationnel, qui ajoute une structure probabiliste à l’espace latent.
L’auto-encodeur
Architecture
Un auto-encodeur est un réseau de neurones composé de deux parties. L’encodeur transforme l’entrée en une représentation de dimension réduite (), appelée code latent ou simplement code. Le décodeur reconstruit l’entrée à partir de ce code. L’entrée traverse d’abord l’encodeur, puis le décodeur:
où est le code latent et est la reconstruction.
La contrainte crée un goulot d’étranglement (bottleneck): le réseau ne peut pas copier l’entrée vers la sortie en passant par , car n’a pas assez de dimensions pour stocker toute l’information. Le réseau doit donc apprendre quels aspects de l’entrée sont essentiels pour permettre la reconstruction, et lesquels peuvent être ignorés.
Fonction de perte
L’auto-encodeur est entraîné en minimisant l’erreur de reconstruction sur un ensemble de données :
C’est une perte des moindres carrés entre l’entrée et sa reconstruction. Comme pour les réseaux supervisés des chapitres précédents, on minimise cette perte par descente de gradient stochastique: la rétropropagation calcule les gradients et , et un optimiseur (Adam, par exemple) met à jour les paramètres de l’encodeur et du décodeur conjointement.
La perte quadratique n’est pas le seul choix possible. Pour des données binaires (pixels noirs et blancs, par exemple), on utilise l’entropie croisée binaire entre l’entrée et la reconstruction, comme en classification binaire (chapitre 3). Pour des images en niveaux de gris normalisés entre 0 et 1, les deux fonctions de perte donnent des résultats similaires en pratique.
Ce que l’auto-encodeur n’est pas
Un auto-encodeur n’est pas un algorithme de compression au sens informatique du terme: il ne produit pas un code binaire optimal pour des données arbitraires. Il apprend une compression adaptée à la distribution des données d’entraînement. Un auto-encodeur entraîné sur des visages comprimera bien d’autres visages, mais pas des paysages. Cette spécialisation est précisément ce qui rend les représentations apprises utiles pour des tâches en aval (classification, détection d’anomalies, etc.).
L’auto-encodeur linéaire et l’ACP
Que se passe-t-il si l’encodeur et le décodeur sont des transformations linéaires, sans fonction d’activation? L’encodeur devient et le décodeur , où et . La reconstruction est:
et la perte de reconstruction (pour des données centrées) devient:
Cette perte est exactement l’erreur de reconstruction de l’analyse en composantes principales (ACP). On peut montrer que les minimiseurs et satisfont , et que ce sous-espace est engendré par les vecteurs propres de la matrice de covariance empirique associés aux plus grandes valeurs propres Baldi & Hornik (1989). L’erreur de reconstruction minimale est:
où sont les valeurs propres de . C’est la somme des variances dans les directions ignorées par la projection, le même résultat que l’ACP.
L’auto-encodeur linéaire est donc une reformulation de l’ACP comme problème d’optimisation par gradient. Cette reformulation peut sembler inutile (l’ACP se résout par décomposition spectrale, sans itérations), mais elle ouvre une voie: en remplaçant les transformations linéaires par des réseaux de neurones, on obtient une généralisation non linéaire de l’ACP.
Auto-encodeurs non linéaires
Du linéaire au non linéaire
L’ACP projette les données sur un sous-espace linéaire. Or beaucoup de jeux de données vivent sur des variétés courbes de basse dimension: les images de visages, par exemple, varient le long de directions continues (pose, éclairage, expression) qui ne forment pas un sous-espace linéaire de l’espace des pixels. Un sous-espace linéaire est une mauvaise approximation de cette variété.
L’auto-encodeur non linéaire remplace les projections linéaires par des réseaux de neurones. L’encodeur et le décodeur deviennent des MLP (chapitre 7) avec des fonctions d’activation non linéaires:
où les et sont des fonctions d’activation (ReLU, par exemple). L’encodeur et le décodeur ont chacun leurs propres paramètres; l’entraînement ajuste les deux simultanément par rétropropagation.
Le rôle du goulot d’étranglement
La dimension du code latent contrôle le compromis entre fidélité de la reconstruction et compression. Si est trop grand (proche de ), le réseau peut apprendre la fonction identité et le code ne capture aucune structure utile. Si est trop petit, la reconstruction sera mauvaise car trop d’information est perdue.
En pratique, on choisit par validation: on entraîne des auto-encodeurs avec différentes dimensions latentes et on évalue la qualité des représentations sur une tâche en aval (classification avec un classifieur linéaire sur , par exemple) ou simplement la qualité de reconstruction sur un ensemble de validation.
Architectures courantes
L’encodeur et le décodeur ont souvent des architectures symétriques: si l’encodeur a des couches de tailles , le décodeur aura des couches . Cette symétrie n’est pas requise, mais elle simplifie le choix des hyperparamètres. La dernière couche du décodeur utilise une fonction d’activation adaptée au domaine des données: une sigmoïde pour des données dans (pixels normalisés), une identité pour des données réelles non bornées.
Source
import numpy as np
import matplotlib.pyplot as plt
import jax
import jax.numpy as jnp
%config InlineBackend.figure_format = 'retina'

# Générer des données sur une variété non linéaire (demi-cercle bruité)
np.random.seed(42)
N = 500
t = np.random.uniform(0, np.pi, N)
noise = np.random.normal(0, 0.05, (N, 2))
X = np.column_stack([np.cos(t), np.sin(t)]) + noise

# --- ACP ---
X_centered = X - X.mean(axis=0)
cov = X_centered.T @ X_centered / N
eigenvalues, eigenvectors = np.linalg.eigh(cov)
w1 = eigenvectors[:, -1]  # eigh trie par ordre croissant
z_pca = X_centered @ w1
X_pca_recon = np.outer(z_pca, w1) + X.mean(axis=0)

# --- Auto-encodeur en JAX ---
# Architecture: 2 -> 64 -> 1 -> 64 -> 2

def init_params(key):
    k1, k2, k3, k4 = jax.random.split(key, 4)
    return {
        'W1': jax.random.normal(k1, (2, 64)) * jnp.sqrt(2.0 / 2),
        'b1': jnp.zeros(64),
        'W2': jax.random.normal(k2, (64, 1)) * jnp.sqrt(2.0 / 64),
        'b2': jnp.zeros(1),
        'W3': jax.random.normal(k3, (1, 64)) * jnp.sqrt(2.0 / 1),
        'b3': jnp.zeros(64),
        'W4': jax.random.normal(k4, (64, 2)) * jnp.sqrt(2.0 / 64),
        'b4': jnp.zeros(2),
    }

def encode(params, x):
    h = jax.nn.relu(x @ params['W1'] + params['b1'])
    return h @ params['W2'] + params['b2']

def decode(params, z):
    h = jax.nn.relu(z @ params['W3'] + params['b3'])
    return h @ params['W4'] + params['b4']

def loss_fn(params, x):
    z = encode(params, x)
    x_hat = decode(params, z)
    return jnp.mean((x - x_hat) ** 2)

# Adam
def adam_init(params):
    return {k: {'m': jnp.zeros_like(v), 'v': jnp.zeros_like(v)}
            for k, v in params.items()}

@jax.jit
def adam_step(params, state, grads, lr=1e-3, b1=0.9, b2=0.999, eps=1e-8, t=1):
    new_params, new_state = {}, {}
    for k in params:
        m = b1 * state[k]['m'] + (1 - b1) * grads[k]
        v = b2 * state[k]['v'] + (1 - b2) * grads[k] ** 2
        m_hat = m / (1 - b1 ** t)
        v_hat = v / (1 - b2 ** t)
        new_params[k] = params[k] - lr * m_hat / (jnp.sqrt(v_hat) + eps)
        new_state[k] = {'m': m, 'v': v}
    return new_params, new_state

grad_fn = jax.jit(jax.grad(loss_fn))

X_jax = jnp.array(X_centered)
params = init_params(jax.random.key(0))
state = adam_init(params)

for i in range(3000):
    grads = grad_fn(params, X_jax)
    params, state = adam_step(params, state, grads, t=i + 1)

# Reconstruction
X_ae_recon = np.array(decode(params, encode(params, X_jax))) + X.mean(axis=0)

# --- Tracé ---
fig, axes = plt.subplots(1, 3, figsize=(12, 3.5))

axes[0].scatter(X[:, 0], X[:, 1], s=8, c=t, cmap='viridis', alpha=0.7)
axes[0].set_title('Données originales')
axes[0].set_xlabel('$x_1$')
axes[0].set_ylabel('$x_2$')
axes[0].set_aspect('equal')

axes[1].scatter(X[:, 0], X[:, 1], s=8, c=t, cmap='viridis', alpha=0.2)
axes[1].scatter(X_pca_recon[:, 0], X_pca_recon[:, 1], s=8, c=t, cmap='viridis', alpha=0.7)
for i in range(0, N, 15):
    axes[1].plot([X[i, 0], X_pca_recon[i, 0]], [X[i, 1], X_pca_recon[i, 1]],
                 'k-', alpha=0.1, linewidth=0.5)
axes[1].set_title('Reconstruction par ACP ($L=1$)')
axes[1].set_xlabel('$x_1$')
axes[1].set_ylabel('$x_2$')
axes[1].set_aspect('equal')

axes[2].scatter(X[:, 0], X[:, 1], s=8, c=t, cmap='viridis', alpha=0.2)
axes[2].scatter(X_ae_recon[:, 0], X_ae_recon[:, 1], s=8, c=t, cmap='viridis', alpha=0.7)
for i in range(0, N, 15):
    axes[2].plot([X[i, 0], X_ae_recon[i, 0]], [X[i, 1], X_ae_recon[i, 1]],
                 'k-', alpha=0.1, linewidth=0.5)
axes[2].set_title('Reconstruction par auto-encodeur ($L=1$)')
axes[2].set_xlabel('$x_1$')
axes[2].set_ylabel('$x_2$')
axes[2].set_aspect('equal')

plt.tight_layout()
W0409 22:49:32.675388 39650675 cpp_gen_intrinsics.cc:74] Empty bitcode string provided for eigen. Optimizations relying on this IR will be disabled.
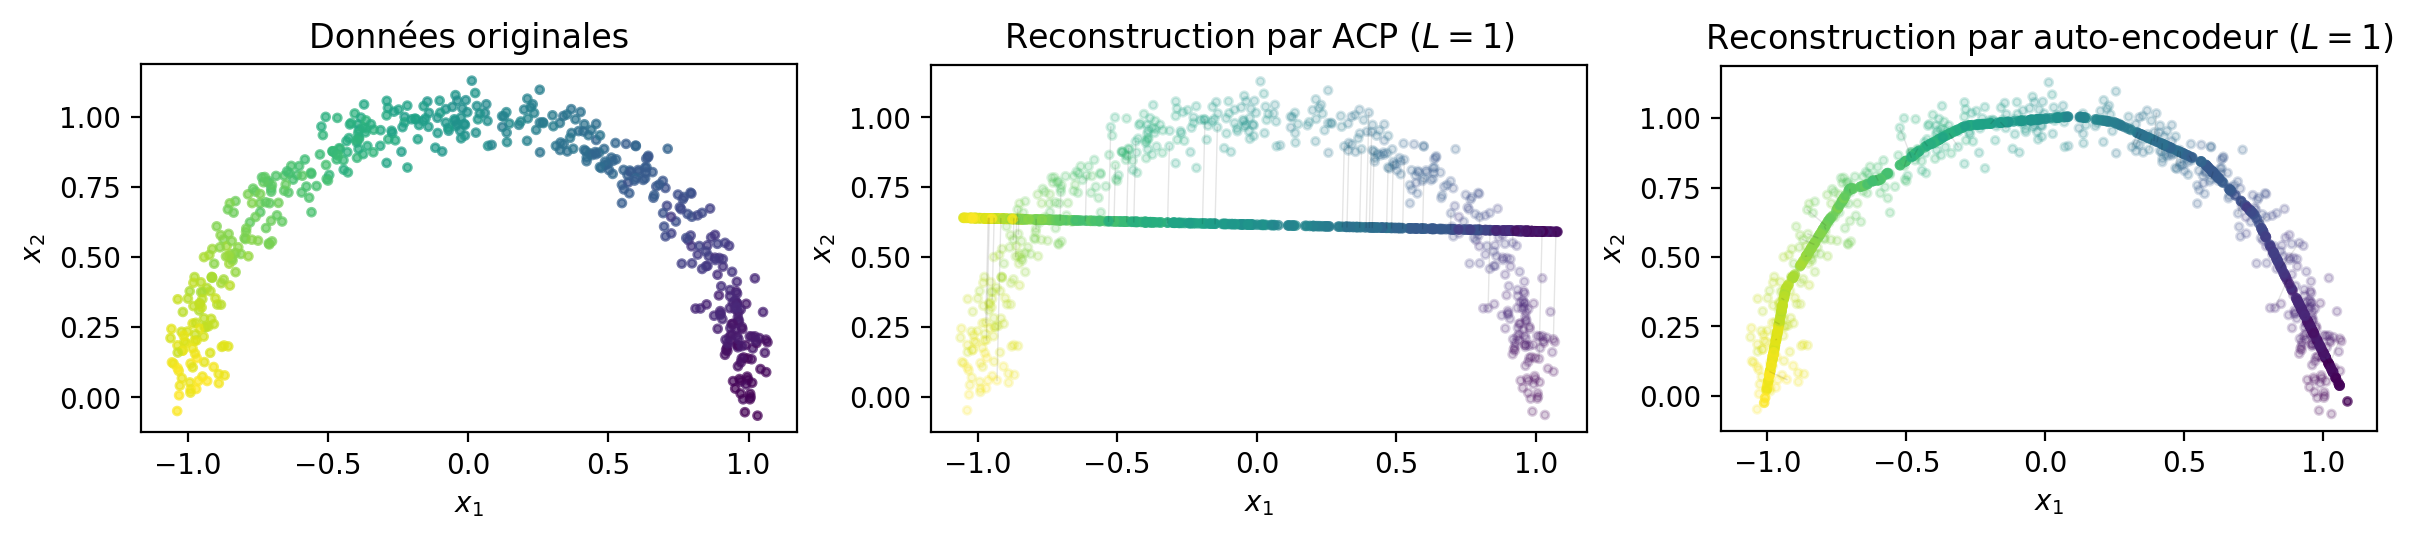
La figure ci-dessus illustre la différence entre l’ACP et un auto-encodeur non linéaire sur des données disposées en demi-cercle. L’ACP projette les données sur une droite (la direction de variance maximale), ce qui écrase la structure courbe. L’auto-encodeur, grâce à ses non-linéarités, apprend à projeter sur la variété courbe elle-même: chaque point est reconstruit près de sa position originale sur le demi-cercle. La dimension latente est dans les deux cas, mais l’auto-encodeur utilise cette unique dimension pour paramétrer la position le long de la courbe.
Auto-encodeur débruiteur
Motivation
Un auto-encodeur avec une capacité suffisante peut apprendre à reconstruire ses entrées presque parfaitement, sans pour autant apprendre des représentations utiles. Si le réseau mémorise chaque exemple individuellement, le code latent ne capture pas les régularités de la distribution, il encode simplement l’identité de chaque point.
L’auto-encodeur débruiteur (denoising autoencoder, DAE) contourne ce problème en modifiant la tâche d’entraînement Vincent et al. (2008). Au lieu de reconstruire à partir de , on corrompt d’abord l’entrée en , puis on entraîne le réseau à reconstruire l’entrée originale (propre) à partir de l’entrée corrompue:
La perte reste la même qu’en (2), mais l’entrée de l’encodeur est alors que la cible de reconstruction est :
où est le processus de corruption. En pratique, l’espérance est estimée en tirant une corruption différente à chaque passage d’un exemple dans le réseau (comme le dropout au chapitre 8, une nouvelle corruption est tirée à chaque itération).
Processus de corruption
Deux corruptions sont courantes:
Le bruit additif gaussien ajoute un bruit à l’entrée: . L’écart-type contrôle l’intensité de la corruption.
La corruption par masquage met à zéro une fraction des composantes de , choisies aléatoirement. Chaque composante est indépendamment mise à zéro avec probabilité . Cette corruption force le réseau à inférer les composantes manquantes à partir des composantes restantes, un peu comme on compléterait un mot à trous.
Interprétation géométrique
Pour reconstruire à partir de , le réseau doit apprendre à ramener les points bruités vers la variété des données. La reconstruction se trouve (idéalement) sur la variété, ou du moins plus près de celle-ci que . Le vecteur pointe donc approximativement vers la variété.
On peut montrer que, dans la limite d’un bruit gaussien de faible variance, la fonction de reconstruction optimale estime le gradient du logarithme de la densité des données Vincent (2011):
Ce gradient, appelé fonction de score (score function), indique la direction dans laquelle la densité des données augmente le plus vite. L’auto-encodeur débruiteur apprend donc implicitement la structure de la distribution des données, pas seulement une compression.
Source
# Illustration de l'auto-encodeur débruiteur sur des données 2D
np.random.seed(42)
N_dae = 300
t_dae = np.random.uniform(0, np.pi, N_dae)
X_clean = np.column_stack([np.cos(t_dae), np.sin(t_dae)])

# Corruption par bruit gaussien
sigma_noise = 0.3
X_noisy = X_clean + np.random.normal(0, sigma_noise, X_clean.shape)

fig, axes = plt.subplots(1, 2, figsize=(8, 3.5))

axes[0].scatter(X_clean[:, 0], X_clean[:, 1], s=10, alpha=0.5, label='Originales')
axes[0].scatter(X_noisy[:, 0], X_noisy[:, 1], s=10, alpha=0.3, marker='x', label='Corrompues')
axes[0].set_title('Données et corruption')
axes[0].set_xlabel('$x_1$')
axes[0].set_ylabel('$x_2$')
axes[0].set_aspect('equal')
axes[0].legend(fontsize=8)

# Flèches de reconstruction: de x_noisy vers x_clean (cible idéale)
# On montre un sous-ensemble pour la lisibilité
indices = np.random.choice(N_dae, 50, replace=False)
axes[1].scatter(X_noisy[:, 0], X_noisy[:, 1], s=10, alpha=0.2, color='C1')
for i in indices:
    axes[1].annotate('', xy=X_clean[i], xytext=X_noisy[i],
                     arrowprops=dict(arrowstyle='->', color='C0', alpha=0.4, lw=0.8))
# Tracer la variété
t_curve = np.linspace(0, np.pi, 200)
axes[1].plot(np.cos(t_curve), np.sin(t_curve), 'k-', linewidth=1.5, alpha=0.5, label='Variété')
axes[1].set_title('Vecteurs de reconstruction')
axes[1].set_xlabel('$x_1$')
axes[1].set_ylabel('$x_2$')
axes[1].set_aspect('equal')
axes[1].legend(fontsize=8)

plt.tight_layout()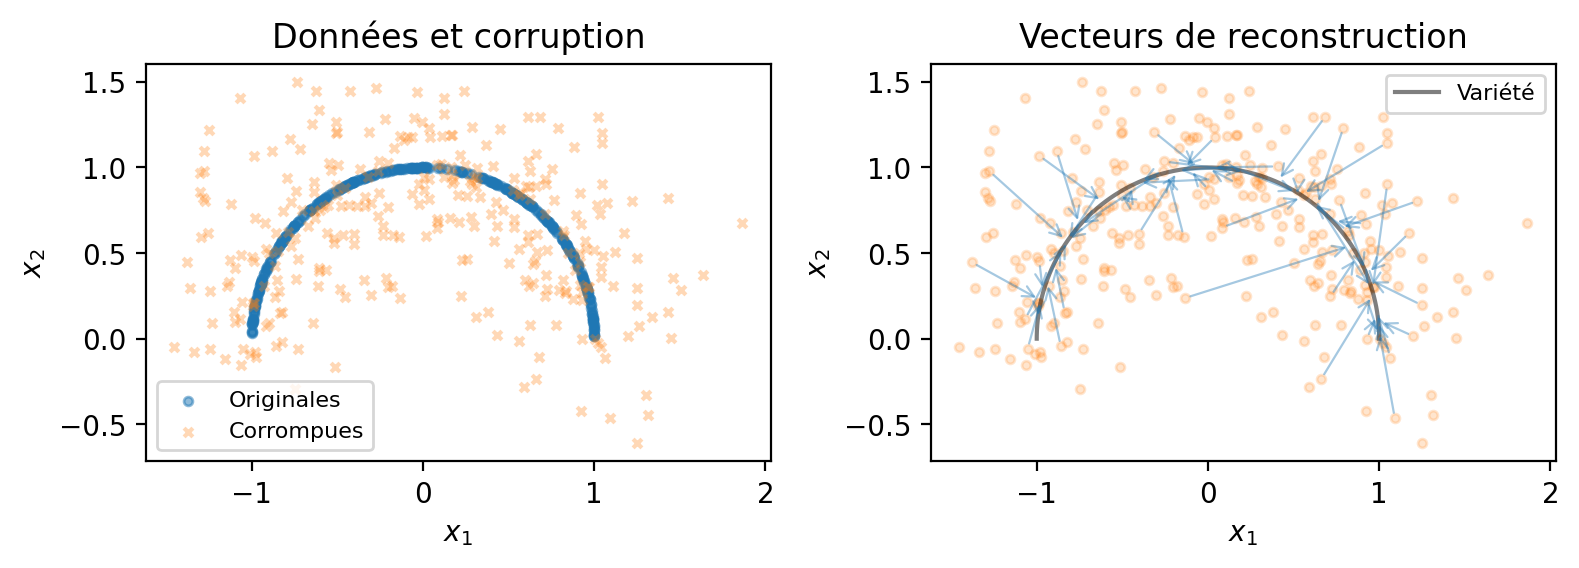
La figure de droite montre les vecteurs de reconstruction idéaux: chaque flèche part d’un point corrompu et pointe vers le point propre correspondant, c’est-à-dire vers la variété des données. Ces vecteurs approximent le gradient de la log-densité: ils indiquent la direction dans laquelle les données sont les plus probables.
Vers l’auto-encodeur variationnel
L’auto-encodeur standard apprend un encodeur déterministe: à chaque entrée correspond un unique code . Mais l’espace latent résultant n’a pas de structure particulière. Deux points proches dans l’espace latent ne correspondent pas nécessairement à des données similaires, et un point tiré au hasard dans l’espace latent ne correspond généralement à aucune donnée réaliste. On ne peut donc pas utiliser un auto-encodeur standard pour générer de nouvelles données.
L’auto-encodeur variationnel (VAE) Kingma & Welling (2014) résout ce problème en imposant une structure probabiliste à l’espace latent. Au lieu de produire un code déterministe , l’encodeur produit les paramètres d’une distribution: une moyenne et une variance pour chaque dimension latente. Le code est ensuite tiré aléatoirement de cette distribution:
L’entraînement du VAE ajoute un terme de régularisation qui force la distribution des codes à rester proche d’une gaussienne standard . Ce terme, une divergence de Kullback-Leibler, garantit que l’espace latent est continu et structuré: des points proches dans l’espace latent correspondent à des données similaires, et on peut générer de nouvelles données en décodant des points tirés de .
Le VAE se situe à l’intersection des auto-encodeurs et de l’inférence variationnelle que nous avons brièvement rencontrée au chapitre 6 (dans le contexte de l’algorithme EM et de l’ELBO). L’encodeur joue le rôle de la distribution variationnelle qui approxime l’a posteriori intractable . L’étude détaillée du VAE dépasse le cadre de ce cours; nous renvoyons le lecteur intéressé à des références spécialisées Kingma & Welling (2019).
Auto-encodeurs et pré-entraînement
Au chapitre 8, nous avons vu que le pré-entraînement couche par couche a été la première technique permettant d’entraîner des réseaux profonds. L’auto-encodeur a joué un rôle central dans cette approche Hinton & Salakhutdinov (2006)Bengio et al. (2007): chaque couche du réseau était pré-entraînée comme un auto-encodeur, apprenant à reconstruire ses entrées avant de passer à la couche suivante.
Cette technique a perdu de son importance avec l’arrivée de ReLU, de la normalisation par lots et des connexions résiduelles, qui permettent d’entraîner des réseaux profonds directement. Mais le principe sous-jacent reste pertinent: apprendre des représentations non supervisées, puis les transférer vers une tâche supervisée. Les représentations apprises par un auto-encodeur (ou un auto-encodeur débruiteur) sur un grand ensemble de données non étiquetées peuvent servir d’initialisation pour un réseau supervisé entraîné sur un petit ensemble étiqueté, suivant le schéma tronc-tête du chapitre 8.
Résumé
L’auto-encodeur apprend des représentations de basse dimension en minimisant l’erreur de reconstruction entre l’entrée et sa version comprimée puis reconstruite. Le goulot d’étranglement force le réseau à capturer la structure essentielle des données.
Quand l’encodeur et le décodeur sont linéaires, l’auto-encodeur retrouve la solution de l’ACP: la projection sur le sous-espace de variance maximale. Le passage aux non-linéarités permet de capturer des variétés courbes que l’ACP ne peut pas représenter.
L’auto-encodeur débruiteur renforce les représentations en entraînant le réseau à reconstruire des entrées propres à partir de versions corrompues. Dans la limite de faible bruit, cette tâche revient à estimer le gradient de la log-densité des données.
L’auto-encodeur variationnel ajoute une structure probabiliste à l’espace latent, ce qui permet de générer de nouvelles données et relie l’auto-encodeur au cadre de l’inférence variationnelle.
Exercices
Exercice 1: Reconstruction par auto-encodeur linéaire ★
Soit un auto-encodeur linéaire avec poids liés () et . La matrice de covariance empirique des données centrées est:
Calculez les valeurs propres et les vecteurs propres de .
Pour , quel est le optimal?
Quelle est l’erreur de reconstruction minimale?
Quelle proportion de la variance totale est préservée par la projection?
Solution Exercice 1
Le polynôme caractéristique est , donc et .
Pour : donne , soit .
Pour : .
Le optimal est le vecteur propre associé à la plus grande valeur propre: .
L’erreur de reconstruction minimale est (la variance dans la direction ignorée).
La variance totale est . La variance préservée est , soit .
Exercice 2: Auto-encodeur débruiteur ★
Considérons un auto-encodeur débruiteur avec corruption gaussienne , .
Si les données sont tirées d’une gaussienne , quelle est la reconstruction optimale (au sens des moindres carrés) de étant donné ?
Indice: calculez en utilisant le fait que est conjointement gaussien.
Montrez que le vecteur de reconstruction est proportionnel à dans ce cas.
Solution Exercice 2
Puisque avec et indépendants, la distribution jointe est gaussienne avec:
La reconstruction optimale est:
C’est un moyennage entre la moyenne a priori et l’observation bruitée , pondéré par le rapport signal sur bruit dans chaque direction.
La distribution marginale de est , donc:
Le vecteur de reconstruction est:
Donc , ce qui confirme le résultat annoncé dans le chapitre.
Exercice 3: Dimension latente et reconstruction ★★
Soit un auto-encodeur linéaire (sans biais) avec des données en dont la matrice de covariance a les valeurs propres , , .
Calculez l’erreur de reconstruction pour et .
Quel pourcentage de la variance totale est capturé dans chaque cas?
En voyant ces chiffres, quel choisiriez-vous? Justifiez.
Si l’on utilise un auto-encodeur non linéaire avec , l’erreur de reconstruction peut-elle être inférieure à celle de l’auto-encodeur linéaire avec ? Expliquez.
Solution Exercice 3
Pour : . Pour : .
Variance totale: .
:
:
semble préférable: on passe de 74% à 96% de variance expliquée en ajoutant une seule dimension. Le gain relatif est important et est faible par rapport aux deux autres valeurs propres, ce qui suggère que la troisième direction est principalement du bruit.
Oui. Si les données vivent sur une variété courbe de dimension 1 (par exemple une spirale dans ), un auto-encodeur non linéaire peut paramétrer cette variété avec une seule dimension latente et obtenir une erreur de reconstruction proche de zéro (limitée seulement par le bruit). L’ACP, étant linéaire, ne peut projeter que sur une droite et perd toute la structure courbe.
Exercice 4: Implémentation d’un auto-encodeur ★★
Implémentez un auto-encodeur en NumPy pour des données 2D.
Générez points sur un cercle bruité: avec et .
Construisez un auto-encodeur avec l’architecture (activation ReLU pour les couches cachées, pas d’activation en sortie).
Entraînez par descente de gradient (taux d’apprentissage , 5000 itérations sur tout le jeu de données).
Tracez les données originales et les reconstructions. Comparez avec la reconstruction par ACP ().
Tracez le code latent en fonction de (le paramètre du cercle). Que constatez-vous?
Solution Exercice 4
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
N = 500
theta = np.random.uniform(0, 2 * np.pi, N)
X = np.column_stack([np.cos(theta), np.sin(theta)])
X += np.random.normal(0, 0.05, X.shape)

# Centrage
mu = X.mean(axis=0)
Xc = X - mu

# Initialisation He
rng = np.random.RandomState(0)
W1 = rng.randn(2, 32) * np.sqrt(2.0 / 2)
b1 = np.zeros(32)
W2 = rng.randn(32, 1) * np.sqrt(2.0 / 32)
b2 = np.zeros(1)
W3 = rng.randn(1, 32) * np.sqrt(2.0 / 1)
b3 = np.zeros(32)
W4 = rng.randn(32, 2) * np.sqrt(2.0 / 32)
b4 = np.zeros(2)

relu = lambda x: np.maximum(0, x)
relu_grad = lambda x: (x > 0).astype(float)

lr = 0.001
for epoch in range(5000):
    h1 = Xc @ W1 + b1;  a1 = relu(h1)
    z = a1 @ W2 + b2
    h3 = z @ W3 + b3;    a3 = relu(h3)
    xhat = a3 @ W4 + b4
    diff = xhat - Xc
    # Rétropropagation
    dxhat = 2 * diff / N
    dW4 = a3.T @ dxhat;      db4 = dxhat.sum(0)
    da3 = dxhat @ W4.T;      dh3 = da3 * relu_grad(h3)
    dW3 = z.T @ dh3;         db3 = dh3.sum(0)
    dz = dh3 @ W3.T
    dW2 = a1.T @ dz;         db2 = dz.sum(0)
    da1 = dz @ W2.T;         dh1 = da1 * relu_grad(h1)
    dW1 = Xc.T @ dh1;        db1 = dh1.sum(0)
    for p, g in [(W1,dW1),(b1,db1),(W2,dW2),(b2,db2),
                 (W3,dW3),(b3,db3),(W4,dW4),(b4,db4)]:
        p -= lr * g

# Reconstruction
h1 = Xc @ W1 + b1; a1 = relu(h1)
z_final = a1 @ W2 + b2
h3 = z_final @ W3 + b3; a3 = relu(h3)
X_recon = a3 @ W4 + b4 + mu

plt.figure(figsize=(6, 6))
plt.scatter(X[:, 0], X[:, 1], s=5, alpha=0.3, label='Données')
plt.scatter(X_recon[:, 0], X_recon[:, 1], s=5, alpha=0.5, label='Reconstruction')
plt.legend()
plt.axis('equal')
plt.tight_layout()
Le code latent en fonction de devrait montrer une relation monotone (au moins par morceaux): le réseau a appris à paramétrer la position sur le cercle avec un seul nombre réel. La relation n’est pas nécessairement linéaire car le réseau peut choisir une paramétrisation arbitraire. Avec un seul neurone latent, le réseau ne peut pas reconstruire le cercle entier de manière continue (le cercle n’est pas homéomorphe à un segment de droite), donc on observe une discontinuité.
Exercice 5: L’auto-encodeur peut-il apprendre l’identité? ★★
Considérons un auto-encodeur avec (pas de goulot d’étranglement).
Montrez qu’il existe un choix de paramètres pour lequel l’erreur de reconstruction est nulle.
Cet auto-encodeur apprend-il une représentation utile? Pourquoi?
Proposez deux modifications de l’architecture ou de l’entraînement qui forcent l’apprentissage de représentations utiles même quand .
Solution Exercice 5
Si , l’encodeur et le décodeur peuvent chacun apprendre la fonction identité: et . La reconstruction est exacte et la perte est nulle. Avec des activations ReLU, cela est réalisable si les poids sont des matrices identité et les biais sont nuls (les entrées non négatives passent directement; pour des entrées de signe quelconque, on peut utiliser deux neurones par dimension pour encoder les parties positive et négative).
Non. La fonction identité ne capture aucune structure des données. Le code n’est pas comprimé et ne révèle rien sur la distribution sous-jacente.
Deux approches:
L’auto-encodeur débruiteur (corrompre l’entrée) force le réseau à apprendre la structure des données même sans goulot d’étranglement, car reconstruire à partir de exige de comprendre les dépendances entre les composantes.
Ajouter une pénalité de parcimonie sur le code (par exemple, ) force la plupart des dimensions latentes à être proches de zéro. Seules quelques dimensions sont actives pour chaque entrée, ce qui produit une représentation comprimée même si .
- Baldi, P., & Hornik, K. (1989). Neural Networks and Principal Component Analysis: Learning from Examples Without Local Minima. Neural Networks, 2(1), 53–58.
- Vincent, P., Larochelle, H., Bengio, Y., & Manzagol, P.-A. (2008). Extracting and Composing Robust Features with Denoising Autoencoders. Proceedings of the 25th International Conference on Machine Learning (ICML), 1096–1103.
- Vincent, P. (2011). A Connection Between Score Matching and Denoising Autoencoders. Neural Computation, 23(7), 1661–1674.
- Kingma, D. P., & Welling, M. (2014). Auto-Encoding Variational Bayes. arXiv Preprint arXiv:1312.6114.
- Kingma, D. P., & Welling, M. (2019). An Introduction to Variational Autoencoders. Foundations and Trends in Machine Learning, 12(4), 307–392.
- Hinton, G. E., & Salakhutdinov, R. R. (2006). Reducing the Dimensionality of Data with Neural Networks. Science, 313(5786), 504–507.
- Bengio, Y., Lamblin, P., Popovici, D., & Larochelle, H. (2007). Greedy Layer-Wise Training of Deep Networks. Advances in Neural Information Processing Systems (NeurIPS).