Le chapitre précédent a montré comment les réseaux récurrents traitent les séquences en maintenant un état caché mis à jour à chaque pas de temps. Cette approche a deux limitations: le traitement est séquentiel (on ne peut pas paralléliser le calcul des différentes positions), et toute l’information doit transiter par un vecteur de taille fixe .
Le mécanisme d’attention résout ces deux problèmes en permettant à chaque position d’une séquence de consulter directement toutes les autres. Au lieu de compresser l’information dans un seul vecteur, l’attention calcule une moyenne pondérée sur toutes les positions, avec des poids appris qui dépendent du contenu. Le transformeur construit une architecture complète autour de ce mécanisme, en remplaçant entièrement la récurrence par de l’attention.
Dans ce chapitre, nous commençons par l’intuition derrière l’attention, puis nous formalisons le mécanisme avec les requêtes, clés et valeurs. Nous passons ensuite à l’auto-attention (où une séquence s’interroge elle-même), à l’attention multi-têtes, puis à l’architecture complète du transformeur. Nous terminons par les variantes (encodeur, décodeur, encodeur-décodeur) et les raisons de la domination actuelle des transformeurs.
L’attention: accès sélectif à l’information
Considérons la traduction d’une phrase du français vers l’anglais avec un RNN encodeur-décodeur. L’encodeur lit la phrase source mot par mot et produit un état final qui résume toute la phrase. Le décodeur génère ensuite la traduction mot par mot à partir de cet état.
Le problème est que doit contenir toute l’information nécessaire pour traduire chaque mot de la phrase cible. Pour une phrase courte, c’est faisable. Pour une phrase longue, l’information est inévitablement compressée et dégradée.
Un traducteur humain ne procède pas ainsi. En traduisant le cinquième mot de la phrase cible, il retourne consulter les mots pertinents de la phrase source, pas un résumé compressé de toute la phrase. Le mécanisme d’attention imite ce comportement: à chaque pas de la génération, le décodeur peut “regarder en arrière” vers toutes les positions de l’encodeur et sélectionner l’information pertinente.
Cette idée, proposée par Bahdanau et al. Bahdanau et al. (2015), a transformé la traduction automatique neuronale. Nous allons la formaliser, puis la généraliser au-delà du cadre encodeur-décodeur.
Requêtes, clés et valeurs
Le mécanisme d’attention repose sur trois ingrédients. Nous disposons d’un ensemble de positions, chacune associée à un vecteur de représentation. L’attention extrait de l’information de ces positions en fonction d’une requête.
Soit une séquence de représentations , chaque . Nous définissons:
la requête (query) : ce que nous cherchons;
les clés (keys) : ce que chaque position “annonce” contenir;
les valeurs (values) : l’information effectivement stockée à chaque position.
Cette terminologie s’éclaire par analogie avec un dictionnaire Python. Un dictionnaire fait une consultation dure: d[clé] retourne exactement une valeur, ou échoue si la clé est absente. L’attention fait une consultation souple: la requête est comparée à toutes les clés simultanément, et la sortie est un mélange des valeurs pondéré par le degré de correspondance entre la requête et chaque clé.
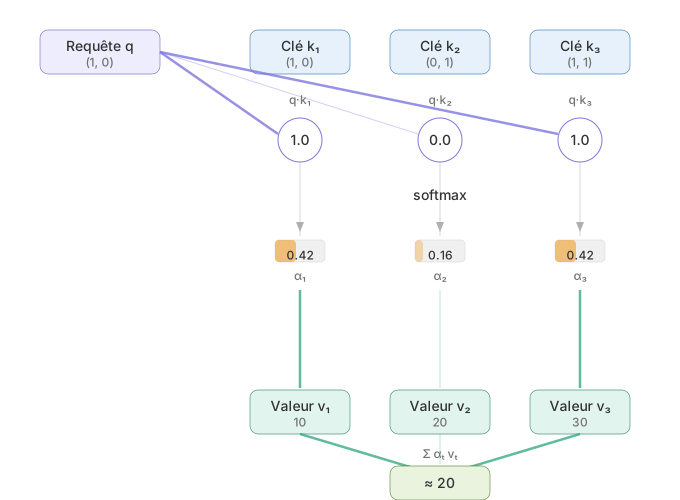
Figure 1:Le mécanisme d’attention: la requête est comparée à chaque clé, les scores sont normalisés par softmax, et la sortie est la somme pondérée des valeurs.
Quand les poids sont concentrés sur une seule position, la consultation souple se rapproche d’une consultation dure; quand ils sont uniformes, la sortie est la moyenne de toutes les valeurs.
L’attention calcule un score de similarité entre la requête et chaque clé, normalise ces scores en probabilités, puis retourne la moyenne pondérée des valeurs:
Le score mesure la compatibilité entre la requête et la clé à la position . Le softmax (1) transforme ces scores en poids positifs qui somment à 1. La sortie (2) est une combinaison convexe des valeurs, pondérée par la pertinence de chaque position.
Prenons un exemple concret avec 3 positions et une requête . Si les clés sont , , , les scores sont 1, 0 et 1: la requête « sélectionne » les positions dont les clés ont une forte composante en première dimension. Après le softmax, les positions 1 et 3 reçoivent chacune environ 42% du poids, tandis que la position 2 n’en reçoit que 16%. La sortie est dominée par les valeurs des positions les plus compatibles avec la requête.
La division par est une normalisation. Sans elle, quand la dimension est grande, les produits scalaires tendent à avoir des magnitudes élevées, ce qui pousse le softmax vers des distributions très piquées (presque concentrées sur un seul élément). La normalisation par maintient la variance des scores à une échelle raisonnable.
En notation matricielle, si nous traitons toutes les requêtes simultanément ( est la matrice des requêtes, celle des clés, celle des valeurs):
Le produit contient tous les scores de similarité. Le softmax est appliqué sur chaque ligne (chaque requête). La multiplication par produit la sortie .
L’animation interactive ci-dessous permet de manipuler la requête et d’observer comment les poids d’attention et la sortie changent en temps réel. Les boutons de préréglage illustrent les scénarios clés: sélection d’une position, attention uniforme, ou mélange intermédiaire. Le curseur de température généralise la normalisation par : une valeur faible produit une consultation quasi dure, une valeur élevée adoucit la distribution.
/Users/pierre-luc.bacon/Documents/mlbook/.venv/lib/python3.12/site-packages/IPython/core/display.py:447: UserWarning: Consider using IPython.display.IFrame instead
  warnings.warn("Consider using IPython.display.IFrame instead")
Auto-attention
Dans le mécanisme d’attention décrit ci-dessus, les requêtes proviennent d’une séquence et les clés/valeurs d’une autre (par exemple, le décodeur interroge l’encodeur). C’est l’attention croisée.
L’auto-attention (self-attention) est le cas où les requêtes, clés et valeurs proviennent toutes de la même séquence. Chaque position de la séquence interroge toutes les autres positions (y compris elle-même) pour construire une nouvelle représentation qui intègre le contexte global.
Concrètement, soit la matrice des représentations d’entrée (une ligne par position). On définit trois projections linéaires apprises:
où et sont des matrices de paramètres. La sortie est:
La sortie a la même forme que l’entrée: vecteurs de dimension . Chaque vecteur de sortie est une combinaison pondérée de toutes les valeurs, les poids étant déterminés par la similarité entre la requête de cette position et les clés de toutes les autres positions.
Prenons un exemple concret. Dans la phrase « Le chat qui dormait sur le canapé s’est réveillé », le mot « réveillé » doit savoir que son sujet est « chat » pour construire une représentation utile. L’auto-attention peut capturer cette dépendance: les matrices et projettent les représentations de « réveillé » et « chat » dans un espace où leur produit scalaire est élevé, ce qui donne un poids d’attention fort entre ces deux positions. Le vecteur de sortie pour « réveillé » incorpore alors l’information de « chat ». Les matrices de projection , et déterminent quel type de relation l’attention capture. Un seul jeu de matrices ne peut encoder qu’une seule notion de similarité entre positions. Nous verrons à la section suivante comment l’attention multi-têtes dépasse cette limitation.
Une propriété importante de l’auto-attention est qu’elle est équivariante par permutation: si l’on permute les lignes de , les lignes de la sortie sont permutées de la même façon. L’auto-attention ne contient aucune notion d’ordre intrinsèque. Contrairement au RNN, où la position reçoit nécessairement l’information des positions via , l’auto-attention traite toutes les positions de façon symétrique. Nous verrons plus loin comment l’encodage positionnel restaure la notion d’ordre.
import numpy as np
from scipy.special import softmax

def self_attention(X, W_Q, W_K, W_V):
    d_k = W_Q.shape[1]
    Q, K, V = X @ W_Q, X @ W_K, X @ W_V
    scores = Q @ K.T / d_k**0.5
    weights = softmax(scores, axis=-1)
    return weights @ V

rng = np.random.default_rng(0)
T, d, d_k = 4, 8, 3
X = rng.standard_normal((T, d))
W_Q = rng.standard_normal((d, d_k))
W_K = rng.standard_normal((d, d_k))
W_V = rng.standard_normal((d, d_k))

# Sortie sur l'entrée originale
Y = self_attention(X, W_Q, W_K, W_V)

# Permuter les lignes de X, puis calculer l'auto-attention
perm = [2, 0, 3, 1]
Y_perm = self_attention(X[perm], W_Q, W_K, W_V)

# Comparer: permuter la sortie vs calculer sur l'entrée permutée
print("Y permutée (Y[perm]):")
print(np.round(Y[perm], 4))
print("\nAuto-attention sur X permutée:")
print(np.round(Y_perm, 4))
print("\nIdentiques ?", np.allclose(Y[perm], Y_perm))
Y permutée (Y[perm]):
[[ 4.5165 1.9008 -0.2993]
[ 0.5129 -0.6411 -1.1559]
[ 2.5529 4.5957 -0.3496]
[ 2.5089 4.5356 -0.3696]]
Auto-attention sur X permutée:
[[ 4.5165 1.9008 -0.2993]
[ 0.5129 -0.6411 -1.1559]
[ 2.5529 4.5957 -0.3496]
[ 2.5089 4.5356 -0.3696]]
Identiques ? True
Chemins directs entre positions
Dans un RNN, l’information de la position 1 doit traverser la chaîne pour atteindre la position . À chaque transition, le signal est transformé et potentiellement atténué. Comme nous l’avons vu au chapitre 9, cette chaîne est précisément ce qui cause la dissolution du gradient: le gradient subit multiplications matricielles successives, et sa norme tend à décroître exponentiellement avec la longueur de la séquence.
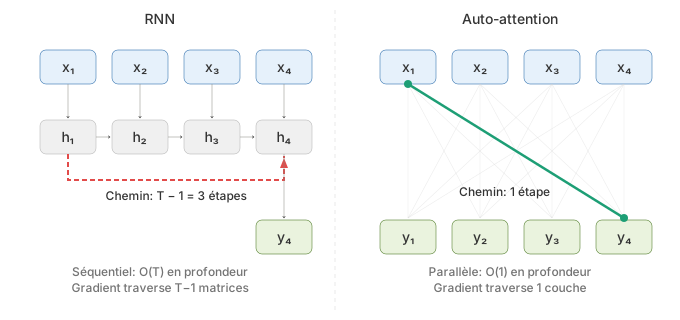
Figure 2:À gauche, la chaîne séquentielle d’un RNN: l’information de doit traverser chaque état caché pour atteindre . À droite, l’auto-attention connecte directement chaque position d’entrée à chaque position de sortie.
L’auto-attention élimine ce goulot d’étranglement: chaque position de sortie est directement connectée à chaque position d’entrée en une seule couche, sans intermédiaire. Là où le RNN impose un chemin de longueur , l’auto-attention n’a besoin que d’un seul pas.
La conséquence pour l’entraînement est directe: un chemin court entre deux positions signifie un chemin court pour le gradient. Les connexions résiduelles du bloc transformeur (section suivante) amplifient cet effet en ajoutant un chemin d’identité à travers chaque couche.
Attention multi-têtes
Comme nous l’avons vu, un seul jeu de matrices de projection ne capture qu’un seul type de relation. Or, dans « Le chat qui dormait sur le canapé s’est réveillé », le mot « dormait » entretient à la fois une relation syntaxique avec « chat » (son sujet) et une relation de proximité avec « canapé » (son complément de lieu). Un seul mécanisme d’attention doit choisir: il ne peut pas donner un poids élevé à « chat » et à « canapé » pour des raisons différentes avec une seule paire .
L’attention multi-têtes exécute mécanismes d’attention en parallèle, chacun avec ses propres projections. La tête calcule:
où et . On choisit typiquement pour que le coût total soit comparable à une seule tête de dimension .
Les sorties des têtes sont concaténées puis projetées:
où ramène la dimension à .
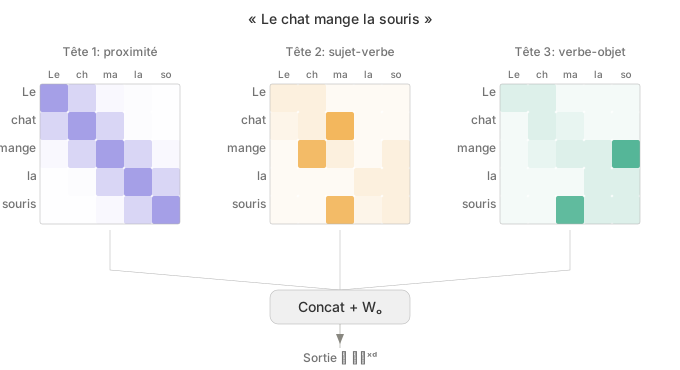
Figure 3:Attention multi-têtes: chaque tête apprend des projections distinctes et capture un type de relation différent. Ici, trois têtes sur la phrase « Le chat mange la souris » illustrent des spécialisations possibles.
Chaque tête peut apprendre à capturer un type de relation différent: une tête peut se spécialiser dans les dépendances locales, une autre dans les dépendances à longue portée, une autre encore dans les relations syntaxiques.
Lien avec la régression à noyau
L’attention par produit scalaire est un cas particulier d’une famille plus ancienne: la régression non paramétrique à noyau. L’estimateur de Nadaraya-Watson Nadaraya (1964)Watson (1964) prédit la sortie pour un point par une moyenne pondérée des observations:
Avec un noyau gaussien , le lien avec l’attention est exact, pas seulement structurel. En développant , le terme est constant pour toutes les positions et disparaît dans le rapport du softmax. Si les clés ont des normes comparables, le score se réduit à : un produit scalaire mis à l’échelle, exactement la forme de l’attention avec jouant le rôle de (l’exercice 5 développe cette dérivation en détail).
La correspondance devient plus révélatrice quand on examine ce que l’attention apprend. Dans Nadaraya-Watson, le noyau est fixé a priori. Dans l’attention, les projections et induisent un noyau effectif . La matrice apprend quelles directions de l’espace d’entrée sont pertinentes pour la comparaison, de façon analogue à l’apprentissage de la forme et de la bande passante du noyau Tsai et al. (2019). Contrairement aux noyaux classiques en statistique, qui mesurent une similarité symétrique (), cette matrice est en général asymétrique (), ce qui permet à l’attention de traiter différemment la relation « sujet → verbe » et la relation « verbe → sujet » Wright & Gonzalez (2021).
La divergence la plus profonde concerne . Dans Nadaraya-Watson, les « valeurs » sont les observations brutes: l’estimateur ne peut retourner que des moyennes pondérées des données. Si l’on pose , l’attention se réduit exactement à Nadaraya-Watson. Mais une projection apprise transforme ce que chaque position offre avant l’agrégation. L’attention apprend simultanément comment pondérer (via , ) et quoi retourner (via ). L’attention multi-têtes pousse cette idée plus loin: estimateurs à noyau indépendants, chacun avec ses propres projections , combinés linéairement par — un ensemble de régresseurs à noyau spécialisés.
Le lien avec la régression à noyau dépasse le cas gaussien. En régression non paramétrique, le noyau gaussien attribue un poids non nul à tous les points, même très éloignés. D’autres noyaux classiques — Epanechnikov, biweight, triweight — attribuent un poids nul au-delà d’une certaine distance (on dit qu’ils sont à support compact). Ils diffèrent par la douceur de la transition vers zéro: l’Epanechnikov est linéaire, le biweight quadratique, le triweight cubique. Santos et al. Santos et al. (2026) montrent que remplacer le softmax par sparsemax dans le mécanisme d’attention produit exactement le noyau d’Epanechnikov, et que -entmax avec engendre toute cette hiérarchie: Epanechnikov (), biweight (), triweight (), gaussien (). Le choix de la fonction de normalisation dans l’attention est donc équivalent au choix du noyau en régression non paramétrique, chacun avec son propre compromis biais-variance.
Le bloc transformeur
Le transformeur Vaswani et al. (2017) construit une architecture profonde en empilant des blocs identiques. Chaque bloc combine l’attention multi-têtes avec un réseau à propagation avant (un petit MLP), le tout stabilisé par des connexions résiduelles et la normalisation de couche.
Un bloc transformeur applique les opérations suivantes:
où FFN est un réseau à propagation avant appliqué indépendamment à chaque position:
avec , , et typiquement 4 fois .
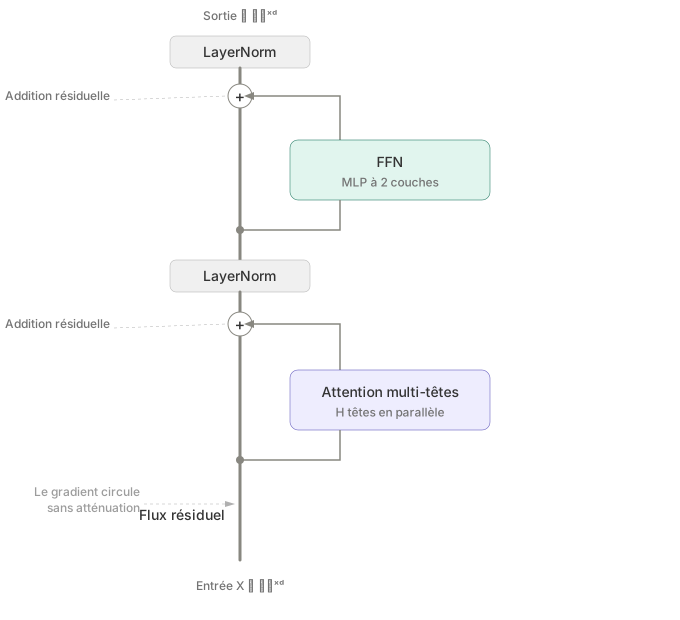
Figure 4:Un bloc transformeur. Le chemin résiduel (flèche verticale) transporte le signal sans transformation, tandis que l’attention multi-têtes et le réseau à propagation avant modifient ce signal par addition.
Les connexions résiduelles ( au lieu de seul) sont le même mécanisme que dans les réseaux résiduels (ResNets): elles permettent au gradient de circuler sans atténuation à travers les couches, ce qui rend possible l’entraînement de réseaux profonds.
La normalisation de couche (layer normalization) normalise les activations à chaque position indépendamment, ce qui stabilise l’entraînement. Elle remplace la normalisation par lots (batch normalization) vue au chapitre 8, car cette dernière est mal adaptée aux séquences de longueurs variables.
Un transformeur complet empile de ces blocs (typiquement à selon la taille du modèle). L’entrée du premier bloc est la séquence de représentations initiales (par exemple, les vecteurs d’un plongement de mots). La sortie du dernier bloc est la séquence de représentations contextualisées.
Encodage positionnel
L’auto-attention est équivariante par permutation: elle produit le même résultat quelle que soit l’ordre des positions. Considérons les mots [mange, le, chat, souris, la] et [le, chat, mange, la, souris]. Sans encodage positionnel, l’auto-attention produit les mêmes représentations de sortie (à permutation des lignes près), car elle opère sur un ensemble de vecteurs, pas sur une séquence ordonnée. L’encodage positionnel brise cette symétrie pour que le transformeur distingue l’ordre des mots.
L’encodage positionnel ajoute un vecteur dépendant de la position à chaque représentation d’entrée:
où encode la position . Le transformeur original Vaswani et al. (2017) utilise des fonctions sinusoïdales:
Chaque paire de dimensions oscille à une fréquence différente, déterminée par . La première paire () a une longueur d’onde de positions: elle change rapidement et distingue des positions voisines. La dernière paire () a une longueur d’onde d’environ positions: elle varie à peine sur une séquence de quelques centaines de mots. Cette combinaison de fréquences fonctionne comme un système de numération: les basses fréquences encodent la position grossière (début, milieu ou fin de la séquence) tandis que les hautes fréquences encodent la position fine (la distinction entre positions adjacentes). Le modèle peut extraire des relations de position relatives par combinaison linéaire, puisque s’exprime comme une transformation linéaire de pour tout décalage fixé (chaque paire sin/cos se transforme par une rotation d’angle ).
Une alternative courante est d’utiliser des encodages positionnels appris: chaque position a un vecteur qui est un paramètre du modèle, optimisé pendant l’entraînement. Les deux approches fonctionnent bien en pratique.
Comment des vecteurs initialisés aléatoirement apprennent-ils à encoder la position? Pour le voir, considérons une expérience simple. On entraîne un unique bloc d’auto-attention sur la tâche « prédire le vecteur à la position précédente »: étant donné une séquence , la sortie à la position doit être . Cette tâche exige de savoir quelle position est « la précédente », ce qui est impossible sans information de position. Les encodages positionnels , initialisés aléatoirement, sont la seule source de cette information. Le gradient de la perte les organise pour que l’attention puisse distinguer les positions.
Source
import numpy as np
from scipy.special import softmax
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

rng = np.random.default_rng(42)
T, d = 16, 16
B = 32  # taille de lot

# Paramètres (initialisés aléatoirement)
P = rng.standard_normal((T, d)) * 0.05      # encodages positionnels à apprendre
Wq = rng.standard_normal((d, d)) * (2/d)**0.5
Wk = rng.standard_normal((d, d)) * (2/d)**0.5
Wv = rng.standard_normal((d, d)) * (2/d)**0.5
W_out = rng.standard_normal((d, d)) * (2/d)**0.5

# Attention positionnelle avant entraînement
Q0i = P @ Wq; K0i = P @ Wk
A_init = softmax(Q0i @ K0i.T / d**0.5, axis=-1)

# Adam pour chaque paramètre
params = [P, Wq, Wk, Wv, W_out]
m_s = [np.zeros_like(p) for p in params]
v_s = [np.zeros_like(p) for p in params]
eta, b1, b2, eps = 0.001, 0.9, 0.999, 1e-8

losses = []
for step in range(3000):
    x = rng.standard_normal((B, T, d)) * 0.5
    X = x + P  # ajouter les encodages positionnels

    # Cible: le vecteur à la position précédente
    target = np.zeros_like(x)
    target[:, 1:, :] = x[:, :-1, :]

    # Passe avant
    Q = X @ Wq; K = X @ Wk; V = X @ Wv
    scores = Q @ K.transpose(0, 2, 1) / d**0.5
    A = softmax(scores, axis=-1)
    Z = A @ V
    y = Z @ W_out
    losses.append(0.5 * np.mean((y - target)**2))

    # Passe arrière (rétropropagation manuelle à travers l'attention)
    dy = (y - target) / (B * T * d)
    dW_out = np.einsum('btk,btj->kj', Z, dy)
    dZ = dy @ W_out.T
    dA = dZ @ V.transpose(0, 2, 1)
    dV = A.transpose(0, 2, 1) @ dZ
    dS = A * (dA - (A * dA).sum(axis=-1, keepdims=True)) / d**0.5
    dQ = dS @ K; dK = dS.transpose(0, 2, 1) @ Q
    dX = dQ @ Wq.T + dK @ Wk.T + dV @ Wv.T
    dP = dX.sum(axis=0)  # somme sur le lot
    dWq = np.einsum('bti,btj->ij', X, dQ)
    dWk = np.einsum('bti,btj->ij', X, dK)
    dWv = np.einsum('bti,btj->ij', X, dV)

    grads = [dP, dWq, dWk, dWv, dW_out]
    t_ = step + 1
    for i in range(5):
        m_s[i] = b1 * m_s[i] + (1 - b1) * grads[i]
        v_s[i] = b2 * v_s[i] + (1 - b2) * grads[i]**2
        mhat = m_s[i] / (1 - b1**t_)
        vhat = v_s[i] / (1 - b2**t_)
        params[i] -= eta * mhat / (np.sqrt(vhat) + eps)

# Attention positionnelle après entraînement (x = 0, position seule)
Q0 = P @ Wq; K0 = P @ Wk
A_final = softmax(Q0 @ K0.T / d**0.5, axis=-1)

fig, axes = plt.subplots(1, 3, figsize=(13, 4))

im0 = axes[0].imshow(A_init, cmap='Blues', vmin=0, vmax=0.3)
axes[0].set_title('Attention avant entraînement', fontsize=10)
axes[0].set_xlabel('Position source (clé)')
axes[0].set_ylabel('Position cible (requête)')
plt.colorbar(im0, ax=axes[0], shrink=0.8)

im1 = axes[1].imshow(A_final, cmap='Blues', vmin=0, vmax=1)
axes[1].set_title('Attention après entraînement', fontsize=10)
axes[1].set_xlabel('Position source (clé)')
axes[1].set_ylabel('Position cible (requête)')
plt.colorbar(im1, ax=axes[1], shrink=0.8)

axes[2].semilogy(losses, 'C0-', lw=1.5)
axes[2].set_xlabel('Itération')
axes[2].set_ylabel('Perte (MSE)')
axes[2].set_title('Convergence', fontsize=10)
axes[2].grid(True, alpha=0.3)

plt.suptitle("Apprentissage d'encodages positionnels sur la tâche « prédire le mot précédent »",
             fontsize=11)
plt.tight_layout()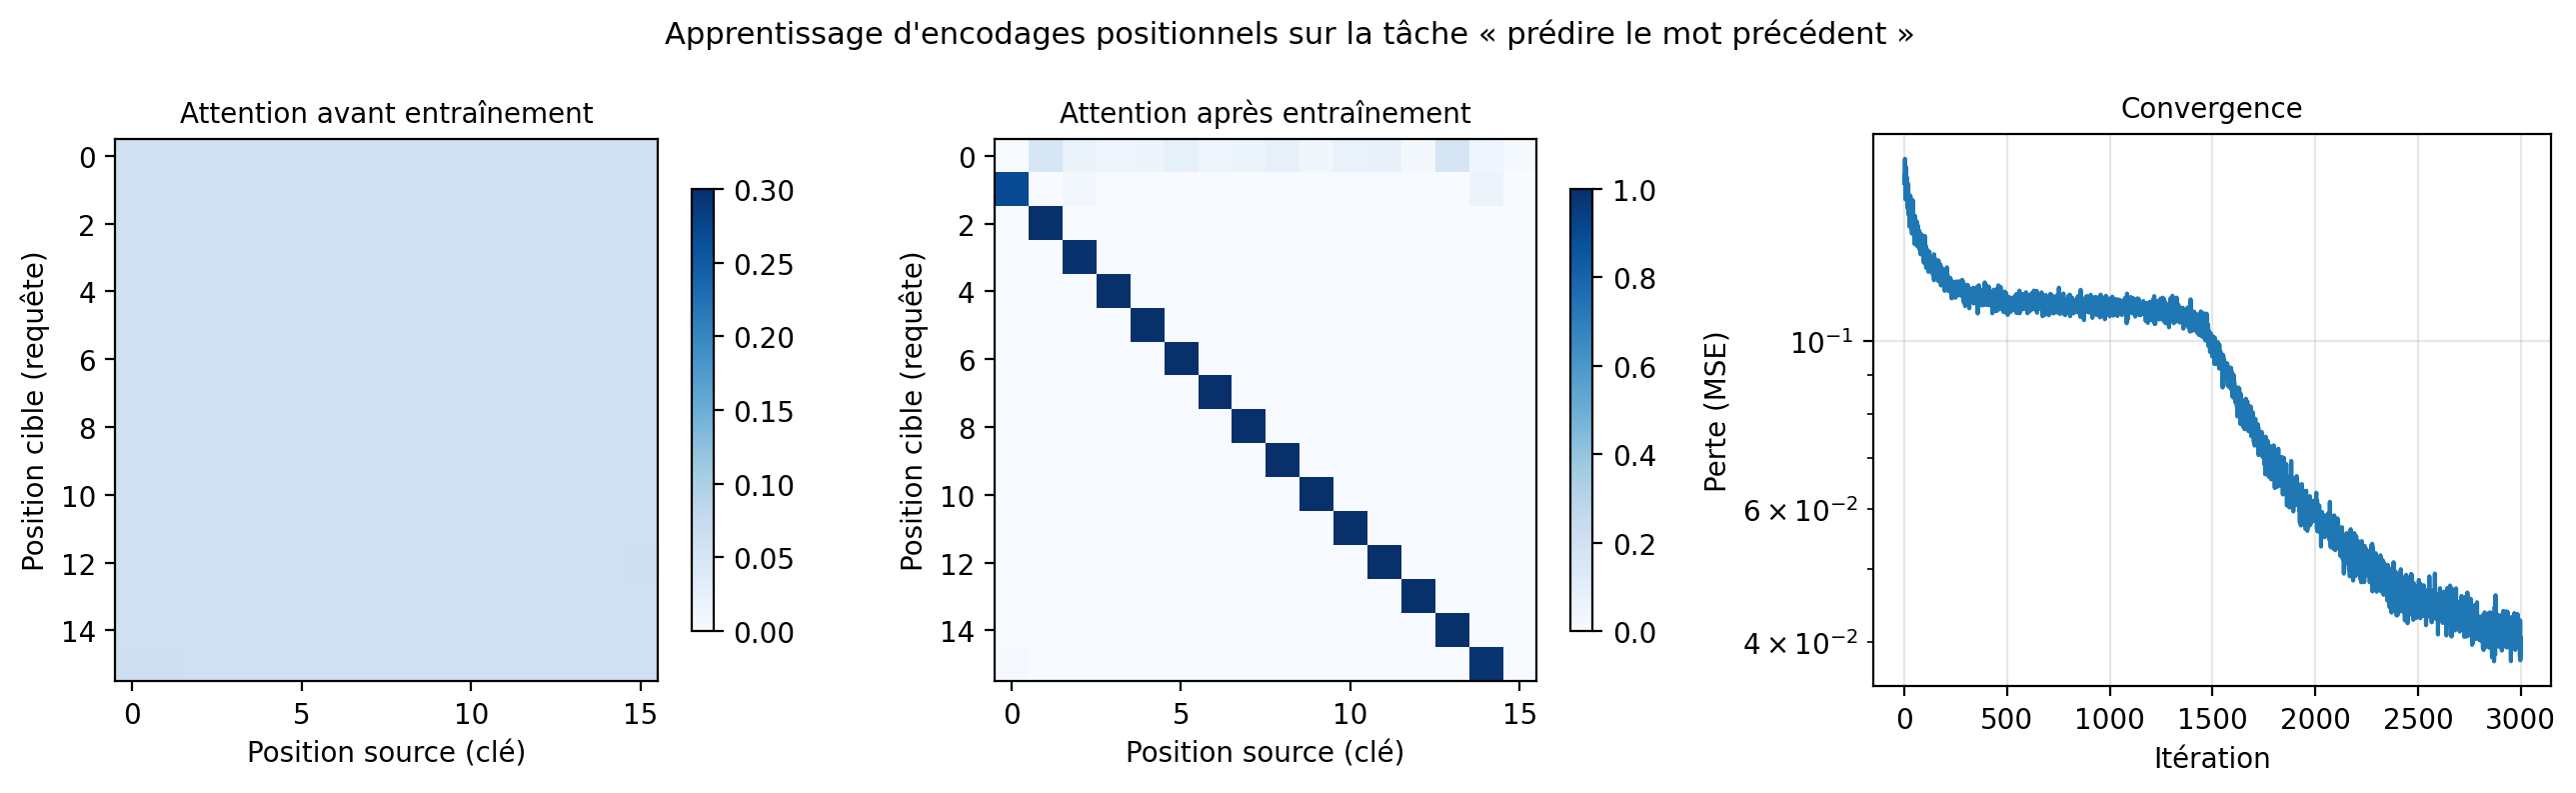
Avant l’entraînement, l’attention est quasi uniforme: chaque position regarde toutes les autres de façon indiscriminée. Après 3000 itérations, une diagonale décalée apparaît: la position concentre presque tout son poids d’attention sur la position . Les encodages positionnels, partis de vecteurs aléatoires, se sont organisés pour que le produit soit maximal — le modèle a appris de lui-même la notion de « position précédente ».
L’animation interactive ci-dessous permet d’explorer l’encodage positionnel sinusoïdal. La carte de chaleur montre l’encodage de chaque position: les dimensions basses oscillent rapidement (position fine), les dimensions hautes oscillent lentement (position grossière). Le visualiseur de vagues isole des paires sin/cos individuelles, et le graphique de similarité cosinus montre que deux positions proches ont des encodages similaires — une propriété approximativement invariante par translation.
/Users/pierre-luc.bacon/Documents/mlbook/.venv/lib/python3.12/site-packages/IPython/core/display.py:447: UserWarning: Consider using IPython.display.IFrame instead
  warnings.warn("Consider using IPython.display.IFrame instead")
Variantes d’architecture
Le mécanisme de base (auto-attention + FFN + résiduel + normalisation) s’assemble de différentes façons selon la tâche. La Figure 5 illustre la structure interne de chaque variante.
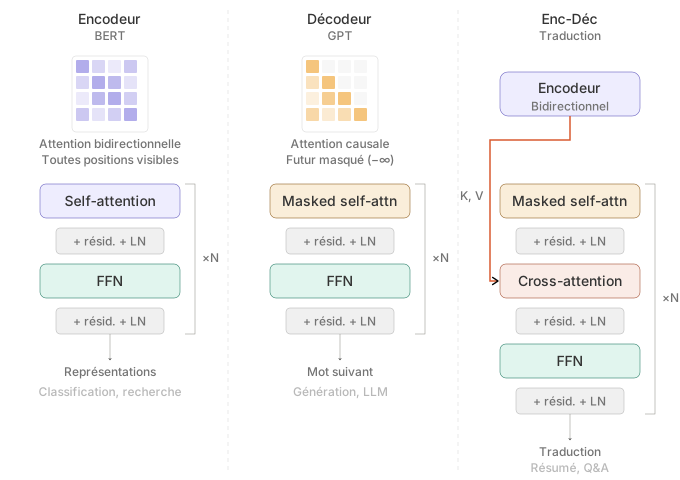
Figure 5:Les trois variantes d’architecture du transformeur. L’encodeur utilise l’auto-attention bidirectionnelle; le décodeur utilise l’auto-attention causale (masquée); l’encodeur-décodeur combine les deux avec une couche d’attention croisée.
Encodeur seul
L’encodeur traite la séquence d’entrée avec de l’auto-attention bidirectionnelle: chaque position peut consulter toutes les autres, y compris celles qui la suivent. La sortie est une séquence de représentations contextualisées.
BERT Devlin et al. (2019) est l’exemple le plus connu. On l’utilise pour la classification de texte (en ajoutant une tête de classification sur la représentation du premier jeton), la recherche d’information, ou l’extraction de caractéristiques pour d’autres modèles.
Décodeur seul
Le décodeur génère une séquence un élément à la fois, de gauche à droite. Un modèle de langage est entraîné à prédire le prochain mot à chaque position: la cible à la position est le mot . Pendant l’entraînement, toutes les positions sont traitées en parallèle par l’auto-attention, ce qui signifie que la position a accès à toute la séquence, y compris les mots futurs qu’elle est censée prédire. Sans contrainte supplémentaire, le modèle pourrait simplement copier le mot suivant au lieu d’apprendre à le prédire.
Le masque causal résout ce problème en restreignant l’attention: la position ne peut consulter que les positions . Concrètement, on définit une matrice de masque dont les entrées valent:
Cette matrice est triangulaire inférieure (avec des zéros sur la diagonale et en dessous, au-dessus). Pour :
On ajoute ce masque aux scores d’attention avant le softmax:
Le mécanisme repose sur le comportement du softmax face à : lorsque , le score , et . Le poids d’attention est donc nul, et la position ignore complètement la position . Le softmax renormalise les poids restants pour qu’ils somment à 1, de sorte que chaque position ne combine que les valeurs des positions passées et présente.
GPT Radford et al. (2018) et les grands modèles de langage (LLM) utilisent cette architecture. La génération se fait de façon autorégressive: on échantillonne un mot, on l’ajoute à la séquence, et on prédit le suivant.
Encodeur-décodeur
L’architecture originale du transformeur Vaswani et al. (2017) combine un encodeur et un décodeur. L’encodeur traite la séquence source avec de l’auto-attention bidirectionnelle. Le décodeur génère la séquence cible avec de l’auto-attention causale, mais à chaque bloc, il inclut aussi une couche d’attention croisée: les requêtes viennent du décodeur, et les clés/valeurs viennent de l’encodeur. Cela permet au décodeur de consulter la séquence source à chaque étape de la génération.
Cette architecture est naturelle pour les tâches de transduction (traduction, résumé, réponse à une question), où l’entrée et la sortie sont des séquences de nature différente.
Entraînement et génération autorégressive
La section précédente a décrit la structure du décodeur et le masque causal, mais elle n’a pas détaillé comment on entraîne un modèle de langage ni comment on génère du texte avec. Cette section rend ces deux procédures explicites et les compare à leur équivalent pour les réseaux récurrents. Nous commençons par préciser ce qu’est un jeton.
Des mots aux jetons
Jusqu’ici, nous avons parlé de « mots » et de « positions » de manière informelle. En pratique, un modèle de langage ne travaille pas directement sur des mots: il opère sur des jetons (tokens), des unités de texte issues d’un découpage appelé tokénisation (tokenization).
Pourquoi ne pas utiliser les mots directement? Le vocabulaire d’une langue est immense et ouvert: noms propres, termes techniques, néologismes, fautes de frappe. Un vocabulaire de mots entiers contiendrait des centaines de milliers d’entrées, et tout mot absent du vocabulaire serait inutilisable. À l’autre extrême, découper en caractères individuels résout le problème du vocabulaire (l’alphabet est fini et petit), mais produit des séquences très longues — une phrase de 20 mots devient une séquence de 100 caractères — et chaque caractère isolé porte peu d’information sémantique.
La tokénisation par sous-mots (subword tokenization) offre un compromis. L’idée, popularisée par l’algorithme BPE (Byte Pair Encoding) Sennrich et al. (2016), est de construire un vocabulaire de taille fixe (typiquement 30 000 à 100 000 entrées) en fusionnant progressivement les paires de caractères les plus fréquentes dans un corpus. Les mots courants sont représentés par un seul jeton (« le », « pour », « transformer »), tandis que les mots rares sont découpés en sous-mots (« anticonstitutionnellement » → « anti », « constitu », « tion », « nellement »). Ce mécanisme garantit que tout texte peut être découpé en jetons du vocabulaire, sans mot inconnu.
Chaque jeton du vocabulaire est associé à un indice entier. La première couche du modèle est une table de représentations vectorielles (embedding table) , où est la taille du vocabulaire et la dimension des représentations. Le jeton d’indice est converti en vecteur . Ce sont ces vecteurs qui entrent dans le transformeur comme la séquence , et les paramètres de sont appris conjointement avec le reste du modèle.
La dernière couche d’un modèle de langage fait l’opération inverse: elle projette la représentation de sortie sur le vocabulaire pour obtenir un score par jeton. Souvent, cette projection réutilise la même matrice (transposée), ce qui réduit le nombre de paramètres.
Génération mot par mot
Générer du texte avec un modèle de langage consiste à produire une séquence de jetons un par un. À chaque étape , le modèle calcule une distribution sur le vocabulaire, conditionnée sur les jetons déjà produits , puis échantillonne le jeton suivant à partir de cette distribution. Ce jeton est ajouté à la séquence, et le processus se répète.
Avec un RNN, cette boucle repose sur l’état caché , qui résume tout le contexte en un vecteur de taille fixe.
Le coût de chaque étape est , où est la dimension de l’état caché et celle des représentations vectorielles. Ce coût est constant quel que soit le nombre de jetons déjà générés, car tout le contexte est comprimé dans .
Avec un transformeur décodeur, il n’y a pas d’état caché récurrent. À chaque étape, le modèle reçoit la séquence complète et calcule l’auto-attention sur toutes ces positions.
À l’étape , l’attention calcule le produit : le coût est par couche. En sommant sur les étapes de génération, le coût total est , cubique en la longueur de la séquence. La sous-section sur le cache clés-valeurs montrera comment ramener ce coût à .
À l’inférence, les deux architectures sont donc séquentielles: on ne peut pas produire le jeton avant d’avoir choisi le jeton . La différence est le coût par étape. Pour le RNN, ce coût est constant car l’état a une taille fixe. Pour le transformeur, il croît avec la longueur de la séquence car l’attention revisite tout le contexte à chaque pas.
Entraînement parallèle
Pendant l’entraînement, la séquence cible est connue entièrement. L’objectif est de maximiser la vraisemblance du prochain jeton à chaque position. La perte est la somme des entropies croisées:
Pour un RNN, on utilise le teacher forcing: à chaque pas , on fournit comme entrée le vrai jeton du corpus (et non la prédiction du modèle). La mise à jour de l’état caché devient , où est la représentation vectorielle du jeton de référence. Cela stabilise l’entraînement en évitant que les erreurs du modèle s’accumulent d’un pas à l’autre. Mais le calcul reste séquentiel: dépend de , et les pas de temps sont traités dans l’ordre.
Pour un transformeur, le masque causal rend le teacher forcing inutile, car il accomplit le même effet de manière parallèle. On fournit la séquence complète en une seule passe avant. Le masque garantit que la position ne consulte que , exactement comme si on avait appliqué le teacher forcing position par position. Les prédictions sont obtenues simultanément, et la perte (16) est calculée sur toutes les positions en un seul passage. Le calcul est massivement parallèle: c’est un produit matriciel sur toute la séquence, l’opération pour laquelle les GPU sont conçus.
L’asymétrie entre entraînement et inférence est donc la suivante. Pendant l’entraînement, tous les jetons cibles sont connus à l’avance, ce qui permet de traiter toutes les positions en parallèle (transformeur) ou au moins d’utiliser les vrais jetons comme entrée (RNN avec teacher forcing). Pendant la génération, chaque jeton dépend du précédent, et le calcul est nécessairement séquentiel pour les deux architectures. Cette asymétrie a une conséquence: pendant l’entraînement, le modèle ne voit jamais ses propres erreurs, car il reçoit toujours les vrais jetons. Pendant la génération, une erreur à l’étape affecte toutes les étapes suivantes. Cet écart entre les conditions d’entraînement et de génération est appelé biais d’exposition (exposure bias).
Le cache clés-valeurs
L’algorithme de génération naïf (Algorithm 2) recalcule l’attention sur toute la séquence à chaque nouvelle étape. Or, à l’étape , les clés et valeurs des positions ont déjà été calculées à l’étape : seule la position est nouvelle.
Le cache clés-valeurs (KV cache) exploite cette observation. À chaque couche et chaque tête, on conserve en mémoire les matrices de clés et de valeurs des positions passées. À l’étape , on calcule uniquement la requête, la clé et la valeur pour la nouvelle position :
On concatène et au cache:
L’attention pour la position est alors un produit vecteur-matrice, pas un produit matrice-matrice:
Le coût de l’étape passe de à : un produit de taille au lieu de . Sur étapes, le coût total est au lieu de . La contrepartie est la mémoire: on stocke et pour chaque couche et chaque tête, soit une quantité de mémoire qui croît linéairement avec la longueur de la séquence.
Avec le cache, le transformeur à l’inférence ressemble au RNN en ce qu’il étend un état à chaque pas. Mais cet état (le cache) grandit avec , alors que l’état caché du RNN a une taille fixe . C’est le même compromis que celui discuté au chapitre précédent: le RNN comprime toute l’information dans un vecteur de taille fixe, au risque du goulot d’information; le transformeur conserve tout le contexte, au prix d’une mémoire croissante.
Démonstration: génération avec GPT-2
Mettons en pratique la boucle de génération autorégressive avec GPT-2, un transformeur décodeur pré-entraîné sur un large corpus de texte anglais. Le code ci-dessous implémente la boucle décrite dans l’algorithme Algorithm 2, sans recourir à une fonction de génération toute faite: on calcule les logits, on applique le softmax avec un paramètre de température, on échantillonne, et on ajoute le jeton au contexte.
Source
import logging, warnings, os
logging.disable(logging.INFO)
warnings.filterwarnings("ignore")
os.environ["TOKENIZERS_PARALLELISM"] = "false"

import torch
import numpy as np
from transformers import GPT2LMHeadModel, GPT2Tokenizer

tokenizer = GPT2Tokenizer.from_pretrained("gpt2")
model = GPT2LMHeadModel.from_pretrained("gpt2")
model.eval()

def generer(prompt, max_jetons=40, temperature=1.0, graine=42):
    """Génération autorégressive, jeton par jeton."""
    torch.manual_seed(graine)
    ids = tokenizer.encode(prompt, return_tensors="pt")
    generes = []

    for _ in range(max_jetons):
        with torch.no_grad():
            sorties = model(ids)
        # Logits du dernier jeton
        logits = sorties.logits[0, -1, :] / temperature
        probs = torch.softmax(logits, dim=0)
        # Échantillonner le prochain jeton
        jeton = torch.multinomial(probs, num_samples=1)
        generes.append(jeton.item())
        ids = torch.cat([ids, jeton.unsqueeze(0)], dim=1)
        # Arrêter au jeton de fin
        if jeton.item() == tokenizer.eos_token_id:
            break

    return tokenizer.decode(generes)

prompt = "The meaning of life is"
print(f"Invite : {prompt!r}\n")
print(f"Texte généré :\n{prompt}{generer(prompt)}")
Warning: You are sending unauthenticated requests to the HF Hub. Please set a HF_TOKEN to enable higher rate limits and faster downloads.
Loading weights: 0%| | 0/148 [00:00<?, ?it/s]Loading weights: 100%|██████████| 148/148 [00:00<00:00, 7477.74it/s]
Invite : 'The meaning of life is'
Texte généré :
The meaning of life is materialistic," a teacher at a private school in Zurich, Switzerland, tells RT Radio. "If it's for a matter of weeks, you can live peacefully, you can live healthyly."
À chaque étape, le modèle reçoit la séquence complète (invite + jetons déjà générés), calcule les logits sur le vocabulaire, et échantillonne le jeton suivant. La boucle est séquentielle: on ne peut pas choisir le jeton avant d’avoir produit le jeton .
On peut extraire les poids d’attention de GPT-2 pour observer le masque causal. La matrice d’attention d’une tête a pour entrée le poids que la position accorde à la position . Le masque causal force pour tout : chaque position ne consulte que les positions précédentes et elle-même. La matrice résultante est triangulaire inférieure.
Source
%config InlineBackend.figure_format = 'retina'
import matplotlib.pyplot as plt

# Charger le modèle avec l'implémentation d'attention qui expose les poids
model_attn = GPT2LMHeadModel.from_pretrained("gpt2", attn_implementation="eager")
model_attn.eval()

ids = tokenizer.encode(prompt, return_tensors="pt")
with torch.no_grad():
    sorties = model_attn(ids, output_attentions=True)

jetons = [tokenizer.decode(i) for i in ids[0]]
T = len(jetons)

# Couche 0, 4 premières têtes
fig, axes = plt.subplots(1, 4, figsize=(14, 3.5))
for h, ax in enumerate(axes):
    attn = sorties.attentions[0][0, h, :T, :T].numpy()
    im = ax.imshow(attn, cmap='Blues', vmin=0, vmax=1)
    ax.set_xticks(range(T))
    ax.set_xticklabels(jetons, rotation=45, ha='right', fontsize=8)
    ax.set_yticks(range(T))
    ax.set_yticklabels(jetons, fontsize=8)
    ax.set_title(f'Tête {h}', fontsize=10)
    ax.set_xlabel('Clé (position consultée)')
    if h == 0:
        ax.set_ylabel('Requête (position courante)')

fig.suptitle(f'Poids d\'attention de la première couche de GPT-2 — masque causal',
             fontsize=11, y=1.06)
plt.tight_layout()
Loading weights: 0%| | 0/148 [00:00<?, ?it/s]Loading weights: 100%|██████████| 148/148 [00:00<00:00, 14708.49it/s]
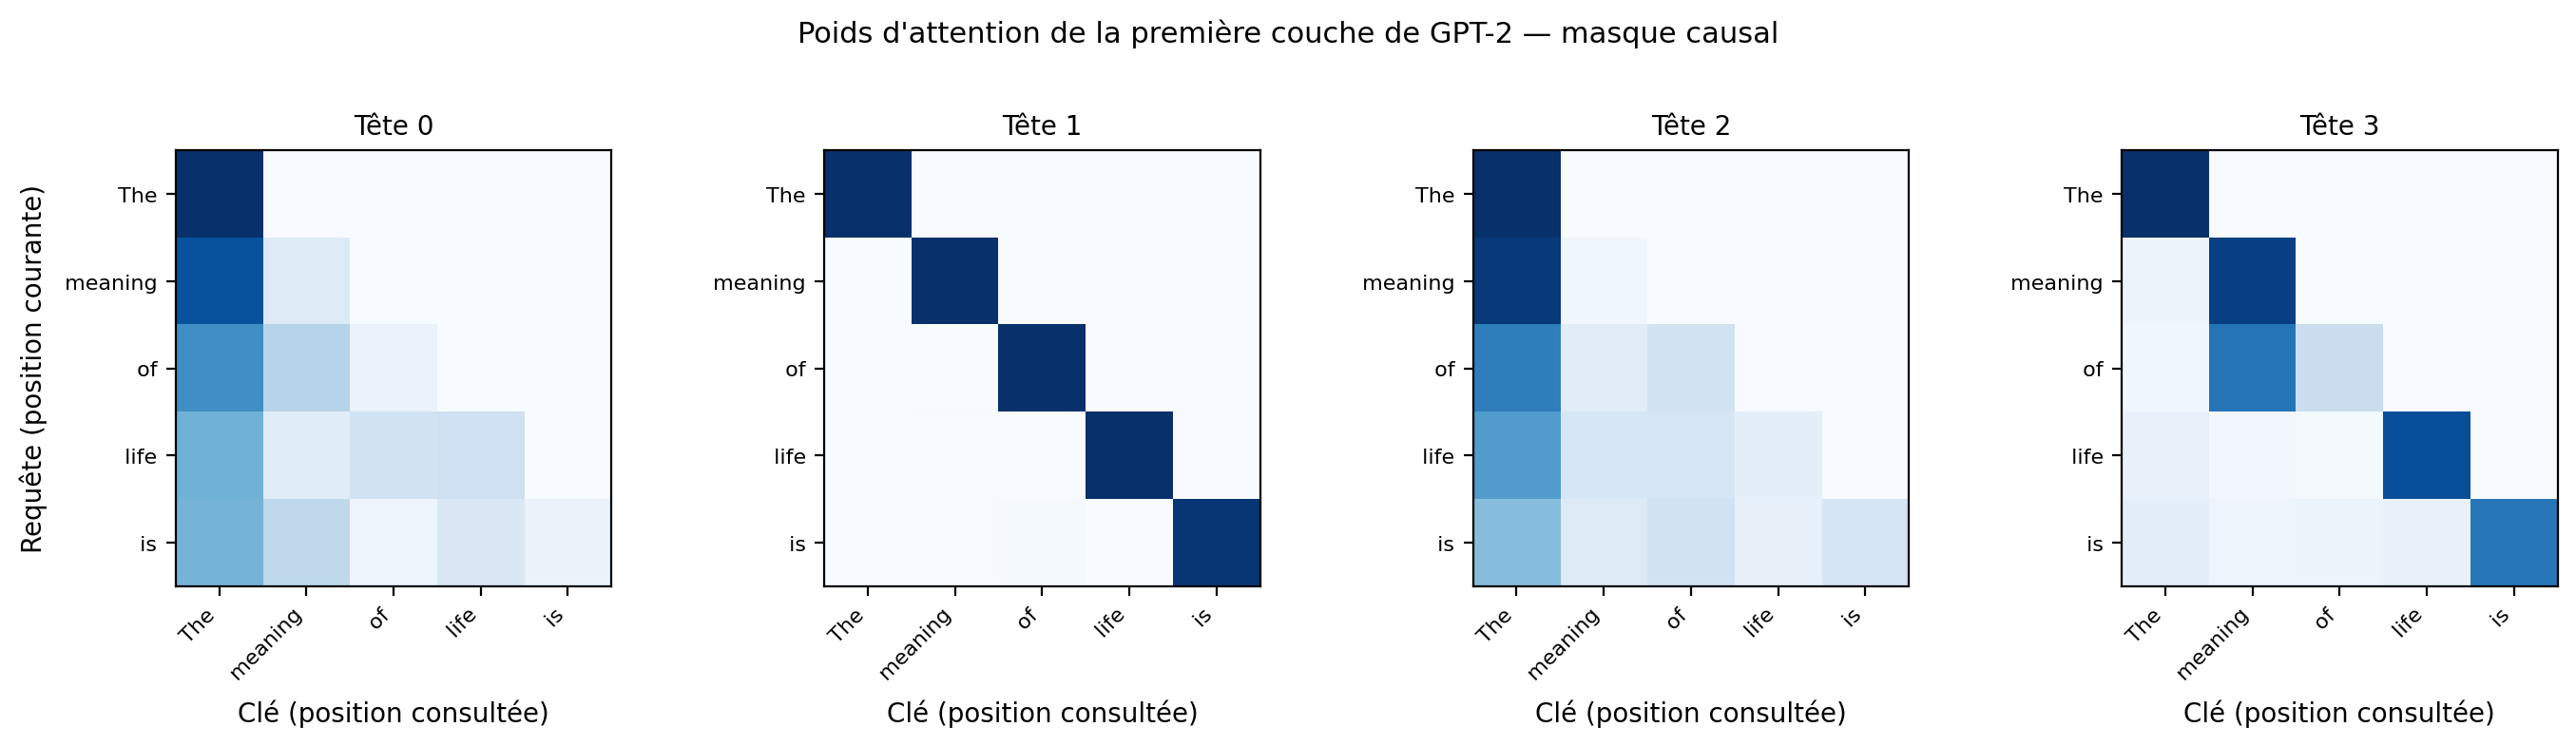
La structure triangulaire est visible dans chaque tête: les entrées au-dessus de la diagonale sont nulles. Au-delà de cette contrainte commune, chaque tête apprend un motif d’attention différent. Certaines têtes concentrent leur attention sur le jeton immédiatement précédent; d’autres répartissent l’attention plus uniformément sur tout le contexte disponible.
Le paramètre de température contrôle la forme de la distribution. Une température basse () concentre la masse de probabilité sur les jetons les plus probables, rendant la génération quasi déterministe. Une température élevée () aplatit la distribution et augmente la diversité, au prix de la cohérence.
Source
%config InlineBackend.figure_format = 'retina'
import matplotlib.pyplot as plt

# Montrer la distribution sur le vocabulaire pour le dernier jeton de l'invite
ids = tokenizer.encode(prompt, return_tensors="pt")
with torch.no_grad():
    logits = model(ids).logits[0, -1, :]

temperatures = [0.3, 1.0, 2.0]
fig, axes = plt.subplots(1, 3, figsize=(13, 3.5))

for ax, tau in zip(axes, temperatures):
    probs = torch.softmax(logits / tau, dim=0)
    top_probs, top_ids = probs.topk(10)
    top_mots = [tokenizer.decode(i).strip() for i in top_ids]

    bars = ax.barh(range(10), top_probs.numpy(), color='#2196F3')
    ax.set_yticks(range(10))
    ax.set_yticklabels(top_mots, fontsize=9)
    ax.invert_yaxis()
    ax.set_xlabel('Probabilité')
    ax.set_title(f'$\\tau = {tau}$')
    ax.set_xlim(0, min(1.0, top_probs[0].item() * 1.3))

plt.suptitle(f'Distribution sur les 10 jetons les plus probables après "{prompt}"',
             fontsize=11, y=1.04)
plt.tight_layout()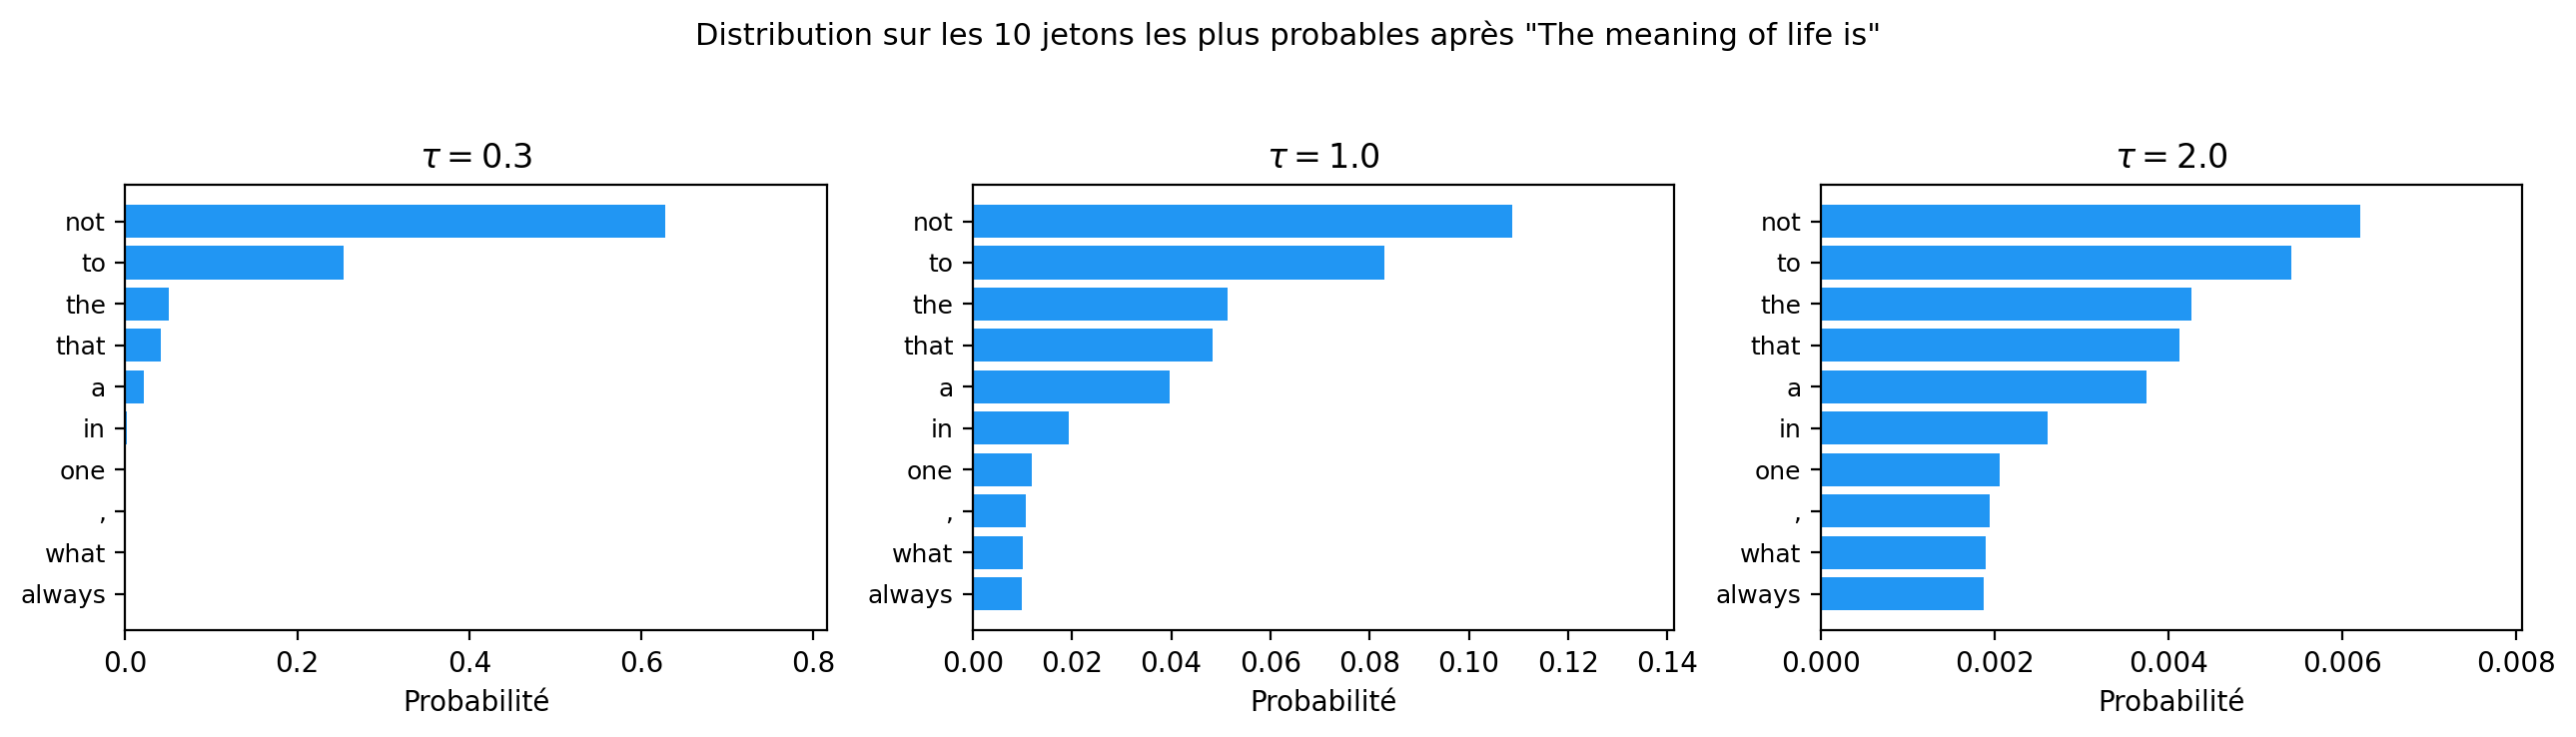
À température , le jeton le plus probable concentre l’essentiel de la masse: la génération suit un chemin prévisible. À (la valeur par défaut), la distribution est celle apprise par le modèle. À , les jetons moins probables reçoivent une part non négligeable, ce qui produit un texte plus varié mais moins cohérent. La température ne modifie pas les logits: elle change uniquement la forme du softmax, .
Source
print(f"Invite : {prompt!r}\n")
for tau in [0.3, 1.0, 2.0]:
    texte = generer(prompt, temperature=tau)
    print(f"τ = {tau:.1f} : {prompt}{texte}")
Invite : 'The meaning of life is'
τ = 0.3 : The meaning of life is not to be understood by the average person. It is to be understood by the average person.

The meaning of life is not to be understood by the average person. It is to be understood
τ = 1.0 : The meaning of life is materialistic," a teacher at a private school in Zurich, Switzerland, tells RT Radio. "If it's for a matter of weeks, you can live peacefully, you can live healthyly."
τ = 2.0 : The meaning of life is material warfare worldwide 903 Request Details FalseMoreover Defendants Zurich, Vice Collective Gear Glad Inspective Publishing 133 flux∴ARE)."Rev989 It AC 630 Thomas Colomb cooperate Sal Meielvedrone Park Alexandria
Pourquoi les transformeurs dominent
Les transformeurs ont remplacé les RNN comme architecture dominante pour le traitement des séquences, et ils se sont étendus bien au-delà (vision, audio, protéines, etc.). Cette domination repose sur un avantage structurel lié au matériel moderne, mais elle s’accompagne d’un coût que les RNN n’avaient pas.
Parallélisme et matériel moderne
L’auto-attention calcule comme un produit matriciel: exactement l’opération pour laquelle les GPU sont conçus. Un GPU contient des milliers de cœurs qui exécutent la même opération arithmétique sur des données différentes, et la multiplication matricielle exploite pleinement ce parallélisme.
Dans un RNN, le calcul de attend : les pas de temps sont séquentiels. Sur un GPU avec des milliers de cœurs, la plupart restent inactifs pendant que le RNN traite un pas à la fois. L’attention, elle, traite toutes les paires de positions en une seule opération matricielle. Sur une séquence de 512 positions, un RNN exécute 512 pas séquentiels, tandis que l’attention calcule toutes les interactions en un seul produit .
Le coût quadratique de l’attention
Cet avantage a une contrepartie. La complexité de calcul de l’auto-attention est : la matrice contient entrées, une pour chaque paire de positions. Pour une séquence de positions avec 16 têtes et , la matrice d’attention d’une seule tête contient millions d’entrées, soit environ 268 millions pour l’ensemble des têtes d’une seule couche. La mémoire et le temps de calcul croissent quadratiquement avec la longueur de la séquence.
C’est pourquoi les premiers transformeurs étaient limités à environ 512 jetons. L’adoption du transformeur n’est pas une victoire pure sur les RNN: on échange une profondeur séquentielle contre un coût mémoire . Pour de courtes séquences, un RNN peut être plus économe. Pour de longues séquences, des variantes d’attention sous-quadratique (attention linéaire, attention éparse) tentent de retrouver le meilleur des deux régimes.
Mise à l’échelle
Au-delà du parallélisme, les transformeurs possèdent une propriété empirique remarquable: leur performance s’améliore de façon prévisible quand on augmente le nombre de paramètres, la taille des données, et la quantité de calcul. Des lois de puissance (scaling laws) relient ces trois quantités à la perte du modèle. Cette prévisibilité permet de planifier les ressources nécessaires pour atteindre un niveau de performance donné.
Les chemins de gradient courts (une seule couche d’attention suffit pour connecter deux positions quelconques) facilitent l’entraînement de modèles très profonds. Combinée au parallélisme sur GPU, cette propriété a conduit aux grands modèles de langage (LLM) qui comptent des centaines de milliards de paramètres. La domination des transformeurs est donc indissociable du matériel sur lequel ils s’exécutent: sur des processeurs séquentiels, leur avantage sur les RNN serait bien moindre.
Résumé
Le mécanisme d’attention permet à chaque position d’une séquence de consulter sélectivement toutes les autres positions, en calculant une moyenne pondérée des valeurs dont les poids dépendent de la similarité entre requêtes et clés. L’auto-attention applique ce mécanisme au sein d’une même séquence, et l’attention multi-têtes exécute plusieurs mécanismes en parallèle pour capturer différents types de relations.
Le transformeur empile des blocs composés d’attention multi-têtes et de réseaux à propagation avant, stabilisés par des connexions résiduelles et la normalisation de couche. L’encodage positionnel injecte la notion d’ordre, absente de l’auto-attention elle-même.
Les trois variantes principales (encodeur seul, décodeur seul, encodeur-décodeur) correspondent à des familles de tâches différentes. Le parallélisme, les connexions directes à longue portée, et les propriétés de mise à l’échelle expliquent la domination actuelle des transformeurs, au prix d’un coût quadratique en la longueur de la séquence. Pendant l’entraînement, le masque causal permet de calculer toutes les prédictions en parallèle; pendant la génération, les jetons sont produits un par un, et le cache clés-valeurs évite de recalculer l’attention sur tout le contexte à chaque pas.
Exercices
Les exercices ★ vérifient la compréhension de base. Les exercices ★★ demandent d’appliquer les concepts à des calculs concrets. Les exercices ★★★ approfondissent le sujet et sont optionnels pour IFT3395.
Exercice 1: Attention à la main ★
Soit trois positions avec les clés et valeurs suivantes (en dimension , ):
| Position | ||
|---|---|---|
| 1 | 10 | |
| 2 | 20 | |
| 3 | 30 |
La requête est .
Calculez les scores pour chaque position (sans normalisation par ).
Appliquez le softmax pour obtenir les poids d’attention .
Calculez la sortie .
Quel est l’effet de la normalisation par ?
Solution Exercice 1
Scores: , , .
.
Sortie: .
Avec , les scores deviennent . Le softmax donne une distribution plus uniforme: . La normalisation “adoucit” l’attention en réduisant l’écart entre les scores, ce qui est particulièrement utile quand est grand.
Exercice 2: Nombre de paramètres d’un bloc transformeur ★★
Considérez un bloc transformeur avec , têtes, et .
Combien de paramètres dans une tête d’attention (, , )?
Combien au total pour l’attention multi-têtes (incluant )?
Combien dans le FFN (, , biais)?
Quel est le total pour un bloc? Et pour un transformeur à blocs?
(Ignorez les paramètres de la normalisation de couche.)
Solution Exercice 2
Avec :
Par tête: : 32 768. Idem pour et . Total par tête: .
Huit têtes: . : 262 144. Total attention multi-têtes: 1 048 576 1M paramètres.
: 1 048 576. : 2 048. : 1 048 576. : 512. Total FFN: 2 099 712 2M.
Total par bloc: 3,1M. Pour 6 blocs: 18,9M paramètres (sans compter les plongements d’entrée et de sortie).
Exercice 3: Masque causal ★★
L’attention causale empêche la position de consulter les positions .
Écrivez la matrice de masque pour , où si la position peut consulter la position , et sinon.
Montrez que donne bien des poids nuls pour les positions futures.
Pourquoi est-ce nécessaire pour un modèle de langage?
Solution Exercice 3
La matrice de masque est triangulaire inférieure:
Quand , le score , et . Le softmax donne un poids nul pour cette position: . Les positions futures sont ignorées.
Un modèle de langage prédit le prochain mot à chaque position. Pendant l’entraînement, toutes les positions sont traitées en parallèle. Sans masque, la position pourrait “voir” le mot qu’elle est censée prédire (position ), et le modèle n’apprendrait rien. Le masque causal garantit que la prédiction à la position ne dépend que des mots .
Exercice 4: Auto-attention et permutation ★★
Soit une matrice de permutation ( réarrange les lignes de ).
Montrez que . (L’auto-attention est équivariante par permutation.)
Qu’est-ce que cela implique pour un transformeur sans encodage positionnel?
Pourquoi le RNN n’a-t-il pas cette propriété?
Solution Exercice 4
Posons . Alors , et de même , . Le score: . Le softmax est appliqué par ligne, et permute les lignes: . La sortie: (car ). Donc .
Sans encodage positionnel, le transformeur traite “le chat mange la souris” et “la souris mange le chat” de façon identique (à permutation près). Il ne peut pas distinguer l’ordre des mots. L’encodage positionnel brise cette symétrie.
Le RNN traite les positions séquentiellement: dépend de , qui dépend de , etc. La récurrence impose un ordre de traitement, ce qui rend le réseau sensible à l’ordre des entrées sans encodage positionnel explicite.
Exercice 5: Nadaraya-Watson et attention ★★
L’estimateur de Nadaraya-Watson avec un noyau gaussien prédit:
Montrez que cette formule a la même structure que le mécanisme d’attention: identifiez ce qui joue le rôle de la requête, des clés, des valeurs et du score de similarité.
Développez et montrez que, sous certaines simplifications, le score se réduit à un produit scalaire entre et .
Qu’est-ce qu’il faudrait changer dans Nadaraya-Watson pour obtenir exactement l’attention par produit scalaire utilisée dans les transformeurs?
Solution Exercice 5
La formule de Nadaraya-Watson est une moyenne pondérée normalisée, exactement comme l’attention. Les correspondances sont:
La requête est le point pour lequel on prédit.
Les clés sont les points d’entraînement .
Les valeurs sont les observations .
Le score de similarité est , qui est grand (proche de 0) quand et sont proches.
La normalisation par la somme des exponentielles est le softmax.
En développant: . Le terme est constant pour toutes les positions et disparaît après le softmax (il s’annule dans le rapport). Si les données sont normalisées de sorte que est approximativement constant pour tout , ce terme disparaît aussi. Le score se réduit alors à , un produit scalaire mis à l’échelle.
Deux modifications sont nécessaires:
Remplacer la similarité fixe (noyau gaussien) par des projections linéaires apprises: , , avec un score .
Remplacer les valeurs brutes par des projections apprises: .
Nadaraya-Watson utilise des similarités et des valeurs fixées par les données; l’attention apprend les trois projections (, , ), ce qui lui permet d’adapter simultanément ce qu’elle cherche, comment elle compare, et ce qu’elle retourne.
Exercice 6: Coût de la génération autorégressive ★★
On génère jetons avec un transformeur décodeur à un seul bloc, de dimension , avec une seule tête d’attention.
Sans cache clés-valeurs, quel est le coût du produit à l’étape (quand la séquence contient jetons)? Quel est le coût total pour générer jetons?
Avec le cache clés-valeurs, quel est le coût de l’attention à l’étape ? Le coût total?
Un RNN avec un état caché de dimension génère jetons. Quel est le coût total? Comparez avec les résultats précédents.
Solution Exercice 6
À l’étape , les matrices et ont lignes et colonnes. Le produit coûte . Le coût total est .
Avec le cache, à l’étape , on calcule un seul vecteur requête et on le multiplie par . Le coût est . Le coût total est .
Pour le RNN, chaque étape coûte (mise à jour de et calcul de la sortie). Le coût total est , linéaire en . Le RNN est donc plus économe en calcul par jeton, mais il comprime tout le contexte dans un vecteur de taille fixe , ce qui limite sa capacité à exploiter les dépendances à long terme.
- Bahdanau, D., Cho, K., & Bengio, Y. (2015). Neural Machine Translation by Jointly Learning to Align and Translate. Proceedings of the 3rd International Conference on Learning Representations (ICLR).
- Nadaraya, E. A. (1964). On Estimating Regression. Theory of Probability and Its Applications, 9(1), 141–142.
- Watson, G. S. (1964). Smooth Regression Analysis. Sankhyā: The Indian Journal of Statistics, Series A, 26(4), 359–372.
- Tsai, Y.-H. H., Bai, S., Yamada, M., Morency, L.-P., & Salakhutdinov, R. (2019). Transformer Dissection: An Unified Understanding of Transformer’s Attention via the Lens of Kernel. Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing (EMNLP), 4344–4353.
- Wright, M. A., & Gonzalez, J. E. (2021). Transformers are Deep Infinite-Dimensional Non-Mercer Binary Kernel Machines. arXiv Preprint arXiv:2106.01506.
- Santos, S., Gonçalves, N., McNamee, D. C., Treviso, M., & Martins, A. F. T. (2026). Sparse Attention as Compact Kernel Regression. arXiv Preprint arXiv:2601.22766.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is All You Need. Advances in Neural Information Processing Systems (NeurIPS), 30.
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics (NAACL), 4171–4186.
- Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving Language Understanding by Generative Pre-Training.
- Sennrich, R., Haddow, B., & Birch, A. (2016). Neural Machine Translation of Rare Words with Subword Units. Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics, 1715–1725.