Au chapitre 7, nous avons vu que le perceptron multicouche (MLP) traite son entrée comme un vecteur plat : chaque couche dense opère sur toutes les composantes sans distinction. Pour une image de pixels, la matrice mélange toutes les positions spatiales sans savoir que le pixel est voisin du pixel .
Ce chapitre introduit une alternative: remplacer la multiplication par une matrice dense par l’opération de convolution, qui exploite la structure spatiale des données. Nous commençons par définir la convolution en une dimension, puis en deux dimensions. Nous montrons ensuite que la convolution est un opérateur linéaire, ce qui signifie que la différentiation automatique du chapitre 7 s’y applique sans modification. La section suivante explique les biais inductifs qui rendent cette opération particulièrement adaptée au traitement d’images et de signaux. Nous décrivons ensuite les éléments pratiques d’une couche convolutive (pas, rembourrage, canaux, mise en commun). Le chapitre se termine par des démonstrations visuelles: l’effet de noyaux classiques sur des signaux, puis les détecteurs de caractéristiques appris par un réseau profond.
De la couche dense à la convolution
Le coût de la couche dense sur une image
Considérons une image couleur de pixels avec 3 canaux (rouge, vert, bleu). Mise à plat, l’entrée est un vecteur de dimensions. Une couche dense avec neurones cachés nécessite une matrice , soit paramètres, sans compter les biais. Pour une seule couche.
Au-delà du nombre de paramètres, la couche dense a un problème structurel. Le poids qui relie le pixel en position au neurone est complètement indépendant du poids qui relie le pixel voisin au même neurone. La couche ne sait pas que ces deux pixels sont voisins dans l’image. Elle ne sait pas non plus qu’un contour vertical en haut à gauche ressemble à un contour vertical en bas à droite. Chaque motif spatial doit être appris indépendamment à chaque position, ce qui demande beaucoup de données.
Peut-on concevoir une opération linéaire qui respecte la structure spatiale de l’entrée?
La convolution en une dimension
Commençons par le cas le plus simple: un signal à une dimension. Soit un signal discret et un noyau de taille . La convolution discrète produit un signal de sortie défini par:
Pour chaque position , on extrait une fenêtre de valeurs consécutives du signal d’entrée, on multiplie terme à terme par les poids du noyau, et on somme. Le noyau glisse le long du signal, produisant une valeur de sortie à chaque position.
Prenons un exemple concret. Soit le signal et le noyau (un filtre de différence). Le noyau a éléments. La sortie a éléments:
Le noyau calcule la différence entre deux valeurs consécutives: c’est un détecteur de changements brusques dans le signal. Un noyau calculerait plutôt la moyenne locale, lissant le signal. Différents noyaux extraient différentes caractéristiques.
Source
%config InlineBackend.figure_format = 'retina'
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
N = 200
t = np.linspace(0, 4 * np.pi, N)
signal = np.sin(t) + 0.5 * np.sin(3 * t) + 0.3 * rng.standard_normal(N)

# Trois noyaux
K_avg = 9
w_avg = np.ones(K_avg) / K_avg  # Lissage (moyenne mobile)
w_diff = np.array([1.0, -1.0])   # Différence (détection de changements)
w_gauss = np.exp(-0.5 * np.linspace(-2, 2, 11)**2)
w_gauss = w_gauss / w_gauss.sum()  # Lissage gaussien

y_avg = np.convolve(signal, w_avg, mode='valid')
y_diff = np.convolve(signal, w_diff[::-1], mode='valid')
y_gauss = np.convolve(signal, w_gauss, mode='valid')

fig, axes = plt.subplots(4, 1, figsize=(9, 7), sharex=True)

axes[0].plot(t, signal, color='#333')
axes[0].set_ylabel('Amplitude')
axes[0].set_title('Signal original')

t_avg = t[:len(y_avg)]
axes[1].plot(t_avg, y_avg, color='#2196F3')
axes[1].set_ylabel('Amplitude')
axes[1].set_title(f'Moyenne mobile (noyau de taille {K_avg})')

t_diff = t[:len(y_diff)]
axes[2].plot(t_diff, y_diff, color='#E91E63')
axes[2].set_ylabel('Amplitude')
axes[2].set_title('Filtre de différence $[1, -1]$')

t_gauss = t[:len(y_gauss)]
axes[3].plot(t_gauss, y_gauss, color='#4CAF50')
axes[3].set_ylabel('Amplitude')
axes[3].set_title('Lissage gaussien')
axes[3].set_xlabel('$t$')

plt.tight_layout()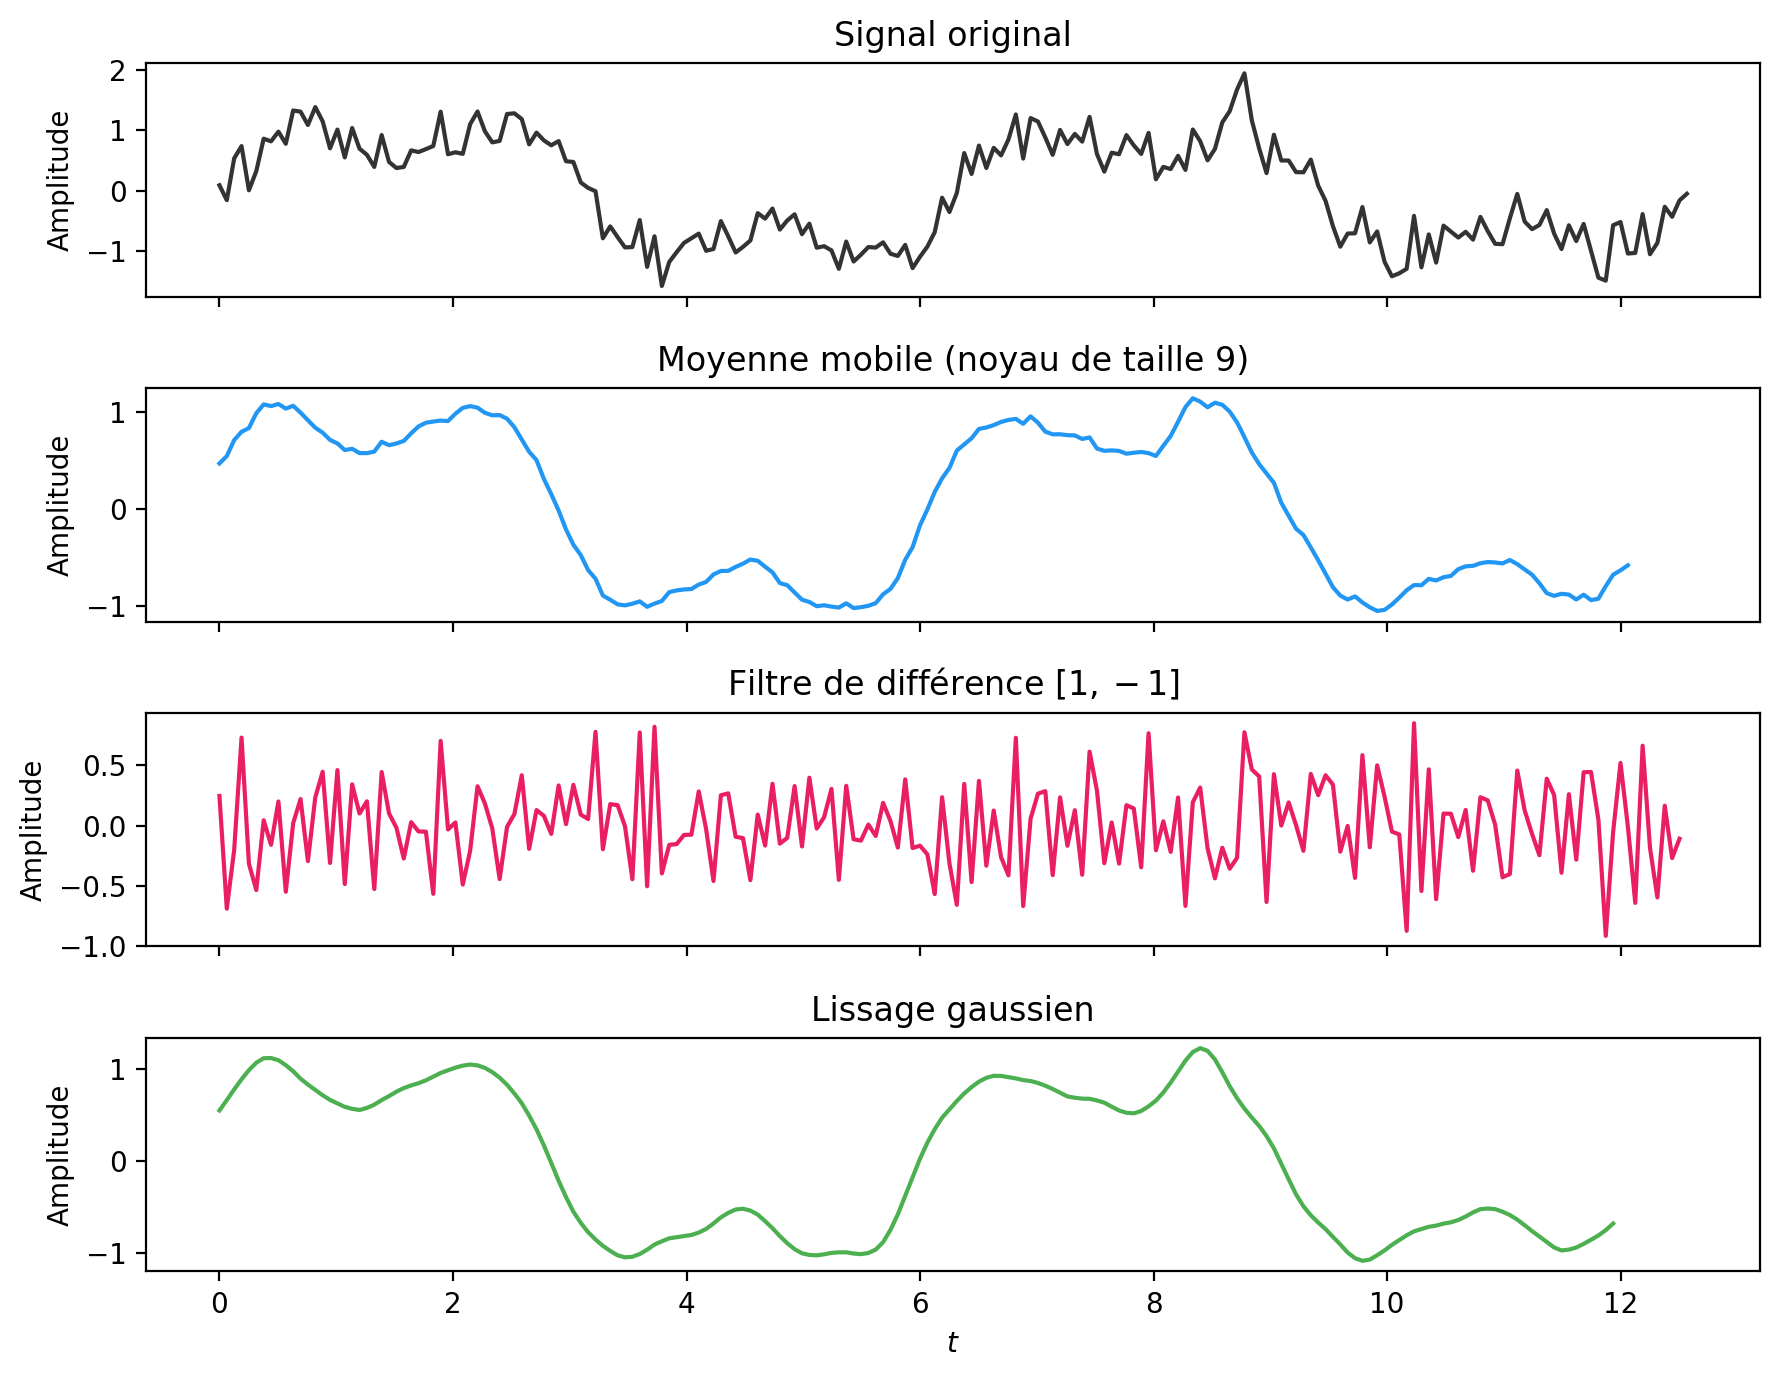
La moyenne mobile atténue le bruit en calculant la moyenne sur une fenêtre glissante. Le filtre de différence amplifie au contraire les variations rapides, mettant en évidence les transitions du signal. Le lissage gaussien offre un compromis: il atténue le bruit tout en préservant mieux la forme du signal que la moyenne uniforme. Ces trois noyaux illustrent un principe général: le choix du noyau détermine quelle caractéristique du signal est extraite.
La convolution en deux dimensions
Pour une image en niveaux de gris , le noyau est une petite matrice . La convolution 2D produit une carte de réponse :
Le principe est le même qu’en 1D: le noyau glisse sur l’image, et à chaque position , on calcule la somme pondérée de la région locale couverte par le noyau. La sortie a pour dimensions .
Prenons un exemple. Soit une image et un noyau :
La sortie est une matrice . Par exemple:
Chaque élément de mesure la force de la correspondance entre le noyau et la région locale de l’image. Ce noyau particulier calcule la différence entre le coin supérieur gauche et le coin inférieur droit d’un carré : il détecte un type de contraste diagonal.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.signal import correlate2d

# Charger une image d'exemple
from scipy.datasets import face
img_rgb = face()
img = np.mean(img_rgb, axis=2)  # Convertir en niveaux de gris
img = img[100:600, 200:800]      # Recadrer une région intéressante

# Noyaux classiques
sobel_h = np.array([[ 1,  2,  1],
                    [ 0,  0,  0],
                    [-1, -2, -1]], dtype=float)

sobel_v = np.array([[ 1, 0, -1],
                    [ 2, 0, -2],
                    [ 1, 0, -1]], dtype=float)

gauss = np.array([[1, 2, 1],
                  [2, 4, 2],
                  [1, 2, 1]], dtype=float) / 16.0

sharpen = np.array([[ 0, -1,  0],
                    [-1,  5, -1],
                    [ 0, -1,  0]], dtype=float)

# Appliquer les noyaux
resp_h = correlate2d(img, sobel_h, mode='same', boundary='symm')
resp_v = correlate2d(img, sobel_v, mode='same', boundary='symm')
resp_gauss = correlate2d(img, gauss, mode='same', boundary='symm')
resp_sharp = correlate2d(img, sharpen, mode='same', boundary='symm')
magnitude = np.sqrt(resp_h**2 + resp_v**2)

fig, axes = plt.subplots(2, 3, figsize=(12, 7))

axes[0, 0].imshow(img, cmap='gray')
axes[0, 0].set_title('Image originale')
axes[0, 0].axis('off')

axes[0, 1].imshow(np.abs(resp_h), cmap='gray')
axes[0, 1].set_title('Contours horizontaux (Sobel)')
axes[0, 1].axis('off')

axes[0, 2].imshow(np.abs(resp_v), cmap='gray')
axes[0, 2].set_title('Contours verticaux (Sobel)')
axes[0, 2].axis('off')

axes[1, 0].imshow(resp_gauss, cmap='gray')
axes[1, 0].set_title('Lissage gaussien')
axes[1, 0].axis('off')

axes[1, 1].imshow(np.clip(resp_sharp, 0, 255), cmap='gray')
axes[1, 1].set_title('Accentuation des détails')
axes[1, 1].axis('off')

axes[1, 2].imshow(magnitude, cmap='gray')
axes[1, 2].set_title('Magnitude des contours')
axes[1, 2].axis('off')

plt.tight_layout()
/Users/pierre-luc.bacon/Documents/mlbook/.venv/lib/python3.12/site-packages/tqdm/auto.py:21: TqdmWarning: IProgress not found. Please update jupyter and ipywidgets. See https://ipywidgets.readthedocs.io/en/stable/user_install.html
from .autonotebook import tqdm as notebook_tqdm
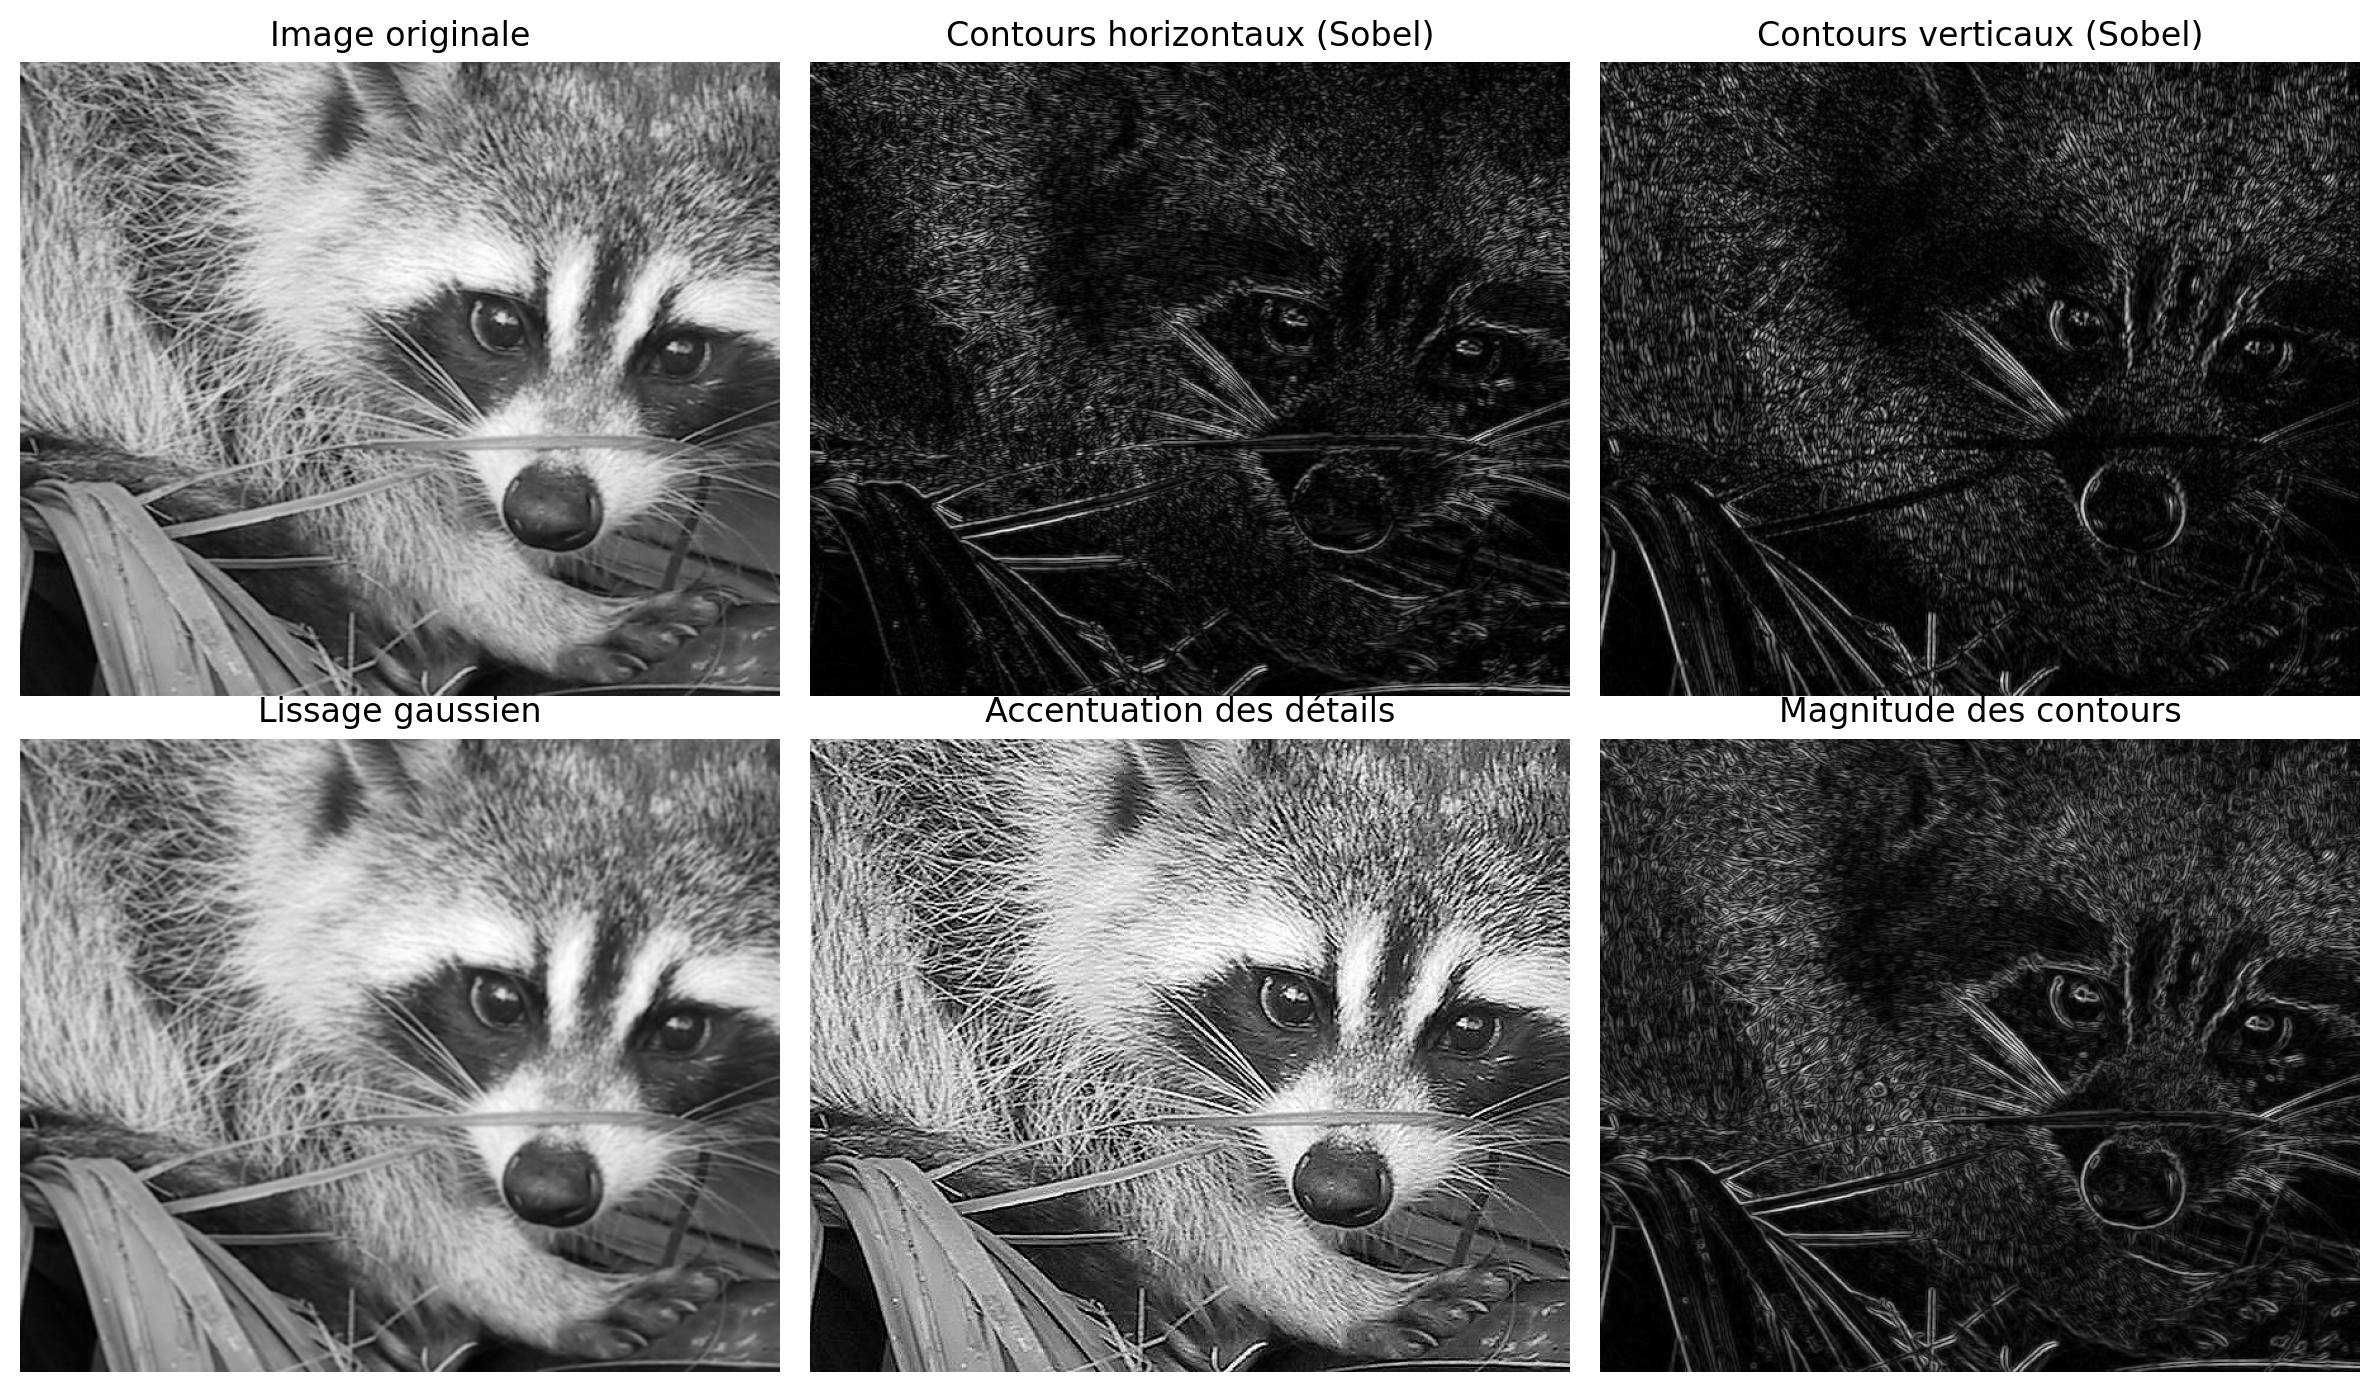
Les noyaux de Sobel détectent les contours dans une direction particulière. Le lissage gaussien atténue les détails fins. L’accentuation (sharpening) renforce les contrastes locaux. Ces noyaux sont conçus à la main, mais l’idée des réseaux convolutifs est de les apprendre à partir des données: le réseau découvre automatiquement les noyaux les plus utiles pour la tâche.
La convolution comme opérateur linéaire
Matrice de Toeplitz
La convolution en 1D peut s’écrire comme un produit matrice-vecteur. Reprenons l’exemple avec et . Les quatre sorties sont:
La matrice est une matrice de Toeplitz: chaque ligne contient les mêmes poids, décalés d’une position. Deux observations:
Parcimonie. La matrice a 20 entrées, mais seulement 2 paramètres libres ( et ). Une couche dense de mêmes dimensions aurait 20 paramètres indépendants. Le nombre de paramètres de la convolution dépend uniquement de la taille du noyau , pas de la taille du signal .
Partage. Les entrées non nulles de chaque ligne sont identiques. Le même noyau est appliqué à chaque position du signal. C’est la structure de Toeplitz qui encode ce partage.
La convolution est donc un cas particulier de la multiplication matricielle que nous avons vue au chapitre 7, avec une matrice qui est creuse et dont les entrées non nulles sont liées entre elles. En deux dimensions, la matrice équivalente est une matrice de Toeplitz par blocs (doublement structurée), mais le principe est le même: la convolution est une opération linéaire avec des contraintes de structure.
Convolution et gradient: la différentiation automatique fait le travail
Puisque la convolution est une opération linéaire, ses dérivées partielles sont simples. À partir de l’équation (1), on obtient directement:
La dérivée par rapport au noyau est une valeur du signal d’entrée; la dérivée par rapport à l’entrée est une valeur du noyau. Rien de nouveau par rapport aux dérivées d’un produit matrice-vecteur.
Dans le contexte d’un réseau de neurones entraîné par différentiation automatique (chapitre 7), nous n’avons pas à calculer ces dérivées à la main. La convolution est une opération différentiable comme une autre dans le graphe de calcul. La bibliothèque de DA la traite exactement comme elle traite une multiplication matricielle ou une fonction d’activation: elle connaît la règle VJP de la convolution et l’applique automatiquement lors de la passe arrière.
Si vous avez compris la différentiation automatique du chapitre 7, vous savez déjà comment entraîner un réseau convolutif. Aucune dérivation supplémentaire n’est nécessaire de votre part.
Source
import jax
import jax.numpy as jnp

def conv1d(w, x):
    """Convolution 1D (corrélation croisée)."""
    K = len(w)
    return jnp.array([jnp.dot(w, x[n:n+K]) for n in range(len(x) - K + 1)])

x = jnp.array([1.0, 3.0, 2.0, 5.0, 1.0])
w = jnp.array([1.0, -1.0])

# Le gradient par rapport au noyau — jax.grad fait tout le travail
perte = lambda w: jnp.sum(conv1d(w, x)**2)
grad_w = jax.grad(perte)(w)

print(f"Sortie de la convolution : {conv1d(w, x)}")
print(f"Gradient de la perte par rapport au noyau : {grad_w}")
Sortie de la convolution : [-2. 1. -3. 4.]
Gradient de la perte par rapport au noyau : [ 30. -30.]
Le gradient est calculé en une ligne. La fonction jax.grad construit automatiquement le graphe de calcul, identifie que conv1d est une composition de produits scalaires et de sommes, et propage le gradient par la règle de la chaîne. Du point de vue de la DA, la convolution n’a rien de spécial.
Biais inductif: pourquoi la convolution est adaptée aux signaux
La convolution est un opérateur linéaire, comme la couche dense. Pourquoi s’en servir plutôt que d’une matrice pleine? La réponse tient dans les biais inductifs que la convolution impose: des hypothèses sur la structure des données qui, lorsqu’elles sont vérifiées, permettent au modèle d’apprendre plus efficacement avec moins de données.
Partage de paramètres
Dans la matrice de Toeplitz (6), chaque ligne contient les mêmes poids, décalés d’une position. Le même noyau est appliqué à chaque position du signal. Si le noyau apprend à détecter un contour vertical, il le détectera partout dans l’image, que ce contour soit en haut à gauche ou en bas à droite.
Cette propriété a un impact direct sur le nombre de paramètres. Un noyau de taille a 9 paramètres, que l’image soit de ou de pixels. Pour comparaison, une couche dense reliant une image entrées à 1024 sorties a environ 106 paramètres, alors qu’une couche convolutive avec 64 noyaux de taille n’en a que (plus les biais). Moins de paramètres signifie moins de risque de surapprentissage et un entraînement plus rapide.
Connectivité locale
Chaque valeur de sortie ne dépend que d’une petite région locale de l’entrée: la fenêtre couverte par le noyau. Dans la matrice de Toeplitz, cela se traduit par une structure en bande: chaque ligne n’a que entrées non nulles sur . Le reste est nul.
Cette connectivité locale encode l’hypothèse que les éléments voisins d’un signal sont plus liés entre eux que les éléments éloignés. Pour une image, les pixels voisins forment ensemble des contours, des textures et des objets. Pour un signal audio, les échantillons proches dans le temps sont fortement corrélés. La couche dense, avec sa matrice pleine, n’a pas cette hypothèse: chaque sortie dépend de toutes les entrées, y compris celles qui sont éloignées.
En empilant plusieurs couches convolutives, les couches profondes combinent les sorties des couches précédentes et accèdent indirectement à des régions de plus en plus larges de l’entrée. Les premières couches détectent des motifs locaux (contours, textures), les couches intermédiaires assemblent ces motifs en structures plus complexes (yeux, roues), et les couches profondes reconnaissent des objets entiers.
Équivariance à la translation
La convolution possède une propriété appelée équivariance à la translation. Définissons l’opérateur de translation sur un signal discret: , qui décale le signal de positions. La convolution commute avec la translation:
Si on décale le signal d’entrée puis qu’on applique la convolution, le résultat est le même que si on avait appliqué la convolution d’abord puis décalé la sortie. Un détecteur de contour qui produit une forte réponse à la position produira la même réponse à la position si l’image est décalée de .
Avec un MLP, ce n’est pas le cas. Décaler l’image d’entrée de quelques pixels produit un vecteur complètement différent du point de vue de la couche dense, et les activations changent de manière imprévisible.
Source
import numpy as np
import matplotlib.pyplot as plt

# Signal avec une bosse localisée
N = 100
x = np.zeros(N)
x[20:35] = np.hanning(15)

# Version décalée
tau = 30
x_shifted = np.zeros(N)
x_shifted[20+tau:35+tau] = np.hanning(15)

# Noyau: dérivée (détecteur de transitions)
w = np.array([1.0, 0.5, 0.0, -0.5, -1.0])

y = np.correlate(x, w, mode='full')[:N]
y_shifted = np.correlate(x_shifted, w, mode='full')[:N]

fig, axes = plt.subplots(2, 2, figsize=(10, 5))

axes[0, 0].plot(x, color='#333')
axes[0, 0].set_title('Signal original $x$')
axes[0, 0].set_ylabel('Amplitude')

axes[0, 1].plot(x_shifted, color='#333')
axes[0, 1].set_title(f'Signal décalé $T_{{{tau}}} x$')

axes[1, 0].plot(y, color='#2196F3')
axes[1, 0].set_title('Convolution $w \\star x$')
axes[1, 0].set_ylabel('Amplitude')
axes[1, 0].set_xlabel('Indice $n$')

axes[1, 1].plot(y_shifted, color='#2196F3')
axes[1, 1].set_title(f'Convolution $w \\star T_{{{tau}}} x$')
axes[1, 1].set_xlabel('Indice $n$')

plt.tight_layout()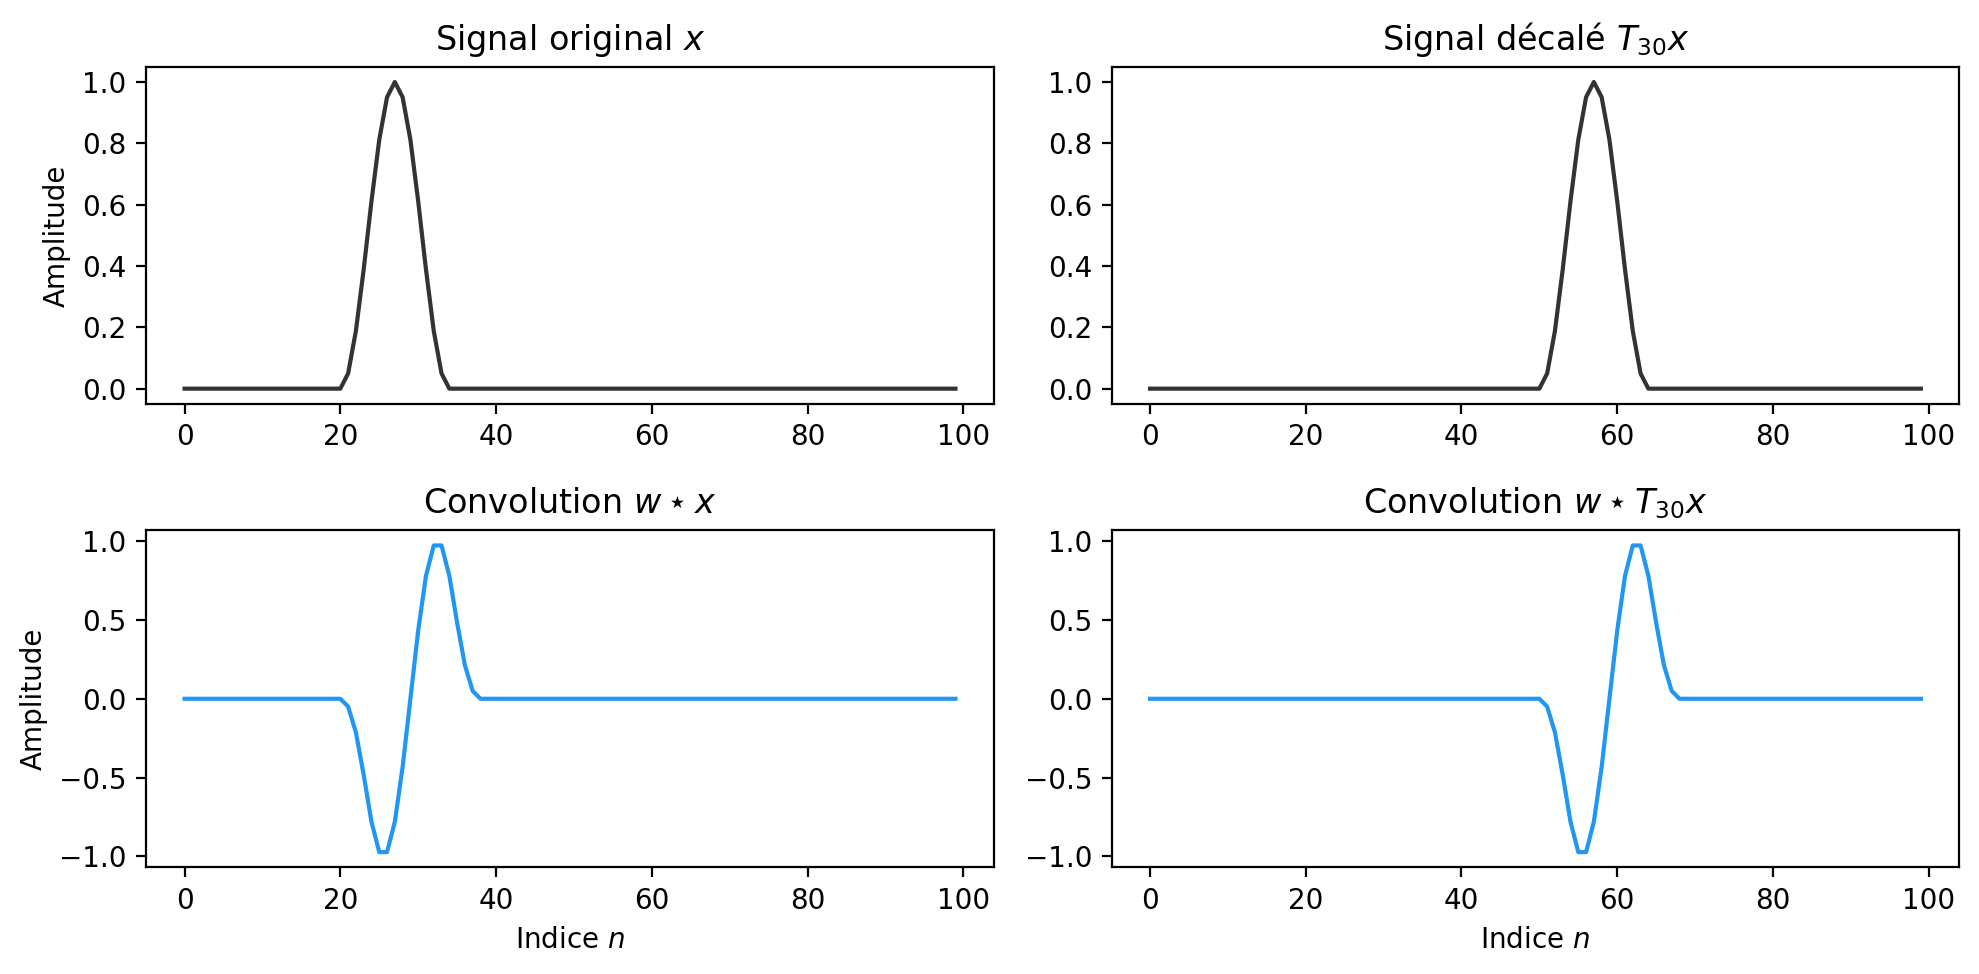
La réponse du noyau se déplace avec le signal, sans changer de forme. La convolution préserve l’information de position.
Une distinction importante: la convolution est équivariante (la sortie se déplace avec l’entrée), pas invariante (la sortie resterait identique quel que soit le déplacement). Pour obtenir une forme d’invariance, utile lorsqu’on veut classifier une image indépendamment de la position de l’objet, on utilise les couches de mise en commun décrites plus loin.
Anatomie d’une couche convolutive
Pas et rembourrage
Dans la définition de base, le noyau avance d’une position à la fois. Le pas (stride) permet de faire avancer le noyau de positions au lieu d’une, réduisant la taille de la sortie. La dimension de sortie en 1D devient .
Le rembourrage (padding) consiste à ajouter des valeurs (typiquement des zéros) autour de l’entrée. Un rembourrage de de chaque côté augmente la taille effective de l’entrée de , ce qui donne une sortie de taille:
En deux dimensions, avec un noyau , un pas et un rembourrage :
Un choix courant est le rembourrage dit « same »: avec , qui donne une sortie de même taille spatiale que l’entrée.
Canaux d’entrée et de sortie
Une image couleur a canaux (rouge, vert, bleu). Chaque noyau d’une couche convolutive opère sur tous les canaux d’entrée: il a pour dimensions . La couche applique noyaux différents, produisant cartes de réponse. Pour le canal de sortie :
Le nombre total de paramètres est (en comptant les biais). La sortie est un tenseur de dimensions , qui sert d’entrée à la couche suivante.
Mise en commun (pooling)
Les couches de mise en commun (pooling) réduisent les dimensions spatiales en résumant une région locale par une seule valeur. La mise en commun maximale (max pooling) sur une fenêtre de taille avec un pas de prend le maximum de chaque région:
La mise en commun par la moyenne remplace le maximum par la moyenne. Dans les deux cas, la dimension spatiale est divisée par dans chaque direction.
La mise en commun n’a pas de paramètres apprenables. Son rôle est double: réduire le coût de calcul des couches suivantes, et introduire une forme d’invariance approximative à la translation. En prenant le maximum sur une fenêtre, de petits déplacements de l’entrée n’affectent pas la sortie si le maximum reste dans la même fenêtre.
La mise en commun globale par la moyenne (global average pooling) est un cas extrême: la fenêtre couvre toute la carte de réponse, produisant un seul scalaire par canal. C’est une façon d’éliminer toute dimension spatiale avant de passer à une couche dense de classification, dans l’esprit de l’architecture tronc-tête décrite au chapitre 8.
Démonstrations: l’effet d’un noyau sur un signal
Filtrage d’un signal composite en 1D
Considérons un signal composé de sinusoïdes à différentes fréquences, auxquelles on ajoute du bruit. Différents noyaux extraient différentes composantes du signal.
Source
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(0)
N = 500
t = np.linspace(0, 1, N, endpoint=False)

# Signal composite: basse fréquence + haute fréquence + bruit
basse = 2.0 * np.sin(2 * np.pi * 3 * t)
haute = 0.5 * np.sin(2 * np.pi * 40 * t)
bruit = 0.3 * rng.standard_normal(N)
signal = basse + haute + bruit

# Noyaux
K_lp = 25
w_lp = np.ones(K_lp) / K_lp  # Passe-bas: moyenne mobile

sigma_bp = 2.0
w_bp_base = np.exp(-0.5 * np.linspace(-3, 3, 15)**2 / sigma_bp**2)
w_bp = w_bp_base / w_bp_base.sum()
w_hp = np.zeros(15)
w_hp[7] = 1.0
w_hp = w_hp - w_bp  # Passe-haut: identité - passe-bas

y_lp = np.convolve(signal, w_lp, mode='valid')
y_hp = np.convolve(signal, w_hp, mode='valid')

fig, axes = plt.subplots(3, 1, figsize=(10, 6), sharex=True)

t_plot = t[:len(y_lp)]
axes[0].plot(t, signal, color='#333', alpha=0.7, linewidth=0.5)
axes[0].set_ylabel('Amplitude')
axes[0].set_title('Signal composite (basse fréquence + haute fréquence + bruit)')

axes[1].plot(t_plot, y_lp, color='#2196F3')
axes[1].set_ylabel('Amplitude')
axes[1].set_title(f'Filtre passe-bas (moyenne mobile, $K = {K_lp}$)')

t_hp = t[:len(y_hp)]
axes[2].plot(t_hp, y_hp, color='#E91E63')
axes[2].set_ylabel('Amplitude')
axes[2].set_title('Filtre passe-haut (identité $-$ gaussien)')
axes[2].set_xlabel('Temps (s)')

plt.tight_layout()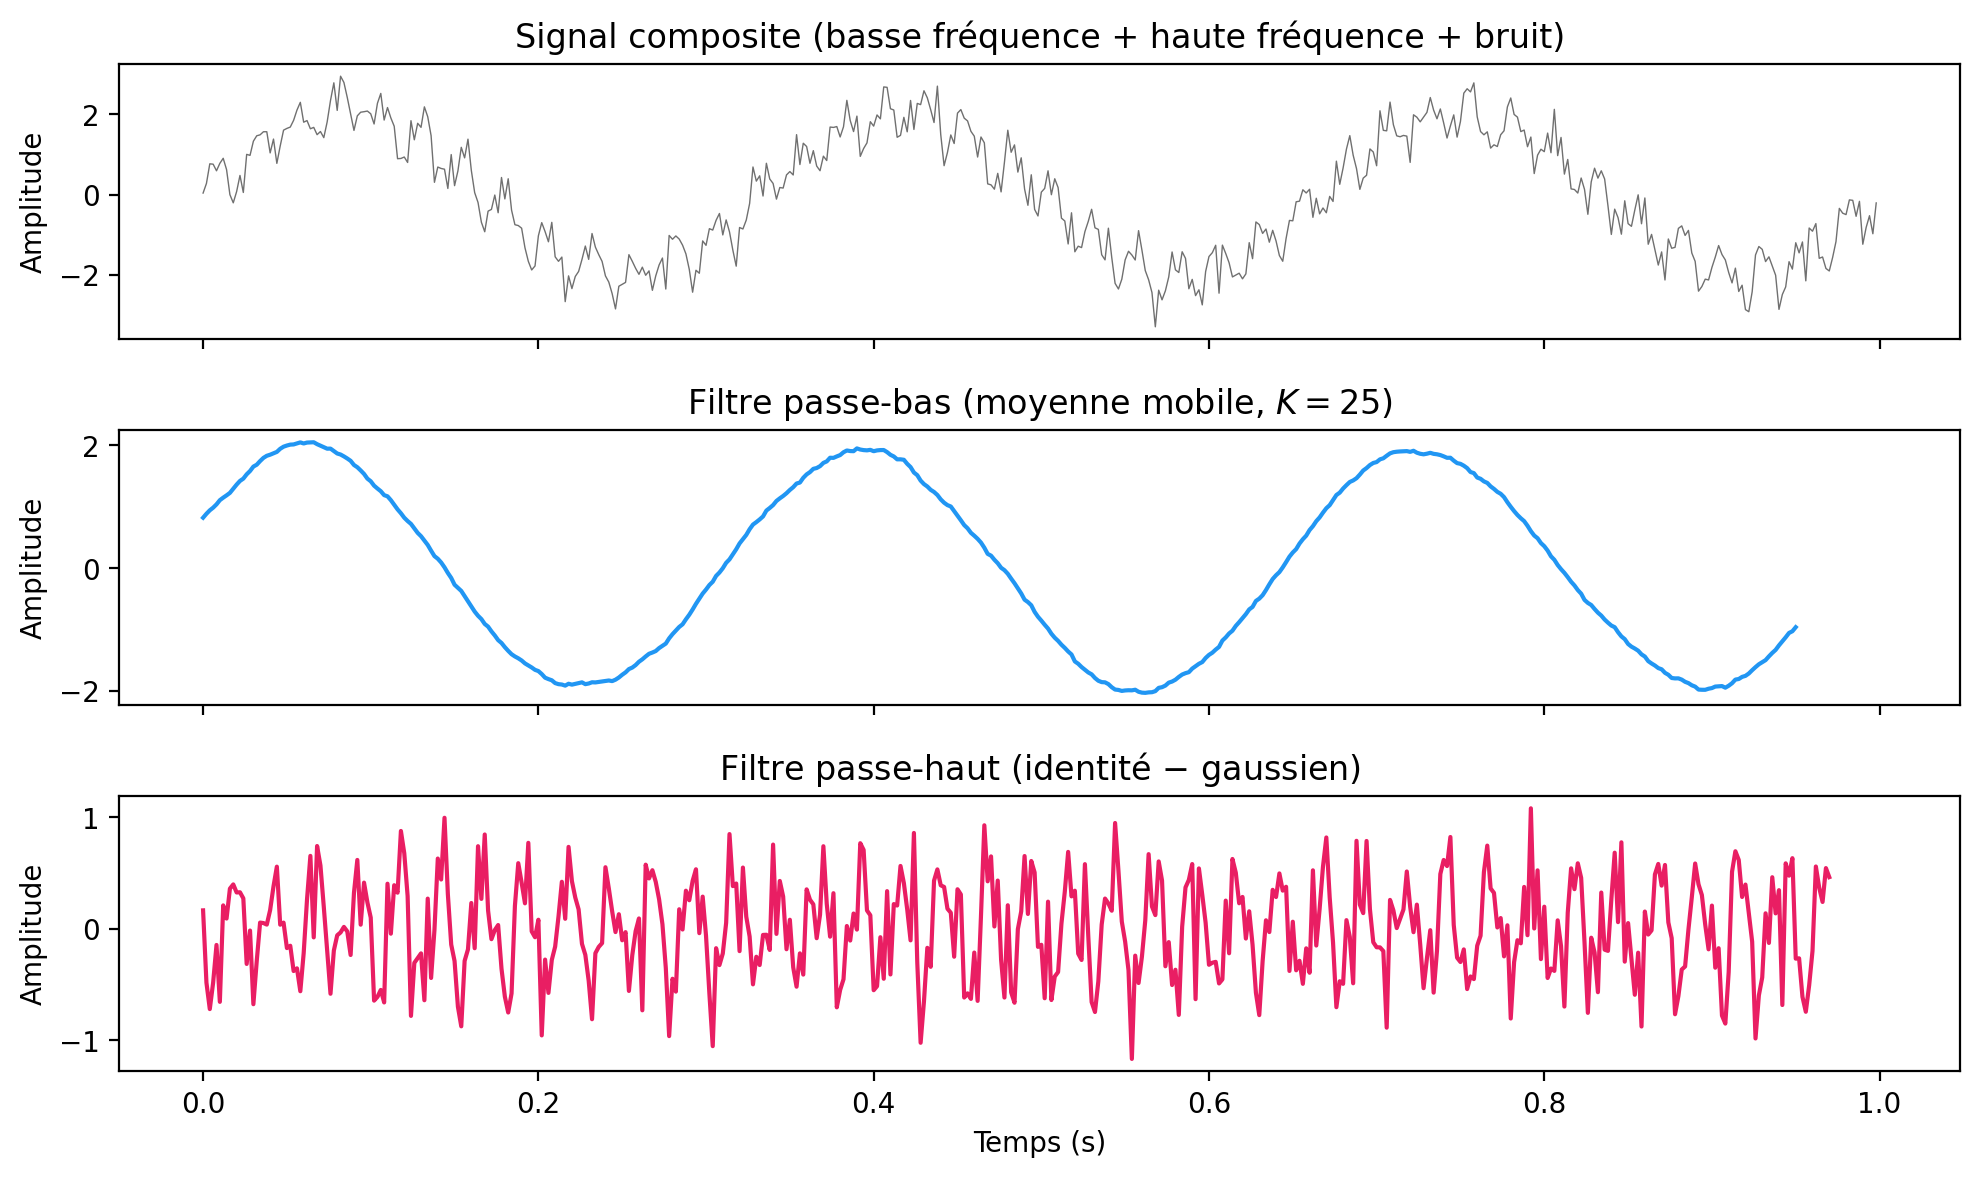
Le filtre passe-bas extrait la composante lente du signal en éliminant les oscillations rapides et le bruit. Le filtre passe-haut fait l’inverse: il supprime la tendance lente et ne conserve que les variations rapides. Un réseau convolutif apprend à combiner ce type de filtrage, couche après couche, pour construire une représentation adaptée à la tâche.
Noyaux classiques en 2D
Revenons aux images. Les noyaux classiques du traitement d’image montrent différents aspects de la structure visuelle.
Source
import numpy as np
import matplotlib.pyplot as plt
from scipy.signal import correlate2d
from scipy.datasets import face

img = np.mean(face(), axis=2)
img = img[100:600, 200:800]

# Noyau laplacien: détection de tous les contours
laplacien = np.array([[ 0,  1,  0],
                      [ 1, -4,  1],
                      [ 0,  1,  0]], dtype=float)

# Noyau de relief (emboss)
emboss = np.array([[-2, -1, 0],
                   [-1,  1, 1],
                   [ 0,  1, 2]], dtype=float)

# Grand lissage gaussien
x_g = np.linspace(-3, 3, 15)
gauss_1d = np.exp(-0.5 * x_g**2)
gauss_2d = np.outer(gauss_1d, gauss_1d)
gauss_2d = gauss_2d / gauss_2d.sum()

resp_lap = correlate2d(img, laplacien, mode='same', boundary='symm')
resp_emboss = correlate2d(img, emboss, mode='same', boundary='symm')
resp_gauss = correlate2d(img, gauss_2d, mode='same', boundary='symm')

fig, axes = plt.subplots(2, 2, figsize=(10, 8))

axes[0, 0].imshow(img, cmap='gray')
axes[0, 0].set_title('Image originale')
axes[0, 0].axis('off')

axes[0, 1].imshow(np.abs(resp_lap), cmap='gray', vmax=np.percentile(np.abs(resp_lap), 99))
axes[0, 1].set_title('Laplacien (tous les contours)')
axes[0, 1].axis('off')

axes[1, 0].imshow(resp_emboss, cmap='gray')
axes[1, 0].set_title('Relief (emboss)')
axes[1, 0].axis('off')

axes[1, 1].imshow(resp_gauss, cmap='gray')
axes[1, 1].set_title('Lissage gaussien ($15 \\times 15$)')
axes[1, 1].axis('off')

plt.tight_layout()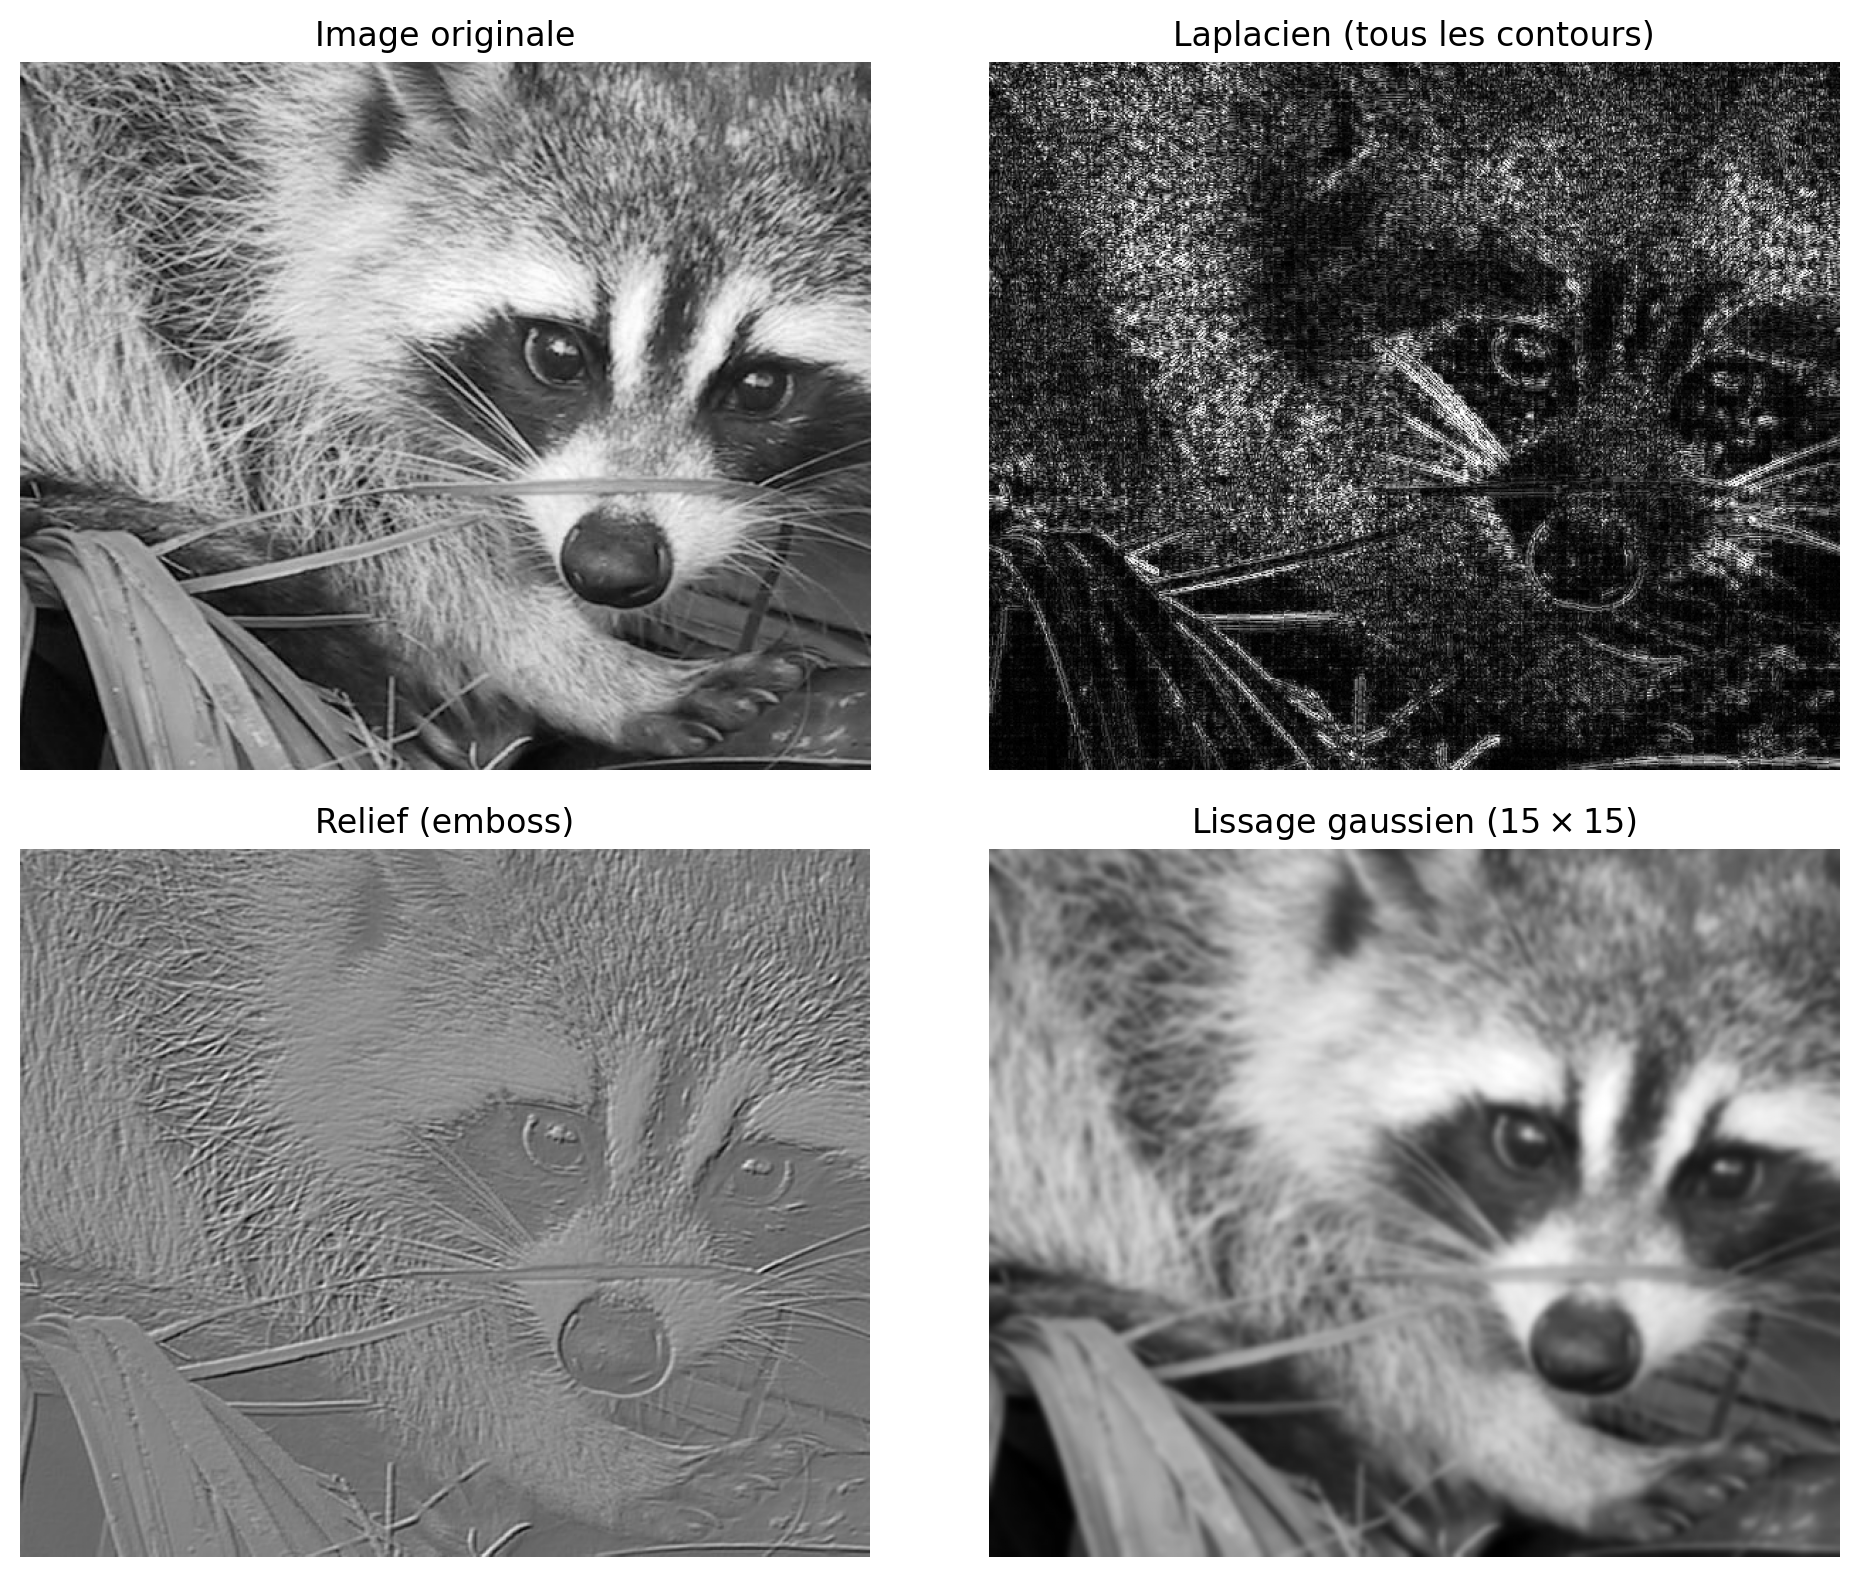
Le laplacien détecte les contours dans toutes les directions en mesurant la courbure locale de l’intensité. Le noyau de relief crée un effet tridimensionnel en accentuant les transitions dans une direction particulière. Le lissage gaussien large efface les détails fins et ne conserve que les structures à grande échelle. Chacun de ces effets résulte d’un noyau de quelques dizaines de paramètres, appliqué de manière identique à toutes les positions de l’image.
Les détecteurs de caractéristiques appris
Les noyaux que nous venons de voir étaient conçus à la main. Dans un réseau convolutif, les noyaux sont des paramètres appris par descente de gradient. Que découvre le réseau?
Visualiser les noyaux d’un réseau pré-entraîné
Examinons la première couche de convolution d’un réseau ResNet-18 entraîné sur ImageNet (un jeu de données de plus d’un million d’images naturelles, réparties en 1000 catégories). Cette couche applique 64 noyaux de taille aux 3 canaux de couleur de l’image d’entrée.
Source
import logging, warnings, os
logging.disable(logging.INFO)
warnings.filterwarnings("ignore")
os.environ["TORCH_HOME"] = "/tmp/torch_cache"

import torch
import torchvision.models as models
import numpy as np
import matplotlib.pyplot as plt

model = models.resnet18(weights=models.ResNet18_Weights.DEFAULT)
filters = model.conv1.weight.data.clone().cpu().numpy()  # (64, 3, 7, 7)

# Normaliser chaque filtre individuellement pour l'affichage
filters_display = np.zeros_like(filters)
for i in range(filters.shape[0]):
    f = filters[i]
    filters_display[i] = (f - f.min()) / (f.max() - f.min() + 1e-8)

fig, axes = plt.subplots(8, 8, figsize=(10, 10))
for i, ax in enumerate(axes.flat):
    ax.imshow(np.transpose(filters_display[i], (1, 2, 0)))
    ax.axis('off')
fig.suptitle('64 noyaux de la première couche de ResNet-18 ($7 \\times 7 \\times 3$)',
             fontsize=13, y=1.01)
plt.tight_layout()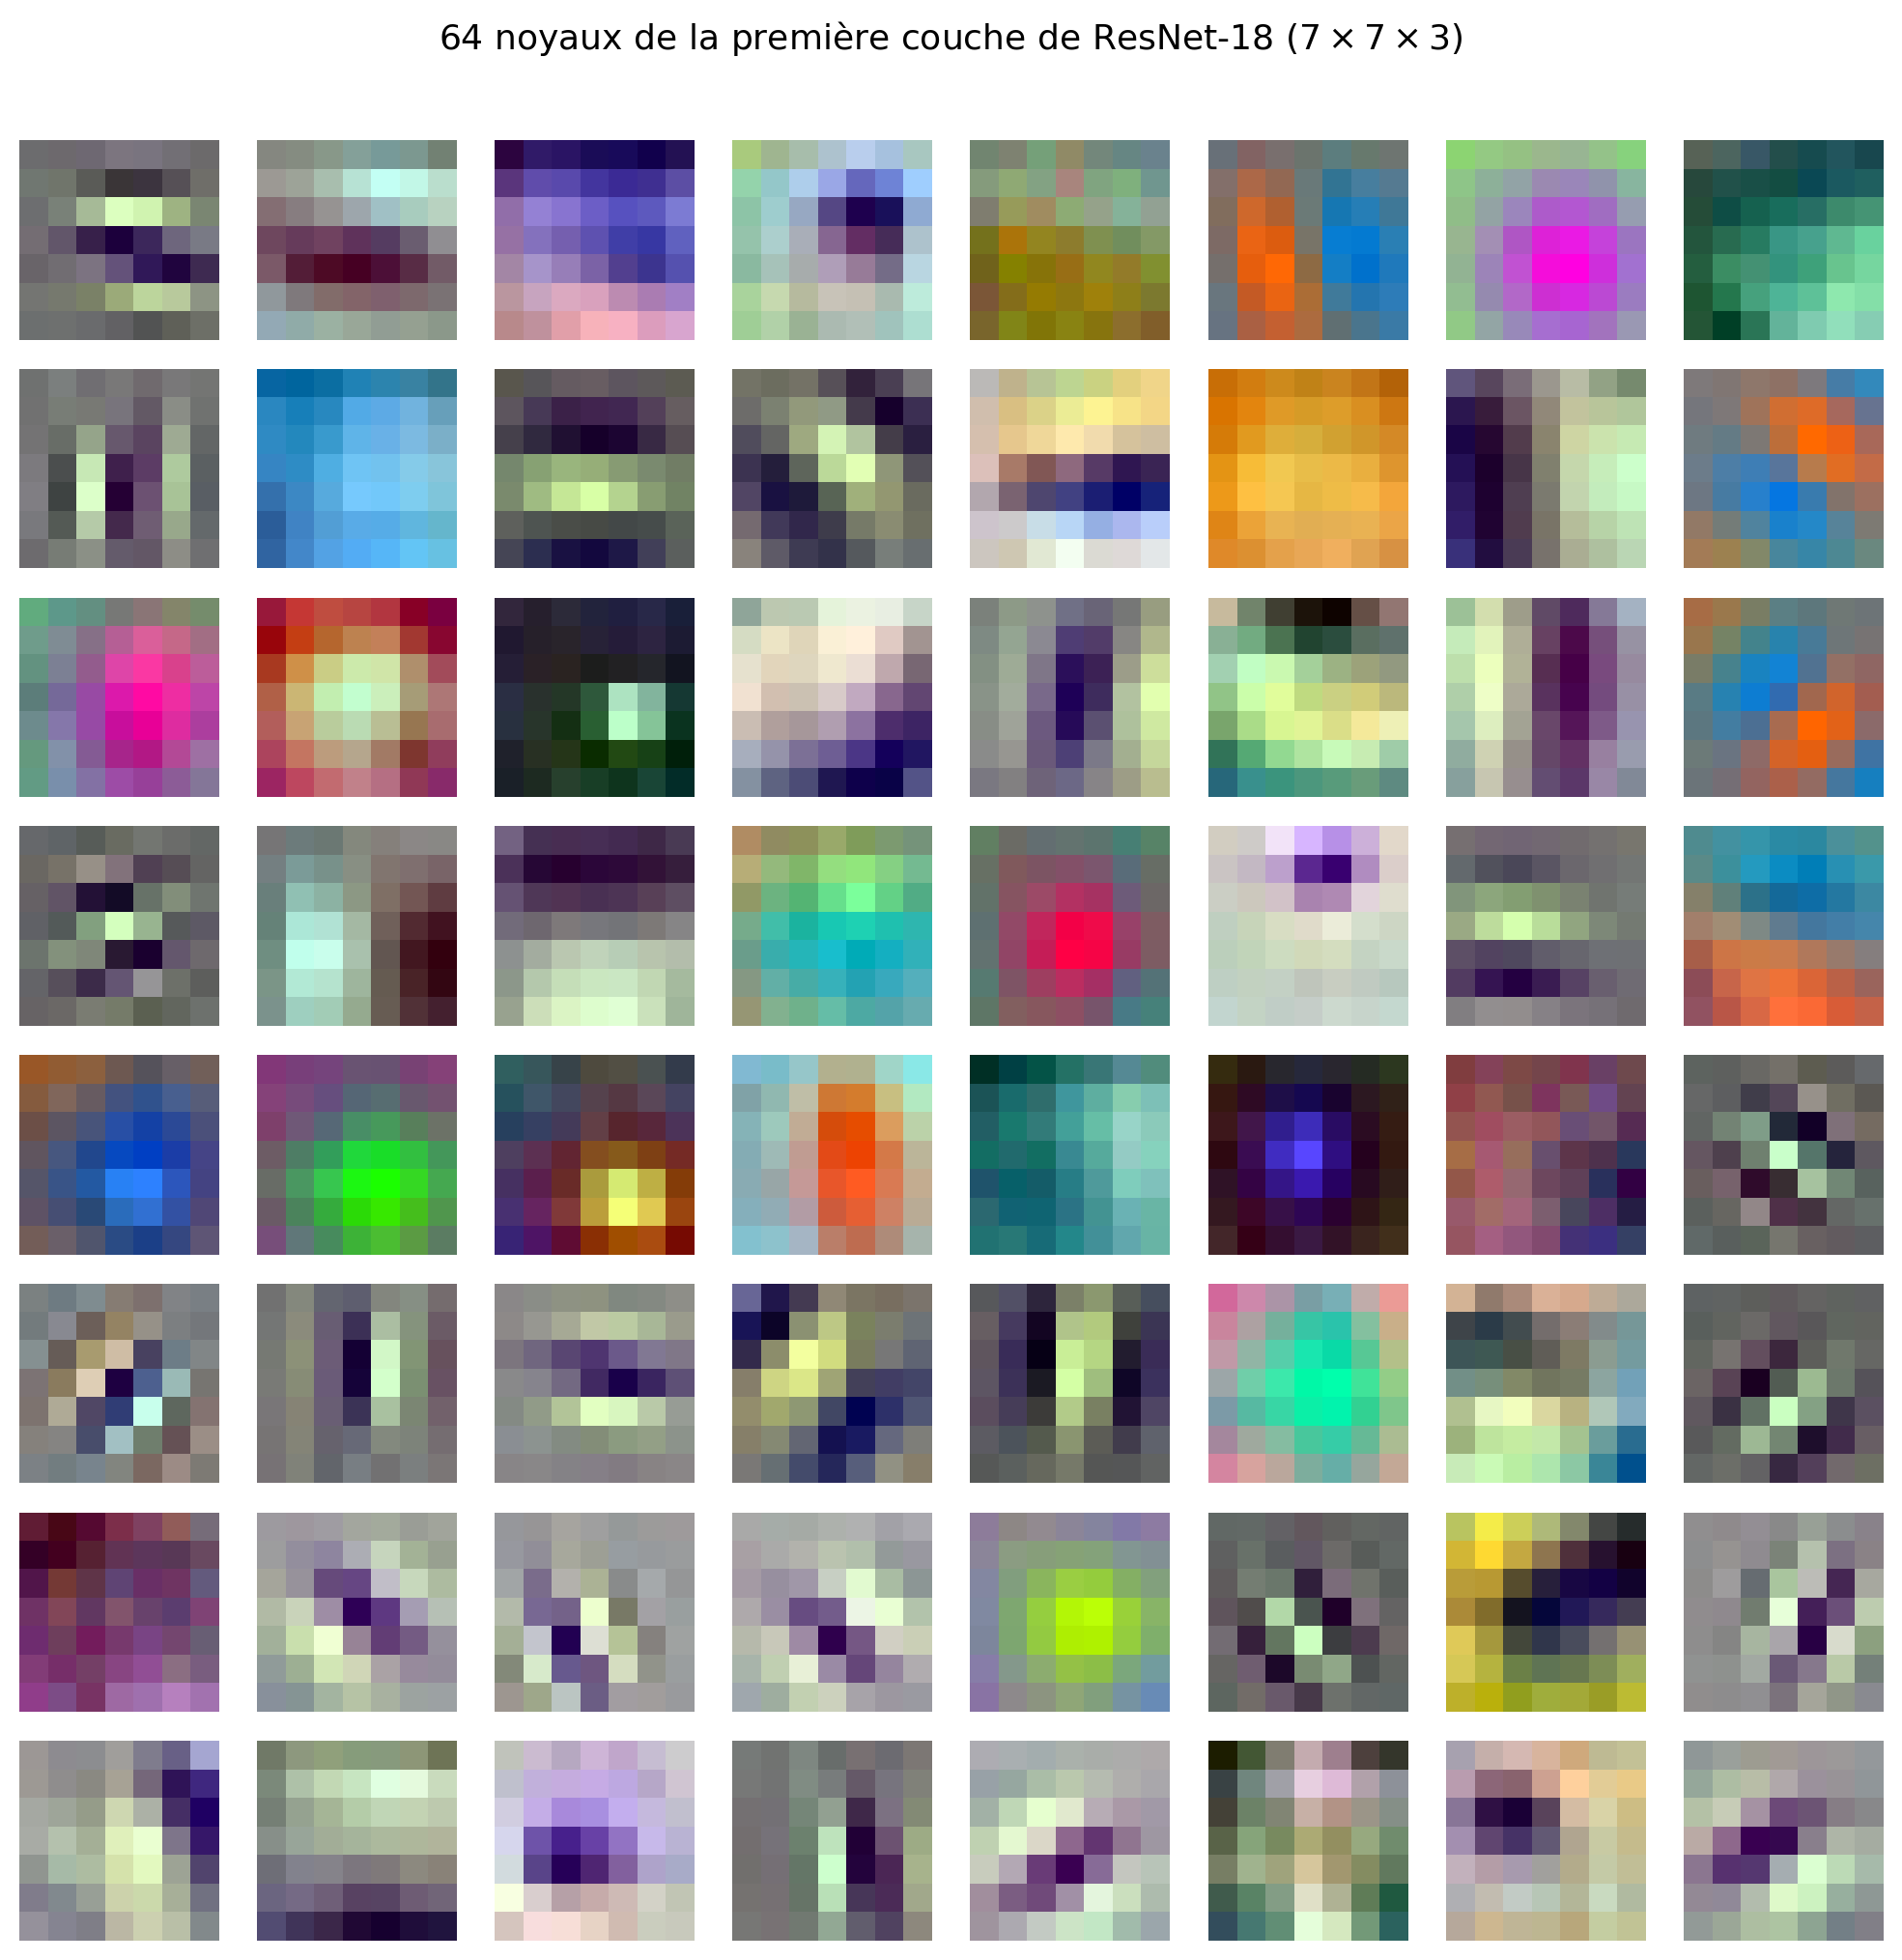
Ces noyaux appris ressemblent aux filtres classiques du traitement d’images. Certains détectent des contours à différentes orientations (horizontaux, verticaux, diagonaux). D’autres répondent à des contrastes de couleur (rouge contre bleu, clair contre sombre). D’autres encore détectent des textures simples. Le réseau a redécouvert ces opérations à partir des données, sans qu’on les lui ait prescrites.
Visualiser les cartes d’activation
Pour comprendre ce que chaque noyau « voit » dans une image concrète, on peut passer une image à travers la première couche et examiner les cartes de réponse.
Source
import logging, warnings, os
logging.disable(logging.INFO)
warnings.filterwarnings("ignore")
os.environ["TORCH_HOME"] = "/tmp/torch_cache"

import torch
import torchvision.models as models
import torchvision.transforms as transforms
import numpy as np
import matplotlib.pyplot as plt
from scipy.datasets import face

model = models.resnet18(weights=models.ResNet18_Weights.DEFAULT)
model.eval()

# Préparer l'image
img_rgb = face()[100:600, 200:800]
transform = transforms.Compose([
    transforms.ToPILImage(),
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406],
                         std=[0.229, 0.224, 0.225]),
])
img_tensor = transform(img_rgb.astype(np.uint8)).unsqueeze(0)

# Extraire les activations après la première convolution + batch norm + relu
with torch.no_grad():
    x = model.conv1(img_tensor)
    x = model.bn1(x)
    activations = model.relu(x)  # (1, 64, 112, 112)

act = activations.squeeze(0).numpy()

fig, axes = plt.subplots(4, 8, figsize=(14, 7))
for i, ax in enumerate(axes.flat):
    ax.imshow(act[i], cmap='viridis')
    ax.axis('off')
    ax.set_title(f'{i}', fontsize=8, pad=2)
fig.suptitle('Cartes de réponse de la première couche de ResNet-18',
             fontsize=13, y=1.01)
plt.tight_layout()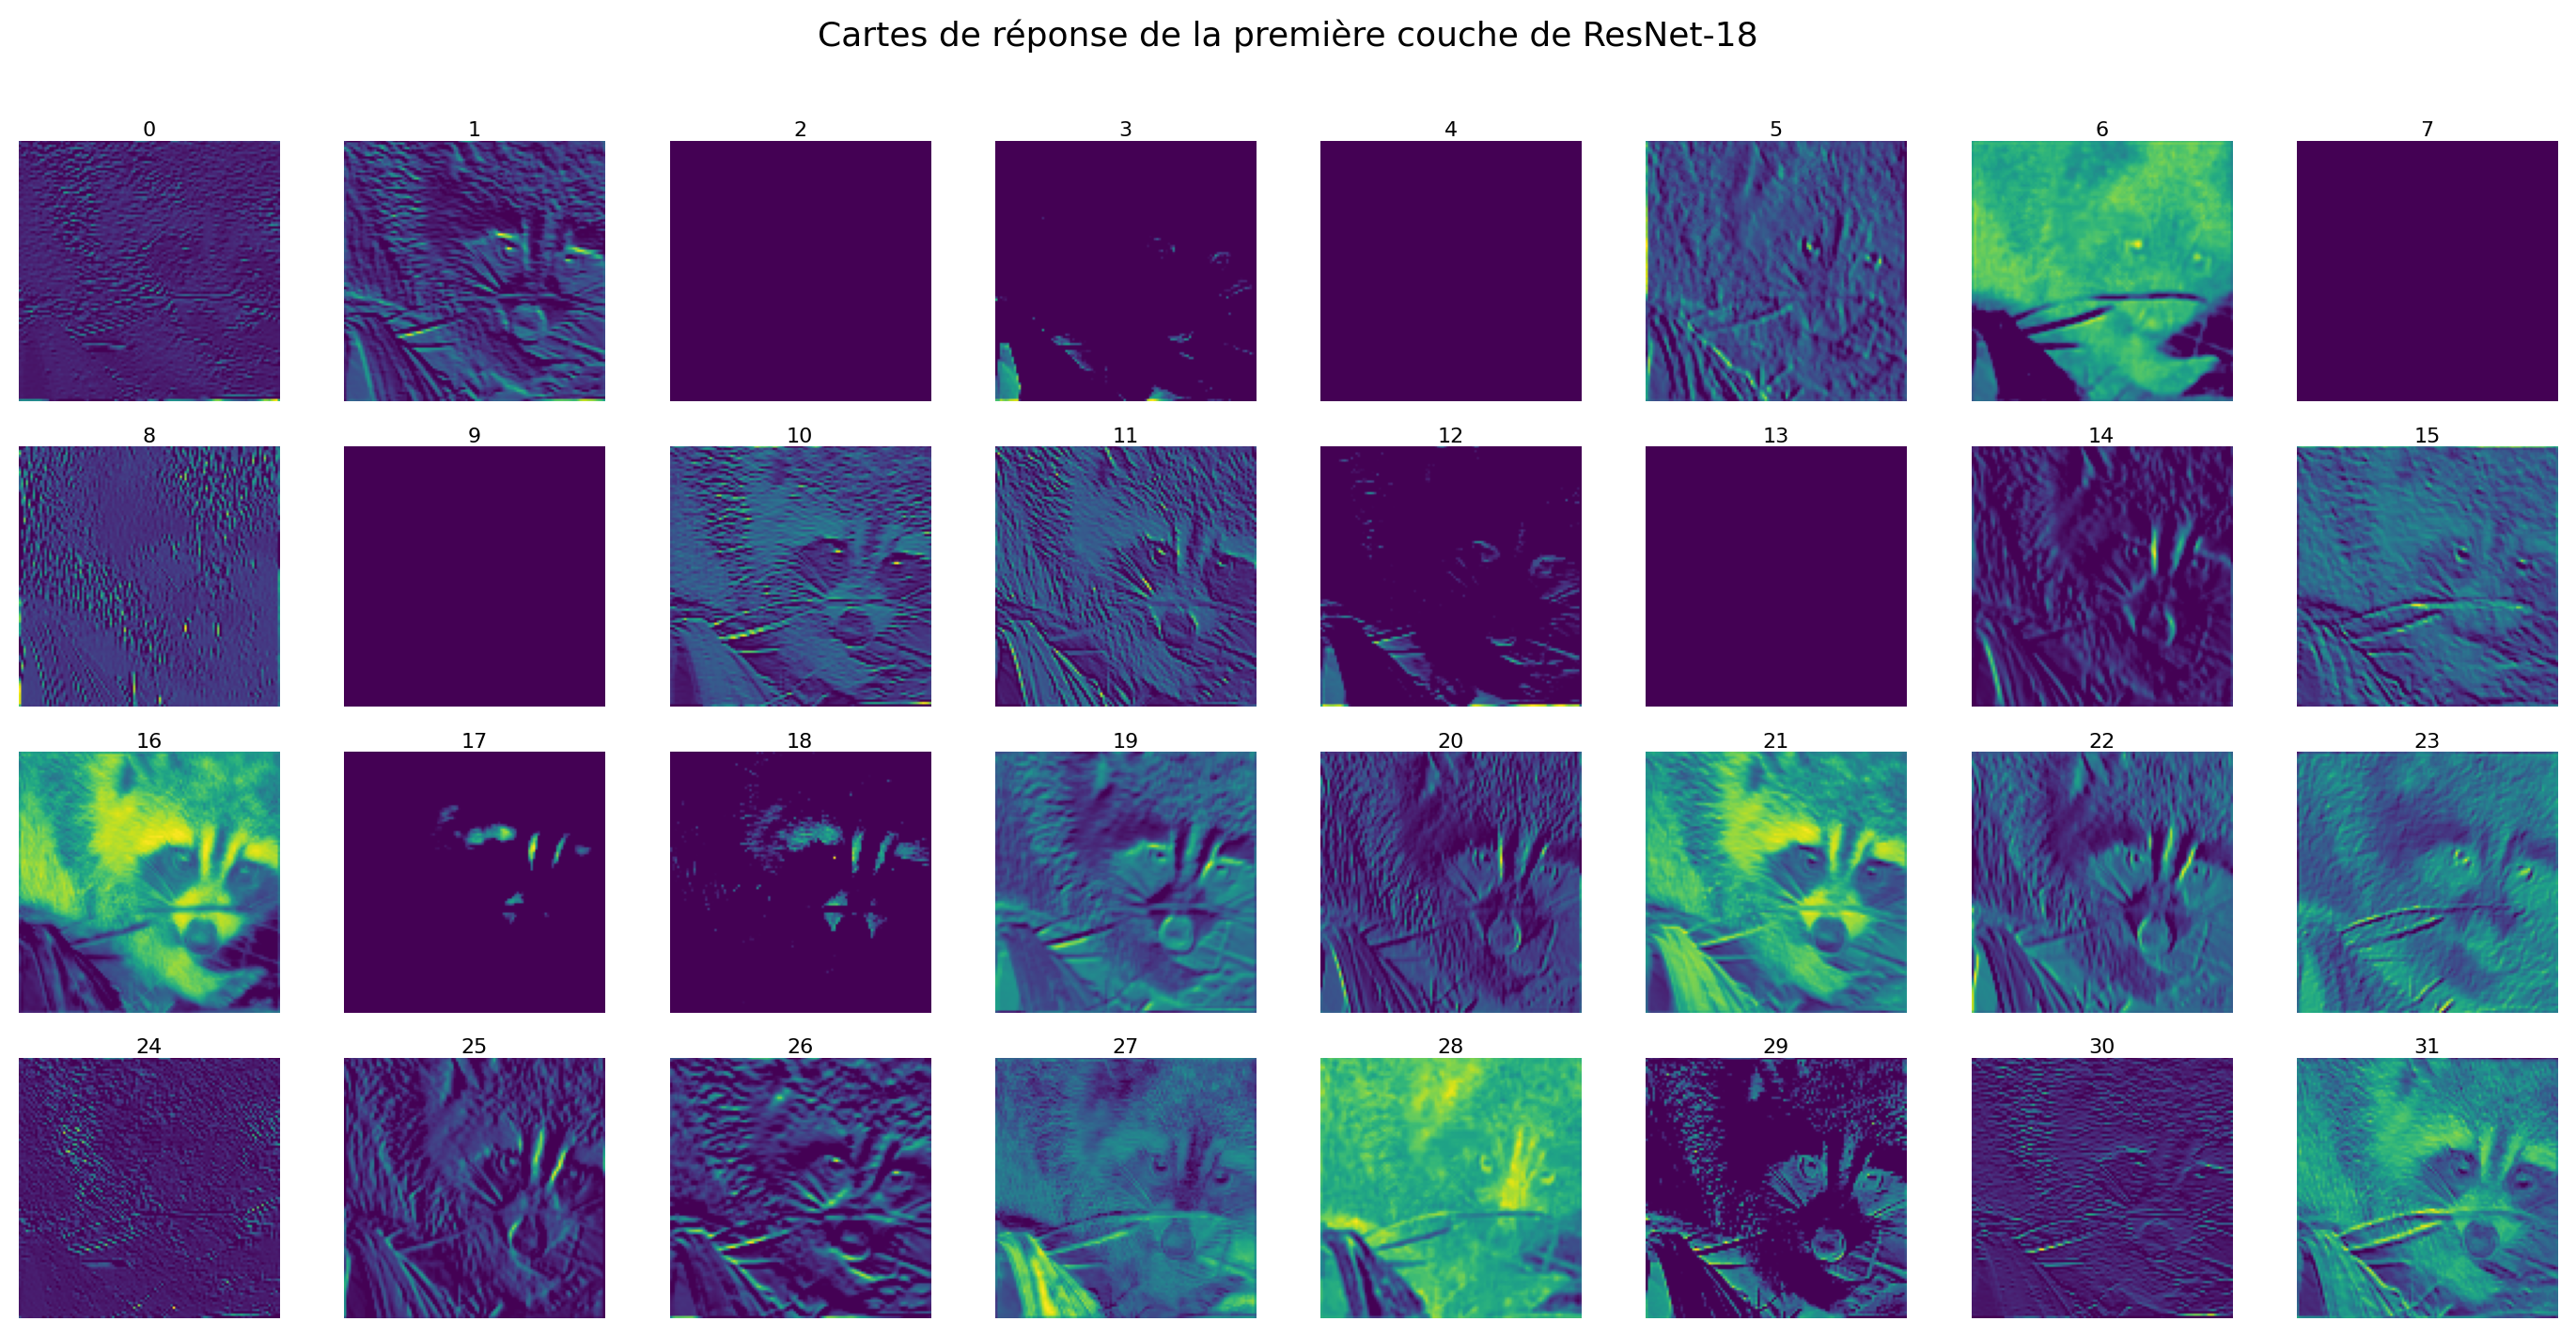
Chaque carte de réponse montre les régions de l’image auxquelles un noyau appris réagit le plus fortement. Certains canaux détectent les contours horizontaux, d’autres les contours verticaux, d’autres encore les zones de couleur uniforme ou les transitions de contraste. En superposant et en combinant ces cartes au fil des couches, le réseau construit une description progressivement plus abstraite de l’image, des contours locaux aux objets entiers.
Résumé
Ce chapitre a introduit la convolution comme une opération linéaire structurée, alternative à la couche dense pour les données spatiales. La convolution est définie par un noyau qui glisse sur le signal d’entrée, calculant une somme pondérée locale à chaque position. Cette opération peut s’écrire comme un produit matrice-vecteur avec une matrice de Toeplitz, et la différentiation automatique du chapitre 7 la traite sans modification.
La convolution est utile parce qu’elle impose trois biais inductifs adaptés aux images et aux signaux: le partage de paramètres (le même détecteur à chaque position), la connectivité locale (chaque sortie dépend d’un voisinage), et l’équivariance à la translation (la réponse se déplace avec l’entrée). Ces biais réduisent le nombre de paramètres et améliorent la généralisation lorsque les données ont une structure spatiale.
Les démonstrations visuelles ont montré que les noyaux, qu’ils soient conçus à la main ou appris par un réseau profond, extraient des caractéristiques locales du signal. Les premiers noyaux d’un réseau entraîné sur des images naturelles détectent des contours, des textures et des contrastes de couleur, fournissant une base sur laquelle les couches profondes construisent des représentations de plus en plus abstraites.
Exercices
Les exercices ★ vérifient la compréhension de base. Les exercices ★★ demandent d’appliquer les concepts à des calculs concrets. Les exercices ★★★ approfondissent le sujet et sont optionnels pour IFT3395.
Exercice 1: Convolution 1D à la main ★
Soit le signal et le noyau .
Calculez la sortie en appliquant la convolution (corrélation croisée) définie par l’équation (1).
Quelle est la taille de ?
Que détecte ce noyau dans le signal?
Solution Exercice 1
Le noyau a éléments, le signal a éléments, donc la sortie a éléments.
Donc . Ce noyau calcule la différence entre une valeur et celle deux positions plus loin (): il détecte les variations du signal sur une fenêtre de 3 éléments, en ignorant l’élément central.
Exercice 2: Dimensions de sortie ★
Soit une image d’entrée de taille avec canal. On applique une couche de convolution avec 16 noyaux de taille , un pas et un rembourrage .
Quelle est la taille spatiale de la sortie?
Combien de paramètres cette couche a-t-elle (incluant les biais)?
Quel rembourrage donnerait une sortie de même taille spatiale que l’entrée?
Solution Exercice 2
En appliquant la formule (10): . La sortie est de taille .
Chaque noyau a poids, plus un biais. Avec 16 noyaux: paramètres.
On veut : , donc , soit . C’est le rembourrage « same » pour un noyau de taille 5: .
Exercice 3: Matrice de Toeplitz et gradient ★★
Considérez la convolution 1D avec et .
Écrivez la matrice de Toeplitz telle que .
Supposons que la perte est . Calculez et par la règle de la chaîne.
Montrez que ces gradients s’écrivent comme une corrélation croisée entre le gradient amont (qui vaut dans ce cas) et le signal d’entrée.
Solution Exercice 3
Exercice 4: Équivariance à la translation ★★
Prouvez que la convolution discrète 1D est équivariante à la translation: si et pour un entier , alors .
Donnez un exemple d’opération qui est invariante à la translation (la sortie ne change pas du tout lorsque l’entrée est décalée).
Expliquez pourquoi la mise en commun maximale avec une grande fenêtre introduit une invariance approximative à la translation.
Solution Exercice 4
Par définition:
La dernière égalité utilise la définition de . La convolution commute avec la translation.
La somme globale est invariante à la translation: permuter ou décaler les éléments ne change pas la somme. De même, le maximum global est invariant.
La mise en commun maximale sur une fenêtre de taille calcule . Si l’entrée est décalée de , le maximum reste souvent inchangé tant que l’élément maximal reste dans la même fenêtre. L’invariance est approximative car elle dépend de la position relative de l’élément maximal dans la fenêtre, et elle n’est exacte que pour des décalages petits par rapport à .
Exercice 5: Comptage de paramètres, MLP vs ConvNet ★★★
On veut classifier des images en couleur (3 canaux) en 10 classes.
Architecture A (MLP): entrée aplatie → couche dense de 256 neurones → ReLU → couche dense de 10 neurones.
Architecture B (ConvNet): Conv(, 32 filtres, pas 1, rembourrage 1) → ReLU → MaxPool() → Conv(, 64 filtres, pas 1, rembourrage 1) → ReLU → MaxPool() → mise à plat → couche dense de 10 neurones.
Calculez le nombre total de paramètres de l’architecture A.
Calculez le nombre total de paramètres de l’architecture B (détaillez les dimensions intermédiaires à chaque étape).
Laquelle a le moins de paramètres? Discutez le compromis en termes de biais inductif.
Solution Exercice 5
Architecture A:
Couche 1: entrée 3072, sortie 256 → paramètres
Couche 2: entrée 256, sortie 10 → paramètres
Total: paramètres
Architecture B:
Conv 1: entrée , noyaux → paramètres. Sortie: (rembourrage « same »)
MaxPool: sortie
Conv 2: noyaux → paramètres. Sortie:
MaxPool: sortie valeurs
Dense: paramètres
Total: paramètres
L’architecture B a environ 13 fois moins de paramètres que l’architecture A. Le partage de paramètres et la connectivité locale de la convolution réduisent le nombre de paramètres, tandis que les biais inductifs (équivariance, localité) rendent le modèle mieux adapté aux images. Le MLP, en revanche, n’a aucune hypothèse sur la structure spatiale: il peut en principe apprendre n’importe quelle fonction de , mais il a besoin de beaucoup plus de données pour compenser l’absence de biais inductif.