Le chapitre précédent a défini l’architecture des réseaux de neurones et montré comment la différentiation automatique calcule leurs gradients. Il reste à décider comment utiliser ces gradients pour entraîner le réseau, et comment s’assurer que le réseau entraîné généralise bien.
Nous commençons par les algorithmes d’optimisation: la descente de gradient stochastique par mini-lots, le momentum et Adam. Nous examinons ensuite pourquoi les méthodes du second ordre, malgré leur convergence plus rapide en théorie, sont rarement utilisées en pratique. La troisième section aborde les problèmes de stabilité du gradient en profondeur et les techniques pour y remédier (initialisation, normalisation, connexions résiduelles). Nous présentons ensuite les méthodes de régularisation, puis nous terminons par le pré-entraînement et le transfert de représentations, une approche qui transforme l’initialisation en un levier d’optimisation.
Optimisation par gradient stochastique
La différentiation automatique produit les gradients . Il reste à décider comment utiliser ces gradients pour mettre à jour les paramètres. Cette section présente les algorithmes d’optimisation les plus utilisés en pratique, de la descente de gradient stochastique jusqu’à Adam.
Descente de gradient stochastique par mini-lots
Nous avons vu la descente de gradient au chapitre 3. Pour un réseau de neurones entraîné sur exemples, calculer le gradient exact sur tout le jeu de données à chaque itération est coûteux. La descente de gradient stochastique par mini-lots (minibatch SGD) estime le gradient sur un sous-ensemble aléatoire de exemples:
où est un mini-lot de taille tiré aléatoirement. Cette estimation est non biaisée: . La mise à jour des paramètres est:
où est le taux d’apprentissage. Une époque correspond à un passage complet sur le jeu de données, soit mises à jour. Les données sont brassées aléatoirement à chaque époque pour éviter les biais d’ordre.
En pratique, est souvent entre 32 et 512. Un petit introduit plus de bruit dans l’estimation du gradient (haute variance), ce qui peut aider à échapper aux minima locaux mais ralentit la convergence. Un grand donne une estimation plus précise mais réduit l’effet régularisateur du bruit stochastique.
Momentum
Un problème de SGD est l’oscillation: sur une surface de perte avec des directions de courbures très différentes (une vallée étroite et allongée, par exemple), le gradient pointe perpendiculairement aux parois et le pas fait zigzaguer d’une paroi à l’autre, progressant lentement dans la direction de la vallée.
L’idée du momentum Polyak (1964) est d’accumuler une vitesse dans les directions stables et d’amortir les oscillations. On maintient un vecteur de vitesse qui est une moyenne pondérée exponentiellement des gradients passés:
Le paramètre (typiquement ) contrôle la “mémoire”: avec , la mise à jour actuelle contribue à 10% de la vitesse, et les gradients des 10 derniers pas ont encore une influence notable. On peut vérifier que , ce qui montre que est bien une moyenne pondérée des gradients passés, avec des poids décroissant géométriquement.
La variante Nesterov Nesterov (1983) calcule le gradient à la position anticipée plutôt qu’à la position courante:
Cette “anticipation” améliore la convergence en théorie et souvent en pratique.
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

# f(θ) = 0.1 θ₁² + 2 θ₂² : vallée allongée (condition number 20)
def grad_f(t): return np.array([0.2*t[0], 4*t[1]])

theta0 = np.array([-5.0, 2.0])
eta    = 0.4
beta   = 0.5
n_steps = 30

# SGD
traj_sgd = [theta0.copy()]
t = theta0.copy()
for _ in range(n_steps):
    t = t - eta * grad_f(t)
    traj_sgd.append(t.copy())
traj_sgd = np.array(traj_sgd)

# SGD + Momentum
traj_mom = [theta0.copy()]
t = theta0.copy(); m = np.zeros(2)
for _ in range(n_steps):
    m = beta * m + grad_f(t)
    t = t - eta * m
    traj_mom.append(t.copy())
traj_mom = np.array(traj_mom)

t1 = np.linspace(-5.5, 1.0, 300)
t2 = np.linspace(-2.5, 2.5, 300)
T1, T2 = np.meshgrid(t1, t2)
Z = 0.1*T1**2 + 2*T2**2

fig, axes = plt.subplots(1, 2, figsize=(10, 4), sharey=True)
plt.suptitle(r'SGD vs momentum sur $f(\theta) = 0{,}1\,\theta_1^2 + 2\,\theta_2^2$', fontsize=11)

trajs  = [traj_sgd, traj_mom]
titles = ['SGD', r'SGD + Momentum ($\beta=0{,}5$)']
colors = ['#1f77b4', '#d62728']

for ax, traj, title, color in zip(axes, trajs, titles, colors):
    ax.contourf(T1, T2, Z, levels=20, cmap='Greys', alpha=0.5)
    ax.contour( T1, T2, Z, levels=20, colors='gray', linewidths=0.4, alpha=0.6)
    n = len(traj) - 1
    for i in range(n):
        alpha = 0.25 + 0.75 * (i / n)
        ax.plot(traj[i:i+2, 0], traj[i:i+2, 1], '-', color=color, lw=2, alpha=alpha)
    ax.plot(*traj[0],  'ko', ms=8,  zorder=5, label='Départ')
    ax.plot(*traj[-1], 'o',  ms=7,  color=color, zorder=6, label='Arrivée')
    ax.plot(0, 0, 'r*', ms=12, zorder=5, label='Minimum')
    ax.set_xlabel(r'$\theta_1$')
    ax.set_title(title, fontsize=10)
    ax.legend(fontsize=8, loc='upper right')
    ax.set_xlim(-5.5, 1.0); ax.set_ylim(-2.5, 2.5)
    ax.grid(True, alpha=0.2)

axes[0].set_ylabel(r'$\theta_2$')
plt.tight_layout()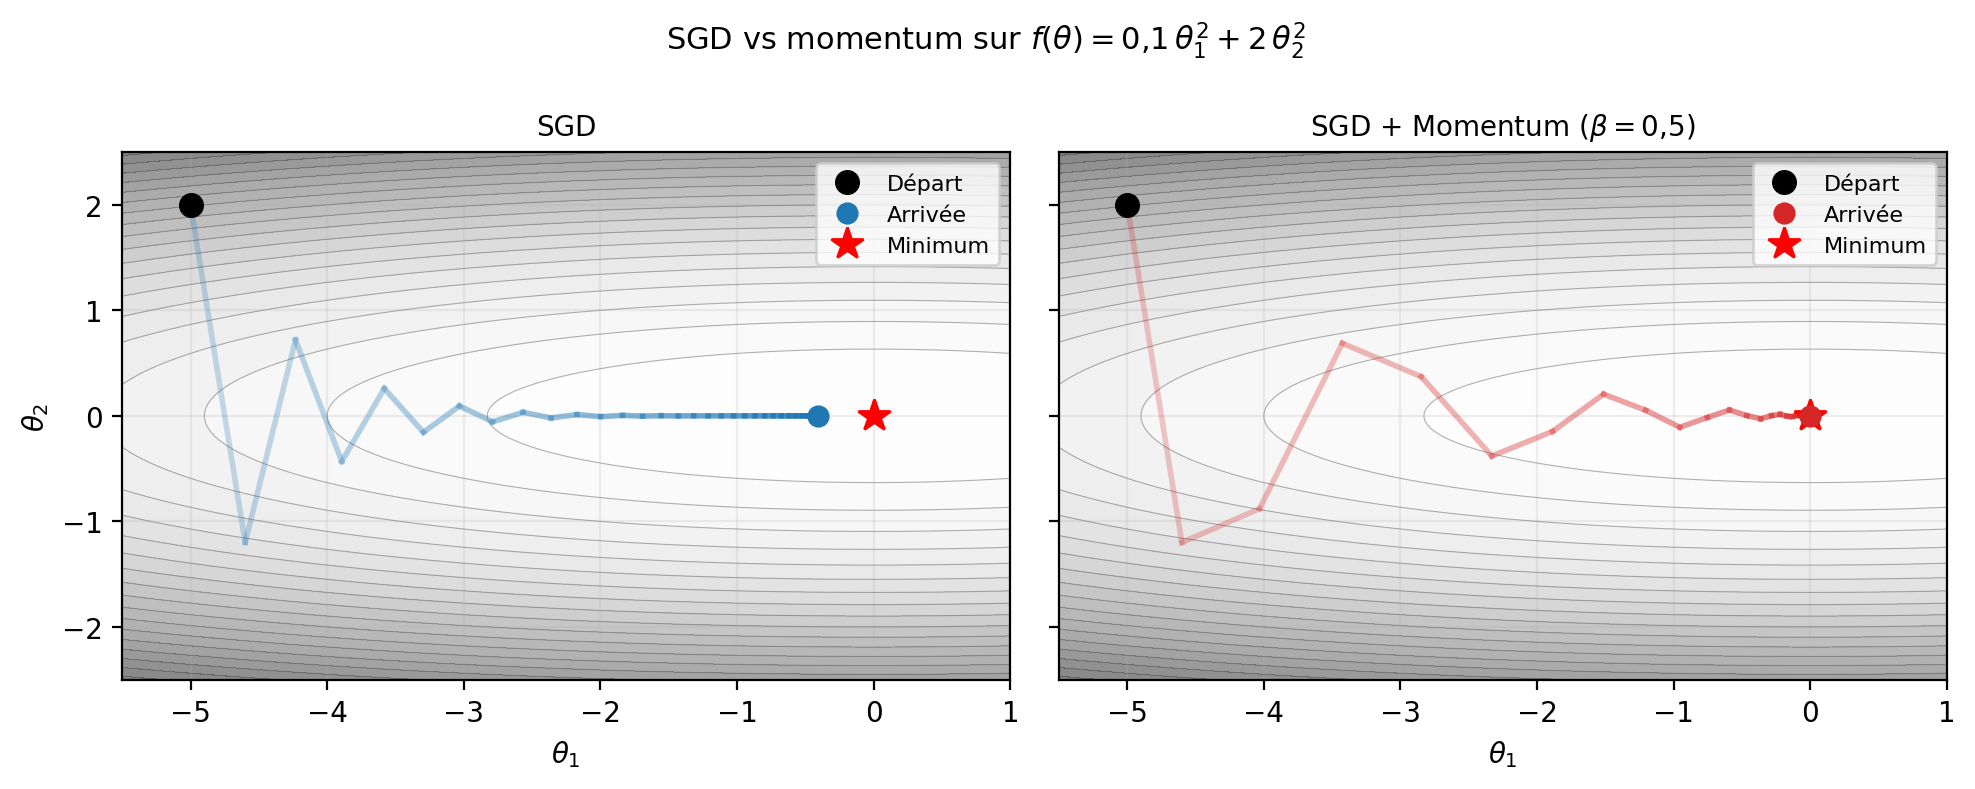
La surface de perte forme une vallée allongée: la courbure est 20 fois plus forte dans la direction que dans la direction . SGD zigzague perpendiculairement à la vallée (le gradient pointe vers les parois) et progresse lentement le long de l’axe . Avec le momentum, les oscillations en se compensent partiellement dans la moyenne mobile (les gradients alternent de signe), tandis que les gradients en s’accumulent dans une direction cohérente. Le résultat est une trajectoire plus directe vers le minimum.
Taux d’apprentissage adaptatifs: RMSProp
SGD et momentum utilisent le même taux d’apprentissage pour tous les paramètres. Cela peut être sous-optimal quand les gradients ont des magnitudes très différentes selon les dimensions: un adapté aux grandes dimensions sera trop grand pour les petites, et vice versa.
RMSProp Tieleman & Hinton (2012) maintient une estimation de la variance du gradient par dimension , et divise le gradient par la racine de cette variance:
où est la -ème composante du gradient, et évite la division par zéro. La quantité est une moyenne pondérée exponentiellement des carrés des gradients passés: elle estime . Diviser par normalise effectivement le gradient par son écart-type empirique, ce qui donne un taux d’apprentissage effectif de magnitude similaire pour toutes les dimensions.
Adam
Adam peut être vu comme une combinaison de momentum et de RMSProp. Adam (Adaptive Moment Estimation) Kingma & Ba (2015) maintient à la fois une moyenne mobile du gradient (premier moment, comme le momentum) et une moyenne mobile du carré du gradient (deuxième moment, comme RMSProp):
Au début de l’entraînement, et sont initialisés à zéro. Pendant les premières itérations, ils sous-estiment les moments réels (biais vers zéro). Adam corrige ce biais:
La mise à jour finale est:
Les valeurs par défaut sont , , , .
Adam et sa variante AdamW (voir la section sur la décroissance des poids) sont souvent les premiers choix en pratique pour entraîner des réseaux de neurones. Adam converge généralement plus vite que SGD ou momentum grâce à la normalisation adaptative, et il est moins sensible au choix du taux d’apprentissage initial.
La figure ci-dessous compare les courbes de convergence des trois algorithmes sur un MLP entraîné à classer deux spirales enchevêtrées.
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

np.random.seed(0)

# --- Génération de données: spirales ---
def make_spirals(n=200, noise=0.15):
    t = np.linspace(0, 4*np.pi, n)
    x1 = np.column_stack([t*np.cos(t), t*np.sin(t)]) / (4*np.pi) + noise*np.random.randn(n,2)
    x2 = np.column_stack([-t*np.cos(t), -t*np.sin(t)]) / (4*np.pi) + noise*np.random.randn(n,2)
    X = np.vstack([x1, x2])
    y = np.array([0]*n + [1]*n)
    return X, y

X_sp, y_sp = make_spirals(150, 0.12)
N = len(y_sp)

def relu(x):     return np.maximum(0, x)
def sigmoid(x):  return 1 / (1 + np.exp(-np.clip(x, -50, 50)))

def ce_loss(p, y):
    p = np.clip(p, 1e-7, 1-1e-7)
    return -np.mean(y*np.log(p) + (1-y)*np.log(1-p))

def mlp_train(optimizer='sgd', eta=0.01, n_epochs=200, B=32, beta1=0.9, beta2=0.999):
    H = 32
    W1 = np.random.randn(2, H) * np.sqrt(2/2)
    b1 = np.zeros(H)
    W2 = np.random.randn(H, 1) * np.sqrt(2/H)
    b2 = np.zeros(1)
    params = [W1, b1, W2, b2]

    # Optimizer state
    m = [np.zeros_like(p) for p in params]
    s = [np.zeros_like(p) for p in params]
    t_step = 0
    eps = 1e-8

    losses = []
    idx = np.arange(N)
    for epoch in range(n_epochs):
        np.random.shuffle(idx)
        epoch_loss = 0.0
        n_batches = 0
        for start in range(0, N, B):
            batch = idx[start:start+B]
            Xb = X_sp[batch];  yb = y_sp[batch].reshape(-1,1).astype(float)
            # Forward
            a1 = Xb @ W1 + b1
            z1 = relu(a1)
            a2 = z1 @ W2 + b2
            p  = sigmoid(a2)
            epoch_loss += ce_loss(p, yb)
            n_batches += 1
            # Backward
            dp  = (p - yb) / len(batch)
            dW2 = z1.T @ dp
            db2 = dp.sum(axis=0)
            dz1 = dp @ W2.T
            da1 = dz1 * (a1 > 0)
            dW1 = Xb.T @ da1
            db1 = da1.sum(axis=0)
            grads = [dW1, db1, dW2, db2]
            t_step += 1
            for i, (p_i, g) in enumerate(zip(params, grads)):
                if optimizer == 'sgd':
                    p_i -= eta * g
                elif optimizer == 'momentum':
                    m[i] = beta1 * m[i] + g
                    p_i -= eta * m[i]
                elif optimizer == 'adam':
                    m[i] = beta1*m[i] + (1-beta1)*g
                    s[i] = beta2*s[i] + (1-beta2)*g**2
                    mhat = m[i] / (1 - beta1**t_step)
                    shat = s[i] / (1 - beta2**t_step)
                    p_i -= eta * mhat / (np.sqrt(shat) + eps)
        losses.append(epoch_loss / n_batches)
    return losses

np.random.seed(0)
losses_sgd  = mlp_train('sgd',      eta=0.08,  n_epochs=200)
np.random.seed(0)
losses_mom  = mlp_train('momentum', eta=0.02,  n_epochs=200)
np.random.seed(0)
losses_adam = mlp_train('adam',     eta=0.005, n_epochs=200)

fig, ax = plt.subplots(figsize=(8, 4))
epochs = np.arange(1, 201)
ax.plot(epochs, losses_sgd,  'C0-',  lw=2, label='SGD')
ax.plot(epochs, losses_mom,  'C1--', lw=2, label='SGD + Momentum')
ax.plot(epochs, losses_adam, 'C3-',  lw=2.5, label='Adam')
ax.set_xlabel('Époque')
ax.set_ylabel('Perte (entropie croisée)')
ax.set_title('Convergence des optimiseurs sur le problème des spirales')
ax.legend(fontsize=10)
ax.grid(True, alpha=0.3)
ax.set_xlim(1, 200)
plt.tight_layout()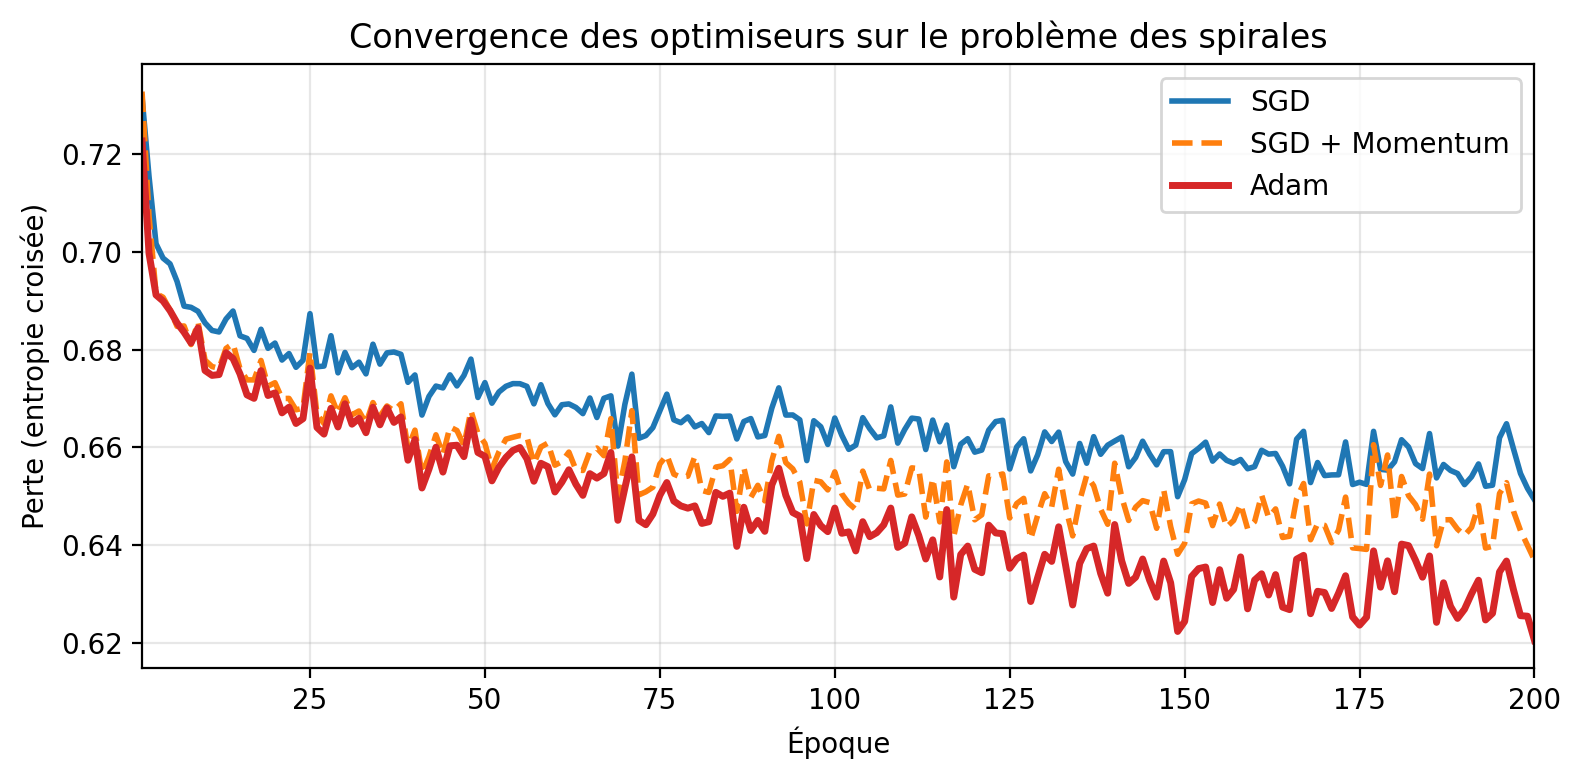
Adam converge plus rapidement et de façon plus régulière grâce à la normalisation adaptative par dimension. SGD seul oscille davantage et converge plus lentement sur ce problème. Le momentum offre un compromis intermédiaire.
Quel optimiseur choisir?
En pratique, Adam est un bon point de départ pour la plupart des architectures. SGD avec momentum peut surpasser Adam sur certains problèmes de vision (comme l’entraînement de réseaux convolutifs sur CIFAR-10 ou ImageNet) si l’on prend le temps d’ajuster le taux d’apprentissage et un calendrier de décroissance. Pour la recherche, il est courant d’essayer les deux et de comparer.
Le taux d’apprentissage est l’hyperparamètre le plus important pour tous ces algorithmes. Un trop grand provoque des oscillations ou une divergence; un trop petit converge lentement.
Calendriers de taux d’apprentissage
Un taux d’apprentissage constant n’est pas toujours optimal. En début d’entraînement, un taux élevé accélère la convergence, mais en fin d’entraînement, un taux plus faible permet de se rapprocher du minimum sans osciller. Les calendriers de taux d’apprentissage (learning rate schedules) font varier au cours de l’entraînement. Les plus courants sont:
Décroissance linéaire: , où est le nombre total d’itérations. Le taux diminue uniformément jusqu’à zéro.
Décroissance cosinus Loshchilov & Hutter (2017): . La décroissance est lente au début et à la fin, plus rapide au milieu. C’est le calendrier le plus utilisé pour l’entraînement de grands modèles.
Réchauffement (warmup) suivi d’une décroissance: le taux augmente linéairement de 0 à pendant les premières itérations, puis décroît. Le réchauffement stabilise les premières mises à jour, quand les moments d’Adam ne sont pas encore fiables.
Pourquoi les méthodes du premier ordre dominent
Les algorithmes présentés ci-dessus (SGD, momentum, Adam) n’utilisent que le gradient, c’est-à-dire l’information du premier ordre sur la surface de perte. En optimisation classique, les méthodes du second ordre, qui exploitent aussi la courbure, convergent beaucoup plus vite. Pourtant, elles sont rarement utilisées pour entraîner des réseaux de neurones. Cette section explique pourquoi. Si les notions de hessien ou de courbure ne vous sont pas familières, concentrez-vous sur la conclusion: les méthodes du premier ordre suffisent en pratique, et nous y reviendrons dans les exercices avec des exemples concrets.
Méthodes du second ordre: Newton et L-BFGS
La méthode de Newton remplace la mise à jour de gradient par:
où est la matrice hessienne, la matrice des dérivées secondes de la perte. En multipliant le gradient par l’inverse du hessien, la méthode de Newton adapte le pas dans chaque direction selon la courbure locale. Sur une fonction quadratique, elle converge en une seule itération.
En pratique, on n’inverse pas le hessien directement. L’algorithme L-BFGS (Limited-memory BFGS) en construit une approximation à partir des dernières paires gradient-paramètre (typiquement à 30). Cette méthode fonctionne bien pour des problèmes de taille modérée, comme l’entraînement de modèles log-linéaires ou de petits réseaux.
Le coût prohibitif de la courbure
Pour un réseau de paramètres, le hessien est une matrice . Le stocker requiert en mémoire, et l’inverser coûte opérations.
Pour un réseau modeste de paramètres (un petit réseau convolutif), le hessien contiendrait 1012 entrées, soit environ 4 téraoctets en précision simple. Pour les modèles modernes avec à 1011 paramètres, c’est hors de question.
L-BFGS réduit le coût mémoire à , ce qui le rend utilisable pour des problèmes de taille intermédiaire. Mais il requiert des gradients sur l’ensemble du jeu de données (pas des mini-lots), ce qui le rend incompatible avec l’entraînement stochastique standard des réseaux profonds. Des variantes stochastiques existent, mais elles n’ont pas démontré d’avantage systématique sur Adam en pratique.
Le bruit stochastique comme régularisateur implicite
Le coût computationnel n’est pas la seule raison de la domination du premier ordre. Le bruit introduit par l’échantillonnage des mini-lots joue un rôle positif pour la généralisation.
La variance du gradient estimé par un mini-lot de taille est:
où est la variance du gradient sur les exemples individuels. L’écart-type du bruit dans la mise à jour est donc proportionnel à : un taux d’apprentissage élevé ou un petit lot augmentent le bruit.
Ce bruit agit comme un régularisateur implicite: il empêche l’optimiseur de se stabiliser dans des minima étroits de la surface de perte. Des expériences Keskar et al. (2017) montrent qu’en augmentant la taille des lots (réduisant le bruit), la perte d’entraînement diminue plus vite, mais la performance en généralisation se dégrade. Ce phénomène suggère que le bruit de SGD est bénéfique, pas seulement toléré.
Minima plats et généralisation
Pour comprendre ce phénomène, considérons deux types de minima sur la surface de perte: un minimum plat, entouré d’une large région de perte faible, et un minimum étroit, où la perte augmente rapidement dès qu’on s’écarte de la solution.
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

theta = np.linspace(-4, 4, 500)

# Surface de perte avec un minimum plat et un minimum étroit
loss = 0.3 * np.exp(-0.5 * ((theta + 1.8) / 0.25)**2) + \
       0.15 * np.exp(-0.5 * ((theta - 0.5) / 1.2)**2) + \
       0.5 * (1 + np.tanh((theta - 3) / 0.5)) + \
       0.05 * theta**2 + 0.3
loss = loss - loss.min() + 0.05

fig, ax = plt.subplots(figsize=(8, 3.5))
ax.plot(theta, loss, 'k-', lw=2)

# Minimum étroit
ax.annotate('Minimum étroit', xy=(-1.8, loss[np.argmin(np.abs(theta + 1.8))]),
            xytext=(-3.5, 0.6), fontsize=9,
            arrowprops=dict(arrowstyle='->', color='C3', lw=1.5), color='C3')

# Minimum plat
idx_flat = np.argmin(np.abs(theta - 0.5))
ax.annotate('Minimum plat', xy=(0.5, loss[idx_flat]),
            xytext=(2.0, 0.6), fontsize=9,
            arrowprops=dict(arrowstyle='->', color='C0', lw=1.5), color='C0')

# Zones
ax.axhspan(loss[idx_flat] - 0.01, loss[idx_flat] + 0.08, xmin=0.3, xmax=0.65,
           alpha=0.15, color='C0')
ax.axhspan(loss[np.argmin(np.abs(theta + 1.8))] - 0.01,
           loss[np.argmin(np.abs(theta + 1.8))] + 0.08,
           xmin=0.1, xmax=0.17, alpha=0.15, color='C3')

ax.set_xlabel(r'$\theta$ (direction dans l\'espace des paramètres)')
ax.set_ylabel(r'$\mathcal{L}(\theta)$')
ax.set_title('Minima plats et minima étroits sur la surface de perte')
ax.grid(True, alpha=0.3)
ax.set_xlim(-4, 4)
plt.tight_layout()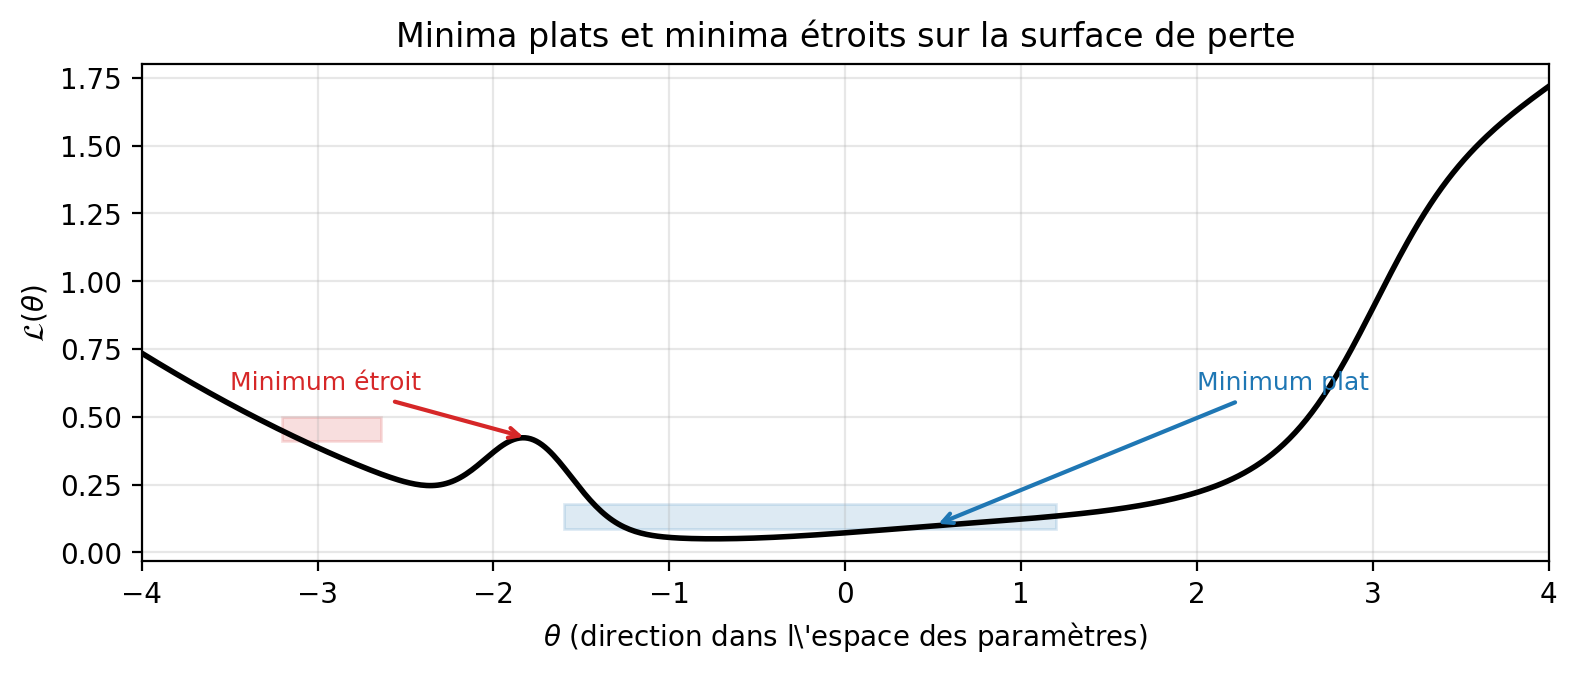
L’intuition est qu’un minimum plat est plus robuste aux perturbations. Quand on passe de la distribution d’entraînement à la distribution de test, les paramètres ne changent pas, mais la surface de perte se déforme légèrement. Un minimum plat reste un bon point même après cette déformation; un minimum étroit peut devenir un mauvais point si la surface se décale.
Une interprétation influente Keskar et al. (2017) est que le bruit de SGD favorise les minima plats: dans un minimum étroit, les fluctuations stochastiques pousseraient l’optimiseur hors du bassin d’attraction, tandis qu’un minimum plat serait assez large pour absorber ces fluctuations. Cette hypothèse reste un sujet de recherche actif; la notion même de “platitude” d’un minimum dépend de la paramétrisation et n’est pas toujours un prédicteur fiable de la généralisation. Elle fournit néanmoins une intuition utile pour comprendre pourquoi les petits lots généralisent souvent mieux que les grands.
En résumé, les méthodes du premier ordre dominent la pratique courante de l’apprentissage profond pour deux raisons complémentaires: leur coût par itération est compatible avec les modèles de grande taille, et le bruit intrinsèque de l’estimation par mini-lots semble jouer un rôle bénéfique pour la généralisation. Des méthodes exploitant la courbure existent et font l’objet de recherches actives, mais elles ne se sont pas imposées comme alternatives standard.
Saturation et stabilité du gradient
Les algorithmes d’optimisation de la section précédente supposent que le gradient parvient de façon fiable à toutes les couches du réseau. En pratique, ce n’est pas garanti: dans les réseaux profonds, le signal de gradient peut se dissoudre ou exploser en traversant les couches. Cette section décrit le problème et les techniques qui le résolvent.
Cette section suppose que vous avez compris le mécanisme général de la différentiation automatique en mode arrière (le gradient se propage de la sortie vers l’entrée), mais pas nécessairement les détails des jacobiennes. La partie mathématique (produits de jacobiennes, rayon spectral) est plus technique; l’essentiel à retenir est le phénomène qualitatif et les solutions pratiques.
Instabilité du gradient en profondeur
Dans un réseau profond, le gradient de la perte par rapport aux premières couches est un produit de jacobiennes locales:
Le gradient à la couche 1 est donc le gradient à la sortie, multiplié successivement par matrices jacobiennes en traversant le réseau de la sortie vers l’entrée. Chaque facteur mesure comment une perturbation infinitésimale à la couche se répercute sur la couche .
Pour saisir l’enjeu de ce produit, considérons d’abord le cas scalaire: un réseau où chaque couche a un seul neurone. Le gradient devient alors un produit de nombres réels. Si chaque facteur vaut , le produit après 50 couches est : le signal a presque disparu. Si chaque facteur vaut , le produit est : il a explosé. Seul le cas maintient un signal stable. Quand chaque facteur est une matrice plutôt qu’un scalaire, la quantité qui joue le rôle de est le rayon spectral.
Structure de la jacobienne locale
En reprenant la notation du chapitre 7, la couche calcule avec . Par la règle de chaîne:
Cette jacobienne est le produit de deux facteurs. La matrice diagonale contient les dérivées de la fonction d’activation évaluées aux pré-activations courantes: chaque entrée diagonale agit comme un portillon qui laisse passer ou atténue le gradient pour le neurone correspondant. La matrice est la matrice de poids de la couche, qui mélange les composantes du gradient entre neurones.
Rayon spectral et instabilité exponentielle
Le rayon spectral d’une matrice est la plus grande valeur absolue de ses valeurs propres: . Pour un produit de matrices, le rayon spectral gouverne le taux de croissance ou de décroissance de la norme du produit. Si les jacobiennes étaient toutes identiques avec un rayon spectral , la norme du produit croîtrait comme . En pratique, les jacobiennes varient d’une couche à l’autre et dépendent de l’entrée, mais le comportement qualitatif est le même:
si pour la plupart des couches, le produit décroît exponentiellement avec la profondeur;
si , le produit croît exponentiellement;
seul le régime maintient un gradient stable à travers la profondeur.
Quand le gradient décroît exponentiellement, on parle de dissolution du gradient (vanishing gradient). Les premières couches reçoivent des mises à jour négligeables par rapport aux dernières: elles restent proches de leur initialisation pendant que les couches de sortie s’adaptent. Le réseau ne peut alors pas apprendre de représentations utiles dans ses premières couches, ce qui limite sa capacité.
Quand le gradient croît exponentiellement, on parle d’explosion du gradient (exploding gradient). Les mises à jour de paramètres deviennent si grandes que la perte oscille violemment ou diverge. Dans les cas extrêmes, les valeurs numériques débordent.
Le rayon spectral de dépend de deux facteurs: la fonction d’activation, qui détermine les entrées diagonales, et la matrice de poids . La sous-section suivante examine comment le choix de l’activation affecte le premier facteur; la sous-section sur l’initialisation traite le second.
Saturation des fonctions d’activation
La saturation est le mécanisme principal de la dissolution du gradient. Pour comprendre pourquoi, examinons les dérivées des fonctions d’activation vues au chapitre 7.
Sigmoïde. La dérivée de la sigmoïde est . Puisque , le produit est borné par 0,25 (atteint en , où ). Pour les grandes valeurs de , est proche de 0 ou 1, et la dérivée est proche de zéro: la fonction est saturée et le gradient s’annule.
Tanh. La dérivée est , bornée par 1 (en ). Tanh sature moins vite que la sigmoïde ( contre ), mais le problème persiste pour les grandes valeurs de .
Dans un réseau de couches avec activation sigmoïde, la jacobienne locale de chaque couche est . La norme de chaque facteur est bornée par . Même avec des poids bien calibrés, le facteur plafonne à 0,25. Entre la sortie et la première couche, il y a jacobiennes, donc la norme du gradient est au plus fois sa valeur initiale. Pour , cela donne : le gradient est pratiquement nul.
ReLU. La dérivée de ReLU est:
Pour les entrées positives, : le gradient passe sans aucune atténuation. Il n’y a pas de saturation. La jacobienne de la couche pour les neurones actifs est lui-même, sans facteur réducteur. Avec une initialisation appropriée (section suivante), la norme du gradient reste stable en traversant les couches.
ReLU n’est pas différentiable en . En pratique, cela ne pose pas de problème. La probabilité qu’une pré-activation soit exactement zéro est nulle (les poids et les entrées sont des nombres à virgule flottante). Les bibliothèques de différentiation automatique adoptent la convention (ou parfois 1): ce choix n’affecte pas l’entraînement, car il ne concerne qu’un ensemble de mesure nulle dans l’espace des entrées. Plus généralement, pour que la rétropropagation fonctionne, il suffit que la fonction d’activation soit différentiable presque partout, c’est-à-dire partout sauf en un nombre fini de points. ReLU, Leaky ReLU et les fonctions linéaires par morceaux satisfont cette condition.
Le coût de cette propriété est le problème des neurones morts: un neurone dont la pré-activation est toujours négative a un gradient nul () et cesse d’apprendre. Une fois mort, le neurone ne peut pas être réactivé par le gradient seul.
Leaky ReLU et GELU. Pour atténuer le problème des neurones morts, Leaky ReLU maintient un petit gradient pour les entrées négatives: pour (typiquement ). Le neurone ne meurt jamais complètement. GELU, utilisé dans les transformeurs modernes (chapitre 10), est une variante lisse de ReLU dont la dérivée est continue et non nulle partout, ce qui améliore la stabilité de l’optimisation.
La figure ci-dessous simule la norme du gradient en fonction de la profondeur pour des réseaux sigmoïdes et ReLU. La décroissance exponentielle avec la sigmoïde illustre pourquoi les réseaux profonds étaient difficiles à entraîner avant l’adoption de ReLU.
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

np.random.seed(42)
n_layers = 20
n_trials = 50
d = 50  # dimension des couches

def simulate_gradient_norm(activation_deriv, n_layers, n_trials, d):
    """Simule la norme d'un signal rétropropagé à travers n_layers couches."""
    norms = []
    for _ in range(n_trials):
        g = np.ones(d) / np.sqrt(d)  # gradient normalisé en sortie
        for _ in range(n_layers):
            W = np.random.randn(d, d) / np.sqrt(d)
            # Pré-activations aléatoires pour simuler un réseau typique
            a = np.random.randn(d)
            dphi = activation_deriv(a)
            # Jacobienne locale: diag(phi'(a)) @ W
            g = (dphi * g) @ W  # VJP simplifié
        norms.append(np.linalg.norm(g))
    return norms

d_sigmoid = lambda a: np.exp(-a) / (1 + np.exp(-a))**2
d_relu    = lambda a: (a > 0).astype(float)

layers = np.arange(1, n_layers + 1)
norms_sigmoid = np.array([
    np.mean(simulate_gradient_norm(d_sigmoid, l, n_trials, d))
    for l in layers
])
norms_relu = np.array([
    np.mean(simulate_gradient_norm(d_relu, l, n_trials, d))
    for l in layers
])

fig, ax = plt.subplots(figsize=(8, 4))
ax.semilogy(layers, norms_sigmoid, 'C0-o', markersize=4, linewidth=2, label='Sigmoïde')
ax.semilogy(layers, norms_relu,    'C2-s', markersize=4, linewidth=2, label='ReLU')
ax.axhspan(0, 1e-8, alpha=0.1, color='C0', label='Zone de disparition')
ax.set_xlabel('Profondeur (nombre de couches)')
ax.set_ylabel('Norme du signal rétropropagé')
ax.set_title('Atténuation du signal de gradient avec la profondeur')
ax.legend(fontsize=10)
ax.grid(True, alpha=0.3, which='both')
ax.set_xlim(1, n_layers)
plt.tight_layout()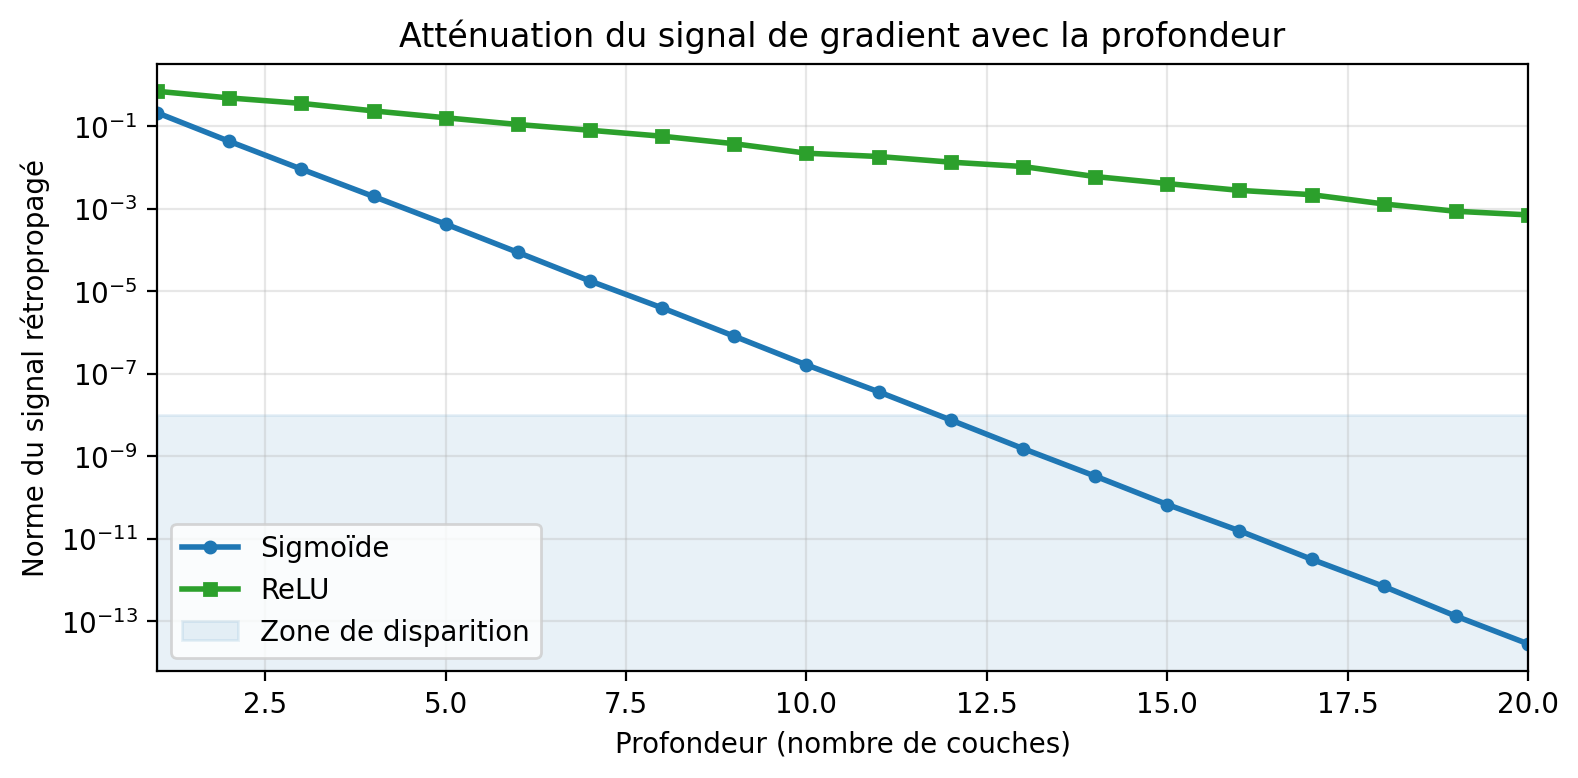
Avec la sigmoïde, la norme du gradient décroît de façon quasi exponentielle: à 20 couches de profondeur, le signal est réduit de plusieurs ordres de grandeur. ReLU maintient un gradient plus stable grâce à sa dérivée égale à 1 pour les activations positives.
Initialisation des poids
Une bonne initialisation vise à maintenir la variance des activations et des gradients stable à travers les couches. Deux stratégies courantes:
L’initialisation de Glorot Glorot & Bengio (2010) (aussi appelée Xavier) tire les poids d’une distribution telle que:
où et sont les dimensions d’entrée et de sortie de la couche. Cette stratégie est adaptée aux activations sigmoïde et tanh.
L’initialisation de He He et al. (2015), conçue pour ReLU, utilise une variance plus grande:
Le facteur 2 compense le fait que ReLU annule environ la moitié des activations.
La figure ci-dessous montre les distributions des activations à différentes profondeurs pour trois stratégies d’initialisation: variance trop petite (saturation), variance trop grande (explosion), et initialisation de Glorot (stable).
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

np.random.seed(1)
d = 100
n_samples = 500
n_layers = 5
check_layers = [1, 2, 3, 4, 5]

def propagate(x, n_layers, var, activation=np.tanh):
    activations = []
    h = x.copy()
    for _ in range(n_layers):
        W = np.random.randn(d, d) * np.sqrt(var)
        h = activation(h @ W)
        activations.append(h.ravel())
    return activations

x0 = np.random.randn(n_samples, d)

configs = [
    ('Trop petite\n($\\sigma^2 = 0{,}01$)', 0.01,  'C3'),
    ('Glorot\n($\\sigma^2 = 2/(n+m)$)', 2/d,    'C2'),
    ('Trop grande\n($\\sigma^2 = 4$)',    4.0,    'C0'),
]

fig, axes = plt.subplots(3, 5, figsize=(12, 6), sharey='row')

for row, (label, var, color) in enumerate(configs):
    acts = propagate(x0, n_layers, var)
    for col, (ax, h) in enumerate(zip(axes[row], acts)):
        ax.hist(h, bins=40, color=color, alpha=0.75, density=True, edgecolor='none')
        ax.set_xlim(-1.1, 1.1)
        ax.tick_params(labelsize=7)
        if col == 0:
            ax.set_ylabel(label, fontsize=8)
        if row == 0:
            ax.set_title(f'Couche {col+1}', fontsize=9)
        ax.grid(True, alpha=0.3, axis='y')

plt.suptitle("Distribution des activations (tanh) selon l'initialisation", fontsize=11)
plt.tight_layout()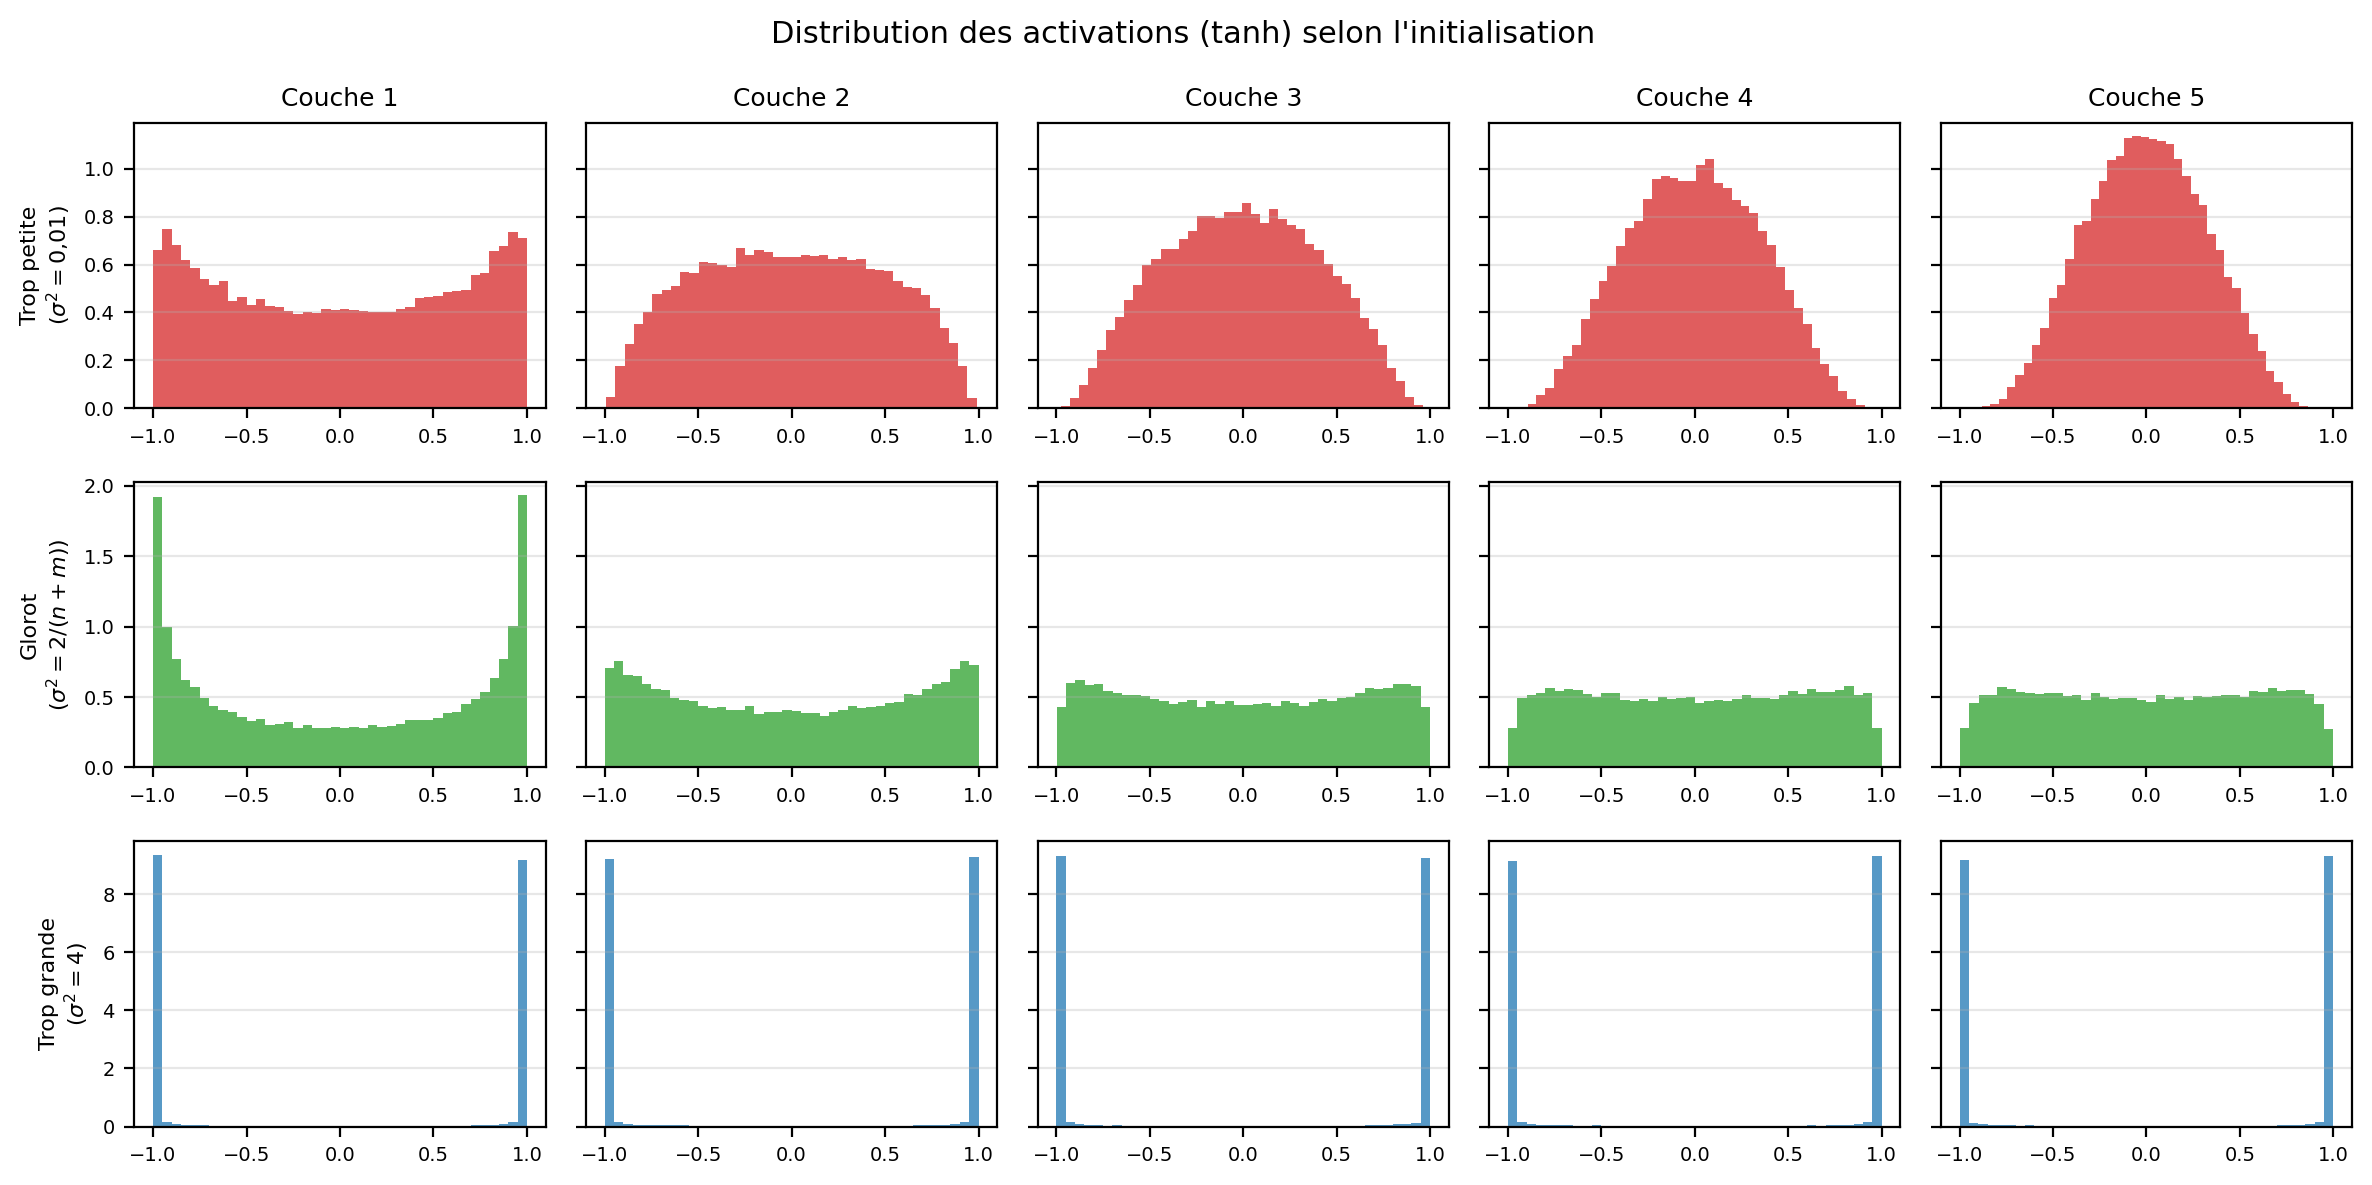
Avec une variance trop petite, les pré-activations se contractent vers zéro à chaque couche. Dans cette zone, tanh est quasi linéaire ( pour petit), ce qui signifie que les couches successives n’ajoutent presque pas de non-linéarité: le réseau profond se comporte comme un modèle linéaire peu expressif. Avec une variance trop grande, les pré-activations sont grandes et les activations saturent à , où la dérivée de tanh est proche de zéro: c’est le régime de dissolution du gradient. L’initialisation de Glorot maintient les pré-activations dans une plage intermédiaire, ce qui préserve à la fois l’expressivité et le signal des gradients à travers la profondeur.
Normalisation par lots
La normalisation par lots (batch normalization) Ioffe & Szegedy (2015) normalise les pré-activations à chaque couche pour qu’elles aient une moyenne nulle et une variance unitaire sur le mini-lot courant:
où et sont la moyenne et la variance empiriques de la pré-activation sur le mini-lot, et est une petite constante de stabilité. Des paramètres appris et permettent ensuite de recalibrer: .
Cette technique stabilise l’entraînement en réduisant la dépendance des gradients à l’échelle des activations. Elle permet d’utiliser des taux d’apprentissage plus élevés et agit comme un régularisateur implicite. À l’inférence, on n’utilise pas les statistiques du mini-lot courant (qui peut être de taille 1): on les remplace par des moyennes glissantes de et accumulées pendant l’entraînement.
La normalisation par lots dépend des statistiques du mini-lot, ce qui pose des problèmes quand les lots sont petits ou quand le modèle traite des séquences de longueurs variables. La normalisation de couche (layer normalization) Ba et al. (2016) calcule plutôt la moyenne et la variance sur les dimensions d’un seul exemple (sur les neurones d’une couche plutôt que sur les exemples d’un lot). Elle ne dépend pas de la taille du mini-lot et est le choix standard pour les transformeurs (chapitre 10).
Connexions résiduelles
Les connexions résiduelles (residual connections ou skip connections) He et al. (2016) ajoutent l’entrée d’un bloc à sa sortie:
Au lieu d’apprendre la transformation complète, le bloc n’apprend que le résidu, c’est-à-dire la différence entre la sortie désirée et l’entrée. Le gradient se propage directement à travers la connexion identité, ce qui atténue la dissolution du gradient:
La présence du terme identité crée un chemin direct pour le gradient: même si est petit, le signal de gradient dispose d’un raccourci qui ne passe pas par la transformation . En pratique, cette propriété atténue fortement la dissolution du gradient et a permis d’entraîner des réseaux de plus de 100 couches.
Comparé à une couche standard, le bloc résiduel ajoute simplement une connexion directe (skip connection) dans le graphe de calcul:
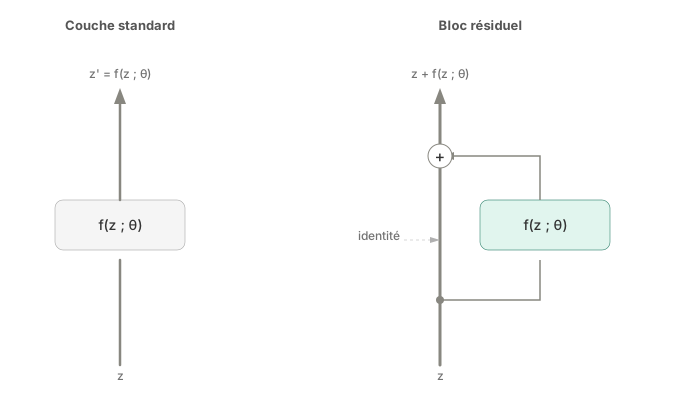
Figure 1:Couche standard (gauche) et bloc résiduel (droite). La connexion identité crée un chemin direct pour le signal: le bloc n’apprend que le résidu à ajouter.
La connexion identité crée un chemin direct pour le gradient: lors de la passe arrière, le gradient peut contourner le bloc et se propager directement vers les couches précédentes, sans multiplication par les jacobiennes potentiellement petites de .
Écrêtage du gradient
L’écrêtage du gradient (gradient clipping) est une technique pragmatique pour empêcher l’explosion du gradient. Avant chaque mise à jour, on limite la norme du gradient:
Si , le gradient est réduit pour avoir une norme . Cette opération préserve la direction du gradient tout en bornant son amplitude.
Régularisation
Les sections précédentes ont couvert les algorithmes d’optimisation et les techniques pour stabiliser le gradient. Un réseau correctement entraîné peut atteindre une perte d’entraînement très faible, mais cela ne garantit pas qu’il généralisera bien à de nouvelles données. Comme nous l’avons vu au chapitre 4, un modèle trop expressif risque le surapprentissage. Cette section présente les techniques de régularisation spécifiques aux réseaux de neurones.
Arrêt précoce
La technique de régularisation la plus simple est l’arrêt précoce (early stopping): on surveille la perte sur un ensemble de validation pendant l’entraînement, et on arrête dès qu’elle cesse de diminuer.
En pratique, la perte de validation fluctue d’une époque à l’autre. On utilise donc un critère de patience: l’entraînement s’arrête si la perte de validation n’a pas diminué depuis époques consécutives (typiquement à 20). On conserve les paramètres correspondant à la meilleure perte de validation observée.
L’arrêt précoce limite implicitement la complexité du modèle: un réseau entraîné pendant peu d’époques reste proche de son initialisation et n’a pas eu le temps de mémoriser les données. On peut montrer que, sous certaines conditions, l’arrêt précoce avec SGD a un effet similaire à la régularisation L2, le nombre d’époques jouant un rôle inversement proportionnel au coefficient de régularisation .
L’arrêt précoce est presque toujours utilisé en pratique, souvent en combinaison avec les autres techniques décrites ci-dessous.
Décroissance des poids et régularisation L2
Ces deux termes sont souvent utilisés de façon interchangeable, mais ils désignent des opérations distinctes qui ne coïncident que dans un cas particulier.
Régularisation L2. Comme nous l’avons vu au chapitre 3, la régularisation L2 modifie la fonction de perte en ajoutant une pénalité sur la norme des paramètres:
L’optimiseur minimise ensuite cette perte modifiée. Le gradient devient : le terme est traité comme une composante du gradient et passe par toute la machinerie de l’optimiseur (moments, normalisation adaptative, etc.).
Décroissance des poids. La décroissance des poids (weight decay) modifie la règle de mise à jour: à chaque pas, les paramètres sont contractés par un facteur , indépendamment du gradient:
où est la direction de descente calculée par l’optimiseur à partir du gradient de seule (sans pénalité).
Équivalence pour SGD. Avec SGD, . La mise à jour avec décroissance des poids est:
C’est exactement la mise à jour obtenue en minimisant par SGD. Les deux opérations sont donc équivalentes pour SGD. Du point de vue bayésien, cela correspond à un prior gaussien sur les paramètres (chapitre 3).
Deux opérations distinctes avec Adam. Avec un optimiseur adaptatif comme Adam, les deux opérations produisent des comportements différents, et il n’y a pas de raison de préférer l’une parce qu’elle “devrait” correspondre à l’autre: ce sont deux formes de régularisation à part entière.
Avec la régularisation L2, le terme est ajouté au gradient avant le calcul des moments et la normalisation adaptative. Il est donc traité comme n’importe quelle autre composante du gradient: divisé par , accumulé dans les moments, etc. La régularisation effective sur chaque paramètre dépend de l’historique de ses gradients.
Avec la décroissance des poids, la contraction s’applique directement sur les paramètres, sans passer par les moments:
Chaque paramètre est contracté par le même facteur, indépendamment de l’historique de ses gradients. C’est une opération plus simple et plus directe.
Loshchilov et Hutter Loshchilov & Hutter (2019) ont observé que la décroissance des poids (et non la régularisation L2) donne de meilleurs résultats avec Adam, et ont proposé AdamW, qui sépare explicitement les deux: Adam gère l’optimisation, la contraction gère la régularisation. AdamW est devenu le choix standard pour l’entraînement de grands modèles.
En pratique, la décroissance des poids ne s’applique généralement pas aux biais. La valeur à 10-2 est courante.
Dropout
La décroissance des poids pénalise les paramètres individuellement. Le dropout Srivastava et al. (2014) agit différemment: il désactive aléatoirement des neurones à chaque passe avant pendant l’entraînement. Formellement, pour chaque couche cachée , on applique un masque de Bernoulli:
où est le taux de dropout (probabilité qu’un neurone soit désactivé), est le masque aléatoire (chaque composante vaut 1 avec probabilité et 0 sinon), et le facteur est une renormalisation inversée (inverted dropout): il compense l’absence de neurones pendant l’entraînement, de sorte que l’espérance des activations reste inchangée:
À l’inférence, on désactive le dropout et on utilise le réseau complet sans renormalisation.
Source
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
%config InlineBackend.figure_format = 'retina'

np.random.seed(3)

fig, axes = plt.subplots(1, 2, figsize=(10, 4.5))
titles = ['Réseau complet (inférence)', 'Dropout $p=0{,}5$ (entraînement)']

layer_sizes = [3, 5, 5, 2]
p_drop = 0.5
np.random.seed(3)
dropped = [np.random.rand(n) < p_drop for n in layer_sizes]
dropped[0]  = [False]*layer_sizes[0]  # inputs never dropped
dropped[-1] = [False]*layer_sizes[-1] # outputs never dropped

for ax_idx, ax in enumerate(axes):
    ax.set_xlim(-0.5, len(layer_sizes)-0.5)
    ax.set_ylim(-0.5, max(layer_sizes)-0.5)
    ax.axis('off')
    ax.set_title(titles[ax_idx], fontsize=10)

    positions = []
    for l, n in enumerate(layer_sizes):
        offset = (max(layer_sizes) - n) / 2
        pos = [(l, offset + i) for i in range(n)]
        positions.append(pos)

    # Draw edges
    for l in range(len(layer_sizes)-1):
        for i, (x1, y1) in enumerate(positions[l]):
            for j, (x2, y2) in enumerate(positions[l+1]):
                if ax_idx == 1 and (dropped[l][i] or dropped[l+1][j]):
                    lw, alpha, col = 0.5, 0.12, 'gray'
                else:
                    lw, alpha, col = 1.2, 0.4, '#555555'
                ax.plot([x1, x2], [y1, y2], '-', color=col, lw=lw, alpha=alpha, zorder=1)

    # Draw nodes
    for l, pos in enumerate(positions):
        for i, (x, y) in enumerate(pos):
            is_dropped = ax_idx == 1 and dropped[l][i]
            fc = '#dddddd' if is_dropped else ('#dae8fc' if l == 0 else ('#d5e8d4' if l == len(layer_sizes)-1 else '#fff2cc'))
            ec = '#aaaaaa' if is_dropped else '#333333'
            circ = plt.Circle((x, y), 0.28, fc=fc, ec=ec, lw=1.5, zorder=3)
            ax.add_patch(circ)
            if is_dropped:
                ax.text(x, y, r'$\times$', ha='center', va='center', fontsize=11, color='#cc0000', zorder=4)

    # Layer labels
    for l, label in enumerate(['Entrée', 'Cachée 1', 'Cachée 2', 'Sortie']):
        ax.text(l, -0.3, label, ha='center', va='top', fontsize=8, color='#555')

legend_elems = [
    mpatches.Patch(fc='#dae8fc', ec='#333', label='Neurone actif (entrée)'),
    mpatches.Patch(fc='#fff2cc', ec='#333', label='Neurone actif (caché)'),
    mpatches.Patch(fc='#dddddd', ec='#aaa', label='Neurone désactivé'),
]
axes[1].legend(handles=legend_elems, fontsize=7.5, loc='upper right')

plt.suptitle('Dropout: désactivation aléatoire de neurones pendant l\'entraînement', fontsize=11)
plt.tight_layout()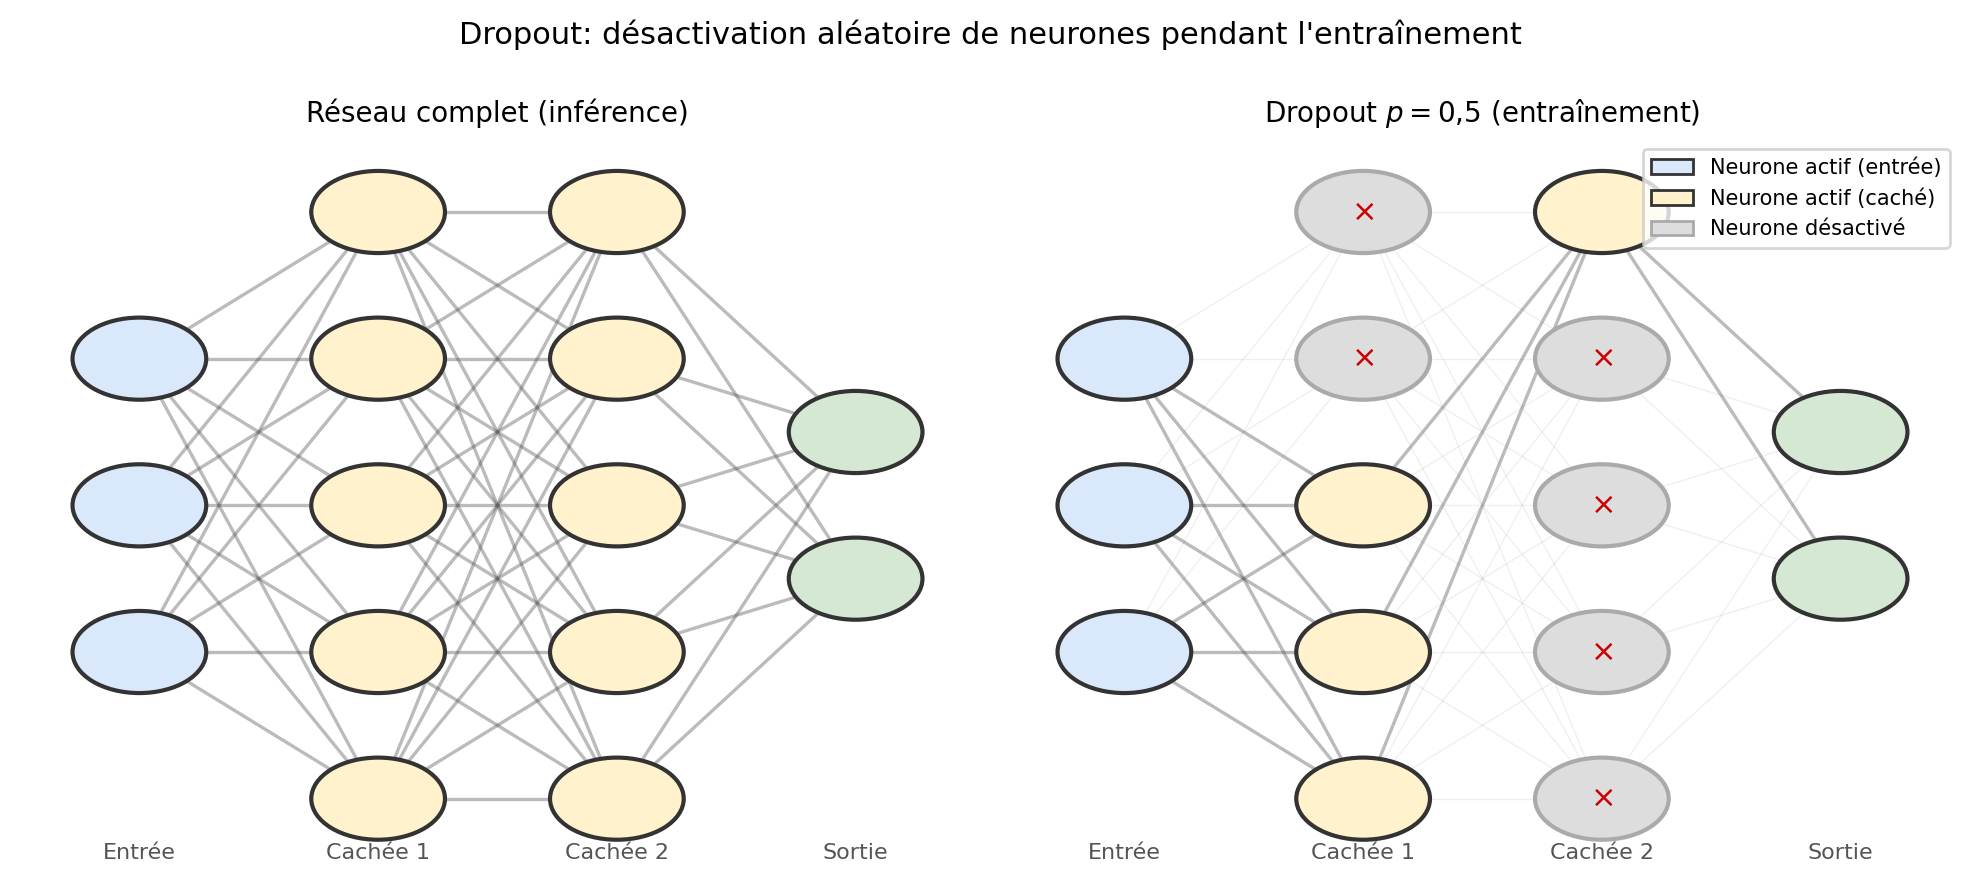
La justification intuitive du dropout est double. D’abord, il empêche la co-adaptation des neurones: chaque neurone ne peut pas compter sur les autres pour corriger ses erreurs, ce qui l’oblige à apprendre des caractéristiques utiles de façon indépendante. Ensuite, l’entraînement avec dropout revient à entraîner simultanément un ensemble de sous-réseaux différents qui partagent leurs paramètres, et l’inférence avec le réseau complet est une approximation de la moyenne de cet ensemble.
Des taux de dropout courants sont à pour les couches convolutives et pour les couches entièrement connectées.
La figure ci-dessous illustre l’effet de la régularisation sur un petit réseau sujet au surapprentissage.
Source
import numpy as np
import matplotlib.pyplot as plt
%config InlineBackend.figure_format = 'retina'

np.random.seed(1)

def make_moons(n=200, noise=0.2):
    t = np.linspace(0, np.pi, n//2)
    x1 = np.column_stack([np.cos(t), np.sin(t)]) + noise*np.random.randn(n//2, 2)
    x2 = np.column_stack([1-np.cos(t), -np.sin(t)+0.5]) + noise*np.random.randn(n//2, 2)
    X = np.vstack([x1, x2])
    y = np.array([0]*(n//2) + [1]*(n//2))
    return X, y

X_all, y_all = make_moons(200, 0.2)
np.random.seed(42)
idx = np.random.permutation(len(y_all))
X_tr, y_tr = X_all[idx[:40]], y_all[idx[:40]]
X_val, y_val = X_all[idx[40:]], y_all[idx[40:]]

def relu(x):    return np.maximum(0, x)
def sigmoid(x): return 1/(1+np.exp(-np.clip(x,-50,50)))
def ce(p, y):
    p = np.clip(p, 1e-7, 1-1e-7)
    return -np.mean(y*np.log(p)+(1-y)*np.log(1-p))

def train_mlp_2layer(X_tr, y_tr, X_val, y_val, H=64, n_epochs=600,
                     eta=0.05, lam=0.0, p_drop=0.0):
    np.random.seed(0)
    W1 = np.random.randn(2, H)*np.sqrt(2/2)
    b1 = np.zeros(H)
    W2 = np.random.randn(H, H)*np.sqrt(2/H)
    b2 = np.zeros(H)
    W3 = np.random.randn(H, 1)*np.sqrt(2/H)
    b3 = np.zeros(1)
    N = len(y_tr)
    tr_losses, val_losses = [], []
    for _ in range(n_epochs):
        a1 = X_tr @ W1 + b1; z1 = relu(a1)
        if p_drop > 0:
            m1 = (np.random.rand(*z1.shape) > p_drop).astype(float) / (1-p_drop)
            z1d = z1 * m1
        else:
            z1d = z1; m1 = None
        a2 = z1d @ W2 + b2; z2 = relu(a2)
        if p_drop > 0:
            m2 = (np.random.rand(*z2.shape) > p_drop).astype(float) / (1-p_drop)
            z2d = z2 * m2
        else:
            z2d = z2; m2 = None
        a3 = z2d @ W3 + b3; p = sigmoid(a3)
        yb = y_tr.reshape(-1,1).astype(float)
        dp = (p - yb) / N
        dW3 = z2d.T @ dp + lam*W3/N; db3 = dp.sum(0)
        dz2 = dp @ W3.T
        if m2 is not None: dz2 = dz2 * m2
        da2 = dz2 * (a2 > 0)
        dW2 = z1d.T @ da2 + lam*W2/N; db2 = da2.sum(0)
        dz1 = da2 @ W2.T
        if m1 is not None: dz1 = dz1 * m1
        da1 = dz1 * (a1 > 0)
        dW1 = X_tr.T @ da1 + lam*W1/N; db1 = da1.sum(0)
        W1 -= eta*dW1; b1 -= eta*db1
        W2 -= eta*dW2; b2 -= eta*db2
        W3 -= eta*dW3; b3 -= eta*db3
        def fwd(X): return sigmoid(relu(relu(X@W1+b1)@W2+b2)@W3+b3)
        tr_losses.append(ce(fwd(X_tr), y_tr.reshape(-1,1)))
        val_losses.append(ce(fwd(X_val), y_val.reshape(-1,1)))
    return W1, b1, W2, b2, W3, b3, tr_losses, val_losses

W1a,b1a,W2a,b2a,W3a,b3a,tr_a,va_a = train_mlp_2layer(
    X_tr, y_tr, X_val, y_val, H=64, lam=0.0, p_drop=0.0)
W1b,b1b,W2b,b2b,W3b,b3b,tr_b,va_b = train_mlp_2layer(
    X_tr, y_tr, X_val, y_val, H=64, lam=5e-3, p_drop=0.5)

xx, yy = np.meshgrid(np.linspace(-1.5, 2.5, 200), np.linspace(-1, 1.8, 200))
Xg = np.column_stack([xx.ravel(), yy.ravel()])

def predict(Xg, W1,b1,W2,b2,W3,b3):
    return sigmoid(relu(relu(Xg@W1+b1)@W2+b2)@W3+b3).reshape(xx.shape)

Za = predict(Xg, W1a,b1a,W2a,b2a,W3a,b3a)
Zb = predict(Xg, W1b,b1b,W2b,b2b,W3b,b3b)

fig, axes = plt.subplots(2, 2, figsize=(11, 8))
n_ep = len(tr_a)
epochs = np.arange(1, n_ep+1)
colors_cls = ['#4878CF', '#D65F5F']

for col, (tr_l, va_l, Zp, title) in enumerate([
    (tr_a, va_a, Za, 'Sans régularisation'),
    (tr_b, va_b, Zb, 'Avec dropout + décroissance des poids'),
]):
    ax = axes[0, col]
    ax.plot(epochs, tr_l, 'C0-',  lw=2, label='Entraînement')
    ax.plot(epochs, va_l, 'C1--', lw=2, label='Validation')
    ax.set_xlabel('Époque');  ax.set_ylabel('Perte')
    ax.set_title(title, fontsize=10)
    ax.legend(fontsize=9);  ax.grid(True, alpha=0.3)

    ax = axes[1, col]
    ax.contourf(xx, yy, Zp, levels=50, cmap='RdBu_r', alpha=0.65, vmin=0, vmax=1)
    ax.contour(xx, yy, Zp, levels=[0.5], colors='k', linewidths=1.5)
    for cls in [0,1]:
        m_tr = y_tr == cls; m_val = y_val == cls
        ax.scatter(X_tr[m_tr,0], X_tr[m_tr,1], c=colors_cls[cls],
                   marker='o', s=60, edgecolors='k', lw=0.8, zorder=5)
        ax.scatter(X_val[m_val,0], X_val[m_val,1], c=colors_cls[cls],
                   marker='s', s=40, alpha=0.5, zorder=4)
    ax.set_xlabel(r'$x_1$');  ax.set_ylabel(r'$x_2$')
    ax.set_title('Frontière de décision', fontsize=10)
    ax.grid(True, alpha=0.2)

axes[0,0].text(0.97, 0.97, 'Surapprentissage', transform=axes[0,0].transAxes,
               ha='right', va='top', fontsize=9, color='C1',
               bbox=dict(boxstyle='round', fc='#fff3f3', ec='C1', alpha=0.9))
fig.legend(['Entraîn. (ronds)', 'Valid. (carrés)'],
           loc='lower center', ncol=2, fontsize=9, framealpha=0.9)
plt.suptitle('Effet de la régularisation sur le surapprentissage', fontsize=12, y=1.01)
plt.tight_layout()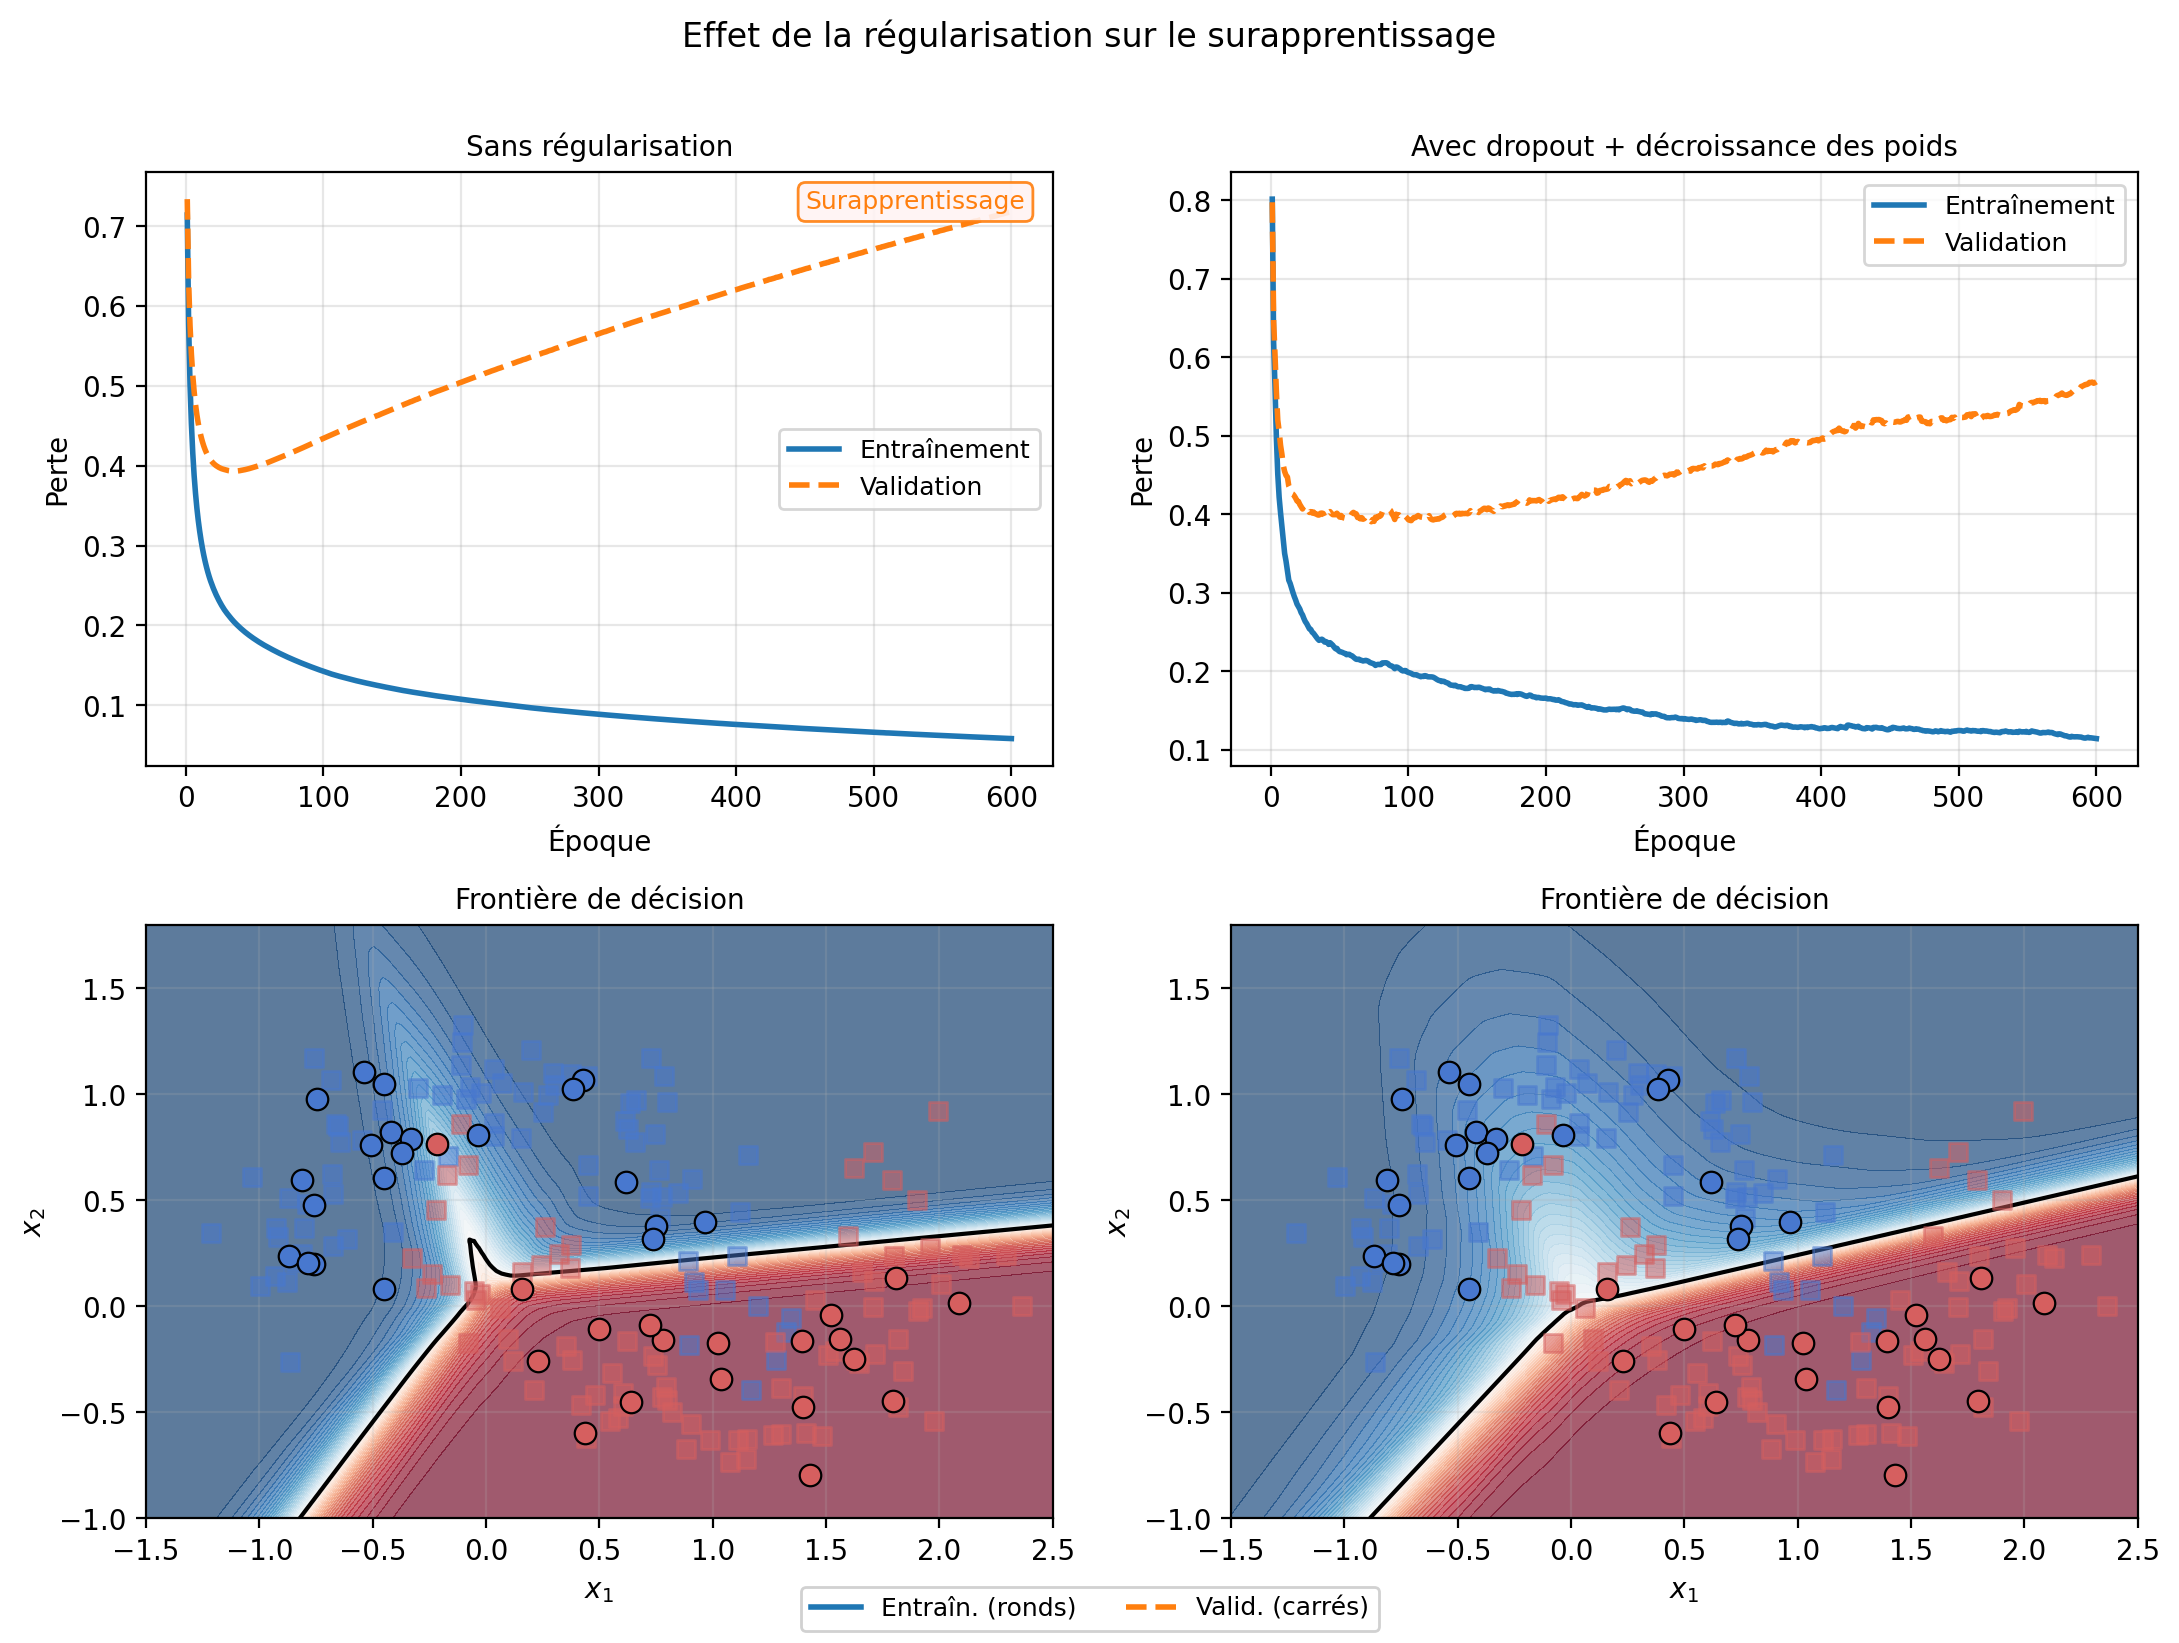
Sans régularisation, le réseau à deux couches cachées (64 neurones chacune, entraîné sur 40 exemples) mémorise les données d’entraînement: la perte d’entraînement descend vers zéro tandis que la perte de validation augmente, et la frontière de décision est très irrégulière. Avec dropout () et décroissance des poids (), la perte de validation est nettement plus basse et la frontière est plus lisse.
Pré-entraînement et transfert
Les sections précédentes supposaient qu’on entraîne un réseau en partant de poids aléatoires. En pratique, il est souvent préférable de partir de poids déjà entraînés sur une autre tâche. Cette idée, le pré-entraînement suivi d’un transfert, est devenue centrale en apprentissage profond.
L’initialisation comme problème d’optimisation
L’initialisation aléatoire (Glorot, He) garantit la stabilité du gradient, mais elle ne fournit aucune information sur la structure des données. L’optimiseur doit explorer la surface de perte depuis un point arbitraire, ce qui peut être lent et sensible aux minima locaux.
Le pré-entraînement sur une tâche auxiliaire place les paramètres dans une région de l’espace qui encode déjà des régularités utiles. L’optimisation de la tâche cible démarre alors depuis un bassin d’attraction plus favorable. Ce gain n’est pas seulement empirique: historiquement, le pré-entraînement a été la première technique permettant d’entraîner des réseaux profonds.
Pré-entraînement couche par couche: perspective historique
Avant l’adoption de ReLU et de la normalisation par lots, entraîner un réseau de plus de quelques couches avec une sigmoïde échouait à cause de la dissolution du gradient. En 2006, Hinton et al. Hinton & Salakhutdinov (2006) ont montré qu’on pouvait contourner ce problème en pré-entraînant le réseau couche par couche, de façon non supervisée, avant de l’ajuster sur la tâche supervisée.
L’idée est la suivante. On entraîne d’abord la première couche comme un auto-encodeur (chapitre 9) ou une machine de Boltzmann restreinte: elle apprend à reconstruire ses entrées, ce qui force les poids à capturer les régularités de la distribution d’entrée. Puis on fixe ces poids et on entraîne la deuxième couche de la même façon, en prenant les activations de la première couche comme entrées. On répète le processus pour chaque couche. Le réseau résultant, dont chaque couche a appris des représentations de complexité croissante, sert d’initialisation pour un entraînement supervisé classique (la phase d’ajustement fin, fine-tuning).
Cette approche glouton couche par couche Bengio et al. (2007) a eu un impact considérable: elle a démontré que les réseaux profonds pouvaient apprendre des représentations hiérarchiques, ouvrant la voie à l’apprentissage profond moderne. Avec les progrès des techniques de stabilisation (ReLU, batch normalization, connexions résiduelles), le pré-entraînement couche par couche est devenu moins nécessaire pour les réseaux à propagation avant. Mais le principe sous-jacent (une bonne initialisation facilite l’optimisation) reste au cœur des approches modernes de transfert.
Architecture tronc-tête
Les réseaux profonds modernes se décomposent naturellement en deux parties:
Le tronc (backbone) est la partie principale du réseau. Il transforme l’entrée brute (pixels, mots, signaux) en une représentation de haut niveau. Dans un réseau convolutif pour la vision, le tronc est l’empilement de couches convolutives. Dans un transformeur (chapitre 10), c’est la pile de blocs d’attention.
La tête (head) est une couche (ou un petit sous-réseau) qui prend la représentation du tronc et produit la sortie pour la tâche spécifique: classification, régression, génération, etc. Elle est souvent réduite à une couche linéaire suivie d’un softmax.
Cette décomposition est utile parce que le tronc apprend des caractéristiques générales (contours, textures, relations syntaxiques) qui sont transférables d’une tâche à l’autre, tandis que la tête est spécifique à chaque tâche.
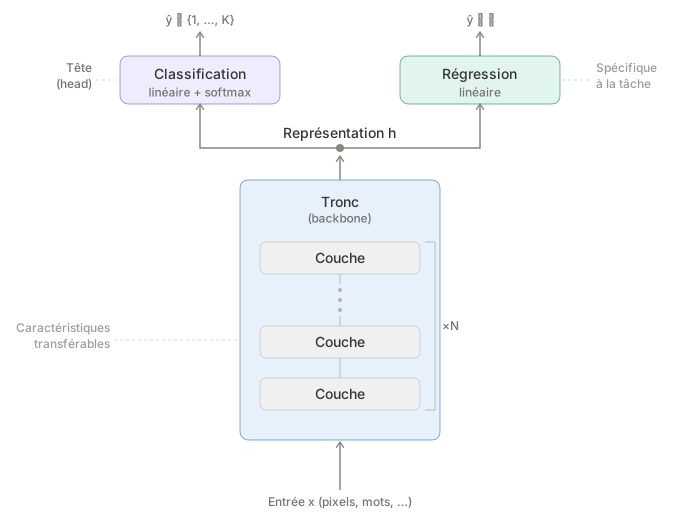
Figure 2:Architecture tronc-tête. Le tronc transforme l’entrée en une représentation de haut niveau. Différentes têtes se branchent sur cette représentation pour produire des sorties spécifiques à chaque tâche.
Transfert de représentations
Le transfert (transfer learning) consiste à réutiliser un tronc pré-entraîné sur une tâche source (souvent avec beaucoup de données) pour résoudre une tâche cible (souvent avec peu de données). Les deux stratégies principales sont:
Extraction de caractéristiques. On gèle les poids du tronc pré-entraîné et on n’entraîne que la tête sur la tâche cible. Le tronc sert de transformateur de caractéristiques fixe. Cette approche est rapide et fonctionne bien quand les données cibles sont rares.
Ajustement fin (fine-tuning). On initialise le réseau avec les poids pré-entraînés, puis on entraîne le réseau entier (tronc + tête) sur la tâche cible, généralement avec un taux d’apprentissage plus faible que pour un entraînement depuis zéro. Le tronc s’adapte aux spécificités de la tâche cible tout en conservant les représentations utiles apprises lors du pré-entraînement.
Une variante courante est le gel progressif (gradual unfreezing): on commence par geler le tronc et entraîner la tête, puis on dégèle progressivement les couches du tronc, des plus proches de la sortie vers les plus proches de l’entrée. Cette stratégie évite de détruire les représentations de bas niveau pendant les premières itérations, quand les gradients de la tête nouvellement initialisée sont encore bruités.
Représentations pré-entraînées
Le pré-entraînement sur de grands jeux de données produit des représentations (aussi appelées plongements, embeddings) qui capturent la structure des données. Un réseau convolutif pré-entraîné sur ImageNet apprend des filtres de bas niveau (contours, couleurs) dans les premières couches et des détecteurs de parties d’objets dans les couches profondes. Un modèle de langue pré-entraîné (comme BERT ou GPT, chapitre 10) apprend des représentations contextualisées des mots qui encodent la syntaxe et la sémantique.
Ces représentations sont utiles bien au-delà de la tâche de pré-entraînement. Un détecteur de contours appris sur ImageNet est utile pour la segmentation médicale. Un plongement de mots appris par prédiction du mot suivant est utile pour la classification de sentiments. C’est cette transférabilité qui rend le pré-entraînement si efficace: au lieu d’apprendre les régularités de base à partir de quelques centaines d’exemples étiquetés, on les importe d’un modèle entraîné sur des millions d’exemples.
Du point de vue de l’optimisation, le pré-entraînement fournit une initialisation dans une région de l’espace des paramètres où la surface de perte de la tâche cible est plus lisse et mieux conditionnée. L’optimiseur converge plus vite et vers de meilleurs minima que depuis une initialisation aléatoire.
Résumé
Ce chapitre a présenté les outils nécessaires pour entraîner un réseau de neurones. La descente de gradient stochastique par mini-lots est la base de tous les algorithmes d’optimisation. Le momentum amortit les oscillations en accumulant une vitesse dans les directions stables. Adam combine momentum et taux d’apprentissage adaptatifs par dimension, ce qui en fait l’optimiseur par défaut pour la plupart des applications.
Les méthodes du second ordre (Newton, L-BFGS) convergent plus vite en théorie, mais leur coût en mémoire et en calcul les rend impraticables pour les réseaux de grande taille. Le bruit intrinsèque de SGD joue un rôle de régularisateur implicite en favorisant les minima plats, qui généralisent mieux.
L’entraînement de réseaux profonds pose des défis spécifiques. La saturation des fonctions d’activation (sigmoïde, tanh) provoque la dissolution du gradient; ReLU y remédie en maintenant un gradient unitaire pour les entrées positives. L’initialisation soignée (Glorot, He), la normalisation par lots et les connexions résiduelles stabilisent l’entraînement en préservant les distributions d’activations et de gradients à travers la profondeur.
Pour éviter le surapprentissage, l’arrêt précoce interrompt l’entraînement quand la perte de validation cesse de diminuer. La décroissance des poids pénalise les paramètres de grande norme, et le dropout désactive aléatoirement des neurones pendant l’entraînement, ce qui force le réseau à apprendre des caractéristiques robustes.
Le pré-entraînement sur des tâches auxiliaires fournit une initialisation qui encode déjà des régularités utiles. Historiquement, le pré-entraînement couche par couche a été la première technique permettant d’entraîner des réseaux profonds. Aujourd’hui, le transfert de représentations (tronc pré-entraîné + tête spécifique) est la méthode standard quand les données étiquetées sont limitées.
Exercices
Exercice 1: SGD avec momentum ★
Considérez la fonction avec , , et .
Calculez le gradient .
Calculez la vitesse et la mise à jour .
Calculez la deuxième itération: , , .
Comparez avec le résultat qu’on obtiendrait avec SGD sans momentum (). Quel algorithme progresse plus vite vers le minimum?
Solution Exercice 1
.
. .
. . .
Sans momentum: , . Avec momentum, est plus proche du minimum (). Le momentum accélère la convergence en accumulant de la vitesse dans la direction du gradient.
Exercice 2: Borne de dissolution ★
Pour un réseau de couches avec activation sigmoïde, la norme du gradient à la première couche est bornée par fois la norme du gradient à la sortie.
Calculez cette borne pour , et .
Si le gradient à la sortie vaut 1, quel est l’ordre de grandeur du gradient à la première couche pour ?
Avec ReLU (dérivée égale à 1 pour les entrées positives), que devient cette borne?
Solution Exercice 2
: . : . : .
Pour , le gradient est de l’ordre de 10-12: il est pratiquement nul. Les premières couches n’apprennent plus.
Avec ReLU, la dérivée est 1 pour les entrées positives. Si toutes les pré-activations sont positives, le facteur multiplicatif est : il n’y a pas de dissolution. C’est l’avantage principal de ReLU pour les réseaux profonds.
Exercice 3: Dissolution du gradient (dérivation complète) ★★★ (optionnel pour IFT3395)
Cet exercice explore la dissolution du gradient en détail. Considérez un réseau de couches, chacune avec une seule unité sigmoïde et un poids :
Montrez que .
Si tous les poids sont et toutes les pré-activations sont au point optimal (où est maximale), quelle est la borne supérieure de en fonction de ?
Pour , calculez cette borne. Que conclure?
Répétez l’analyse avec ReLU. Que change-t-il?
Solution Exercice 3
Par la règle de la chaîne:
Avec et , on obtient le résultat.
Le maximum de est 0,25 (atteint en ). Si et :
Pour : . Le gradient est pratiquement nul.
Avec ReLU, pour . Si toutes les pré-activations sont positives:
Il n’y a pas de dissolution du gradient (mais il peut exploser si ). C’est l’une des raisons du succès de ReLU.
Exercice 4: Adam à la main ★★
Considérez la fonction scalaire et un gradient calculé à (soit ). Partez de , , , avec , , , .
Calculez les valeurs , , , après la première itération.
Calculez la mise à jour .
Comparez avec la mise à jour SGD pure . Quel algorithme fait un pas plus grand? Pourquoi?
Que se passerait-il sans la correction du biais ? Calculez la mise à jour sans correction.
Solution Exercice 4
1. Moments après la première itération (, ):
Correction du biais ():
2. Mise à jour Adam:
3. Comparaison avec SGD:
SGD fait un pas plus grand (de vs pour Adam). Dans cet exemple scalaire et à la première itération, Adam normalise le gradient par sa magnitude: , ce qui donne un pas de taille indépendamment de la magnitude du gradient. En dimension supérieure et après plusieurs itérations, la normalisation est plus nuancée (elle agit par coordonnée et dépend de l’historique), mais le principe reste le même: la normalisation adaptative rend Adam moins sensible au choix de .
4. Sans correction du biais:
Sans correction, le premier pas serait très grand (les moments sont sous-estimés par rapport à leur valeur asymptotique, et est petit, donc est grand). La correction du biais ramène les moments à leur vraie valeur dès la première itération.
Exercice 5: Dropout et espérance des activations ★★
Soit l’activation d’un neurone et le masque de dropout. La sortie avec dropout inversé est .
Montrez que . Pourquoi cette propriété est-elle importante pour l’inférence?
Calculez en fonction de et .
Pour et , calculez la variance. Que se passe-t-il quand ?
Implémentez une fonction
dropout(z, p, training)en NumPy qui applique le dropout inversé pendant l’entraînement et retourne inchangé à l’inférence.
Solution Exercice 5
1. Espérance:
car . Donc:
Cette propriété garantit que les activations ont la même espérance à l’entraînement et à l’inférence. Sans elle, il faudrait rescaler les poids à l’inférence, ce qui complique le déploiement.
2. Variance:
(variance de Bernoulli). Puisque est déterministe:
3. Pour , :
Quand , : le bruit devient arbitrairement grand, ce qui rend l’entraînement instable. En pratique, on ne dépasse pas .
4. Implémentation:
import numpy as np

def dropout(z, p, training=True):
    """Dropout inversé. p = taux de désactivation."""
    if not training or p == 0.0:
        return z
    mask = (np.random.rand(*z.shape) > p) / (1 - p)
    return z * mask
Exercice 6: Comparer SGD et la méthode de Newton ★★
Considérez la fonction avec le point initial .
Calculez le gradient et le hessien .
Effectuez une itération de la méthode de Newton: . Où arrive-t-on?
Effectuez une itération de SGD avec : . Comparez.
Pour un réseau avec paramètres, combien de mémoire (en Go) faudrait-il pour stocker le hessien en float32?
Solution Exercice 6
. En : .
(constante, indépendante de ).
.
.
Newton converge au minimum exact en une seule itération (comme attendu pour une fonction quadratique).
.
SGD fait un pas correct en mais insuffisant en . Le taux est contraint par la direction de forte courbure (); si on augmentait , on divergerait en .
Le hessien a entrées. En float32 (4 octets): octets Go pétaoctets. C’est hors de portée de toute infrastructure actuelle.
Exercice 7: Bruit du mini-lot et taille de lot ★★
Soit la perte empirique, et le gradient estimé sur un mini-lot de taille tiré sans remise.
Montrez que est un estimateur non biaisé de .
En supposant un tirage avec remise (approximation valable quand ), montrez que où est la variance du gradient individuel.
Si (SGD pur) et (gradient exact), que vaut la variance? Interprétez.
En doublant la taille du lot, par quel facteur la variance diminue-t-elle? Par quel facteur le coût par itération augmente-t-il?
Solution Exercice 7
, car chaque est tiré uniformément et .
Avec remise, les termes sont indépendants. Pour la composante : . La variance d’une moyenne de variables i.i.d. est .
Pour : (variance maximale). Pour : (gradient quasi exact). Le bruit diminue avec .
En doublant , la variance est divisée par 2, mais le coût par itération double. Le rapport signal/bruit s’améliore en seulement (écart-type en ), ce qui explique les rendements décroissants des grands lots.
Exercice 8: Initialisation de Glorot ★★
Considérez une couche linéaire avec . On suppose que les entrées sont i.i.d. de moyenne 0 et de variance , et que les poids sont i.i.d. de moyenne 0 et de variance , indépendants des entrées.
Montrez que .
Montrez que .
Pour que la variance soit préservée (), quelle doit être ?
En considérant aussi la passe arrière (le gradient a la même structure mais avec termes au lieu de ), montrez que le compromis entre les deux donne . C’est l’initialisation de Glorot.
Solution Exercice 8
. Par indépendance et moyenne nulle: .
Par indépendance: (car les moyennes sont nulles).
On veut , donc .
Lors de la passe arrière, le gradient se propage par , ce qui donne . Pour préserver la variance du gradient, il faut . Le compromis entre les deux conditions ( pour la passe avant, pour la passe arrière) donne la moyenne harmonique: .
Exercice 9: Comparer les optimiseurs (computationnel) ★★
Implémentez SGD, SGD avec momentum et Adam en NumPy pour entraîner un MLP à deux couches cachées (32 neurones, ReLU) sur un problème de classification binaire de votre choix (par exemple, sklearn.datasets.make_moons).
Tracez les courbes de perte d’entraînement en fonction des époques pour les trois optimiseurs. Utilisez pour SGD, et pour momentum, et pour Adam.
Ajoutez l’arrêt précoce avec patience et un ensemble de validation (20% des données). Combien d’époques chaque optimiseur utilise-t-il avant l’arrêt?
Comparez les frontières de décision finales. Quel optimiseur donne la frontière la plus lisse?
Solution Exercice 9
L’exercice est ouvert, mais voici les observations typiques:
Adam converge plus vite (en nombre d’époques) que SGD et momentum grâce à la normalisation adaptative. SGD oscille davantage.
Avec l’arrêt précoce, Adam s’arrête souvent plus tôt car il atteint rapidement une bonne perte de validation. SGD sans momentum peut nécessiter beaucoup plus d’époques.
Les frontières sont généralement similaires pour les trois optimiseurs si l’entraînement converge. Adam et momentum tendent à donner des frontières légèrement plus lisses car ils oscillent moins en fin d’entraînement.
Voici un squelette de code pour démarrer:
import numpy as np
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split

X, y = make_moons(n_samples=300, noise=0.2, random_state=0)
X_tr, X_val, y_tr, y_val = train_test_split(X, y, test_size=0.2)

def relu(x):    return np.maximum(0, x)
def sigmoid(x): return 1 / (1 + np.exp(-np.clip(x, -50, 50)))

# Initialisation He
H = 32
W1 = np.random.randn(2, H) * np.sqrt(2 / 2)
b1 = np.zeros(H)
W2 = np.random.randn(H, 1) * np.sqrt(2 / H)
b2 = np.zeros(1)

# Boucle d'entraînement: à compléter pour chaque optimiseur
# ...- Polyak, B. T. (1964). Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics, 4(5), 1–17.
- Nesterov, Y. E. (1983). A method for solving the convex programming problem with convergence rate O(1/k2). Doklady Akademii Nauk SSSR, 269(3), 543–547.
- Tieleman, T., & Hinton, G. (2012). Lecture 6.5 — RMSProp: Divide the gradient by a running average of its recent magnitude [Techreport]. COURSERA: Neural Networks for Machine Learning.
- Kingma, D. P., & Ba, J. (2015). Adam: A Method for Stochastic Optimization. International Conference on Learning Representations (ICLR).
- Loshchilov, I., & Hutter, F. (2017). SGDR: Stochastic Gradient Descent with Warm Restarts. International Conference on Learning Representations (ICLR).
- Keskar, N. S., Mudigere, D., Nocedal, J., Smelyanskiy, M., & Tang, P. T. P. (2017). On Large-Batch Training for Deep Learning: Generalization Gap and Sharp Minima. International Conference on Learning Representations (ICLR).
- Glorot, X., & Bengio, Y. (2010). Understanding the Difficulty of Training Deep Feedforward Neural Networks. Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics, 249–256.
- He, K., Zhang, X., Ren, S., & Sun, J. (2015). Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification. Proceedings of the IEEE International Conference on Computer Vision, 1026–1034.
- Ioffe, S., & Szegedy, C. (2015). Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift. Proceedings of the 32nd International Conference on Machine Learning, 448–456.
- Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016). Layer Normalization. arXiv Preprint arXiv:1607.06450.
- He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep Residual Learning for Image Recognition. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 770–778. 10.1109/CVPR.2016.90
- Loshchilov, I., & Hutter, F. (2019). Decoupled Weight Decay Regularization. International Conference on Learning Representations (ICLR).
- Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I., & Salakhutdinov, R. (2014). Dropout: A Simple Way to Prevent Neural Networks from Overfitting. Journal of Machine Learning Research, 15, 1929–1958.
- Hinton, G. E., & Salakhutdinov, R. R. (2006). Reducing the Dimensionality of Data with Neural Networks. Science, 313(5786), 504–507.
- Bengio, Y., Lamblin, P., Popovici, D., & Larochelle, H. (2007). Greedy Layer-Wise Training of Deep Networks. Advances in Neural Information Processing Systems (NeurIPS).