Tout au long de ce livre, nous avons optimisé des fonctions de perte par descente de gradient sur les paramètres d’un modèle: les poids d’une régression linéaire, les paramètres d’une régression logistique, puis les millions de poids d’un réseau de neurones. Dans tous ces cas, la mise à jour suit le même schéma: calculer le gradient de la perte par rapport aux paramètres, puis déplacer ces paramètres dans la direction opposée au gradient. On peut aussi adopter une perspective différente: au lieu d’optimiser les paramètres d’un modèle fixé, optimiser directement dans l’espace des fonctions. Cette perspective mène aux méthodes d’ensemble, parmi les outils les plus utilisés en science des données appliquée.
Dans ce chapitre, nous commençons par reformuler la descente de gradient dans l’espace des fonctions, en tirant parti de l’analogie avec les connexions résiduelles que nous avons vues au chapitre 8. Nous introduisons ensuite les arbres de décision comme modèle de base, en les reliant au routage du mélange d’experts du chapitre 6. La combinaison de ces deux idées donne le gradient boosting, que nous déclinons avec les arbres puis avec les outils industriels (XGBoost, LightGBM, CatBoost). Nous terminons par les forêts aléatoires, une approche complémentaire fondée sur le moyennage de modèles divers.
Descente de gradient dans l’espace des fonctions
Des connexions résiduelles aux modèles additifs
Au chapitre 8, nous avons vu que les connexions résiduelles transforment chaque bloc d’un réseau profond en une correction additive He et al. (2016):
Le bloc n’apprend pas la sortie complète, mais seulement le résidu à ajouter à l’entrée. En déroulant cette récurrence sur blocs, on obtient:
La sortie est donc la somme de l’entrée initiale et de termes , chacun appris par un bloc du réseau. Dans un réseau résiduel classique, tous ces blocs sont entraînés simultanément par rétropropagation. Que se passe-t-il si on les entraîne un à la fois, séquentiellement? Le premier bloc s’ajuste aux données, le deuxième s’ajuste aux erreurs du premier, le troisième aux erreurs des deux premiers, et ainsi de suite.
Cette idée mène au boosting. On construit une prédiction par accumulation de termes:
où est un modèle initial simple (souvent une constante), chaque est un modèle de base (weak learner), et est un taux d’apprentissage qui contrôle la taille des pas. La structure est la même que celle d’un réseau résiduel, mais chaque « bloc » est un modèle à part entière, entraîné pour corriger les erreurs de l’ensemble des blocs précédents.
Le gradient dans l’espace des fonctions
Formalisons cette idée. Nous cherchons une fonction qui minimise le risque empirique:
Pour un réseau de neurones, nous calculons et mettons à jour les paramètres. Ici, nous adoptons une perspective différente: traiter les valeurs prédites elles-mêmes comme les « paramètres » à optimiser. Le gradient de par rapport à ces valeurs est:
Ce vecteur indique, pour chaque exemple d’entraînement, dans quelle direction modifier la prédiction pour réduire la perte. La mise à jour naturelle serait:
Cette mise à jour présente un problème: elle n’est définie qu’aux points d’entraînement . Pour un nouveau point non présent dans l’ensemble d’entraînement, nous n’avons aucun gradient à appliquer.
Approximer le gradient par un modèle
La solution Friedman (2001) consiste à entraîner un modèle qui approxime le gradient négatif sur l’ensemble d’entraînement:
Ce modèle, une fois ajusté, peut être évalué en tout point , y compris des points jamais vus à l’entraînement. Les valeurs sont appelées les pseudo-résidus: ce sont les directions de descente dans l’espace des fonctions, et le modèle en fournit une approximation qui généralise au-delà des données d’entraînement.
La mise à jour devient:
En déroulant la récurrence, on retrouve un modèle additif: la descente de gradient fonctionnelle produit une somme de modèles, exactement comme la descente de gradient paramétrique produit une somme de mises à jour sur les paramètres. L’algorithme général est le suivant.
1. Initialiser f_0(x) = argmin_c Σᵢ ℓ(yᵢ, c)
2. Pour m = 1 à M:
   a. Calculer les pseudo-résidus: rᵢₘ = -∂ℓ(yᵢ, f(xᵢ))/∂f(xᵢ)|_{f=f_{m-1}}
   b. Entraîner F_m sur les couples (xᵢ, rᵢₘ) par régression
   c. Mettre à jour: f_m(x) = f_{m-1}(x) + ν F_m(x)
3. Retourner f_M(x)
Le paramètre joue le même rôle que le taux d’apprentissage dans la descente de gradient classique: des valeurs petites () ralentissent la convergence mais améliorent la généralisation, comme le montre Friedman (2001) et la pratique courante avec les réseaux de neurones.
Cas particulier: la perte quadratique
Pour la perte quadratique , le pseudo-résidu prend une forme familière:
Les pseudo-résidus sont alors les résidus ordinaires: la différence entre la cible et la prédiction courante . Le modèle apprend à prédire ce que l’ensemble actuel ne parvient pas à capturer. Si sous-estime une observation, le résidu est positif et apprend à produire une correction positive pour cette région de l’espace.
La figure suivante illustre ce processus sur un exemple de régression en une dimension. À chaque itération, un arbre de décision peu profond est ajusté sur les résidus de l’ensemble courant, puis ajouté à la prédiction.
Source
%config InlineBackend.figure_format = 'retina'
import numpy as np
import matplotlib.pyplot as plt
from sklearn.tree import DecisionTreeRegressor

np.random.seed(42)
N = 80
x = np.sort(np.random.uniform(0, 2 * np.pi, N))
y_true = np.sin(x)
y = y_true + 0.2 * np.random.randn(N)
x_plot = np.linspace(0, 2 * np.pi, 300)

nu = 0.3
iterations = [0, 1, 3, 20]
fig, axes = plt.subplots(1, 4, figsize=(14, 3), sharey=True)

f_current = np.full(N, y.mean())
f_plot = np.full_like(x_plot, y.mean())

for ax_idx, show_at in enumerate(iterations):
    # Run boosting up to this iteration
    f_run = np.full(N, y.mean())
    f_run_plot = np.full_like(x_plot, y.mean())
    for m in range(1, show_at + 1):
        residuals = y - f_run
        tree = DecisionTreeRegressor(max_depth=2)
        tree.fit(x.reshape(-1, 1), residuals)
        f_run += nu * tree.predict(x.reshape(-1, 1))
        f_run_plot += nu * tree.predict(x_plot.reshape(-1, 1))

    ax = axes[ax_idx]
    ax.scatter(x, y, s=12, alpha=0.4, color='C7', zorder=2, label='Données')
    ax.plot(x_plot, np.sin(x_plot), 'k--', alpha=0.4, linewidth=1, label='Cible')
    ax.plot(x_plot, f_run_plot, 'C0', linewidth=2, label=f'$f_{{{show_at}}}$')
    if show_at > 0:
        # Show residuals as thin vertical lines
        residuals_show = y - f_run
        for i in range(0, N, 3):
            ax.plot([x[i], x[i]], [f_run[np.searchsorted(x_plot, x[i], side='right')-1] if False else (y[i] - residuals_show[i]), y[i]],
                    color='C3', alpha=0.15, linewidth=0.8)
    ax.set_title(f'$m = {show_at}$' if show_at > 0 else '$f_0$ (constante)', fontsize=10)
    ax.set_xlabel('$x$', fontsize=9)
    ax.grid(True, alpha=0.2)
    ax.set_ylim(-1.8, 1.8)

axes[0].set_ylabel('$y$', fontsize=9)
axes[-1].legend(fontsize=8, loc='lower left')
plt.tight_layout()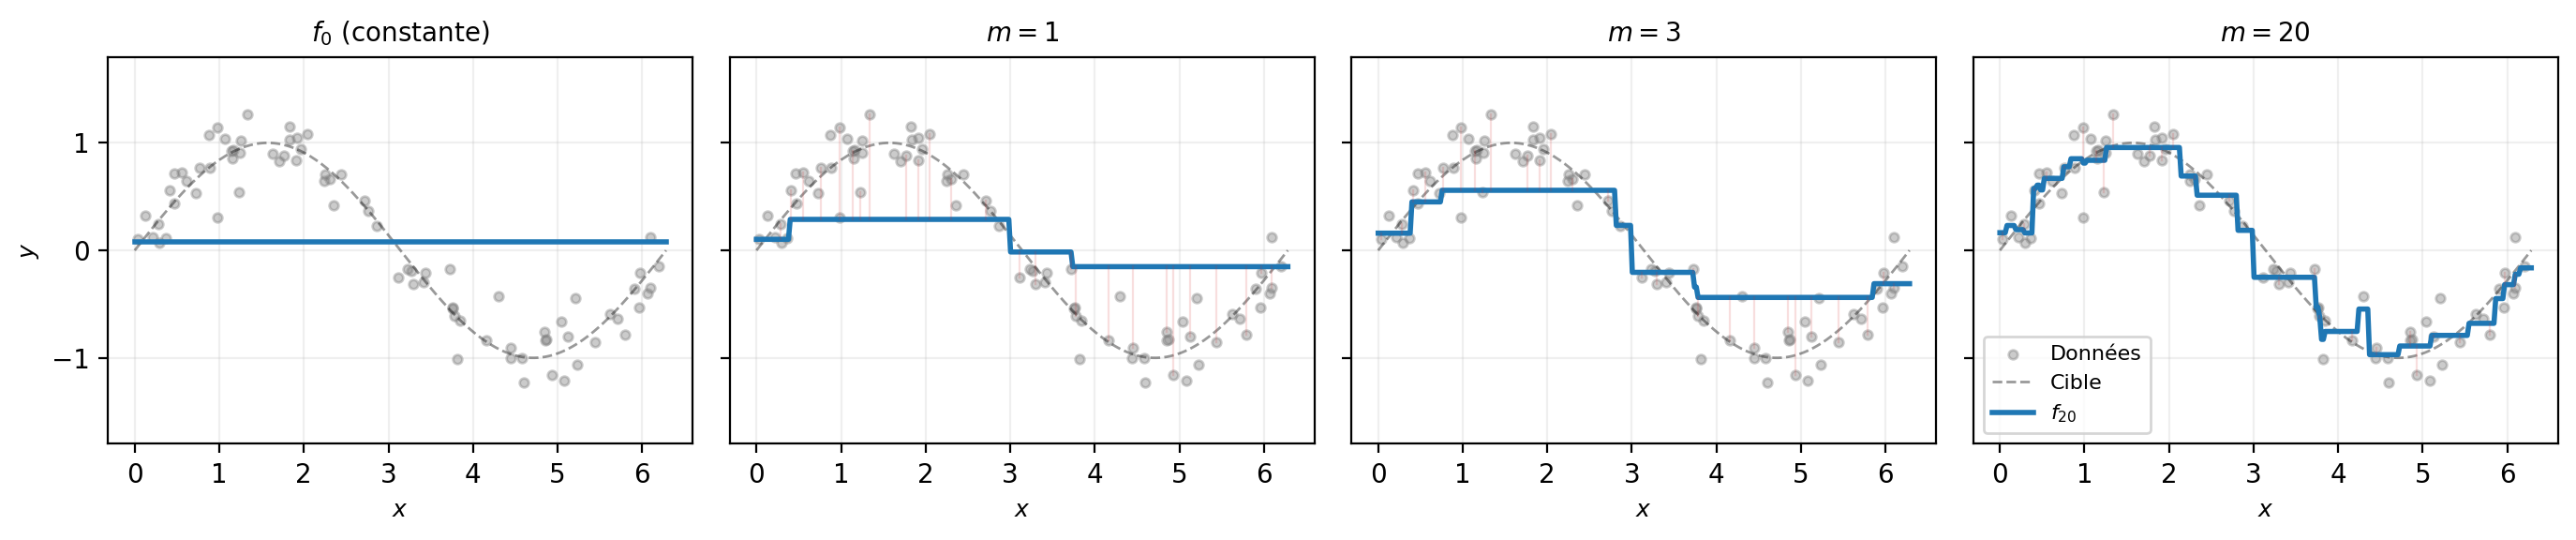
Quel type de modèle utiliser pour ? Le boosting réduit le biais de l’ensemble de façon itérative: chaque modèle ne corrige qu’une fraction des erreurs restantes, et c’est l’accumulation de centaines de petites corrections qui produit un bon prédicteur. Pour que cette stratégie fonctionne, chaque doit être un apprenant faible (weak learner), c’est-à-dire un modèle de faible capacité, à peine meilleur qu’une prédiction aléatoire. Si le modèle de base est trop puissant (un réseau de neurones profond, un arbre non élagué), il réduit le biais trop vite dès les premières itérations, en ajustant non seulement la structure des pseudo-résidus mais aussi leur bruit. Les itérations suivantes n’ont alors plus d’erreur structurée à corriger et se mettent à modéliser du bruit: l’ensemble surapprend. Badirli et al. (2020) ont illustré ce phénomène en utilisant des réseaux de neurones comme modèles de base: les réseaux à une ou deux couches cachées donnaient de bons résultats, mais passer à trois ou quatre couches dégradait la généralisation.
Les arbres de décision peu profonds (typiquement 4 à 8 feuilles) sont des apprenants faibles par construction: leur profondeur limite directement leur capacité, et ce paramètre est facile à contrôler. Ils s’entraînent par un algorithme glouton rapide, sans optimisation itérative, et leur sortie constante par morceaux approxime naturellement les pseudo-résidus. La profondeur de l’arbre et le taux d’apprentissage constituent deux mécanismes de régularisation complémentaires: l’un contrôle la complexité de chaque correction, l’autre contrôle l’amplitude du pas.
Arbres de décision
Du routage doux au partitionnement dur
Au chapitre 6, nous avons vu le mélange d’experts (MoE), où un réseau de routage attribue à chaque expert un poids proportionnel à sa pertinence pour l’entrée :
Les poids sont calculés par un softmax, ce qui donne un routage doux: plusieurs experts contribuent simultanément, et la fonction de routage est différentiable.
Un arbre de décision réalise une opération similaire, mais avec un routage dur. L’espace d’entrée est partitionné en régions et chaque région se voit attribuer une prédiction constante :
Là où le MoE utilise des fonctions douces (softmax) pour décider quels experts activent, l’arbre utilise des seuils durs sur des caractéristiques individuelles: « est-ce que ? ». Le routage est binaire (gauche ou droite) et non différentiable. Chaque observation suit un seul chemin de la racine à une feuille, sans pondération entre les branches.
Source
%config InlineBackend.figure_format = 'retina'
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import FancyArrowPatch

fig, axes = plt.subplots(1, 2, figsize=(10, 4))

# Left panel: decision tree hard partition
ax = axes[0]
np.random.seed(0)
n = 60
x1 = np.random.uniform(0, 6, n)
x2 = np.random.uniform(0, 6, n)
labels = ((x1 > 3) & (x2 > 2)) | ((x1 <= 3) & (x2 > 4))

colors_pts = ['C0' if l else 'C3' for l in labels]
ax.scatter(x1, x2, c=colors_pts, s=18, alpha=0.7, edgecolors='none', zorder=3)

# Draw axis-aligned splits
ax.axvline(x=3, color='k', linewidth=1.5, linestyle='-')
ax.plot([3, 6], [2, 2], 'k-', linewidth=1.5)
ax.plot([0, 3], [4, 4], 'k-', linewidth=1.5)

# Shade regions
ax.fill_between([0, 3], 0, 4, alpha=0.08, color='C3')
ax.fill_between([0, 3], 4, 6, alpha=0.08, color='C0')
ax.fill_between([3, 6], 0, 2, alpha=0.08, color='C3')
ax.fill_between([3, 6], 2, 6, alpha=0.08, color='C0')

ax.set_xlim(0, 6)
ax.set_ylim(0, 6)
ax.set_xlabel('$x_1$', fontsize=10)
ax.set_ylabel('$x_2$', fontsize=10)
ax.set_title('Arbre de d\u00e9cision (seuils durs)', fontsize=10)
ax.set_aspect('equal')

# Right panel: MoE soft routing
ax = axes[1]
xx, yy = np.meshgrid(np.linspace(0, 6, 200), np.linspace(0, 6, 200))

# Simulate soft gating: two experts with learned linear boundaries
def sigmoid(z):
    return 1 / (1 + np.exp(-z))

# Soft version of similar boundaries
g1 = sigmoid(2 * (xx - 3))
g2 = sigmoid(2 * (yy - 3))
soft_prob = g1 * g2 + (1 - g1) * sigmoid(2 * (yy - 4))

ax.contourf(xx, yy, soft_prob, levels=20, cmap='RdBu', alpha=0.3)
ax.scatter(x1, x2, c=colors_pts, s=18, alpha=0.7, edgecolors='none', zorder=3)

ax.set_xlim(0, 6)
ax.set_ylim(0, 6)
ax.set_xlabel('$x_1$', fontsize=10)
ax.set_ylabel('$x_2$', fontsize=10)
ax.set_title('M\u00e9lange d\'experts (routage doux)', fontsize=10)
ax.set_aspect('equal')

plt.tight_layout()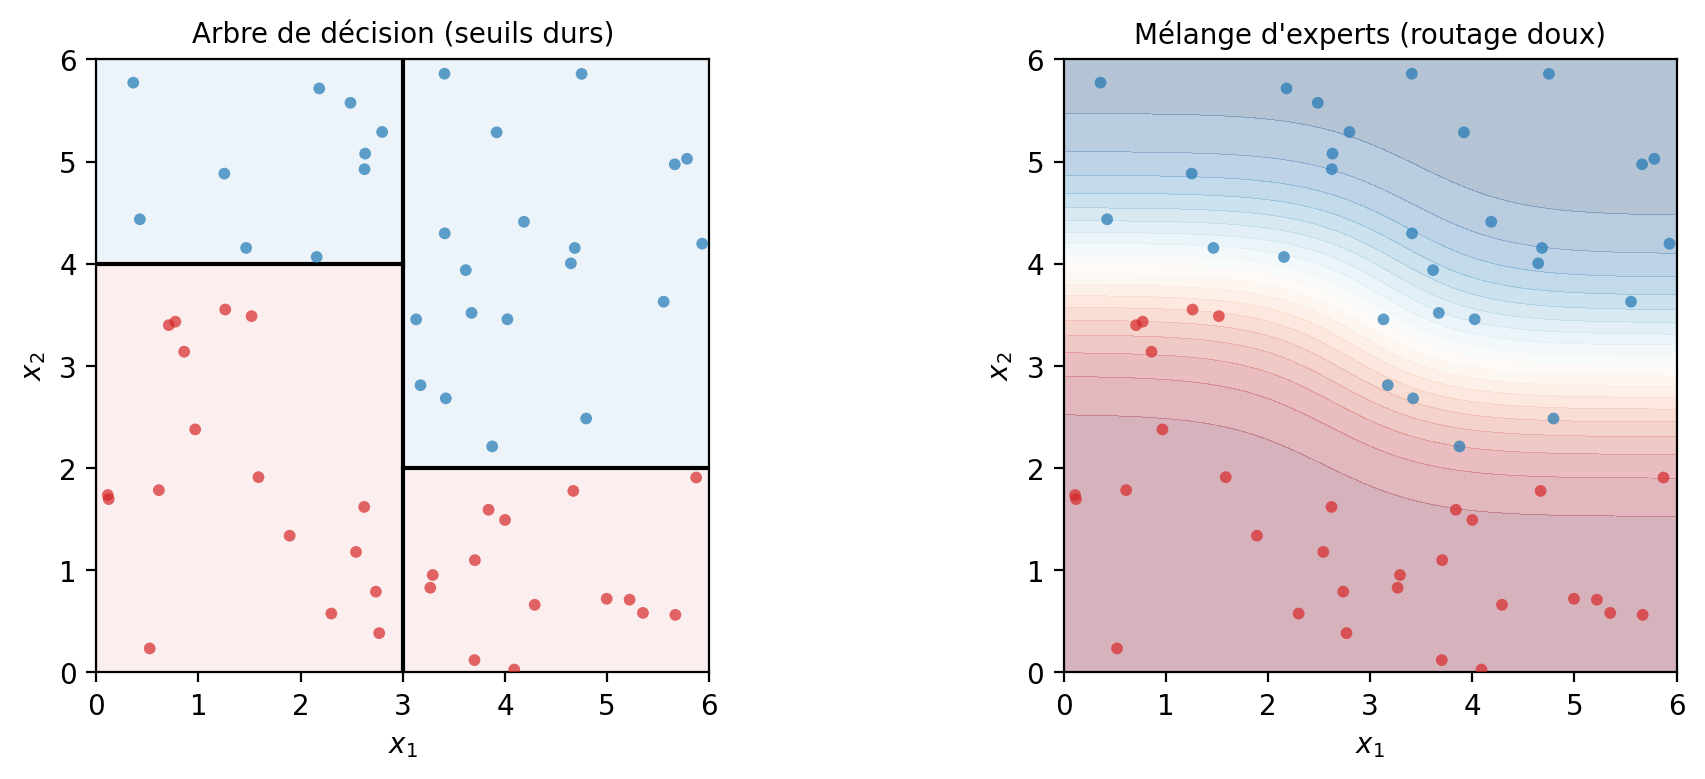
Le lien entre MoE et arbres de décision va au-delà de l’analogie. Frosst & Hinton (2017) ont montré qu’on peut construire des arbres de décision « doux » (soft decision trees) où les seuils sont remplacés par des sigmoïdes, ce qui rend l’arbre entièrement différentiable et entraînable par rétropropagation. Les arbres classiques se situent à l’extrémité non différentiable de ce continuum: ils sont plus rapides à entraîner, directement interprétables, et gèrent naturellement les caractéristiques de types mixtes (continues, catégorielles, manquantes).
Structure d’un arbre
Un arbre de décision est composé de nœuds internes, qui posent des questions sur les caractéristiques, et de feuilles, qui contiennent les prédictions. Pour la régression, chaque feuille prédit une constante , typiquement la moyenne des cibles des exemples qui tombent dans cette feuille:
Pour la classification, chaque feuille contient une distribution sur les classes. La distribution empirique au nœud est:
La prédiction peut être la classe majoritaire , ou la distribution complète pour une estimation probabiliste.
Apprentissage glouton
Trouver l’arbre optimal pour un jeu de données est un problème NP-complet. Contrairement aux réseaux de neurones, où nous pouvons au moins calculer un gradient et suivre une direction de descente, l’espace des structures d’arbres est discret et ne se prête pas à l’optimisation par gradient. Les algorithmes classiques (CART, C4.5, ID3) utilisent donc une procédure gloutonne: à chaque nœud, on cherche la meilleure division parmi toutes les caractéristiques et tous les seuils.
Soit l’ensemble des exemples au nœud . Pour une caractéristique continue et un seuil , la division sépare les exemples en deux enfants:
On choisit la caractéristique et le seuil qui minimisent le coût pondéré des enfants:
où est une mesure d’impureté du nœud.
Critères d’impureté
En régression, le critère naturel est l’erreur quadratique moyenne:
En classification, deux critères sont courants. L’indice de Gini mesure la probabilité qu’un exemple tiré au hasard dans le nœud soit mal classifié si on lui assigne une classe selon :
L’indice de Gini vaut 0 pour un nœud pur (tous les exemples de la même classe) et atteint son maximum quand les classes sont équiprobables. L’entropie offre une alternative liée à la théorie de l’information:
En pratique, le Gini et l’entropie donnent des résultats similaires, comme le montre la figure ci-dessous pour le cas binaire (). Le Gini est légèrement plus rapide à calculer car il évite le logarithme.
Source
%config InlineBackend.figure_format = 'retina'
import numpy as np
import matplotlib.pyplot as plt

p = np.linspace(0.001, 0.999, 300)

gini = 2 * p * (1 - p)
entropy = -(p * np.log2(p) + (1 - p) * np.log2(1 - p))
misclass = 1 - np.maximum(p, 1 - p)

fig, ax = plt.subplots(figsize=(6, 3.5))
ax.plot(p, entropy, 'C0', linewidth=2, label='Entropie (bits)')
ax.plot(p, gini, 'C1', linewidth=2, label='Gini')
ax.plot(p, misclass, 'C2--', linewidth=1.5, label='Erreur de classification')
ax.set_xlabel(r'$\hat{\pi}_1$ (proportion de la classe 1)', fontsize=10)
ax.set_ylabel('Impuret\u00e9', fontsize=10)
ax.legend(fontsize=9)
ax.grid(True, alpha=0.2)
ax.set_xlim(0, 1)
ax.set_ylim(0, 1.1)
plt.tight_layout()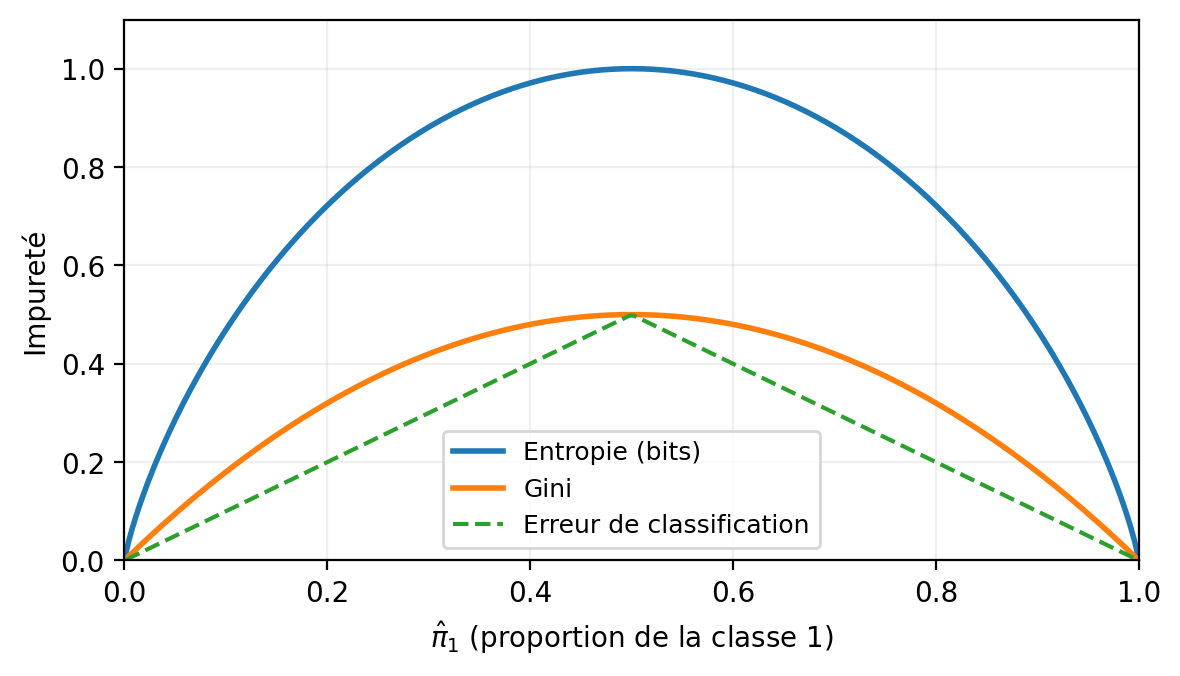
Régularisation
Sans contrainte, un arbre peut croître jusqu’à avoir une feuille par exemple, ce qui donne une erreur d’entraînement nulle mais une mauvaise généralisation. Les deux familles de régularisation sont l’arrêt précoce (limiter la profondeur maximale, exiger un nombre minimal d’exemples par feuille, imposer un gain minimal) et l’élagage a posteriori, où l’on fait croître l’arbre complet puis on fusionne les sous-arbres peu utiles.
L’algorithme CART utilise un critère de coût-complexité:
où est le nombre de feuilles et pénalise la taille de l’arbre. L’élagage après construction est généralement préféré à l’arrêt précoce, car une division qui semble peu utile à un nœud donné peut permettre des divisions très informatives dans les sous-arbres.
Un arbre seul est un modèle limité: sa construction gloutonne et son instabilité face aux variations des données en font un prédicteur médiocre utilisé isolément. Mais ces mêmes propriétés en font un bon modèle de base pour le gradient boosting: chaque arbre n’a besoin que d’approximer grossièrement les pseudo-résidus, et l’ensemble se charge de l’accumulation des corrections.
Gradient tree boosting
Nous avons maintenant les deux ingrédients: un cadre d’optimisation (la descente de gradient fonctionnelle, qui produit des pseudo-résidus à chaque itération) et un modèle de base (l’arbre de décision, rapide à entraîner sur ces pseudo-résidus). Combinons-les.
À l’étape du gradient tree boosting, on construit un arbre de régression sur les pseudo-résidus . L’arbre partitionne l’espace en régions :
La procédure se fait en deux étapes. D’abord, on ajuste l’arbre sur les pseudo-résidus pour déterminer la structure (les régions ). Ensuite, on optimise les poids de chaque feuille:
Pour la perte quadratique, le poids optimal est la moyenne des résidus dans la feuille. Pour d’autres pertes, ce sous-problème est en général résolu analytiquement ou par quelques itérations de Newton.
AdaBoost comme cas particulier
L’algorithme AdaBoost Freund & Schapire (1997), qui a précédé historiquement le gradient boosting, correspond au cas particulier de la perte exponentielle avec .
La perte exponentielle est une borne supérieure lisse sur la perte 0-1. Elle pénalise exponentiellement les erreurs, ce qui la rend sensible aux valeurs aberrantes. À l’étape , l’objectif se réécrit:
où sont les poids des exemples. Les exemples mal classifiés par l’ensemble courant ont un poids plus élevé: le prochain classificateur se concentre sur les cas difficiles.
Pour un classificateur binaire , le coefficient optimal est:
où est l’erreur pondérée. Si le classificateur est à peine meilleur que le hasard ( proche de ), son poids est proche de 0. Si le classificateur est parfait (), son poids tend vers l’infini. Les poids des exemples sont ensuite mis à jour:
Les exemples mal classifiés voient leur poids augmenter exponentiellement, et les exemples bien classifiés voient leur poids diminuer.
Algorithme: AdaBoost.M1
Entrée: Données {(xᵢ, yᵢ)}, nombre d'itérations M
1. Initialiser ωᵢ = 1/N pour tout i
2. Pour m = 1 à M:
   a. Entraîner F_m sur les données pondérées par ω
   b. Calculer err_m = Σ ωᵢ I(ỹᵢ ≠ F_m(xᵢ)) / Σ ωᵢ
   c. Calculer β_m = ½ log[(1 - err_m) / err_m]
   d. Mettre à jour: ωᵢ ← ωᵢ exp[β_m I(ỹᵢ ≠ F_m(xᵢ))]
3. Retourner f(x) = signe[Σ β_m F_m(x)]
XGBoost et l’approximation de second ordre
XGBoost (eXtreme Gradient Boosting) Chen & Guestrin (2016) étend le gradient tree boosting de plusieurs façons. La première innovation est l’ajout d’une régularisation explicite de l’arbre:
Le terme pénalise le nombre de feuilles (poussant vers des arbres plus simples) et le terme régularise les poids des feuilles (comme la décroissance des poids dans les réseaux de neurones).
La seconde innovation est l’utilisation d’une approximation de Taylor de second ordre de la perte, au lieu du seul gradient. En posant et , l’objectif approximé devient:
En regroupant les termes par feuille ( et ), on obtient un critère de gain pour évaluer chaque division candidate:
Ce critère intègre directement la régularisation dans la construction de l’arbre: une division n’est retenue que si son gain dépasse le coût d’ajouter une feuille.
Outils de gradient boosting en pratique
Trois bibliothèques dominent l’utilisation industrielle du gradient boosting. Elles partagent la même idée de base mais diffèrent dans les détails d’implémentation.
XGBoost construit les arbres niveau par niveau (level-wise): tous les nœuds à une profondeur donnée sont divisés avant de passer au niveau suivant. L’approximation de second ordre permet d’optimiser n’importe quelle perte deux fois différentiable. Les caractéristiques catégorielles doivent être encodées manuellement (par exemple en one-hot).
LightGBM Ke et al. (2017) construit plutôt les arbres feuille par feuille (leaf-wise): à chaque étape, la feuille dont la division réduit le plus la perte est divisée, quelle que soit sa profondeur. Cette stratégie produit des arbres asymétriques et converge souvent plus vite. Deux techniques accélèrent l’entraînement sur de grands jeux de données: GOSS (Gradient-based One-Side Sampling) conserve les exemples à fort gradient et sous-échantillonne les autres, et EFB (Exclusive Feature Bundling) regroupe les caractéristiques mutuellement exclusives.
CatBoost Prokhorenkova et al. (2018) se distingue par sa gestion native des caractéristiques catégorielles: au lieu d’un encodage one-hot, il utilise des statistiques ordonnées sur la cible (ordered target statistics) pour convertir les catégories en valeurs numériques, en évitant la fuite d’information (target leakage). L’entraînement utilise un boosting ordonné (ordered boosting) qui entraîne chaque arbre sur une permutation différente des données.
Importance des caractéristiques
Un avantage pratique des ensembles d’arbres est de fournir une mesure d’importance des caractéristiques. Pour un arbre , l’importance de la caractéristique est la somme des gains aux nœuds qui utilisent cette caractéristique:
Pour un ensemble de arbres, on moyenne: . Ces scores, normalisés dans , permettent d’identifier les variables les plus prédictives et d’orienter l’ingénierie des caractéristiques.
Autres modèles de base
Les arbres sont de loin le modèle de base le plus utilisé en gradient boosting, mais le cadre est général. Des modèles linéaires peuvent servir d’apprenants faibles (on parle de L2 boosting). Nous avons vu plus haut que des réseaux de neurones peu profonds peuvent aussi jouer ce rôle Badirli et al. (2020), à condition de limiter strictement leur capacité pour préserver le caractère d’apprenant faible.
On peut aussi faire le lien avec les noyaux. Les fenêtres de Parzen, que nous avons vues pour l’estimation de densité, et l’estimateur de Nadaraya-Watson, que le chapitre 10 a relié au mécanisme d’attention, sont des exemples de modèles non paramétriques définis par une fonction noyau . Cette idée se généralise à des familles de modèles entières (régression à noyau de type ridge, machines à vecteurs de support) construites dans des espaces de Hilbert à noyau reproduisant, un formalisme où tous les calculs se réduisent à des produits scalaires entre exemples. Ce cadre dépasse notre propos, mais il illustre que la descente de gradient fonctionnelle s’inscrit dans une tradition plus large de modèles définis dans des espaces de fonctions.
En pratique, les arbres dominent pour plusieurs raisons: ils sont rapides à entraîner (pas d’optimisation itérative), leur sortie constante par morceaux s’adapte naturellement à la tâche d’approximation du gradient, et ils gèrent les caractéristiques mixtes et les valeurs manquantes sans prétraitement.
Le boosting est une façon de construire un ensemble de modèles, mais ce n’est pas la seule. En ajoutant séquentiellement des corrections, le boosting réduit le biais de l’ensemble. Que se passe-t-il si, au lieu de corriger les erreurs, on cherche plutôt à réduire la variance en moyennant des modèles entraînés indépendamment?
Ensembles par moyennage: bagging et forêts aléatoires
Au chapitre 6, nous avons vu le mélange d’experts, où des modèles spécialisés sont combinés par un réseau de routage qui attribue des poids dépendant de l’entrée. Le bagging adopte une approche plus simple: entraîner modèles du même type sur des sous-ensembles différents des données, puis moyenner leurs prédictions avec des poids uniformes.
L’instabilité des arbres: un avantage
Les arbres de décision sont des modèles instables: de petits changements dans les données d’entraînement peuvent produire des arbres très différents. Cette propriété vient du processus glouton de construction: si une division précoce change, toute la structure en aval est affectée. Pour un modèle unique, cette instabilité est un défaut (haute variance). Pour un ensemble, c’est un atout: des modèles divers produisent des erreurs peu corrélées, et leur moyenne réduit la variance.
Au chapitre 4, nous avons vu la décomposition biais-variance de l’erreur. Pour une moyenne de estimateurs de variance et corrélation , la variance de l’ensemble est:
Quand est grand, le second terme disparaît, mais le premier reste: la variance de l’ensemble ne peut pas descendre en dessous de . Réduire la corrélation entre les modèles est donc au moins aussi important que d’en augmenter le nombre.
Source
%config InlineBackend.figure_format = 'retina'
import numpy as np
import matplotlib.pyplot as plt
from sklearn.tree import DecisionTreeRegressor

np.random.seed(42)
N = 60
x = np.sort(np.random.uniform(0, 2 * np.pi, N))
y = np.sin(x) + 0.3 * np.random.randn(N)
x_plot = np.linspace(0, 2 * np.pi, 300)
y_plot_true = np.sin(x_plot)

fig, axes = plt.subplots(1, 2, figsize=(10, 3.5), sharey=True)

M = 15
preds = []
for m in range(M):
    idx = np.random.choice(N, N, replace=True)
    tree = DecisionTreeRegressor(max_depth=4)
    tree.fit(x[idx].reshape(-1, 1), y[idx])
    preds.append(tree.predict(x_plot.reshape(-1, 1)))

# Left: individual trees
ax = axes[0]
ax.scatter(x, y, s=12, alpha=0.3, color='C7', zorder=2)
ax.plot(x_plot, y_plot_true, 'k--', alpha=0.4, linewidth=1, label='Cible')
for p in preds:
    ax.plot(x_plot, p, alpha=0.2, linewidth=0.8, color='C0')
ax.set_title(f'{M} arbres individuels', fontsize=10)
ax.set_xlabel('$x$', fontsize=9)
ax.set_ylabel('$y$', fontsize=9)
ax.grid(True, alpha=0.2)
ax.set_ylim(-2, 2)

# Right: averaged
ax = axes[1]
ax.scatter(x, y, s=12, alpha=0.3, color='C7', zorder=2)
ax.plot(x_plot, y_plot_true, 'k--', alpha=0.4, linewidth=1, label='Cible')
mean_pred = np.mean(preds, axis=0)
ax.plot(x_plot, mean_pred, 'C0', linewidth=2, label='Moyenne')
ax.set_title('Moyenne (bagging)', fontsize=10)
ax.set_xlabel('$x$', fontsize=9)
ax.legend(fontsize=8, loc='lower left')
ax.grid(True, alpha=0.2)

plt.tight_layout()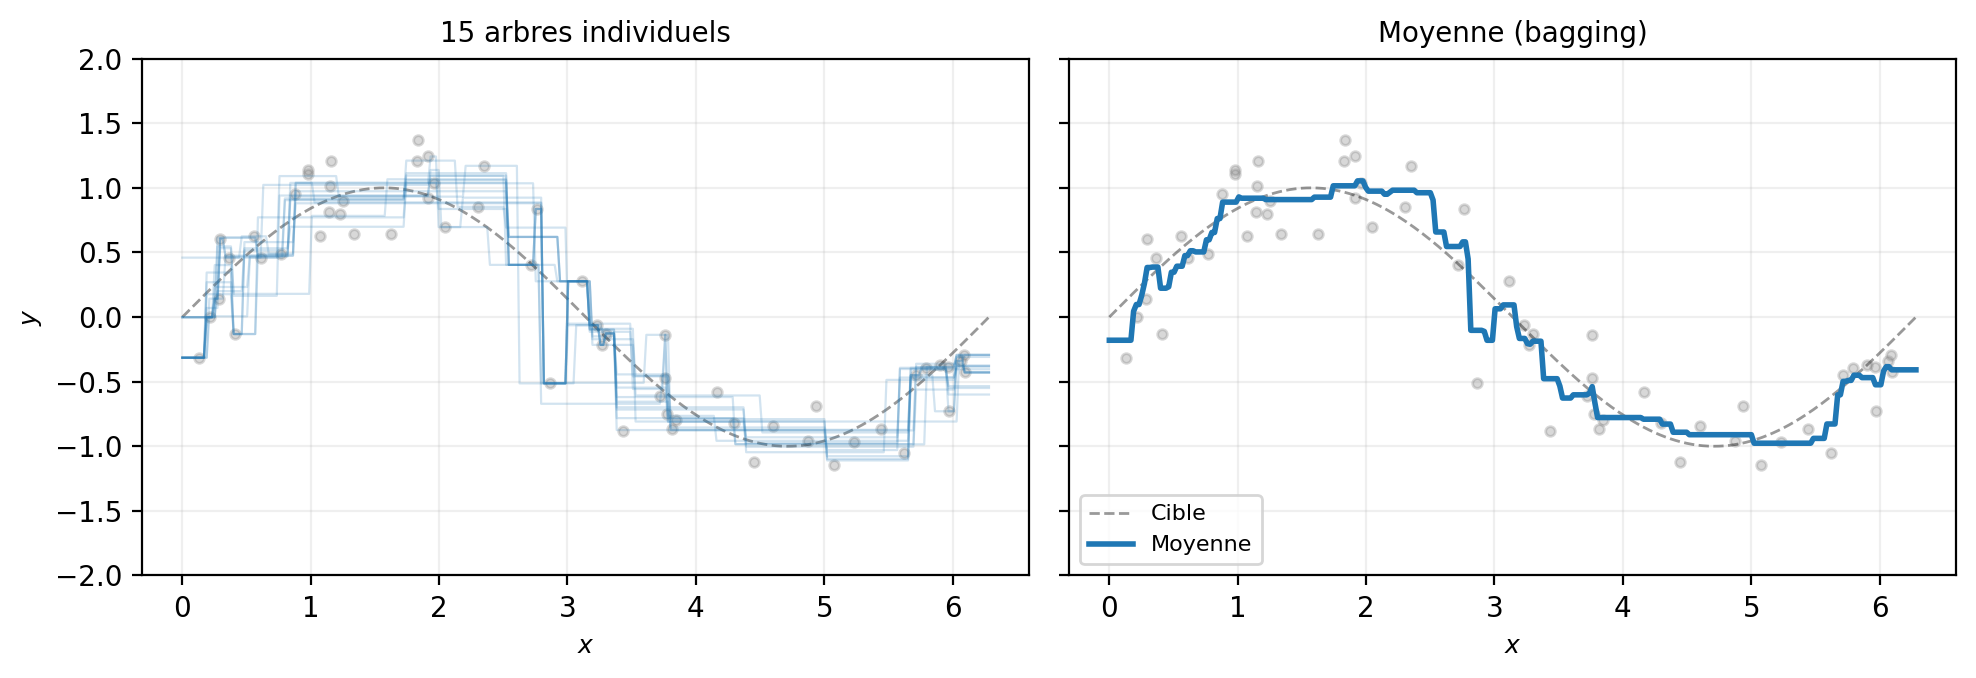
Bagging et échantillonnage bootstrap
Le bagging (Bootstrap AGGregatING) crée de la diversité en entraînant chaque modèle sur un échantillon bootstrap: exemples tirés uniformément avec remplacement parmi les exemples originaux. La probabilité qu’un exemple donné ne soit pas sélectionné dans tirages est:
Chaque modèle voit en moyenne 63% des données. Les 37% restants, appelés exemples hors sac (out-of-bag, OOB), servent de jeu de validation gratuit: l’erreur OOB estime l’erreur de généralisation sans nécessiter de jeu de validation séparé.
Algorithme: Bagging
Entrée: Données D = {(xₙ, yₙ)}, nombre de modèles M
Pour m = 1 à M:
    D_m ← échantillon bootstrap de D (N tirages avec remplacement)
    f_m ← entraîner un modèle sur D_m
Sortie: f(x) = (1/M) Σₘ f_m(x)  [régression]
        f(x) = vote_majoritaire({f_m(x)})  [classification]
Forêts aléatoires
Les forêts aléatoires (Random Forests) Breiman (2001) étendent le bagging en ajoutant une source de diversité supplémentaire: à chaque division d’un arbre, seul un sous-ensemble aléatoire de caractéristiques est considéré. Au lieu de chercher la meilleure division parmi les caractéristiques, on tire un sous-ensemble et on optimise uniquement sur .
La taille typique du sous-ensemble est pour la classification et pour la régression. Cette contrainte décorrèle les arbres: dans le bagging simple, les arbres tendent à avoir des structures similaires parce que les mêmes caractéristiques dominantes apparaissent aux premières divisions. Avec le sous-échantillonnage de caractéristiques, les arbres explorent des découpages différents de l’espace, ce qui réduit la corrélation dans la formule de variance de l’ensemble.
Les forêts aléatoires fournissent deux mesures d’importance des variables. L’importance par diminution d’impureté somme les gains associés à chaque caractéristique sur tous les arbres. L’importance par permutation mesure la dégradation de l’erreur OOB quand on permute aléatoirement les valeurs d’une variable: si la prédiction se dégrade fortement, la variable est importante.
Source
%config InlineBackend.figure_format = 'retina'
import numpy as np
import matplotlib.pyplot as plt
from sklearn.tree import DecisionTreeRegressor

# Compare bagging (all features) vs random forest (feature subsampling)
np.random.seed(42)
N = 80
D = 8
X = np.random.randn(N, D)
# Target depends mainly on first 2 features
y = np.sin(X[:, 0]) + 0.5 * X[:, 1] + 0.2 * np.random.randn(N)

# Sort by x0 for plotting
order = np.argsort(X[:, 0])
x_sorted = X[order, 0]

M = 10
fig, axes = plt.subplots(1, 2, figsize=(10, 3.5), sharey=True)

# Bagging: all features at each split
preds_bag = []
for m in range(M):
    idx = np.random.choice(N, N, replace=True)
    tree = DecisionTreeRegressor(max_depth=4)
    tree.fit(X[idx], y[idx])
    preds_bag.append(tree.predict(X[order]))

ax = axes[0]
for p in preds_bag:
    ax.plot(x_sorted, p, alpha=0.35, linewidth=1, color='C0')
ax.plot(x_sorted, np.mean(preds_bag, axis=0), 'C0', linewidth=2.5, label='Moyenne')
ax.set_title('Bagging (toutes les caract.)', fontsize=10)
ax.set_xlabel('$x_1$', fontsize=9)
ax.set_ylabel('Pr\u00e9diction', fontsize=9)
ax.legend(fontsize=8)
ax.grid(True, alpha=0.2)

# Random forest: subset of features at each split
preds_rf = []
for m in range(M):
    idx = np.random.choice(N, N, replace=True)
    tree = DecisionTreeRegressor(max_depth=4, max_features=int(np.sqrt(D)))
    tree.fit(X[idx], y[idx])
    preds_rf.append(tree.predict(X[order]))

ax = axes[1]
for p in preds_rf:
    ax.plot(x_sorted, p, alpha=0.35, linewidth=1, color='C2')
ax.plot(x_sorted, np.mean(preds_rf, axis=0), 'C2', linewidth=2.5, label='Moyenne')
ax.set_title('For\u00eat al\u00e9atoire ($\\sqrt{D}$ caract.)', fontsize=10)
ax.set_xlabel('$x_1$', fontsize=9)
ax.legend(fontsize=8)
ax.grid(True, alpha=0.2)

plt.tight_layout()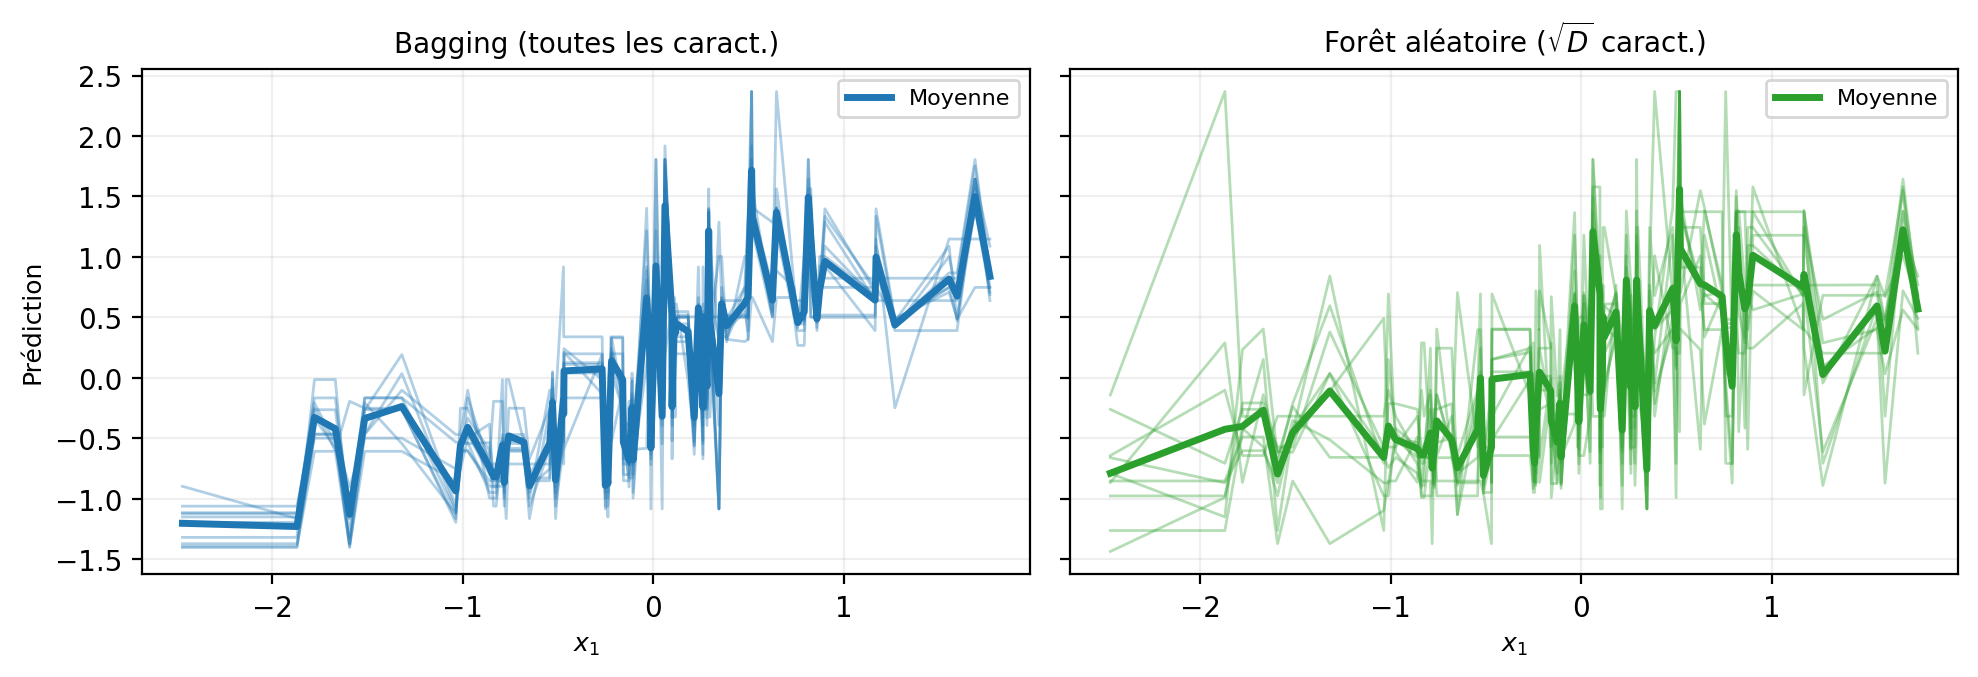
Comparaison: boosting et bagging
Le boosting et le bagging sont des stratégies complémentaires. Le bagging réduit la variance en moyennant des modèles indépendants; il fonctionne mieux avec des modèles de base complexes (arbres profonds) dont la variance est élevée. Le boosting réduit le biais en ajoutant séquentiellement des corrections; il utilise typiquement des modèles de base simples (arbres peu profonds, souvent 4 à 8 feuilles, appelés stumps quand ils n’ont qu’une seule division).
Le bagging est parallélisable (chaque modèle est indépendant) et résistant au surapprentissage. Le boosting est séquentiel et peut surapprendre si le nombre d’itérations est trop grand, ce qui rend le choix de (par validation croisée) un hyperparamètre important.
En pratique, le gradient boosting avec arbres (XGBoost, LightGBM, CatBoost) tend à obtenir les meilleures performances prédictives sur les données tabulaires, tandis que les forêts aléatoires sont plus simples à configurer et plus robustes au choix des hyperparamètres. On peut se demander pourquoi les arbres restent si compétitifs malgré les modèles différentiables développés dans les chapitres précédents.
Stacking
Au lieu de moyenner les prédictions uniformément, on peut apprendre à les combiner. Le stacking entraîne un méta-modèle sur les prédictions des modèles de base: pour chaque exemple, le vecteur sert de caractéristiques au méta-modèle, qui apprend les pondérations optimales. Les prédictions du niveau 0 doivent être obtenues par validation croisée (pas sur les données d’entraînement) pour éviter que le méta-modèle ne mette tout le poids sur le modèle le plus performant sur l’entraînement.
Arbres et données tabulaires
Grinsztajn et al. (2022) ont comparé systématiquement les ensembles d’arbres et les réseaux de neurones sur 45 jeux de données tabulaires de taille moyenne (~10 000 exemples) et identifié trois raisons pour lesquelles les réseaux de neurones peinent sur ce type de données.
Les réseaux de neurones ne sont pas robustes aux caractéristiques non informatives: une variable sans pouvoir prédictif perturbe l’optimisation par gradient, alors que l’algorithme glouton d’un arbre l’ignore simplement en ne la sélectionnant jamais pour une division. Les arbres gèrent naturellement les fonctions cible irrégulières (non lisses), dont les discontinuités correspondent directement à leur structure constante par morceaux. Les réseaux de neurones, en revanche, tendent à apprendre des fonctions lisses, ce qui est un avantage pour les images ou le langage mais un handicap pour les données tabulaires aux frontières de décision abruptes. Les arbres sont invariants aux transformations monotones des caractéristiques (seul l’ordre des valeurs compte pour les seuils), là où les réseaux de neurones sont sensibles à l’échelle et à la distribution des entrées.
Ce résultat ne diminue pas l’intérêt des réseaux de neurones: pour les images, le texte, l’audio ou les données séquentielles, les architectures profondes restent largement supérieures. Mais pour les données tabulaires structurées, qui représentent une grande part des applications industrielles en science des données, les ensembles d’arbres restent un outil de premier plan.
Résumé
L’optimisation dans l’espace des fonctions prolonge l’optimisation paramétrique que nous pratiquons depuis le début de ce livre.
La descente de gradient fonctionnelle construit un modèle additif en ajustant séquentiellement des modèles de base sur les pseudo-résidus, qui sont les gradients négatifs de la perte par rapport aux prédictions. Cette idée généralise la correction additive des connexions résiduelles du chapitre 8 au cas où chaque correction est un modèle complet. Les arbres de décision, qui partitionnent l’espace d’entrée par des seuils durs sur les caractéristiques individuelles, sont le modèle de base dominant pour le gradient boosting. Combinés avec des techniques de régularisation et d’optimisation de second ordre, ils donnent les algorithmes XGBoost, LightGBM et CatBoost, qui sont parmi les outils les plus utilisés en apprentissage machine appliqué.
Les forêts aléatoires prennent le chemin complémentaire: au lieu de corriger séquentiellement le biais, elles réduisent la variance en moyennant des arbres entraînés indépendamment sur des sous-ensembles aléatoires des données et des caractéristiques. Le choix entre boosting et forêts aléatoires dépend du compromis biais-variance propre au problème.
Exercices
Exercice 1: Pseudo-résidus et résidus ★
Pour la perte quadratique :
Calculez le pseudo-résidu .
Vérifiez que c’est le résidu ordinaire .
Pour la perte absolue , calculez le pseudo-résidu. Que vaut-il?
Solution Exercice 1
C’est bien le résidu ordinaire: la différence entre la cible et la prédiction.
Pour la perte absolue: . Le pseudo-résidu est +1 si la prédiction est trop basse et -1 si elle est trop haute. Contrairement à la perte quadratique, l’amplitude de l’erreur n’influence pas le pseudo-résidu, ce qui rend cette perte robuste aux valeurs aberrantes.
Exercice 2: Construction manuelle d’un arbre ★
Considérez les données suivantes pour un problème de classification binaire:
| 1 | 2 | + |
| 2 | 1 | + |
| 3 | 3 | - |
| 4 | 2 | - |
Calculez l’entropie initiale du nœud racine.
Pour la caractéristique avec seuil , calculez l’entropie des deux enfants et le gain d’information.
Faites de même pour avec .
Quelle division est préférable?
Solution Exercice 2
Au nœud racine: 2 exemples + et 2 exemples -, donc . L’entropie est bit.
Pour : enfant gauche , purement +, . Enfant droit , purement -, . Le gain d’information est bit.
Pour : enfant gauche avec , . Enfant droit , purement -, . Le gain est bit.
La division sur est préférable (gain = 1 bit vs 0,311 bit). Elle sépare parfaitement les deux classes.
Exercice 3: Indice de Gini ★
Un nœud contient 60 exemples de classe A et 40 exemples de classe B.
Calculez l’indice de Gini de ce nœud.
Si une division produit un enfant gauche avec (50 A, 10 B) et un enfant droit avec (10 A, 30 B), calculez l’indice de Gini pondéré après division.
De combien la division réduit-elle l’impureté?
Solution Exercice 3
, . .
Enfant gauche (60 exemples): . Enfant droit (40 exemples): . Gini pondéré: .
Réduction: . La division réduit l’impureté de 34%.
Exercice 4: Poids AdaBoost ★★
Considérez AdaBoost avec 3 exemples initialement pondérés uniformément (). Le premier classificateur faible a une erreur pondérée de .
Calculez .
Si l’exemple 1 est mal classifié et les exemples 2 et 3 sont bien classifiés, calculez les nouveaux poids .
Normalisez les poids pour qu’ils somment à 1.
Solution Exercice 4
.
L’exemple 1 (mal classifié): . Les exemples 2, 3 (bien classifiés): .
Somme: . Poids normalisés: , . L’exemple mal classifié reçoit trois fois le poids des exemples bien classifiés: le prochain classificateur se concentrera sur cet exemple.
Exercice 5: Probabilité bootstrap ★
Calculez exactement pour .
Si , combien d’exemples uniques en moyenne sont présents dans un échantillon bootstrap?
Expliquez pourquoi les 37% d’exemples manquants permettent d’estimer l’erreur de généralisation.
Solution Exercice 5
: . : . : . La convergence vers est rapide.
Chaque exemple a une probabilité d’être présent. En moyenne, exemples uniques sur les 1000 tirages.
Les exemples hors sac n’ont pas été utilisés pour entraîner ce modèle particulier, donc leur erreur de prédiction estime la capacité de généralisation, comme le ferait un jeu de validation. En moyennant sur tous les modèles (chaque exemple est hors sac pour environ 37% des modèles), on obtient une estimation de l’erreur de généralisation sans réserver de données.
Exercice 6: Variance d’un ensemble ★★
Soit des estimateurs de même variance et de corrélation deux à deux . L’estimateur de l’ensemble est .
Montrez que .
Que se passe-t-il quand ?
Pourquoi les forêts aléatoires sous-échantillonnent les caractéristiques à chaque nœud?
Solution Exercice 6
.
Quand , le terme et il reste . La variance de l’ensemble ne peut pas descendre en dessous de , quelle que soit la taille de l’ensemble.
Le sous-échantillonnage de caractéristiques réduit la corrélation entre les arbres. Sans cette randomisation, les mêmes caractéristiques dominantes apparaissent aux premières divisions de chaque arbre, ce qui donne proche de 1 et limite la réduction de variance. Avec plus faible, le plancher est plus bas.
Exercice 7: Gradient de la perte logistique ★★
Pour la perte logistique où :
Calculez le pseudo-résidu .
Montrez que le pseudo-résidu est compris dans et interprétez son signe.
Comparez avec les pseudo-résidus de la perte exponentielle . Lequel est plus sensible aux valeurs aberrantes?
Solution Exercice 7
. Donc le pseudo-résidu est .
Si (bonne classification avec marge), est grand et le pseudo-résidu est proche de 0: l’exemple est bien classifié, peu de correction nécessaire. Si (mauvaise classification), est petit et le pseudo-résidu est proche de (soit +1 ou -1): l’exemple nécessite une correction. Le pseudo-résidu est toujours dans car .
Pour la perte exponentielle, le pseudo-résidu est , qui croît exponentiellement avec la marge négative. La perte logistique donne des pseudo-résidus bornés, ce qui la rend plus robuste aux valeurs aberrantes et aux exemples mal étiquetés.
Exercice 8: Connexion résiduelles et boosting ★★
Considérez un réseau résiduel à 3 blocs: .
En quoi cette structure ressemble-t-elle au gradient boosting ?
Identifiez une différence: dans le réseau résiduel, quel est l’entrée de ? Est-ce la même chose que dans le boosting?
Veit et al. (2016) montrent que seuls les chemins courts contribuent au gradient dans un réseau résiduel. Proposez une analogie avec le choix du taux d’apprentissage en gradient boosting.
Solution Exercice 8
Les deux structures sont des sommes de corrections: chaque terme ajoute une fonction qui corrige l’accumulation des termes précédents. Le résultat final est une somme de modèles/blocs.
Dans le réseau résiduel, reçoit en entrée, c’est-à-dire la représentation mise à jour par les blocs précédents. Dans le boosting, reçoit (les données originales) et s’entraîne sur les pseudo-résidus de . Le boosting opère toujours dans l’espace d’entrée original, tandis que le réseau résiduel transforme progressivement les représentations.
Un petit en boosting limite la contribution de chaque modèle, de la même façon que les chemins courts (traversant peu de blocs non triviaux) dominent le gradient dans un ResNet: dans les deux cas, les contributions les plus importantes viennent de corrections modestes plutôt que de transformations profondes.
Exercice 9: Régularisation XGBoost ★★★
Dans XGBoost avec la régularisation :
Montrez que le poids optimal de la feuille est , où et .
Que se passe-t-il quand ? Et quand ?
Le terme impose un coût par feuille. Expliquez pourquoi cela agit comme un test de significativité pour les divisions: une division n’est retenue que si elle apporte suffisamment de gain.
Solution Exercice 9
L’objectif pour une feuille est . En dérivant par rapport à et en annulant: , d’où .
Quand : , c’est la mise à jour de Newton pure (pas de régularisation). Quand : , les prédictions de chaque feuille sont écrasées vers 0. C’est analogue à une forte décroissance des poids dans un réseau de neurones.
Le gain d’une division est . Pour qu’une division soit retenue, le gain doit être positif, c’est-à-dire que l’amélioration apportée par la séparation en deux feuilles doit compenser le coût . Plus est grand, plus une division doit être informative pour être retenue, ce qui produit des arbres plus petits et réduit le surapprentissage.
- He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep Residual Learning for Image Recognition. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 770–778. 10.1109/CVPR.2016.90
- Friedman, J. H. (2001). Greedy Function Approximation: A Gradient Boosting Machine. Annals of Statistics, 29(5), 1189–1232. 10.1214/aos/1013203451
- Badirli, S., Liu, X., Xing, Z., Bhatt, A., Muddu, M., & Verspoor, K. (2020). Gradient Boosting Neural Networks: GrowNet. arXiv Preprint arXiv:2002.07971.
- Frosst, N., & Hinton, G. (2017). Distilling a Neural Network Into a Soft Decision Tree. arXiv Preprint arXiv:1711.09784.
- Freund, Y., & Schapire, R. E. (1997). A Decision-Theoretic Generalization of On-Line Learning and an Application to Boosting. Journal of Computer and System Sciences, 55(1), 119–139. 10.1006/jcss.1997.1504
- Chen, T., & Guestrin, C. (2016). XGBoost: A Scalable Tree Boosting System. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 785–794. 10.1145/2939672.2939785
- Ke, G., Meng, Q., Finley, T., Wang, T., Chen, W., Ma, W., Ye, Q., & Liu, T.-Y. (2017). LightGBM: A Highly Efficient Gradient Boosting Decision Tree. Advances in Neural Information Processing Systems, 30.
- Prokhorenkova, L., Gusev, G., Vorobev, A., Dorogush, A. V., & Gulin, A. (2018). CatBoost: unbiased boosting with categorical features. Advances in Neural Information Processing Systems, 31.
- Breiman, L. (2001). Random Forests. Machine Learning, 45(1), 5–32. 10.1023/A:1010933404324
- Grinsztajn, L., Oyallon, E., & Varoquaux, G. (2022). Why do tree-based models still outperform deep learning on typical tabular data? Advances in Neural Information Processing Systems, 35.
- Veit, A., Wilber, M. J., & Belongie, S. (2016). Residual Networks Behave Like Ensembles of Relatively Shallow Networks. Advances in Neural Information Processing Systems, 29.