Les méthodes non paramétriques conservent les données d’entraînement et les consultent au moment de la prédiction. Les trois variantes à retenir forment une progression : voisinage dur → noyau lisse → moyenne pondérée par noyau.
Les méthodes non paramétriques souffrent du fléau de la dimensionnalité : en haute dimension, la notion de voisinage perd son sens. Pour passer à l’échelle, il faut formaliser ce que signifie « bien prédire » et s’engager sur une famille de fonctions paramétriques.
Le cours repose sur un cadre commun : on cherche un prédicteur f qui minimise le risque R(f)=E[ℓ(f(x),y)]. Comme la distribution conjointe est inconnue, on minimise à la place le risque empirique sur un ensemble d’entraînement. Le prédicteur de Bayes optimal, qui minimise le risque parmi toutes les fonctions, fixe la borne inférieure (risque de Bayes R∗).
Le cadre du risque nous dit quoi minimiser. Les modèles linéaires sont le premier choix de famille paramétrique : ils ont une solution en forme fermée et une interprétation probabiliste directe.
Les moindres carrés ordinaires donnent la solution en forme fermée θ^=(X⊤X)−1X⊤y, mais cette solution est instable quand d≈N ou d>N. Ridge stabilise en ajoutant λI. Via la SVD, Ridge atténue sélectivement les directions de faible variance.
En régression, la vraisemblance gaussienne mène aux moindres carrés. En classification, la vraisemblance de Bernoulli mène à l’entropie croisée et à la régression logistique, qui modélise directement p(y∣x). Le softmax généralise la sigmoïde au cas multiclasse. La perte associée est l’entropie croisée, dérivée du maximum de vraisemblance.
Un modèle linéaire peut être trop simple pour les données, ou trop complexe si l’espace de caractéristiques est enrichi. Le compromis biais-variance structure la première moitié du cours. Un modèle trop simple sous-apprend (biais élevé); un modèle trop complexe surapprend (variance élevée). La validation croisée sert à choisir les hyperparamètres.
La régularisation contrôle la complexité, mais d’où vient-elle? Le cadre probabiliste unifie trois perspectives sur l’apprentissage. Le MAP relie la régularisation à un a priori bayésien, et la théorie de l’information fournit une troisième lecture via la divergence KL.
La régression logistique modélise p(y∣x) directement (approche discriminative). Une alternative est de modéliser p(x∣y) et d’appliquer Bayes (approche générative). Les modèles génératifs modélisent p(x∣y)p(y) puis appliquent Bayes pour classifier, contrairement aux modèles discriminatifs qui modélisent directement p(y∣x). L’algorithme EM est la méthode d’estimation pour les modèles à variables latentes.
Tous les modèles vus jusqu’ici reposent sur des caractéristiques choisies à la main : polynomiales, MFCC, mesures cliniques. Les réseaux de neurones apprennent leurs propres caractéristiques par composition de transformations non linéaires.
Un perceptron multicouche (MLP) empile des couches de la forme zℓ=φ(Wℓzℓ−1+bℓ). La couche de sortie est dictée par le maximum de vraisemblance : linéaire pour la régression, softmax pour la classification multiclasse, sigmoïde pour la classification binaire.
Un MLP est une composition de fonctions. Pour l’entraîner par descente de gradient, il faut calculer le gradient de la perte par rapport à tous les paramètres. La dérivation automatique (AD) calcule les dérivées exactes d’un programme en appliquant la règle de la chaîne sur son graphe de calcul.
Un programme se décompose en un DAG où chaque nœud est une opération élémentaire. Lorsqu’une variable a plusieurs successeurs (branchement), le mode arrière accumule les adjoints de chaque chemin.
En pratique (JAX, PyTorch), un traceur encapsule chaque valeur numérique et enregistre les opérations sur une bande de Wengert. Chaque entrée de la bande contient une fermeture (closure) qui capture les valeurs de la passe avant et la règle VJP. La passe arrière parcourt la bande en sens inverse et accumule les adjoints.
Le gradient en main, nous pouvons entraîner des réseaux profonds. Mais la profondeur crée ses propres difficultés.
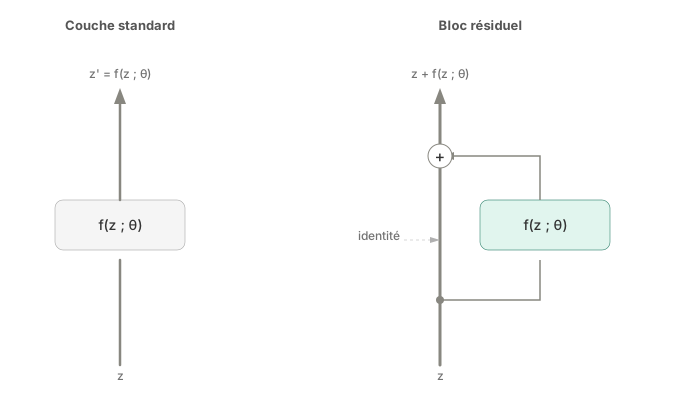
Dans un réseau à L couches, le gradient par rapport aux premières couches est un produit de jacobiens. Si le rayon spectral de chaque jacobien est <1, le gradient disparaît exponentiellement.
Figure 1:Bloc résiduel : le terme identité garantit un chemin direct pour le gradient.
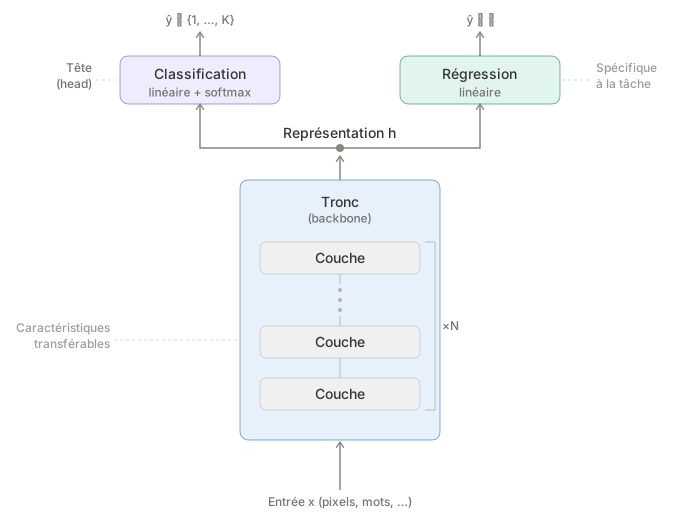
Un réseau se décompose en tronc (caractéristiques générales) et tête (spécifique à la tâche). Deux stratégies : geler le tronc et entraîner la tête (extraction de caractéristiques), ou régler finement le réseau entier avec un taux d’apprentissage réduit.
Figure 2:Architecture tronc-tête : le tronc pré-entraîné extrait des caractéristiques générales.
Les réseaux vus jusqu’ici sont supervisés. Un auto-encodeur utilise la même machinerie (MLP, rétropropagation) pour l’apprentissage non supervisé : il comprime l’entrée via un goulot d’étranglement puis la reconstruit. L’auto-encodeur linéaire est exactement l’ACP.
Les MLP traitent des entrées de taille fixe. Pour les séquences (texte, audio, séries temporelles), il faut une architecture qui accepte des entrées de longueur variable. Les RNN traitent des séquences en maintenant un état caché ht. Le partage de paramètres à travers le temps permet de traiter des séquences de longueur variable.
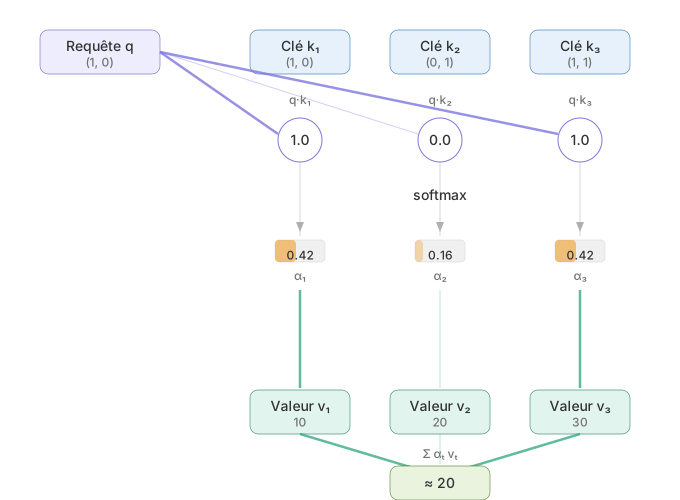
Les RNN compriment tout le passé dans un vecteur de taille fixe et ne peuvent pas être parallélisés. Le mécanisme d’attention élimine ces deux limites : chaque position accède directement à toutes les autres via des requêtes, clés et valeurs apprises, sans passer par un état caché séquentiel.
Figure 3:Attention par produit scalaire : les requêtes interrogent les clés pour pondérer les valeurs.
Les réseaux de neurones sont l’outil de choix pour les données non structurées (images, texte, audio). Pour les données tabulaires structurées, les méthodes d’ensemble à base d’arbres restent compétitives et souvent préférables. La descente de gradient fonctionnelle optimise les prédictions elles-mêmes plutôt que les paramètres. Les arbres de décision servent de modèles de base.
(a)Gradient boosting (ou forêt aléatoire). Données tabulaires structurées → les méthodes d’ensemble à base d’arbres sont l’état de l’art. L’importance des caractéristiques (par permutation ou diminution d’impureté) fournit l’interprétabilité demandée.
(b)Transformeur (encodeur-décodeur). Le mécanisme d’attention permet la parallélisation sur GPU (contrairement aux RNN séquentiels). L’attention croisée entre l’encodeur (langue source) et le décodeur (langue cible) est le mécanisme standard en traduction.
(c)Auto-encodeur. Apprentissage non supervisé → pas d’étiquettes. L’auto-encodeur apprend à reconstruire le fonctionnement normal; une erreur de reconstruction élevée signale une anomalie.
(d)LSTM (ou GRU). Séquences courtes → la limite du traitement séquentiel n’est pas un problème. Les dépendances temporelles locales sont bien captées par les portes du LSTM. Un transformeur serait surdimensionné pour 20 trames.
La variable x a deux arêtes sortantes : l’une vers le nœud × (pour calculer a) et l’autre vers le nœud + (pour calculer b).
(b) Passe avant : a=2×3=6, b=6+2=8, c=relu(8)=8.
Passe arrière (adjoints) :
Étape
Règle VJP
Résultat
cˉ=1
(initialisation)
cˉ=1
bˉ=cˉ⋅1(b>0)=1⋅1
VJP de relu
bˉ=1
aˉ=bˉ⋅1=1
VJP de add (par rapport à a)
aˉ=1
xˉvia b=bˉ⋅1=1
VJP de add (par rapport à x)
contribution = 1
xˉvia a=aˉ⋅y=1⋅3=3
VJP de mul (par rapport à x)
contribution = 3
xˉ=1+3=4
accumulation
∂x∂c=4
yˉ=aˉ⋅x=1⋅2=2
VJP de mul (par rapport à y)
∂y∂c=2
(c) Lorsqu’une variable a plusieurs successeurs, le mode arrière accumule les adjoints par sommation : xˉ=xˉvia a+xˉvia b=3+1=4.
(d) Le mode avant est plus efficace. Le vecteur (1,0)⊤ est le vecteur tangent unitaire en x : on calcule ∂x∂f directement (une dérivée directionnelle). Avec 2 entrées et 1 sortie, le mode avant nécessite 2 passes et le mode arrière 1 passe → le mode arrière est en fait légèrement mieux ici. Mais si l’on ne cherche que ∂f/∂x, le mode avant avec v=(1,0)⊤ donne la réponse en une seule passe, sans calculer ∂f/∂y.
(a) Un réseau récurrent (RNN). Indices : (1) h = np.tanh(W_hh @ h + ...) — l’état caché h est mis à jour récursivement en fonction de lui-même (Whh) et de l’entrée courante (Wxh@xt); (2) la boucle for x_t in x_seq parcourt la séquence pas à pas; (3) les paramètres Whh,Wxh sont partagés à tous les pas de temps.
(b)Dissolution du gradient. Pour T=100, la rétropropagation à travers le temps (BPTT) produit un produit de 99 jacobiens ∏jdiag(tanh′(aj))Whh. Comme tanh′(a)≤1, ce produit décroît exponentiellement avec T si les valeurs propres de Whh sont inférieures à 1. Les premières positions de la séquence ne reçoivent presque aucun signal de gradient.
(c) (1) Remplacer le RNN par un LSTM : l’état de cellule ct offre un chemin quasi-linéaire pour le gradient. (2) Ajouter de l’écrêtage de gradient (gradient clipping) pour prévenir l’explosion du gradient, combiné avec l’utilisation de connexions résiduelles entre couches si le réseau a plusieurs couches empilées.
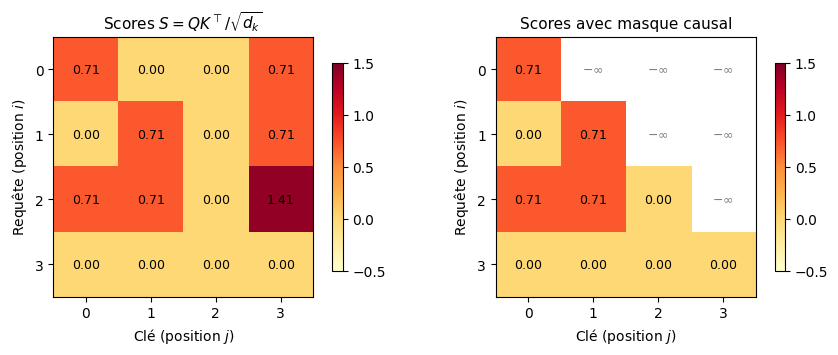
(c) Le calcul de QK⊤ coûte O(T2dk). La matrice de scores est de taille T×T, donc O(T2) en mémoire. Pour les longues séquences (T grand), le coût quadratique domine.
(d)KV cache : à chaque pas de génération t, on ne calcule que qt (une ligne) et on la multiplie par les clés stockées K1:t. On évite de recalculer K et V pour les positions passées.
Sans cache : au pas t, on recalcule Q,K,V pour les t positions → coût O(t2d) par pas → total O(T3d)
Avec cache : au pas t, un seul vecteur requête contre t clés → coût O(td) par pas → total O(T2d)
Matrice de scores et version masquée pour cet exemple :
Source
import numpy as np
import matplotlib.pyplot as plt

Q = np.array([[1, 0], [0, 1], [1, 1], [0, 0]], dtype=float)
K = np.array([[1, 0], [0, 1], [0, 0], [1, 1]], dtype=float)
d_k = 2

S = Q @ K.T / np.sqrt(d_k)

mask = np.triu(np.full((4, 4), -np.inf), k=1)
S_masked = S + mask

fig, axes = plt.subplots(1, 2, figsize=(9, 3.5))

for ax, mat, title in [(axes[0], S, "Scores $S = QK^\\top / \\sqrt{d_k}$"),
                        (axes[1], S_masked, "Scores avec masque causal")]:
    display_mat = np.where(np.isneginf(mat), np.nan, mat)
    im = ax.imshow(display_mat, cmap="YlOrRd", vmin=-0.5, vmax=1.5)
    ax.set_title(title, fontsize=11)
    ax.set_xlabel("Clé (position $j$)")
    ax.set_ylabel("Requête (position $i$)")
    ax.set_xticks(range(4))
    ax.set_yticks(range(4))
    for i in range(4):
        for j in range(4):
            val = mat[i, j]
            if np.isneginf(val):
                ax.text(j, i, "$-\\infty$", ha="center", va="center", fontsize=9, color="gray")
            else:
                ax.text(j, i, f"{val:.2f}", ha="center", va="center", fontsize=9)
    plt.colorbar(im, ax=ax, shrink=0.8)

plt.tight_layout()
plt.show()
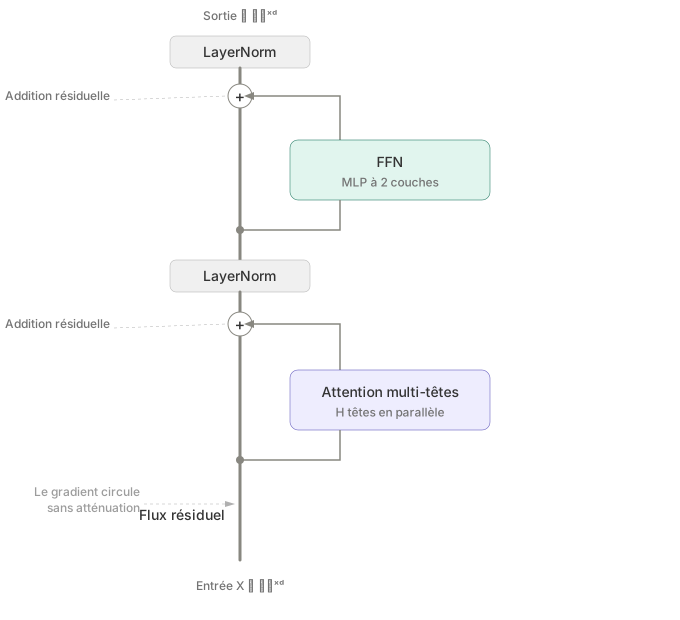
(a)Dissolution du gradient due à la saturation de la sigmoïde : σ′(a)≤0,25, donc après 19 couches le gradient est atténué par un facteur (0,25)19≈10−12. Modifications : (1) remplacer les sigmoïdes par des ReLU (dérivée 1 pour a>0); (2) ajouter des connexions résiduelles pour créer des chemins directs de gradient.
(b) Avec SGD, les deux sont équivalentes. Avec Adam, elles divergent : la régularisation L2 ajoute λθ au gradient avant la normalisation par les moments, ce qui atténue l’effet pour les paramètres à gradient élevé. La décroissance des poids (AdamW) applique la contraction (1−ηλ)θdirectement, sans passer par les moments adaptatifs. AdamW est préféré car il régularise de manière uniforme, indépendamment de l’historique des gradients.
(c) Surapprentissage classique. (1) Arrêt précoce : stopper l’entraînement à l’époque où l’erreur de validation est minimale (ici, vers l’époque 30). Limite implicitement la complexité du modèle. (2) Dropout : désactive aléatoirement une fraction p des neurones à chaque itération, empêchant la co-adaptation et forçant le réseau à apprendre des caractéristiques robustes.
(a) L’auto-encodeur linéaire optimal conserve les L=2 directions de plus grande variance (valeurs propres λ1=5 et λ2=3). L’erreur de reconstruction minimale est la somme des valeurs propres ignorées :
(b) L’ACP projette sur un sous-espace linéaire (plan, droite). Si les données vivent sur une variété courbe — par exemple un demi-cercle en 2D ou une surface en spirale en 3D (Swiss roll) — l’ACP ne peut pas capturer cette courbure et étale les données projetées de manière inappropriée. Un auto-encodeur non linéaire apprend une transformation courbe qui « déplie » la variété dans l’espace latent.
Question 7 — Dissolution du gradient dans les RNN
où at=Whhht−1+Wxhxt+bh. Puisque tanh′(a)=1−tanh2(a)∈[0,1], les éléments diagonaux sont au plus 1. Le produit de T tels jacobiens donne ∏j=1Tdiag(tanh′(aj))Whh. Si le rayon spectral de diag(tanh′(aj))Whh est strictement inférieur à 1 (ce qui est fréquent en pratique), le produit décroît exponentiellement vers zéro.
Quand ft≈1, le terme dominant est diag(ft)≈I, donc ∂ct−1∂ct≈I et le gradient passe sans atténuation sur de longues séquences. On retrouve le même mécanisme dans une connexion résiduellezℓ+1=zℓ+f(zℓ), où le jacobien I+∂zℓ∂f contient un chemin identité direct.
Ce sont les résidus ordinaires : la différence entre la cible et la prédiction actuelle.
(b) Le boosting réduit le biais : chaque modèle faible corrige séquentiellement les erreurs du modèle courant, augmentant la complexité effective du prédicteur. Le bagging (forêts aléatoires) réduit la variance : en moyennant M modèles divers entraînés sur des échantillons bootstrap avec des sous-ensembles aléatoires de caractéristiques, on réduit la variabilité des prédictions. La formule Var[fˉ]=ρσ2+M1−ρσ2 montre que le bagging est d’autant plus efficace que la corrélation ρ entre les arbres est faible.